ARTICLE · 1228121
超3000万人都在用的插件,这次更稳了.
不知道你们有没有发现,最近这一两年出现了一个挺有意思的变化:我们开始把越来越多原本不太能随便告诉别人的内容,交给 AI 来处理了。
比如,一封自己没看懂的邮件,我们会复制进去让它帮忙翻译;一份会议记录,我们会上传上去,请它归纳里面的重点。
AI 确实让这些事情变得省事了不少,很多原本需要自己来回折腾、反复修改的工作,现在几句话就能完成。
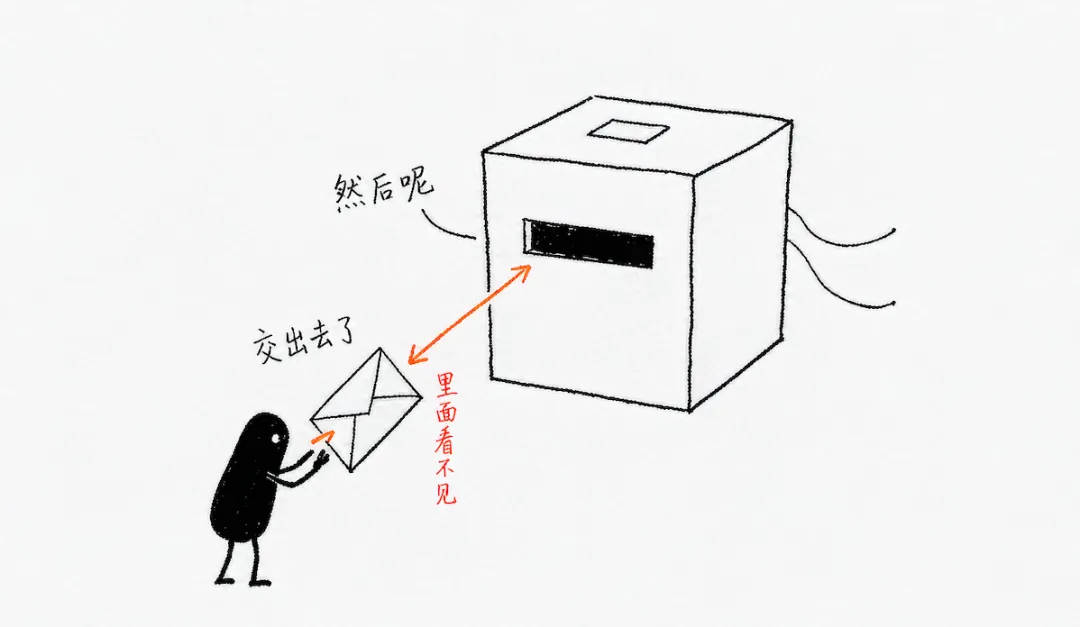
不过,随着使用越来越顺手,我们也就更容易忘记停下来问一句:我刚刚交出去的这些内容,接下来究竟会发生什么?
这里所说的隐私,当然并不只是身份证号、银行卡号这类一眼就能辨认出来的个人信息。
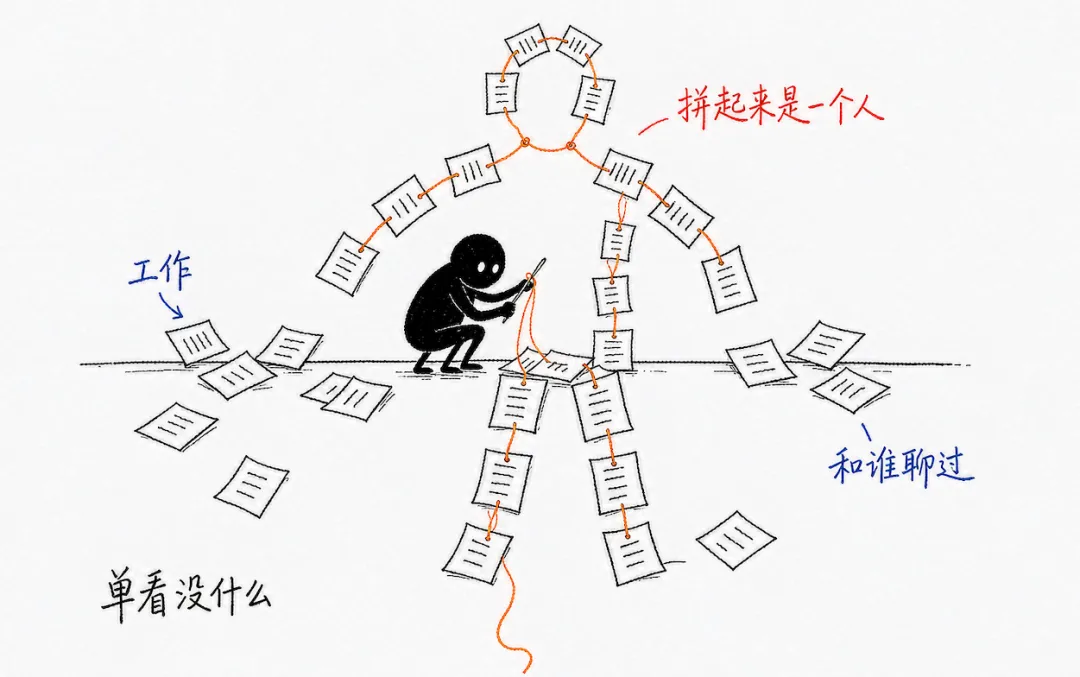
而是你最近在研究什么、公司正在推进什么事情、和谁聊过什么内容,有时其实都藏在一段看起来很普通的文本里面。
单独看每一条信息,可能都没有什么特别的;但是当这些信息被放在一起之后,却有可能一点点拼出一个人的工作内容、人际关系,甚至平时的习惯。
所以,AI 产品的隐私问题很难只靠用户自己“多留个心眼”来解决。
产品是怎样设计的、数据是怎样处理的,以及真的出了问题之后由谁来应对,这些都属于这道题的一部分,也都需要被认真考虑。
一个方便的功能,也可能带来意料之外的边界
沉浸式翻译在去年遇到过一次和这个问题相关的争议。
沉浸式翻译主要帮助用户阅读外文网页、视频字幕和文档,而且这些功能都非常的好用,爱侃也一直在用。
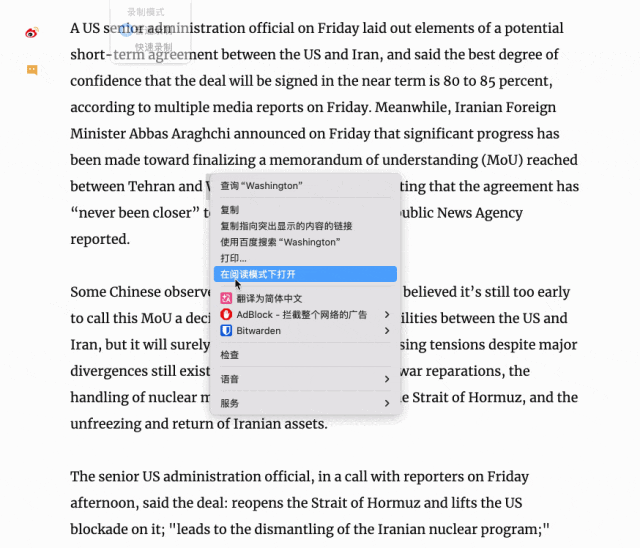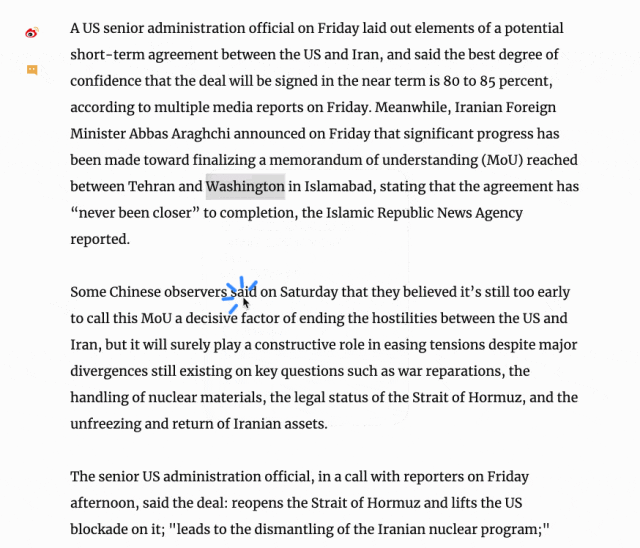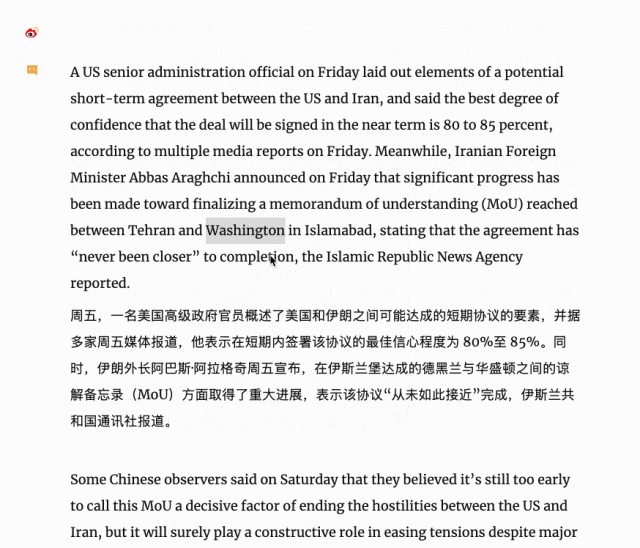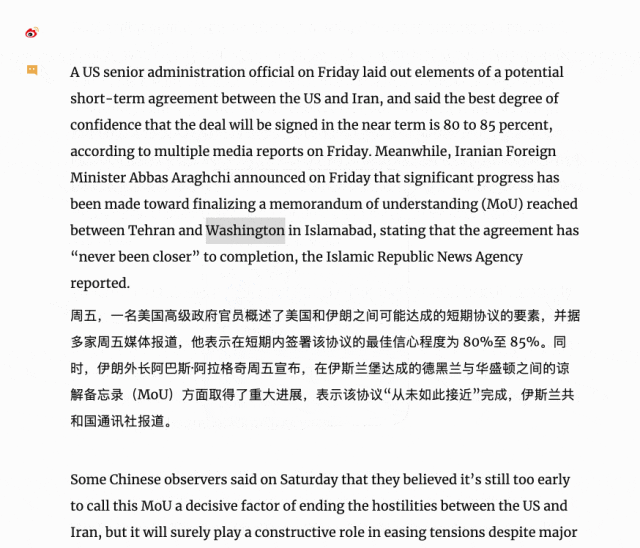
2025年8月,它的网页快照分享功能引发了一些用户对隐私的担忧。
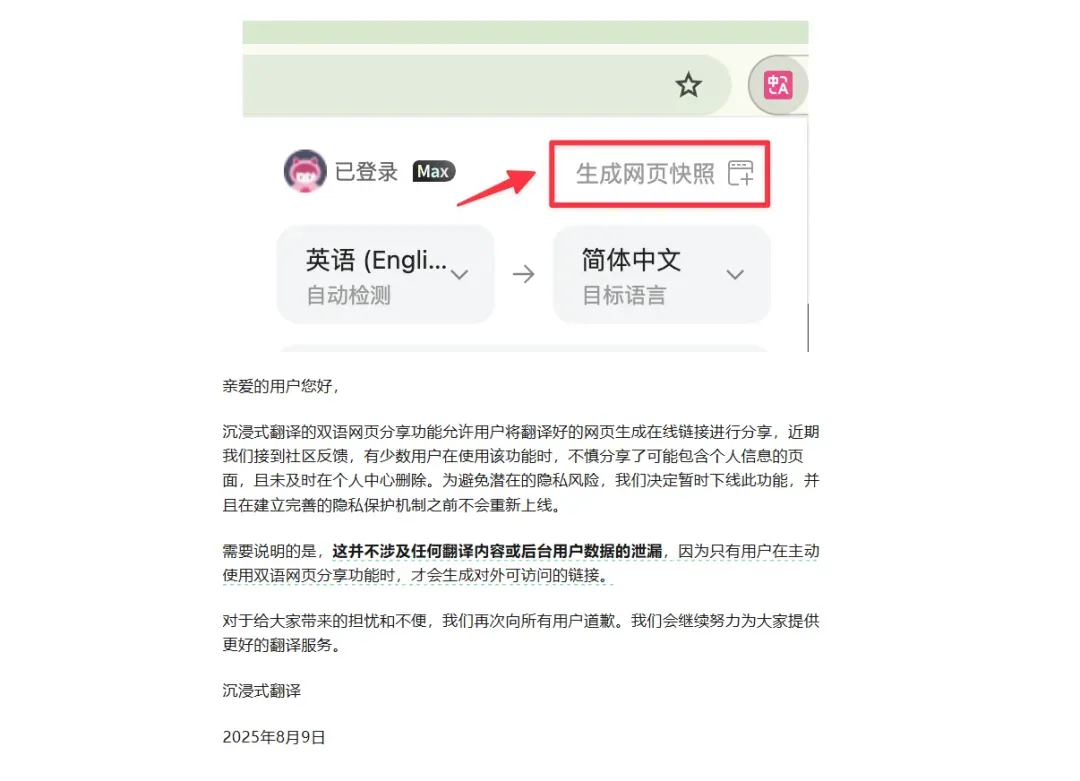
部分公开分享页面被搜索引擎收录之后,团队随后下线了相关功能。沉浸式翻译在最近发布的官号文章中也承认,当时对于公开分享这个功能可能带来的风险,考虑得还不够充分。
这件事也让人想到一个在产品设计中很常见的细节:用户点下“分享”这个按钮时,心里想的可能只是把内容发给某一个人;但是产品实际设计出来的结果,却可能是生成一个任何人都能够访问的页面。
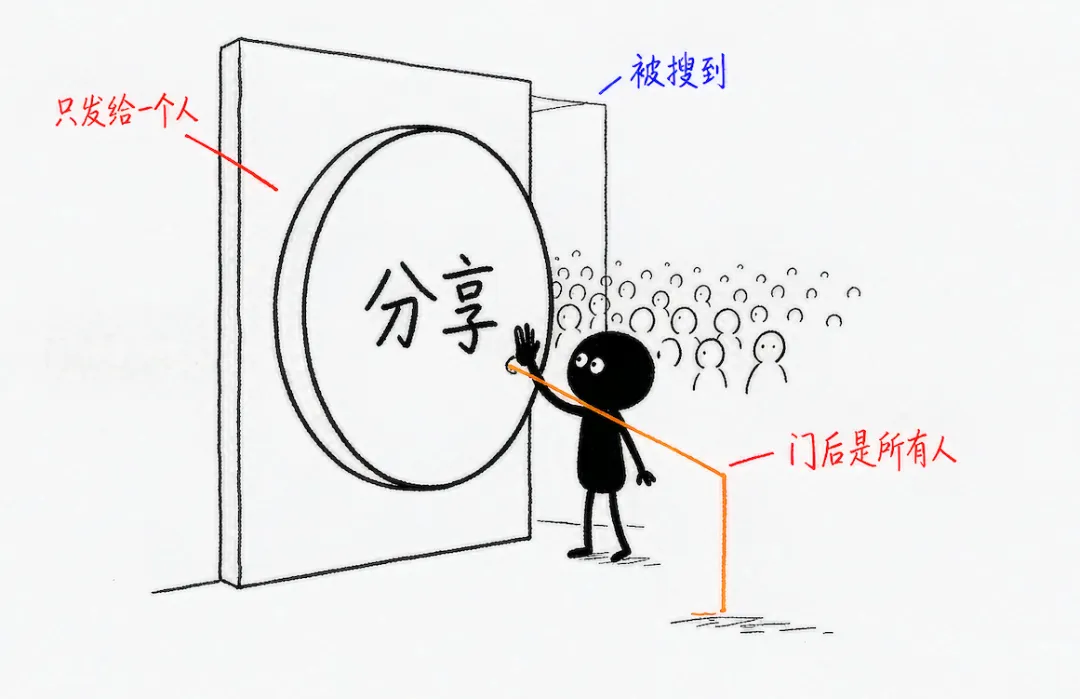
按钮上虽然只有两个字,背后却牵涉到了内容的访问范围、搜索引擎是否会收录,以及内容之后会怎样传播等问题。
因此,在功能正式上线之前,这些不同之处就应该被考虑清楚。用户不应该只能靠猜,才能弄明白自己交出去的内容最后会不会变成公开内容。
隐私保护不是一句“请放心”
我们平时阅读产品介绍时,很容易看到“安全”“保护隐私”这一类承诺。
不过,真正想要判断一款产品究竟怎样对待数据,最后还是要看这些承诺后面有没有对应的具体做法。
比如,数据在传输过程中有没有受到保护;数据到达服务端之后,哪些人或者系统可以进行访问;某项功能是否需要接入第三方服务;资料会被保存多长时间;出现异常之后又由谁来负责处理。
这些问题不一定要求每一个用户都逐条研究清楚,但产品团队需要围绕它们建立相应的规则,也需要让用户能够找到相关说明。
今年9月,沉浸式翻译通过了 ISO/IEC 27001:2022 信息安全管理体系认证和 ISO/IEC 27701:2019 隐私信息管理体系认证。
前一项认证主要关注信息安全风险管理,后一项则进一步涉及个人信息处理方面的管理。
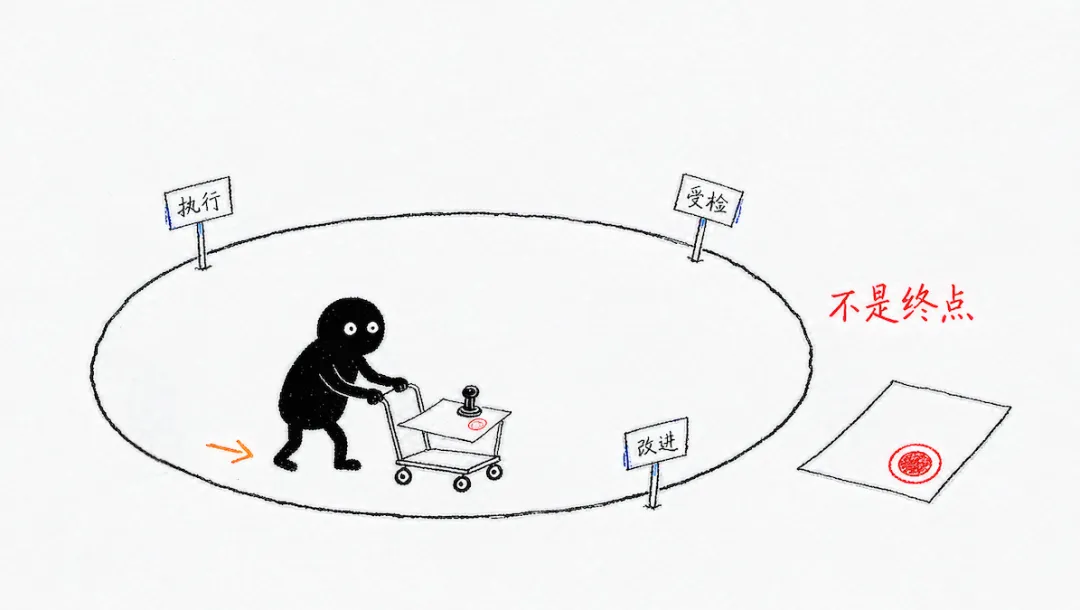
这两项认证的实际的意义在于,企业对于安全和隐私的管理,需要进入一套能够实际执行、接受检查,并且持续改进的体系当中。
沉浸式翻译在官号文章里也提到了,过去一年,他们梳理了数据处理的各个环节,采用 HTTPS 和 TLS 来保护数据传输,按照最小权限原则来管理访问,也把安全评估放进了新功能上线以及重要系统变更之前的流程里面。
想了解更多细节的朋友可以移步官方文章>>>点我直达<<<
这些工作不像推出一个新功能那样显眼,用户打开产品之后,也很难立刻感受到它们具体产生了什么变化。
但隐私保护本来就有很大一部分发生在看不见的地方:比如哪些人拥有什么权限,产品上线之前需要检查哪些内容,以及系统出现异常之后应该怎样响应。
沉浸式翻译还在文章中提到,团队曾经拒绝购买用户数据的商业邀约,并重申不会出售用户个人信息。
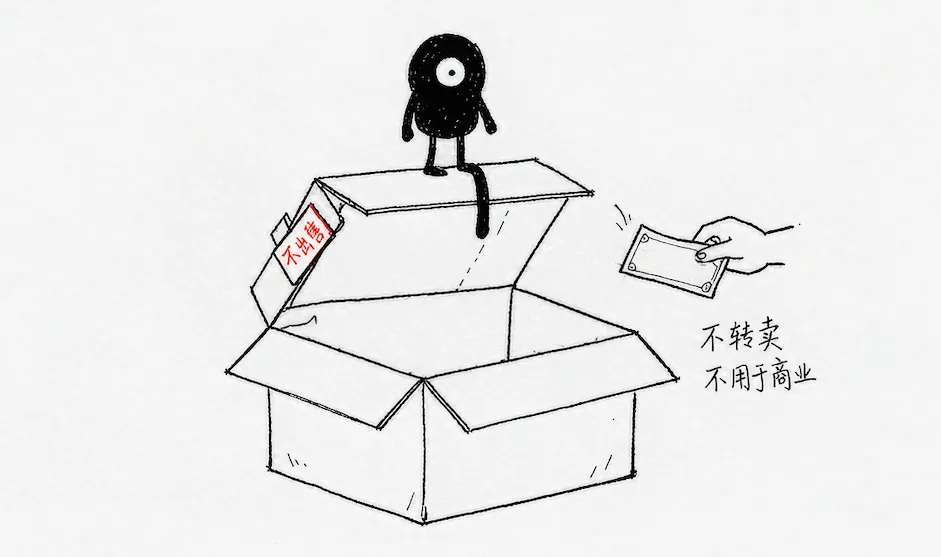
对于一款翻译工具来说,这样的选择也值得拿出来讨论。用户把内容交给工具,是为了让自己看懂这些内容,这并不等于同意这些内容之后被拿去做其他生意。
写在最后
说到底,AI 工具好不好用,功能顺不顺手是一回事,大家敢不敢把日常内容交给它,是另一回事。
沉浸式翻译这次通过了两项安全与隐私管理认证,也公开了过去一年在数据处理、访问权限和安全评估上的一些做法。
敢于正视承认自己的不足,这点没得说,还是值得信赖的,现在你可以完全放心的使用沉浸式翻译。
刚关注爱侃,或者还没用过沉浸式翻译的小伙伴,可以看看下面这篇使用介绍:网页怎么翻译、视频双语字幕怎么开、PDF 翻译效果怎么样,里面都有具体展示。
关注我们,获取更多精彩内容
▽▽▽