ARTICLE · 1247269
为什么读 AI 写的技术文档越来越累?最新论文揭秘:大模型的“长度惩罚”正在制造认知灾难
很多工程师在审查代码提交或翻阅系统架构设计时,都有过一种极其诡异的生理体感。面前的技术文档挑不出任何拼写错误,词汇拼装极其高级,主谓宾结构完全合法。
但是只要连续读完几行文字,大脑就开始隐隐发胀,不得不倒回去重新梳理句式。这种感觉就像去便利店买快餐,厨师为了追求极致的便携,用液压机把一顿丰盛的午餐强行压成一块高密度的干燥砖头,硬塞进食客嘴里。表面上看热量一点没少,但是食客的肠胃根本无法消化。大模型生成技术文档的速度越来越快,但人类工程师的代码审查与排障理解却正在大面积陷入瘫痪。
01
SECTION 01
没有任何语法错误却让人越读越头疼
日常开发中最常见的现象,就是各种自动化工具生成的技术总结。智能体把一次并不复杂的代码 PR 提交,总结为一长串密不透风的书面文字。
我们可以看一段典型的机器生成片段。 “鉴于分布式缓存节点在瞬时高并发流量冲击下可能触发内存淘汰异常,本模块通过引入基于租约时序的自适应熔断机制以确保底层存储拓扑的高可用性。” 整句话长达数十个字,嵌套了两层因果与条件修饰。机器推演这类文字行云流水,因为大模型不需要像人类一样呼吸,单次推演海量 token 毫无压力。
但人类的大脑无法在瞬间缓存多个相互依赖的抽象概念。在工位前审查 diff 时,读者必须在脑海中不断暂停当前解析,倒退回去寻找前面的逻辑锚点。原本很快就能合入的代码改动,因为一段高密度说明,人类往往需要反复核对多次才能提取出真正的修改动作。工程团队原本希望借助模型加速交付,最后却把时间全部耗费在了解释文档的二次沟通与排障等待上。
如果将其重构为符合人类生理直觉的短单句。 “高并发流量可能打崩缓存节点。我们在存储层前增加了一道租约熔断。一旦节点响应超时,系统立刻拒绝多余请求,保护底层数据库。” 三句话短平快推进,动作清晰,状态瞬间落定。
02
SECTION 02
机器为了节省空间把语言避震器彻底拆除
近期学术预印本平台发表了一篇实证研究《Why is AI-generated language so hard to understand?》(论文编号 2610.29162)。研究人员跨多个领域对比了人类写作与 9 个主流前沿大模型的生成文本。
实验测试发现,所有被测模型都在高频使用引发人类理解困难的语言特征。在英文测试语料中,无生命主语搭配动作动词的比例显著升高,低频词组的使用频率也大幅增加;而在很多交互场景中,句法依赖跨度显著拉长,堆叠名词也普遍偏多。
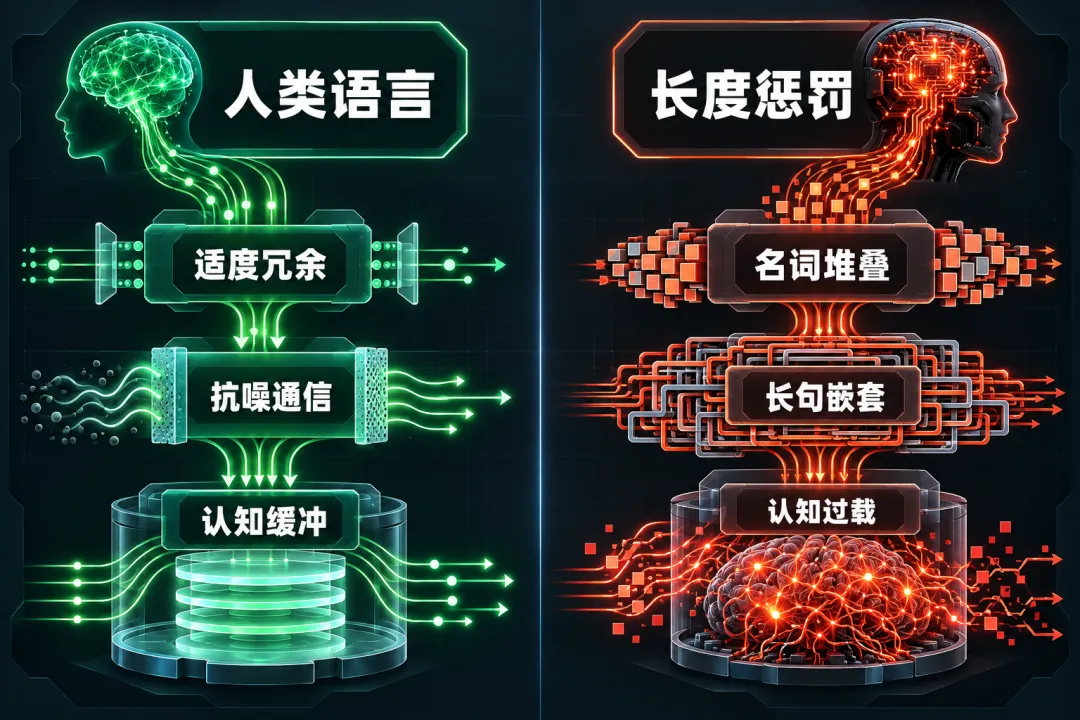
这篇论文通过概念验证实验,揭示了背后的底层物理机制。人类自然语言经过数百万年演化,首要目标是确保人类之间低阻抗、抗干扰的可靠通信。工程师在工位交流时,说话必然带有适当的重复、停顿与解释性过渡。这些看似多余的词句,实际上是人类语言自带的“避震器”,让大脑有足够的时间构建心理模型。
研究团队指出,当语言模型受到长度惩罚驱动时,会被迫追求极致的信息密度。 为了在更少输出词元中塞入相同事实,模型会主动拆除所有用于缓冲的冗余结构。微调实验表明,一旦施加长度惩罚,模型就会表现出极端的压缩倾向,行为模式加速脱离正常人类沟通习惯。机器为了替计算节省词元,把巨大的认知解码负荷毫无保留地甩给了人类大脑。
| 通信目标 | |||
| 缓冲机制 | |||
| 句法特征 | |||
| 认知代价 |
03
SECTION 03
用通俗短单句建立抵御信息过载的工程防线
面对大模型喷涌而出的高密度文本,技术团队不能被动承受认知重压。严肃的工程系统必须在代码审查与文档发布流水线中,建立起明确的去毒与解压机制。清晰有力的工程文档绝不需要生僻词汇装点门面,深刻来自物理事实的精准映射。
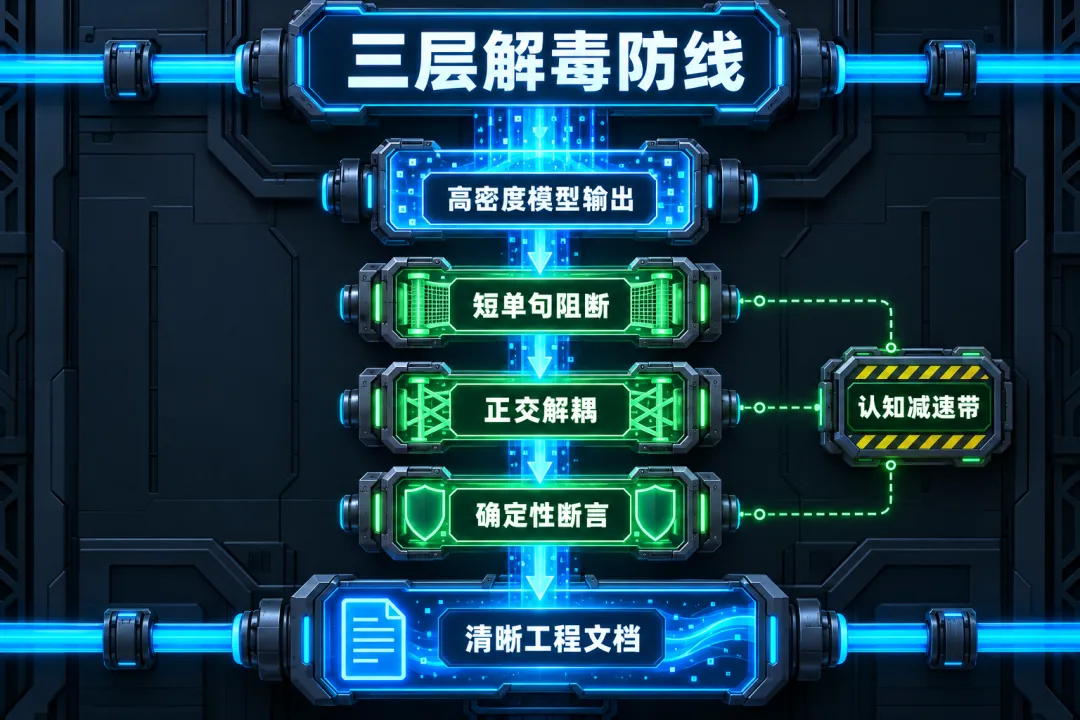
团队在日常工程中可以落地三项去毒自检项。
第一是短单句强制截断。一旦在 PR 描述或设计说明中检测到复杂的长复合句式,立刻切碎为多个独立短单句。一句话只陈述一个明确事实或执行动作,让读者的大脑在句号处瞬间落定状态,阻断认知回溯。
第二是概念正交拆解。不要把系统属性、限制条件与业务动作打包成一整坨复合名词。把运行机制写在前面,把约束边界列在后面,让不同维度的信息各自独立站立,避免模块间相互踩踏。
第三是前置质量断言。团队可以在 Git 钩子或 CI 门禁中设定客观的可读性指标,自动化统计平均句长与生僻名词密度。任何充斥学术黑话与嵌套从句的生成文本,在合并入库前必须被流水线自动拦截并打回重构。
只有把机器过度压缩的信息重新还原为符合人类生理认知的通俗表达,智能体产出的工程资产才能真正转化为团队的生产力。
我是随机比特,专注分享 AI Agent、Coding Agent 与一线研发实践。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发支持,我们下篇见。