ARTICLE · 1249327
为什么 AI 分不清土豆和梨,人却能一眼看穿?(上篇)
发布时间:2026-10-25 20:54:28 最近访问:2026-10-25 20:54:29
为什么 AI 分不清土豆和梨,人却能一眼看穿?(上篇)
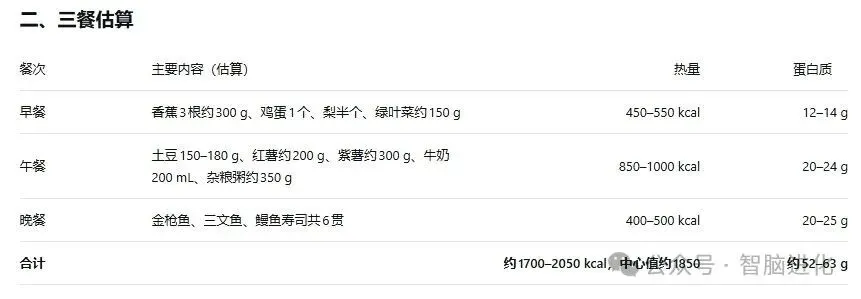
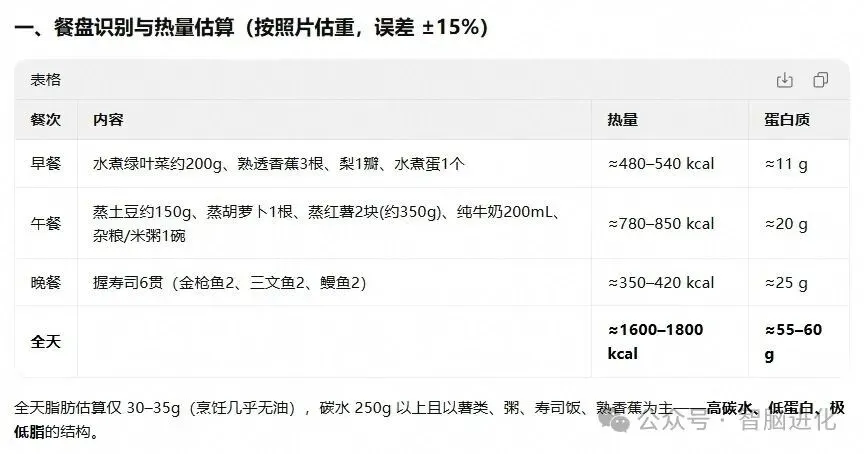
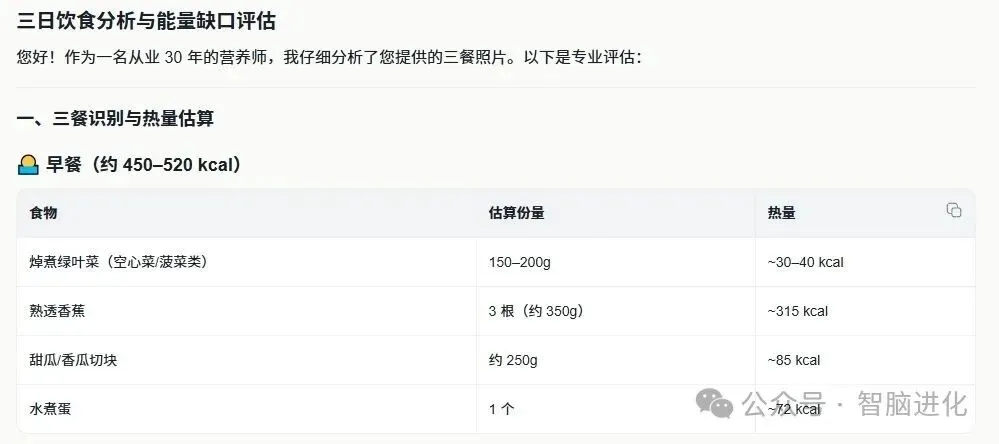
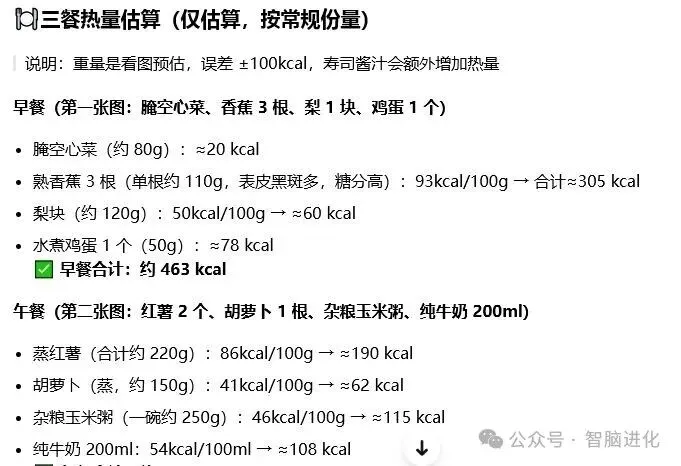
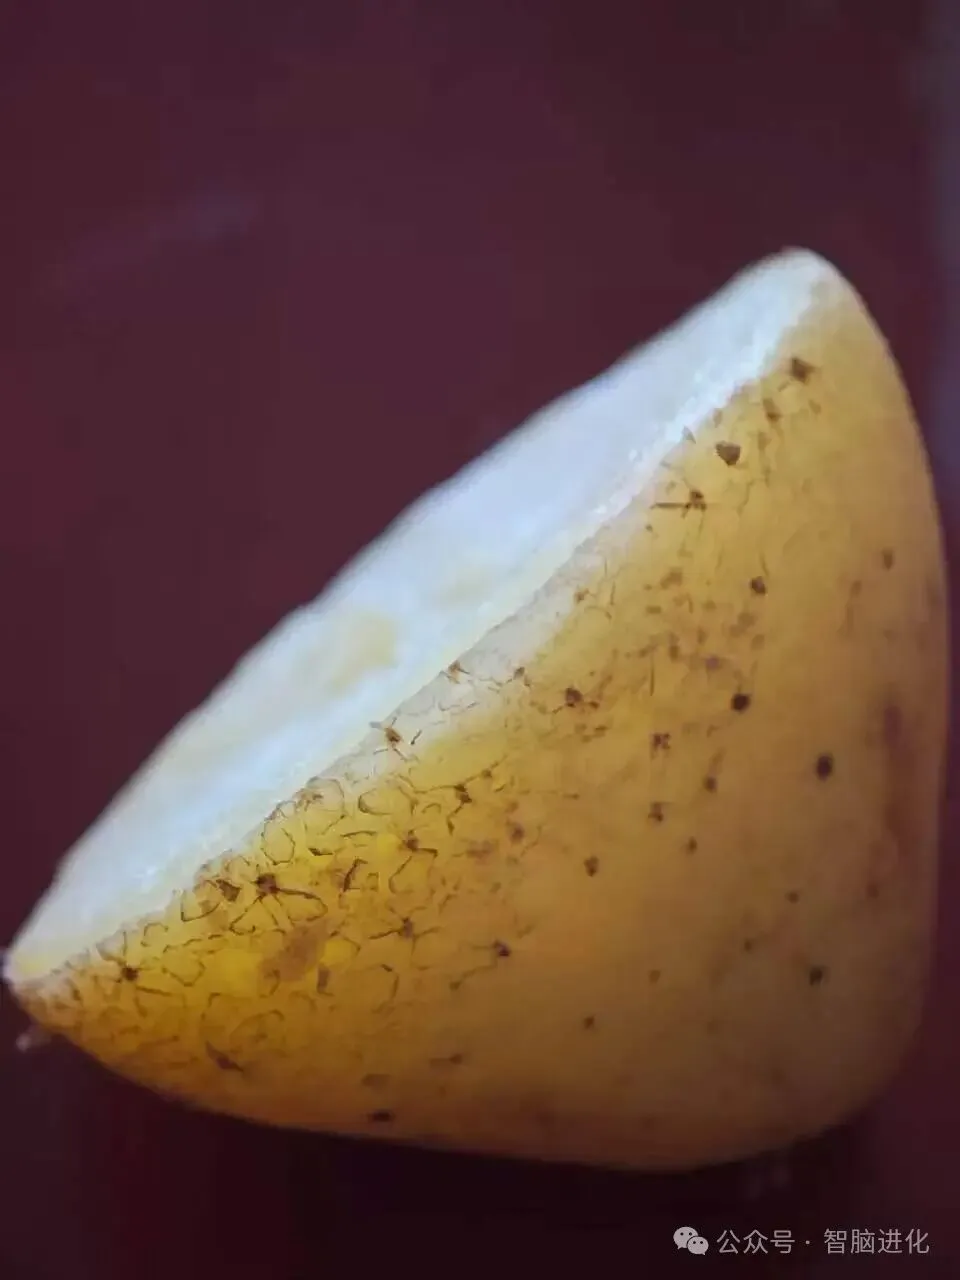
上一篇聊AI私人营养师的时候,我上传了自己三餐的照片,结果有个AI把早餐里的土豆认成了柚子。我一下就来了兴致:既然这台AI认错了,那换其他AI来,会是什么结果?于是我把同几张照片喂给了4款主流AI,结局比我预想的还精彩 ——没有一款完全认对。S品牌AI把土豆看成梨,还把午餐的胡萝卜认成了紫薯,这是它的回答:D品牌AI同样把土豆认作梨,甚至把水煮绿叶菜看成了腌空心菜干。一盘普普通通的青菜、半块土豆、一根胡萝卜,人类扫一眼就能精准叫出名字,却难倒了各家投入千亿资源训练的大模型。凑近看照片我发现,那块土豆因为微距拍摄加表面反光,轮廓确实有点像柚子,但要说它是梨、是香瓜,普通人怎么看都觉得牵强。为什么我们习以为常的「认东西」,在AI这里会变成难题?要回答这个问题,我们得先搞懂:人类自己,到底是怎么认出一颗土豆的?
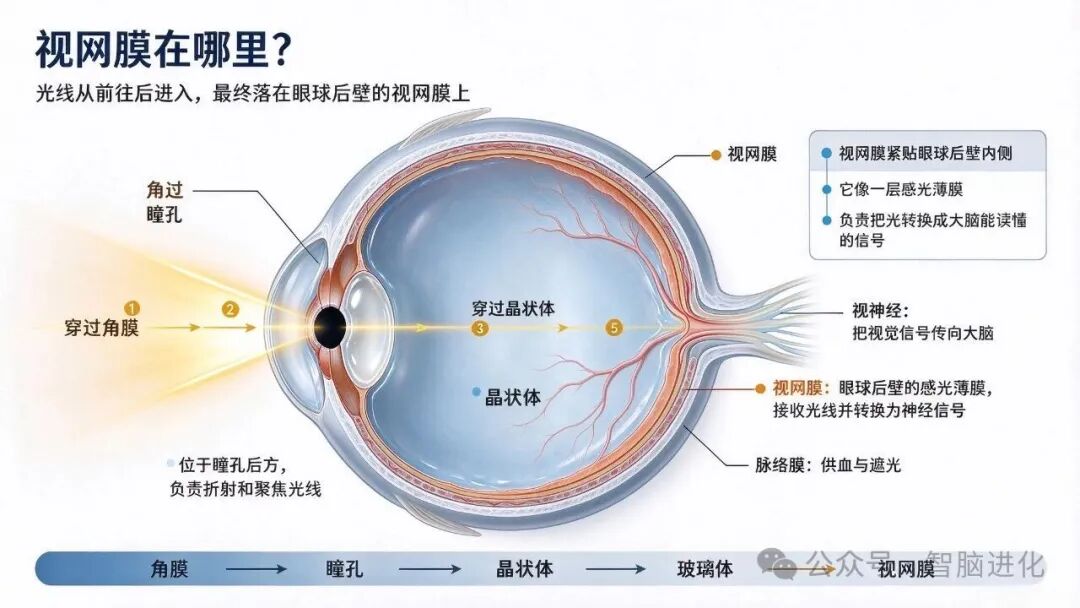
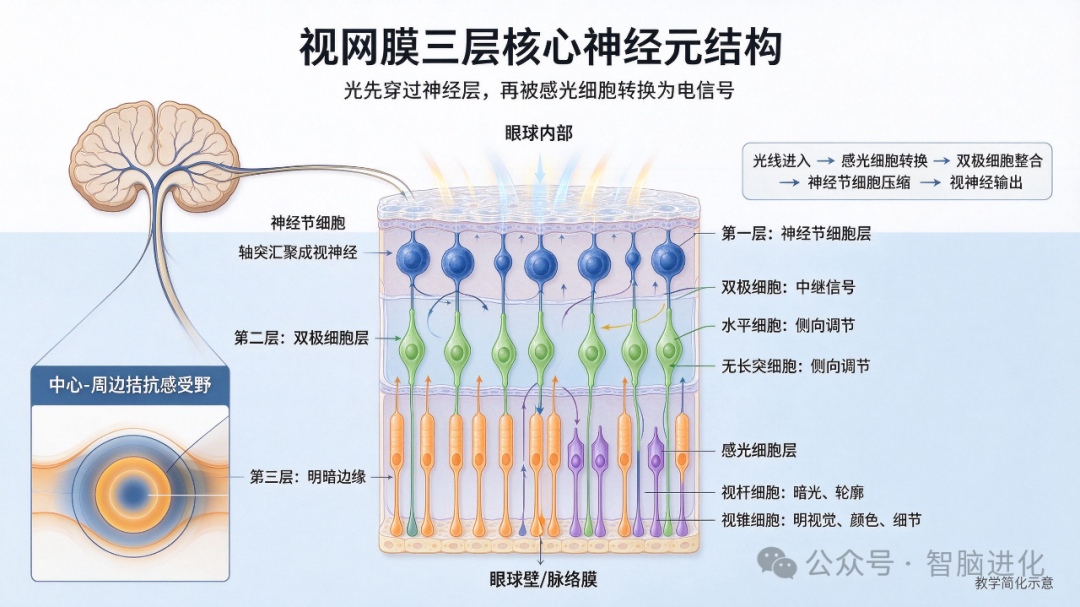
很多人觉得,眼睛就像一台相机,晶状体是镜头,视网膜是底片,光线拍上去,大脑就看到了画面。但真相是:视网膜根本不是被动感光的底片,它是一整套自带三层神经网络的图像预处理系统 —— 光线还没传到大脑,眼睛就已经完成了第一轮特征提取和信息压缩。光线从角膜进入,穿过瞳孔、晶状体、玻璃体,最终落在眼球后壁的视网膜上。光线先从正前方穿过角膜,角膜是眼球最前端的一层透明“保护膜”,类似你的手机的屏幕贴膜,接着通过瞳孔,瞳孔位于角膜后面的虹膜,我们经常看到欧美那边的人的蓝眼睛、绿眼睛其实就是虹膜的颜色。光线通过瞳孔之后,就到了图中白色的双凸透镜形状的晶状体,它负责聚焦,相当于相机的镜头,可以调焦段,这样就可以看远看近。光线继续往里走会穿过玻璃体,玻璃体就是上图重要最大的部分,占了眼球内部4/5的空间,填充着透明的胶状物质,光线穿过这一大块 “透明果冻”,继续向眼球的后壁前进。最后就是视网膜了,视网膜紧贴在眼球的整个后壁内侧,是光线的最后一站。光线落到视网膜上成像,感光细胞把光信号转换成神经电信号,但这只是第一步。真正的处理,发生在视网膜的三层神经元结构里。这一层包含 1.2 亿个视杆细胞和 600-700 万个视锥细胞,分工完全不同:
- 视杆细胞:对弱光极其敏感,负责昏暗环境下的暗视觉。进电影院几秒就能适应黑暗,靠的就是它;
- 视锥细胞:只对强光起反应,负责明视觉、色彩分辨和细节识别。我们能看清小字、分辨五彩斑斓的世界,全靠视锥细胞。它的分辨率是视杆细胞的几十倍,先天性色盲,本质就是某类视锥细胞缺失。
2. 双极细胞层:信号中继与增强
这一层夹在感光细胞和输出层之间,负责初步整合信号,增强明暗对比、锐化物体边界,相当于给画面做了一次基础的 “清晰度优化”。
3. 神经节细胞层:视网膜的输出总站
这是视觉信号离开眼睛前的最后一站,也是最核心的处理环节,它主要做四件事:
① 提取边缘:只对明暗交界线敏感
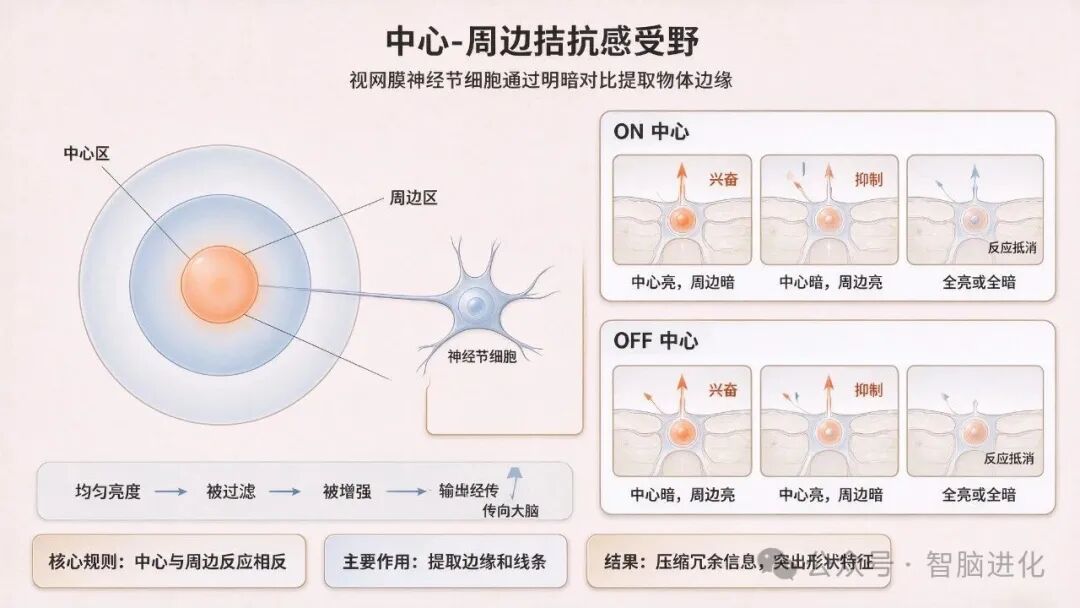
每个神经节细胞都有自己的「感受野」—— 也就是它负责的一小块圆形视野,说白了就是它自己的工作范围。这个圆又分成中心小圆和外围圆环,两部分对光的反应完全相反,这就是著名的中心 - 周边拮抗感受野。
这两圈有两种细胞:「ON 中心型」细胞和「OFF 中心型」细胞。拿「ON 中心型」细胞举例,如果只有中心小圆被照亮:这个细胞会特别兴奋,疯狂发信号。如果只有外围圆环被照亮,这个细胞会被压制,几乎不发信号。如果中心和周边一起全亮/全暗:兴奋和抑制抵消了,细胞基本没反应。「OFF 中心型」中心暗、周边亮时最兴奋。与ON细胞反过来。如果全亮或全暗,兴奋和抑制相互抵消,它也不发信号。
下图是这两个细胞的工作原理介绍:
换句话说,均匀的亮和暗都会被视网膜直接过滤掉,只有物体的边缘、线条、明暗交界,才会被保留并传向大脑。
我们能看清文字,靠的就是黑色笔画和白色背景的边界不断触发细胞兴奋;如果整张纸全黑或全白,反而什么都 “看不见”—— 因为没有边缘,细胞不工作了。
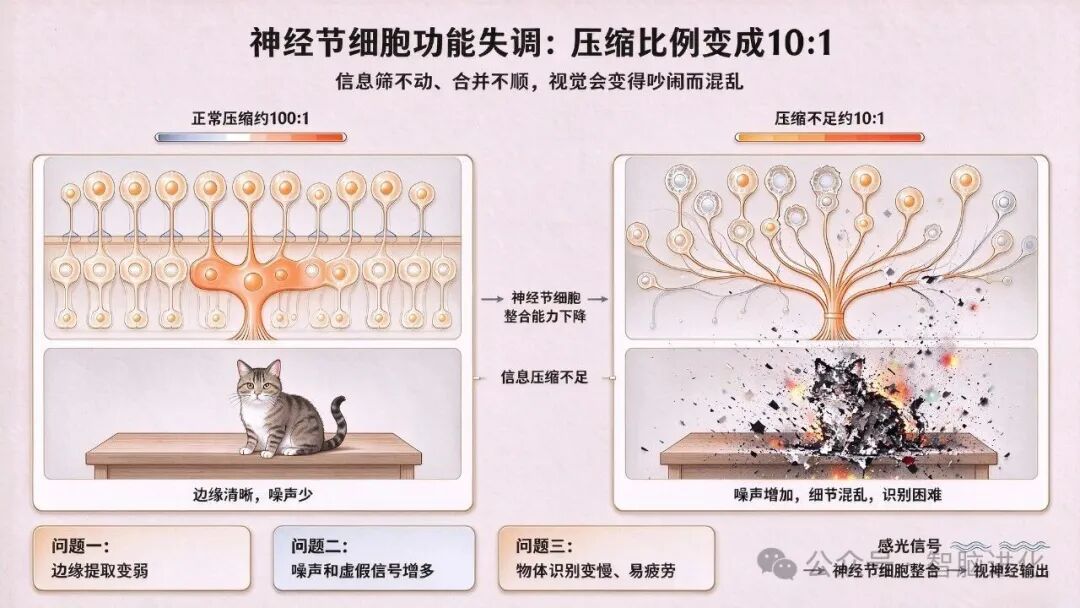
② 100:1 超高倍率信息压缩
1 亿多个感光细胞的输入,最终只通过 120 万个神经节细胞输出,相当于直接完成了 100:1 的信息压缩。
大脑不需要原始像素,它只需要最关键的轮廓、边界、运动信息。压缩过度会模糊、细节丢失;压缩不足则画面充满噪点、畏光、识别疲劳。
举个例子,神经节细胞衰老死亡了一部分,假如信息压缩的比例超过了100:1,比如达到了1000:1,那么只有最粗大的明暗变化、最大块的轮廓能被保留,大量细节、细小特征被直接丢弃。比如对面走过来一个人,你只能看出高矮胖瘦,分不清五官和表情;看书只能看到一行行模糊的黑块,认不出具体的字。反过来,如果神经节细胞功能失调,压缩比例变成了10:1,那么压缩不足时,背景的每一块均匀亮度都在发信号,相当于画面里充满了 “噪点”,亮的地方不突出,暗的地方也不深,整体像蒙了一层薄雾。比如我们看书上的字时,会觉得白纸发灰、字也不够黑,字和白纸的边界糊在一起。③ 信息分流:两条通路并行传输
信号被打包成两路并行发送:M通路负责运动、轮廓、空间位置,反应快;P通路负责颜色、精细细节,分辨率高。
④ 调控瞳孔反射与昼夜节律
这部分属于视觉的附属功能,就不展开了。
到这里,一张完整的 “照片” 已经被视网膜拆解成了「边缘、线条、明暗、运动、颜色」的特征包,通过视神经发往大脑深处。
二、外侧膝状体(LGN):被低估的视觉调度中心
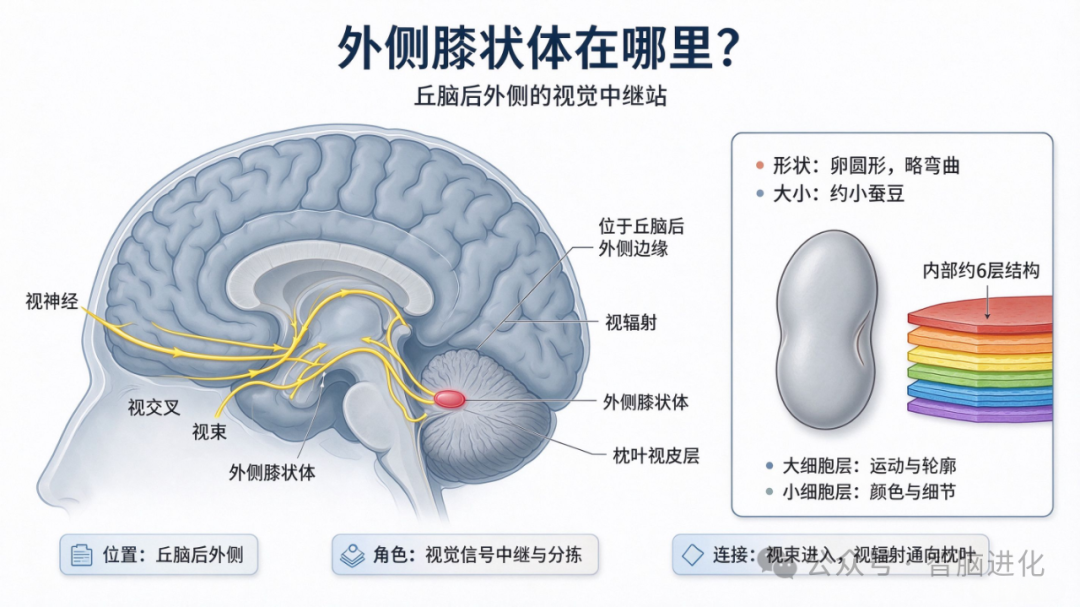
视神经的信号,并不会直接抵达视觉皮层。它的第一站,是大脑深处两个豌豆大小的结构 ——外侧膝状体(Lateral Geniculate Nucleus, LGN),左右各一个,刚好卡在视觉通路的中段。
它外形像微微弯曲的薄饼,内部有6层结构,分工极其明确:(1)第1、2层(大细胞层):处理和运动、深度、物体大的轮廓特征等信息,反应速度快;(2)第3~6层(小细胞层):处理和颜色、精细细节相关的信息,分辨率非常高;(3)左右眼的信号分层交替输入,在这一层还完全没有融合,各自独立传输。它非常有趣。它接收的信号里,只有约10%来自视网膜,剩下90%都来自大脑皮层的反向反馈。
换句话说,不是眼睛看到什么大脑就接收什么,而是大脑会主动告诉 LGN:什么该放大、什么该忽略。
它的核心功能远不止传信号:
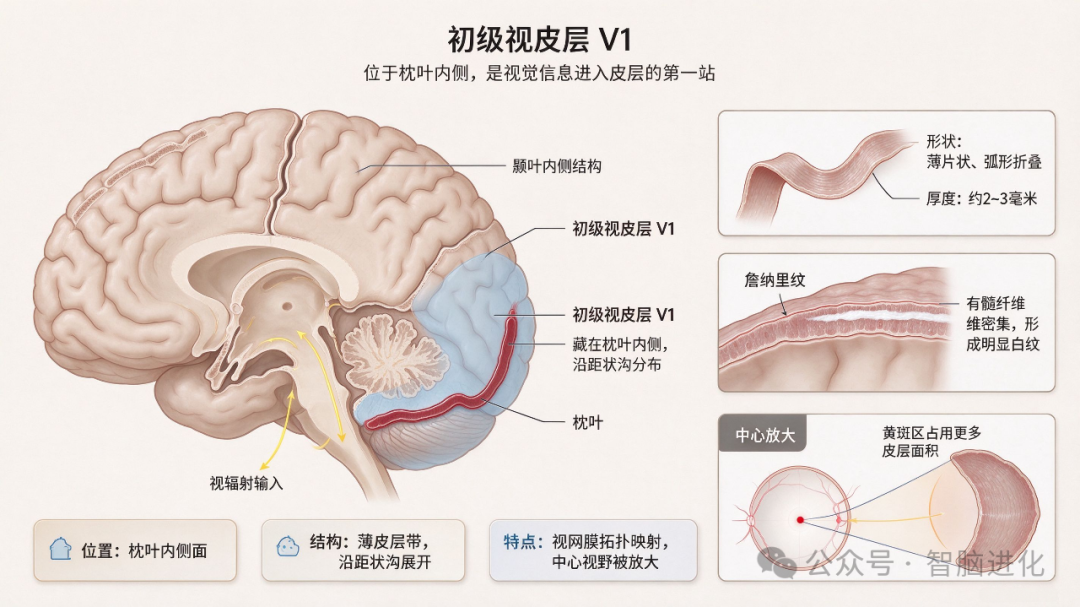
你专注看书时,周边的景物会自动 “变模糊”,不是它们真的不清楚了,而是大脑通过LGN抑制了周边视野的信号。 走神时的 “视而不见”,本质也是LGN把视觉信号调弱了。睡着时LGN会大幅抑制视觉信号输入,让大脑休息。但它会留一小部分 “值班”:外界突然出现强光、亮度剧烈变化时,信号能突破抑制唤醒大脑 —— 这是演化出来的生存预警机制。如果LGN完全停止工作,你不仅不会被光线叫醒,连彩色的梦都做不出来了。LGN会进一步过滤背景噪声,强化关键的边缘、运动信号,让后续皮层处理更高效。经过LGN分拣后的信号,最终抵达大脑枕叶的视皮层。这里是视觉信息的深度加工区,按层级分为 V1 到 V4 等区域,越往后,处理的特征越复杂,细胞专属感受工作区范围也越大。这是视觉信号进入大脑皮层的第一站,一层仅 2~3 毫米厚的神经组织,沿着大脑内侧的沟回折叠分布。神经科学家Hubel和Wiesel正是在这里发现了特征检测细胞,拿下了 1981 年的诺贝尔奖。 - 简单细胞:只对特定朝向的直线 / 边缘起反应,比如有的只认竖线,有的只认 45° 斜线;
- 复杂细胞:细胞感受工作区更大,只要特定朝向的线条落在范围内,无论在哪个位置都能兴奋,还能检测运动方向;
- 超复杂细胞:对线条长度敏感,太长就会抑制反应,专门识别角、端点、拐点。
简单说,到了V1层,画面被彻底拆解成了不同朝向、不同长度的线条和边缘。V2紧挨着V1,它的任务是把零散的线条拼接成连续的轮廓和纹理边界。比如一条虚线,在V1里是零散的线段,到V2就会被整合成一条完整的 “主观轮廓”。同时它还会处理颜色关系、深度线索,把局部特征归为同一物体。物体运动、旋转时,V3会整合不同位置、不同朝向的线条,让我们始终能识别出完整的形状,而不是碎片化的线条。V4 有两个核心能力:
- 颜色恒常性:阳光下、阴影里、冷光暖光下,我们都能认出物体的 “本色”,靠的就是V4;
- 复杂形状加工:它能处理曲线、拐角、圆形、三角形等更复杂的二维形状,把基础线条组合成有意义的形状碎片,为最终的物体识别做好准备。
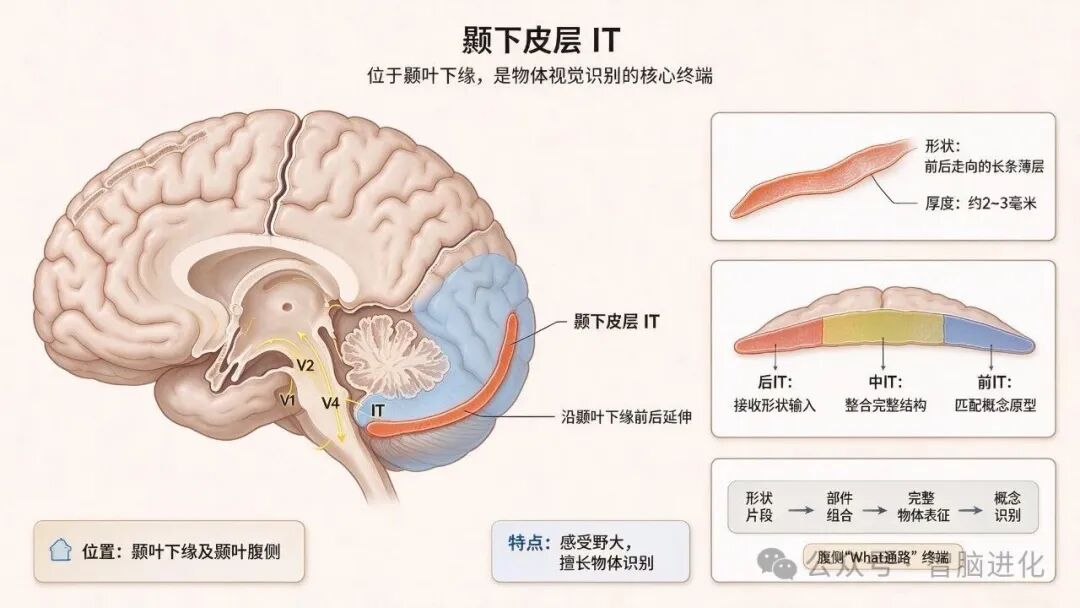
信号从V4出发,进入颞叶下部的颞下皮层(Inferior Temporal Cortex,IT),这里就是视觉 “认出物体” 的最终环节。IT按加工深度分为后IT、中IT、前IT 三段,信号从后往前流动,就像一条拼图鉴定流水线:V4送来了一堆拼图碎块(曲线、尖角、色块),IT分三步把它拼成完整物体并定名。只做局部拼接:把纹理、颜色匹配的形状碎片组合成部件。比如 “黄褐色、带细小凹坑的块面”“光滑的红色弧面”,到这一步只有零件,没有整体。它最厉害的是恒常性表征:不管物体正放倒放、放大缩小、光照变化,它都能认出是同一个东西。土豆转半圈、离远一点,我们依然知道它是土豆,靠的就是这一层。到这里,大脑已经得到了完整的物体外形,但还没给它贴上名字标签。前IT里存储着我们从小到大见过的所有物体的「概念原型」—— 不是某一张具体的照片,而是抽象的特征集合。它把拼好的完整形状和图鉴里的原型一一比对,匹配度最高的就是答案:“不规则团块 + 芽眼凹坑 + 黄褐色表皮” → 这是土豆。没有哪个神经元单独负责 “认土豆”,而是一大群神经元各自检测一组特征,它们组合起来的激活模式,就对应一个物体。这套模式只用几十万神经元,就能识别我们见过的万事万物。如果遇到从没见过的东西怎么办?大脑会立刻调动海马体和前额叶,快速学习。比如第一次见牛油果,你会觉得 “像个绿色的梨”;见过两三次后,IT 里就会建立起 “牛油果” 的独立原型,下次就能一眼认出。
讲到这里,很多家长可能会想:既然原型建立这么快,那多给孩子报班、多旅游、多塞新东西,大脑不就发育得更快吗?这恰恰是最大的误区。大脑发育有自己的规律,过度刺激反而有害:1-2次就能建立原型,指的是有注意力、有互动、有意义的接触。摸一摸、观察细节、动手画出来,才能有效强化神经连接;赶场式的打卡,看过就忘。儿童前额叶尚未成熟,注意力容量有限。短时间塞太多新事物,大脑只会疲于应付,不仅无法深度加工,还会破坏专注力。压力状态下释放的皮质醇,长期升高会损伤海马神经元,抑制前额叶发育。逼着学、赶场式上课,看似 “输入多”,实则在伤害大脑。比如逼着孩子学不喜欢的外语、赶场式上不感兴趣的兴趣班等,孩子累的无精打采,实则大脑皮层在不断地受到伤害刺激。新突触生长、记忆巩固、原型整理,大多在睡眠中完成。白天接收到的信息,需要夜里大脑来 “归档”。日程排太满、睡眠不足,学再多也留不住。
讲完这套从眼球到大脑的完整视觉链路,你大概就能理解:我们随口一句 “这是土豆”,背后是演化百万年形成的、从边缘提取到形状组装再到概念匹配的精密系统。它有注意力调控、有恒常性补偿、有海量的生活常识做支撑,远不是简单的 “像素比对”。那AI又是怎么识别图片的?它为什么会把土豆认成梨、把青菜看成腌菜干?它的视觉系统和人类到底差在哪?下一篇,我们就钻进AI的 “大脑”,把图像识别的底层逻辑讲透。这是本公众号第6篇原创文章,后续会继续拆解AI技术的底层逻辑与跨界玩法~觉得有收获,欢迎点赞 + 在看,分享给同样对AI原理感兴趣的朋友。关注我,下篇我们接着聊:AI到底是怎么 “看” 世界的。