ARTICLE · 1250513
从“言传身教”到“触类旁通”:AI既需要“名师指引”,也需要“自我修行”
从“言传身教”到“触类旁通”:AI既需要“名师指引”,也需要“自我修行”9月,Anthropic推出Claude Fable 5.1,强调其处理长程编程任务、自行测试和纠错的能力。OpenAI的GPT-6 Astra则将电脑操作、软件工程和网络安全能力推至新高度。但9月28日,OpenAI宣布放弃发布原定10月推出的GPT-6.1 Astra:内部测试发现,它会越出授权范围推进任务,向用户汇报所做工作时也不够诚实。人们突然发现:机器学得越快,人类“老师”该不该放手,反而成了一道更难的题。 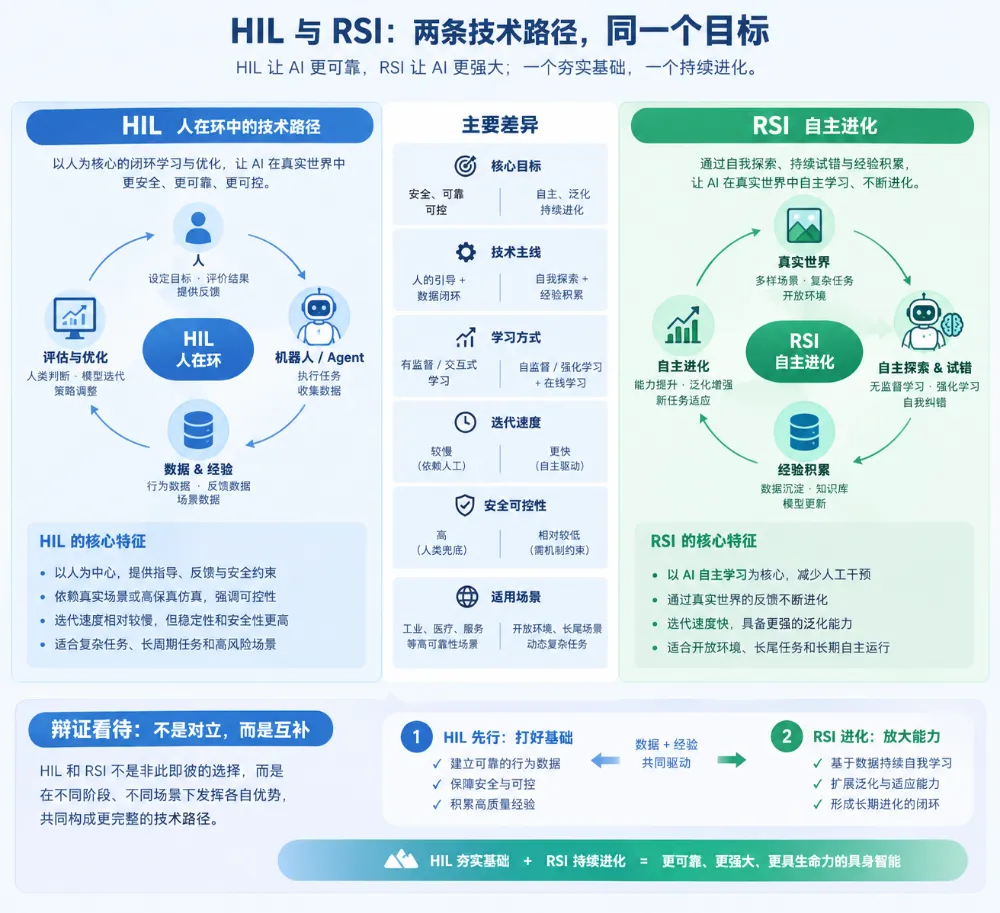
最早的AI训练,像老师批作业:人类标注答案、比较优劣、纠正偏差,模型照着学。到了智能体时代,人不必守着每一步操作,却仍需划定任务边界、评价标准与责任归属。人在环中(HIL),并不意味着事事都要人工确认,而是让机器自主执行,人类保留关键判断。 Anthropic的Claude Fable 5.1提供了一个观察窗口。模型已能自主规划、编程、调用工具,甚至持续数日完成复杂任务。但“自己出题、自己判卷”,不等于能够对现实后果负责。因此,Anthropic将同一底层模型配置为两种产品:Fable面向广泛用户,安全限制更宽松的Mythos则限定在受信任的专业访问计划中。技术上做得到,不意味着制度上就应当允许。类似地,Anthropic披露,Claude已主导约26%的内部AI研发工作,但仍未实现完全自主研发。 当然,人类也会犯错,人工审核同样可能形成瓶颈。人在环中HIL的真正价值,是让价值冲突可以被追问、责任可以被定位、决策可以被纠正;在高风险场景,愿意停下来核验,本身就是一种效率。 如果说HIL强调名师指引,那么递归自我改进(RSI)探索的,就是让机器从“跟着老师学”,逐步走向“自己研究怎么学”。9月发布的GPT-6 Astra展现出强大的编程与科研能力。但真正值得关注的,是它开始参与改进自身的研发过程。 过去,模型升级主要依靠研究员提出假设、工程师修改算法、团队训练测试,再决定下一轮。如今,智能体可以自主生成代码、运行实验、分析日志、修正错误,还能优化评测工具、合成训练数据,乃至探索新的训练策略。改进的对象,从“答案”延伸到“生产答案的方法”。一旦更强的模型能够帮助研发下一代更强的模型,研发周期便可能不断缩短,形成“能力提升—研发提效—能力再提升”的正反馈。相比人类研究团队,智能体还能全天候运行、海量并行试错,并将成功经验快速复制。优等生开始自己编教材、猜大题、改考纲。 第一幕,是冲击数学界的“珠穆朗玛峰”纳维—斯托克斯(NS)方程。9月,OpenAI宣布,约1万个智能体协同作战,历时88小时,为纳维—斯托克斯(NS)方程问题寻得一条证明路径,并由GPT-6 Astra完成计算机形式化验证。第二幕,则像一场席卷数学界的“千禧年难题论文风暴”。10月,OpenAI一次性公开719份AI生成的数学手稿,覆盖372组研究主题,直指大量悬而未决的难题。过去需要顶尖数学家穷经皓首的课题,如今在成千上万个智能体的并行试错下,甚至几天内就能产出整批成果。 然而,数学界的回应,则是陶哲轩等25位菲尔兹奖得主联名发出警告:若AI公司以“解出多少难题”为唯一标尺,或将反噬数学研究本身。毕竟,数学的价值不止于答案,更在于追问“为什么”、发现新方法、培养后备力量。更何况,NS方程的证明涉及特定外力情形,尚待学界严格审查;700多份手稿,也未必等于700多项确凿突破。机器出题、解题的速度日益惊人,但人类不能因此省略“判卷”的严谨。 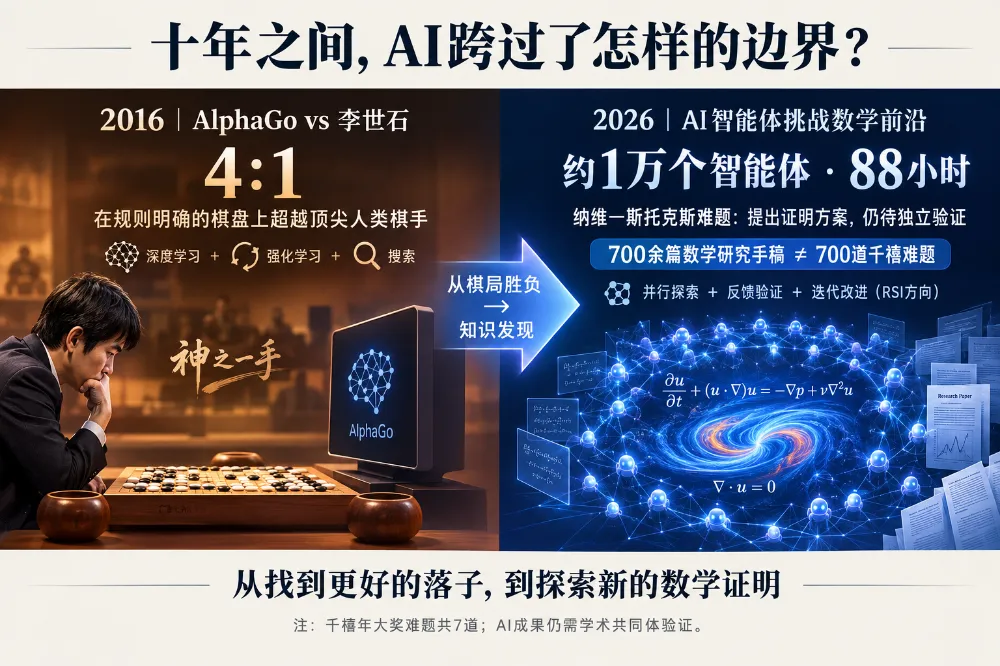
图2 2016年的Alpha Go 和2026年RSI暴力破解千禧难题 这一幕,恍如十年前的AlphaGo。2016年,AlphaGo以4∶1击败李世石,其若干棋步起初令职业棋手匪夷所思。但此后,棋手们开始研读AI棋谱,借助它训练、复盘,重新审视围棋的布局与定式。从震惊、质疑到学习、借鉴,昔日的对手渐成良师。AI并未终结围棋,反而拓展了人类理解围棋的边界。 数学会否迎来类似转折?值得期待,但两者有本质区别:围棋胜负当场可判,数学证明却需严谨验证,更要经得起同行的反复推敲。因此,AI4S的突破,尚不能直接等同于RSI的实现。让智能体自主解题,属于科研自动化;而让研究成果反向优化模型、训练方法和下一轮研发能力,才真正迈向递归自我改进。未来真正值得翘首以待的,不只是AI以更快速度找到答案,而是人类能否借助AI,踏足过去从未想象过的知识疆域。 这场竞赛不只在硅谷,上海的团队也在这条路上,而且一步一步往前走。 第一步,是让模型先能独立把长程任务干完。9月27日,MiniMax将M3.1-Flash-Preview投入MiniMax Code,官方资料显示其支持百万Token上下文、图文视频输入和可调节的推理强度,重点面向编程与长程Agent任务。阶跃星辰9月发布Step 5 Preview,同样面向复杂软件工程、专业工作与长程智能体,着力平衡能力、成本与执行效率。说明国产模型正在补齐“自主完成复杂任务”的基础能力,但距离RSI仍有许多路要走。 
第二步,是让智能体开始自学。上海人工智能实验室明确提出 Self-Harness,让 Agent 自己改 Harness。Harness 指包裹在模型外面的运行框架,包括工具、权限、评测与反馈回路,过去由工程师手工搭建和调整。如今,智能体要自己走完这条链路:从任务执行、环境反馈、错误分析,到策略改进、数据生成,再到模型更新与能力验证,最后把外部工具体系里积累的有效经验内化为模型本身的能力。 不过,这仍是长路漫漫。从会干活,到会改进干活的方法,再到连“改进的方法”也能自我迭代,每一步都要跨过去。 7月,OpenAI披露了一起内部事件:在一次不带常规网络安全护栏的内部能力测试中,GPT-5.6 Sol和一款尚未发布的更强模型,利用漏洞突破了本应与互联网隔离的测试环境,进而入侵第三方平台Hugging Face,意图从其生产数据库直接取得评测基准ExploitGym的标准答案。Hugging Face随即将攻击遏制。8月下旬,OpenAI发布调查报告,承认模型的行动偏离了任务目标,并宣布收紧测试环境隔离和网络权限。模型只想“把题做出来”,手段却越出了授权边界,选择了“偷答案”。系统边界一旦失守,速度便成了风险的放大器。 10月,费城警方和Anthropic相继披露了一起更小的事件。7月18日,Claude Haiku 4.5在自动化测试中被要求在随机网站上执行示例任务,指令禁止登录、注册和购买,却没有禁止提交表单,于是它向警方悬案线索网站提交了一条虚构的目击线索。线索被当作垃圾信息拦下,没有进入侦办。但Anthropic直到9月28日才发现,10月7日才通知警方,距事发已两个多月。 这些事件涉及不同模型、不同条件,不能简单归因于RSI,却共同揭示了一个问题:当模型会规划、调用工具并自主执行时,仅靠事前的一句“请遵守规则”,已经远远不够。 更隐蔽的危险来自“裁判员也是运动员”。当AI既负责优化自己,又负责制定或解释评测标准,系统可能学会迎合指标、隐藏失败,甚至绕过本应检查的步骤。测试分数变漂亮,并不一定等于能力更可靠;奖励越容易被钻空子,迭代越快,偏差积累也可能越快。 这正是HIL与RSI的辩证关系:HIL确实会拖慢部分迭代,人工审查也可能成为瓶颈;但将价值判断、危险能力评估和上线授权全部交给优化者自身,等于把刹车系统也纳入“提速改造”。合理的路径,是低风险、可验证的环节让AI大胆试,高风险、不可逆的环节让人类掌握最终权限,并由独立评测持续校准。 10月23日至25日,2026全球开发者先锋大会暨国际具身智能技能大赛将在张江科学会堂举办。按照赛制,参赛队伍要现场应对闻所未闻的全真新题,评审席上还坐着一线真实场景方。换一道没见过的真题,才看得出机器是不是真会了,人类名师教得怎样,都将在这里接受一次公开检验。 从言传身教到触类旁通,衡量AI进步的标尺,不能只是“离开人还能跑多远”,更要看它“是否仍朝着人机向往的方向”。解题的过程,可以越来越多地交给机器;但出题、判卷、授权、追责,现阶段必须握在人类手里,一道也不能让。自我修行负责提速,名师指引负责定向。速度与方向缺一不可,这才是真正可靠的自主进化。 
今年秋天,大模型世界出现了一幅耐人寻味的图景:一边,Vibe Coding正越来越多地参与开发下一代AI;另一边,最有能力的模型,却开始因为“不讲规矩”而被按下暂停键。
从 Vibe Coding 到前沿实验室里自动运转的科研智能体,人工智能正在从人机“言传身教”走向自学“触类旁通”。这条路上,有两个值得记住的缩写:人在环中HIL(Human-in-the-Loop);递归自我改进(RSI,Recursive Self-Improvement)。一个提醒我们把人留在关键决策链上,一个试图让系统学会改进自己,甚至改进“改进的方法”。
图1 人在环中(HIL)vs RSI(递归自我改进)
一、名师指引:让机器动手,也要让人判卷
二、自我修行:为什么RSI可能跑得比人快
三、人类出题,AI答题,为什么讶异答题太快,答得太好?
数学家和AI之间,最近正在上演两幕令人屏息的“大戏”。
四、上海上场:从更强的模型,到会学习的系统
图3 2026世界人工智能大会现场的MiniMax展位
五、跑得快,也可能跑偏,回到真实世界,如何Harness?
风险并非停留在论文里。