ARTICLE · 1258452
CCAI|AI通识20讲(6/20)——RAG检索增强
怎么给"知识会过期、还会编造"的大模型,配一本随时能翻的"诊疗手册"
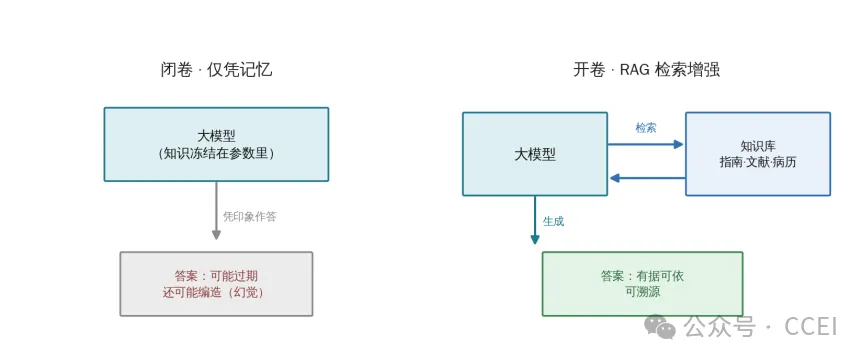
上一讲我们把大模型的能力拆到最底层:它靠预训练把知识"焊死"在参数里,规模跨过某个阈值才"涌现"出某些本领。但正因为知识是训练那一刻冻结进去的,带来了两个临床最在意的麻烦:一是知识会过期——模型不知道你昨天刚更新的院内指南,也没读过上周新发表的文献;二是它会编——遇到没把握的事,常常一本正经给出流畅、自信却可能错误的答案,也就是"幻觉"。
有没有办法,让模型像一位严谨的主治医师那样:回答前先翻最新的诊疗规范、看一眼眼前患者的资料,再下结论?这一讲就讲当下最实用的一项关键工程技术——RAG(检索增强生成)。它的思路很朴素:不逼模型"死记硬背",而是给它配一本随时能查、还能标注出处的"外置手册"。
其一是知识冻结。模型的训练数据有截止日期,之后发生的事——新指南、新药、本院流程、眼前这位患者的病情——它一概不知。让一个"只读到去年"的模型回答今年的规范,天然不可靠。
其二是幻觉。当模型缺乏依据时,它很少老实说"我不知道",而倾向于拼出一个流畅却可能虚构的答案,编造出处更是常见。对临床而言,"自信地答错"比"诚实地不会"危险得多。
训练,说白了就是一个天文数字级别的对表过程:不断微调每一个刻度,让模型预测下一个字的误差一点点变小。所谓"预训练→微调→对齐",本质都是在这一堆参数上做精细调整,只是调整的目标和数据不同。
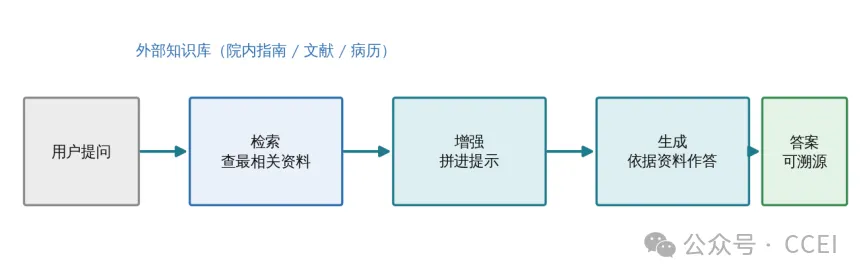
一位专家受邀会诊,不会凭空开方,而是先调阅病历、化验、影像和最新指南,再给意见。RAG 就是给模型装上这套"先调阅、后判断"的流程:检索=调阅资料,增强=把关键资料摆上桌,生成=综合资料给出意见。
RAG 的天花板几乎全写在"检索"这一步——查得不准,后面再强也白搭。要让机器在一堆文档里"按意思"找到相关段落,靠三个动作。
切块(Chunking):先把长文档切成一段段合适大小的片段,太小丢上下文、太大混入噪声,类似给资料归档分册。
嵌入(Embedding):用模型把每段文字转成一串数字(向量),语义相近的文字在向量空间里彼此靠近。
语义检索:把问题也转成向量,去向量库里找距离最近的几段——它匹配的是"意思相近",而非死磕关键词。你问"退烧药",即便原文写的是"解热镇痛药",也能被找出来。检索后还常用重排(rerank)把最相关的几段再精排一次。
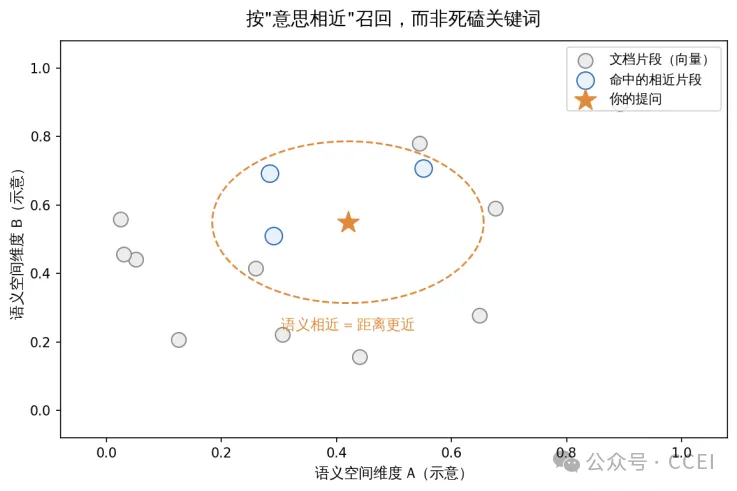
图 2 语义检索示意:文档被嵌入成向量,按"意思相近"(距离近)召回,而非字面关键词
理想的病历系统不该只按字面关键词查找,而应能"按含义"命中:搜"抗凝",就该把肝素、华法林、凝血相关的记录一并召回。RAG 的向量检索,正是给文档建了这样一层"按语义编号的索引",让"意思相近"取代"字面相同"。
垃圾进、垃圾出。知识库本身有错、有偏、过期,或切块/检索没找对,答案照样错——而且因为"看起来有出处",更容易被轻信。
只到"检索到的部分"。模型只对召回的那几段负责;关键信息若没被检索命中,它也无能为力。
它不是推理器,更不是诊断器。RAG 擅长"依据资料作答",不等于临床判断;资料再多,也不能替代医生对具体患者的评估与责任。
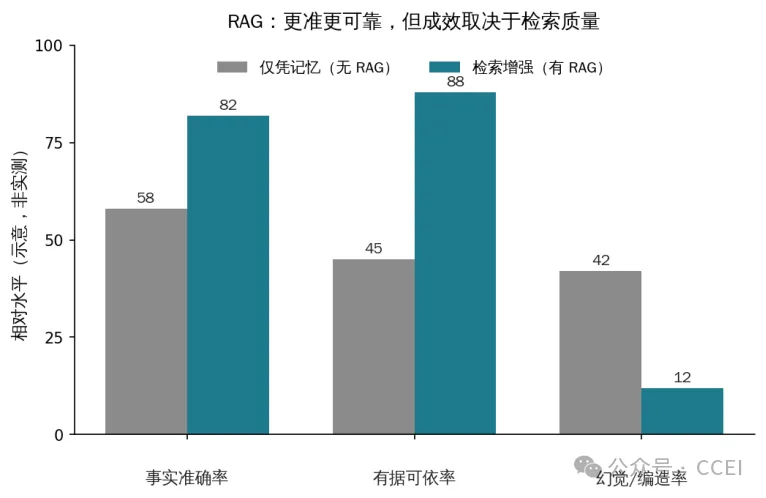
图 3 示意对比:RAG 通常提升事实准确与有据性、降低编造,但成效取决于检索质量(数值为示意)
检索不准,好比会诊时调阅了错误患者的化验单——流程再规范,结论照样被带偏。因此上线一套临床 RAG,数据治理(来源可信、版本最新、权限合规)往往比"换个更大的模型"更关键。
适合"有据可查"的场景:院内指南与流程问答、文献速览、病历文书辅助、检查检验解读等,这些有权威资料库、重"准确+溯源"的任务,正是 RAG 的主场。
优先看"溯源"而非"流畅":一个好用的临床 RAG,应能把结论对应到具体出处,方便你逐条核对;只会流畅作答却不给来源的,要谨慎采信。
把数据治理当第一工程:知识库的来源、更新、脱敏与权限,决定了它可靠的上限;别把力气全花在"换个更大的模型"上。
永远保留人的判断:RAG 提高的是"有据可循"的概率,临床决策与责任仍在医生手中——它是得力的资料助手,不是替你拍板的人。
痛点:模型知识会冻结过期、还会幻觉编造,RAG 用"先查后答"补上这两块短板。
原理:检索→增强→生成,把权威资料拼进提示,让答案"有据可依"、可溯源。
找得准靠三招:切块、嵌入、语义检索(按意思匹配而非关键词),再配合重排。
有上限:检索与知识库质量决定天花板,垃圾进垃圾出;它是资料助手,不是诊断器。