ARTICLE · 1282272
从文档孤岛到知识网络
从文档孤岛到知识网络做企业知识库的朋友大概率都踩过同一个坑:文档存了几百份,真要找个信息,还是得翻半天。纯向量RAG这两年很火,但用久了你会发现一个问题——它擅长“找相似段落”,不擅长“理清楚关系”。问它两个实体之间有什么关联,它经常各自返回一堆相关片段,中间的逻辑链全靠大模型自己脑补。 知识图谱倒是能把实体关系串起来,但从零搭一套语义图谱工程太重,光是本体设计和人工标注就能耗掉一个团队几个月。这次分享的案例,就是把这两条路捏到一起的一次实践——用WeKnora做底座,让智能体自己决定什么时候走向量、什么时候走图谱。 WeKnora的定位是大模型驱动的企业级知识框架,核心做三件事:RAG检索增强、ReAct智能体推理、Wiki知识库。它不是简单的向量库套壳,而是把ReAct循环嵌进了检索流程的每一步。 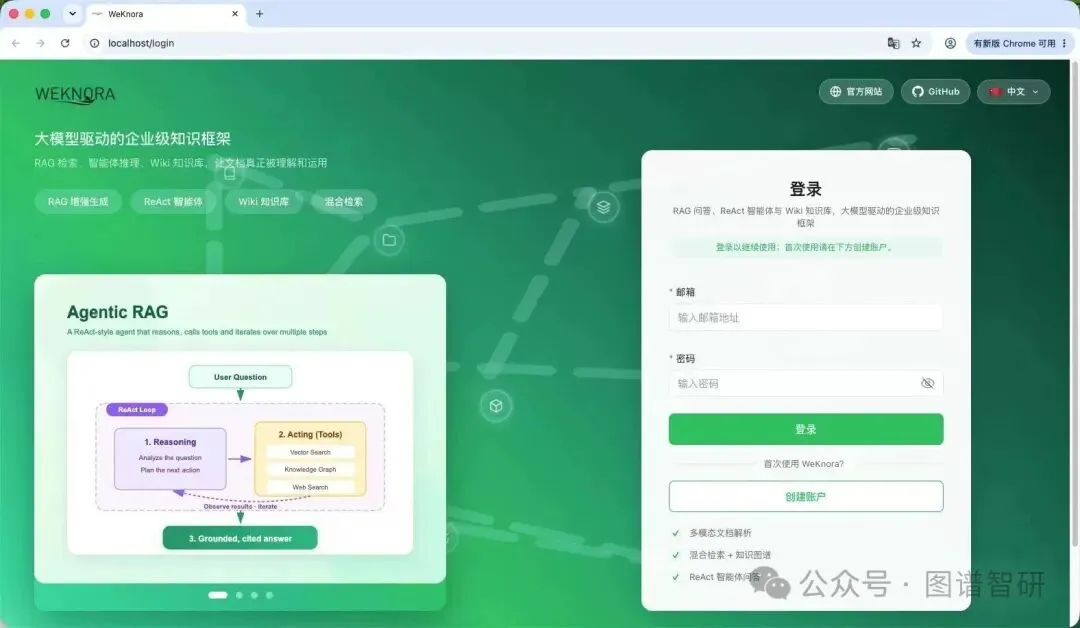
从架构图上能看得很清楚:用户问题进来后,智能体先进入Reasoning阶段,分析问题意图并规划下一步动作;然后进入Acting阶段,自己选择调用向量检索、知识图谱查询还是Web搜索;观察返回结果后判断信息够不够,不够就继续迭代,最后输出带引用的、有据可查的答案。 关键设计点:图谱不是外挂的可视化玩具,而是作为工具层的一等公民,由智能体根据问题类型动态调用。问事实性问题走向量,问关系型问题走图谱。 传统知识图谱项目最耗人的环节,是数据接入和实体抽取。WeKnora在这块做了一层Skill封装:通过REST API就能把PDF、Word、Excel文件批量导入,也支持直接抓URL网页内容写入知识库,还能以Markdown形式结构化创建条目。 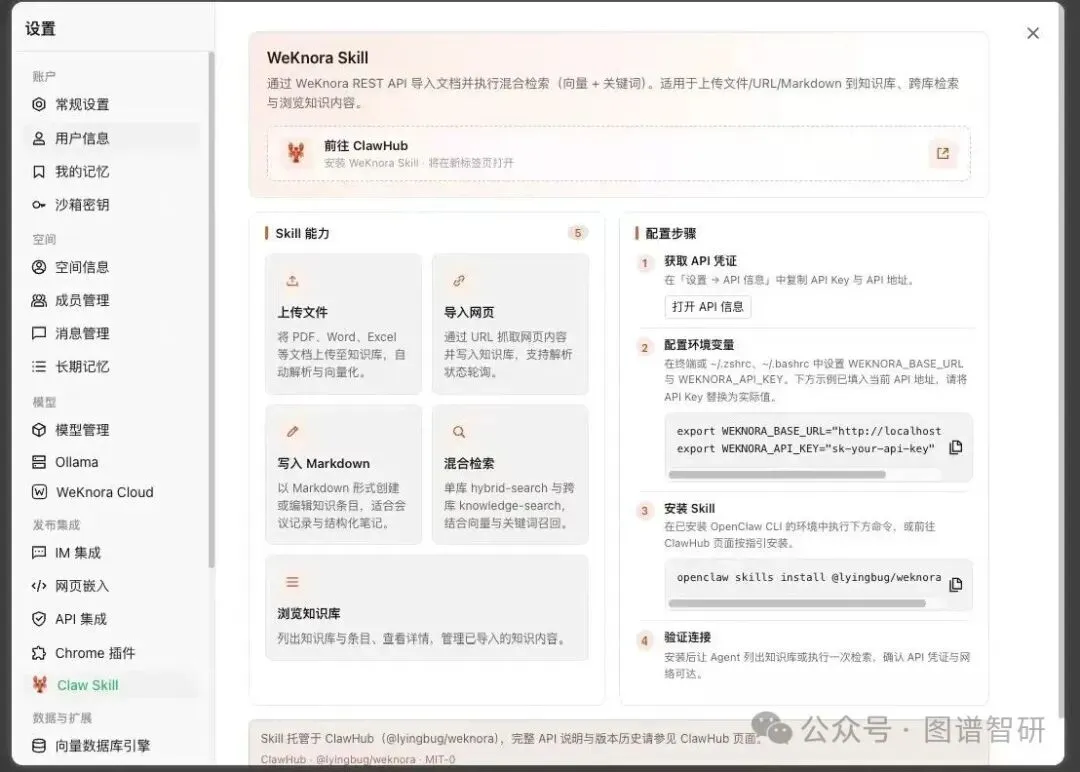
底层做的是混合检索——单库同时跑hybrid-search和跨库knowledge-search,向量召回和关键词召回并行,再由智能体做融合排序。对企业场景来说,这种设计很务实:既保留了向量检索的语义模糊匹配能力,又保住了关键词检索对精确术语的命中率。 图谱构建完成后,先看全景拓扑。下图是整体知识网络的鸟瞰视角:颜色区分不同类型的实体,节点大小对应连接度。能明显看到几个密集的绿色集群,那是核心业务域的实体,周围放射状散开的是长尾概念。 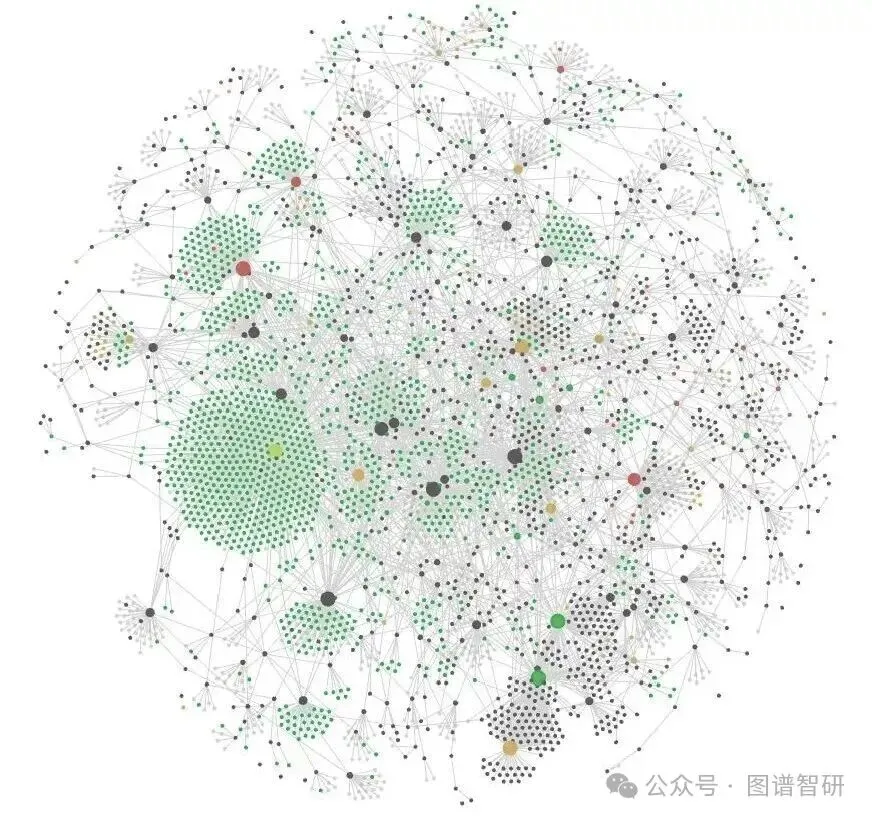
放大到局部看,实体间的关联链路就清晰了。不同颜色的节点代表不同类型的实体(比如绿色是业务对象、青色是流程节点、黄色是组织单元),边的粗细反映关联强度。这种可视化的价值在于,它能让业务专家一眼看出哪些实体是中心枢纽、哪些连接是断的、哪些关系可以补全。 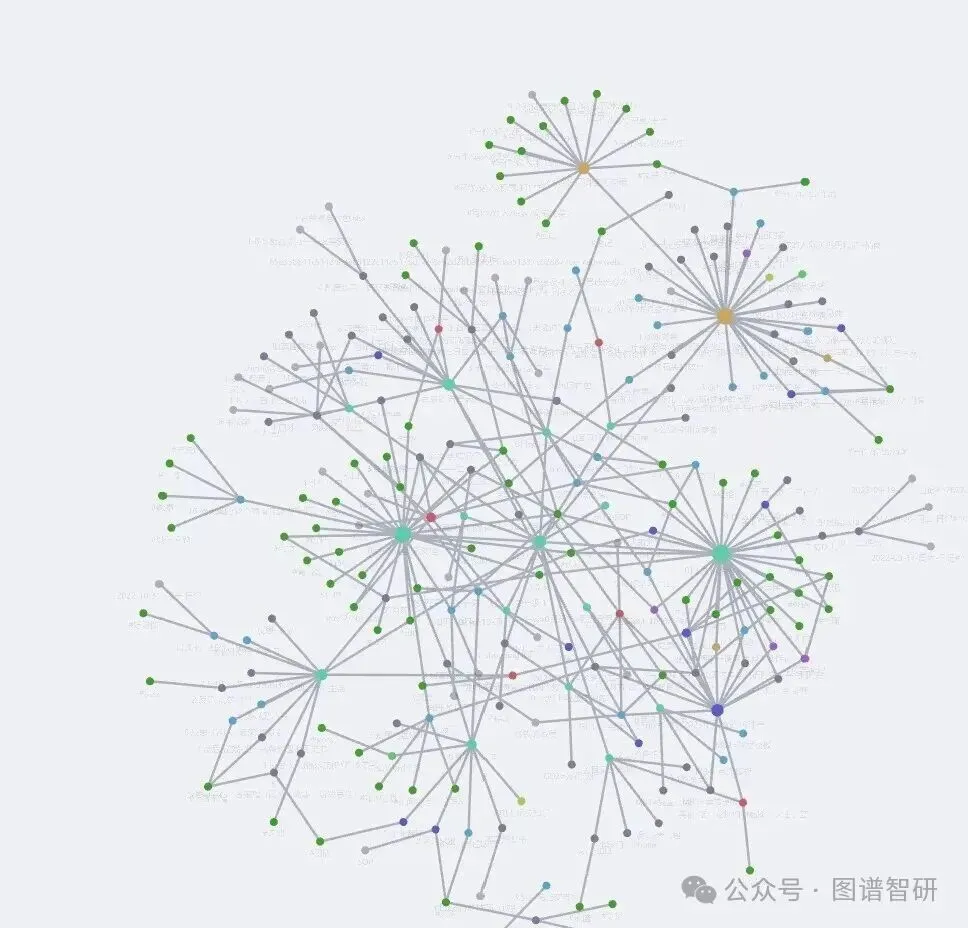
换一个渲染视角看,整体网络的社区结构更突出。蓝青色高亮度节点是入度和出度都很高的核心实体,周围辐射出大量叶子节点。这种“核心—边缘”的拓扑形态,和企业知识的分布规律是吻合的——少数关键概念撑起大部分关联,绝大多数实体是长尾。 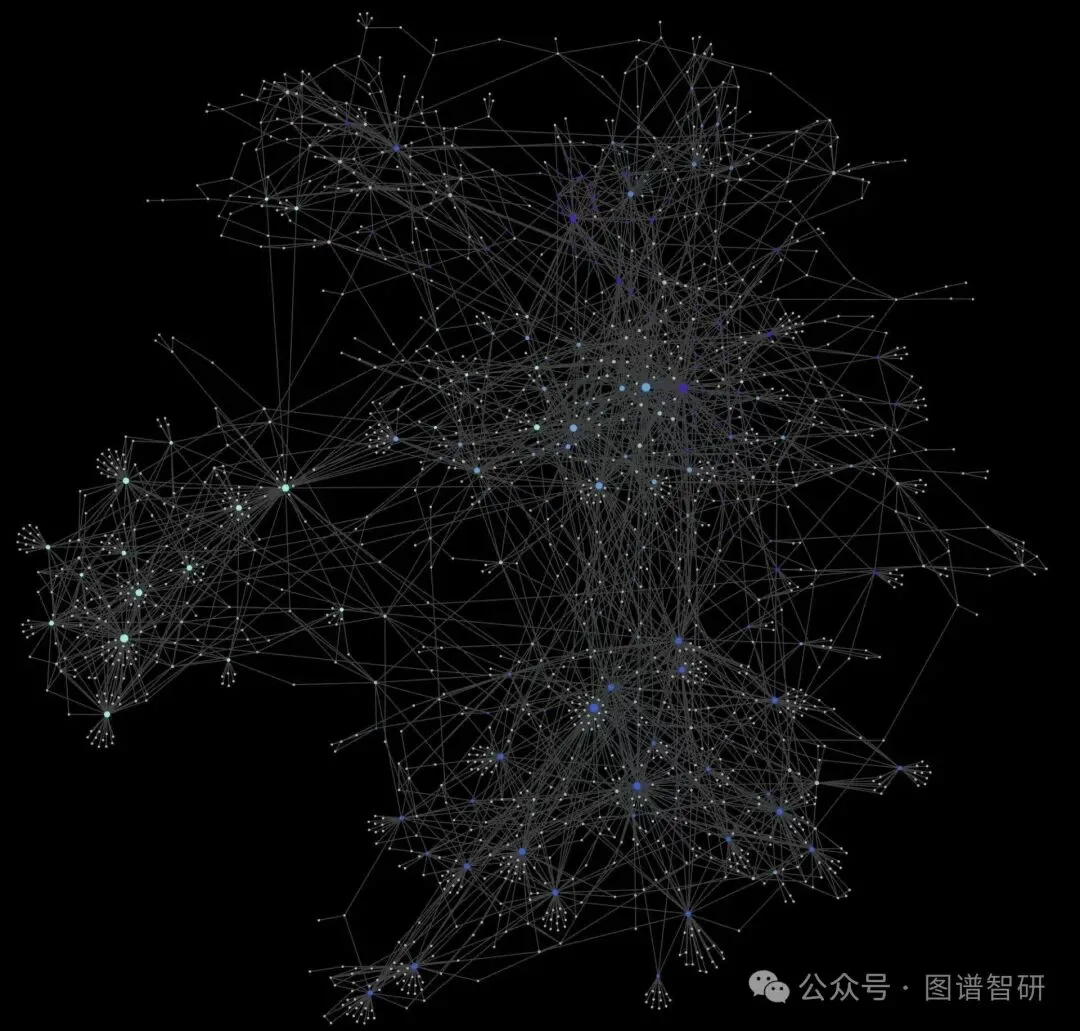
单靠向量检索的时候,问“A和B之间是什么关系”这类问题,系统经常只返回分别提到A和提到B的两段文档,中间的因果链、从属链全靠大模型在生成时临时拼接,可追溯性很差。 加上图谱检索通道后,智能体能顺着边把关联路径直接拉出来——比如A→属于→部门X→负责→项目Y→关联→B,这条路径是结构化存下来的,不是临时从文本里猜的。答案的每一步推理都能回溯到具体的图谱边,引用链条完整。 这套实践的核心思路其实不复杂:不是用图谱替代RAG,而是让两者在智能体框架里各干各擅长的事。企业落地知识图谱,也不用一上来就追求大而全的本体工程,从现有文档自动抽取、从小范围图谱切入,性价比反而更高。 工具链已经搭得差不多了,真正拉开差距的,是后面怎么把业务知识喂进去、怎么把图谱质量养起来。
有问题找我 a70807912
WeKnora + 知识图谱的企业知识库落地实录
一、底座:Agentic RAG不是把图谱当摆设
二、构建:从文档到图谱的自动化链路
三、看图:几百个节点聚出了什么结构
四、落地价值:混合检索到底好在哪
写在最后
本人长期承接知识图谱、RAG 系统搭建、企业知识库定制类项目,技术栈覆盖 Neo4j + LangChain + LlamaIndex + FastAPI 全链路,做过医疗、金融、企业内部知识管理等多个落地案例。有需要做系统开发、毕设辅助、技术方案咨询的,后台私信聊,价格好商量。
另外,做仿真代做(COMSOL/Abaqus/Fluent)和 Python 爬虫、企业自动化开发也接,老客户介绍有优惠。