ARTICLE · 1284263
把软件「拆开」看能拆什么,又拆不动什么
软件只能当黑盒来用?
把软件「拆开」看
能拆什么,又拆不动什么
REA 本地封装 · 中文点选 · 全程离线 · 数据不出本机
曾观淮上云 · REA 逆向分析工作台
— 拆解一个程序之前,先沉下心看清它的边界
📦 9 Parts + Conclusion
👉 滑动
PART 01
拆的是什么
四层翻译
PART 02
不是反编译器
先分清误会
PART 03
内置引擎
各自分工
PART 04
分析步骤
九步闭环
PART 05
练手目标
选对第一题
PART 06
工具对比
省在哪差在哪
PART 07
三步上手
不用先写代码
PART 08
拆不动什么
边界先说清
PART 09
合规红线
只碰该碰的
PART ///
写在最后
信任与安全
你每天打开的 App 和软件
从点下按钮到画面响应,中间到底发生了什么
你每天打开的 App 和软件,从点下按钮到画面响应,中间到底发生了什么?绝大多数人只能看到结果,看不到过程——对使用者来说,软件是一座「黑盒」。
近期,开源项目 REA 在技术圈被广泛讨论,评论区也出现了「以后什么软件都藏不住」之类的说法。热闹之外,更需要先把两件事分清:这类工具能拆什么,又拆不动什么。
这篇文章不制造神话,只把一套面向普通用户的 REA 逆向分析工作台讲清楚:它是什么、怎么工作、适合分析什么、边界在哪里,以及三步如何上手。
01
PART
先搞懂:所谓「拆开看」,到底拆的是什么
WHAT IS REVERSE · 四层翻译
程序编译之后,落到硬盘上是一串机器才能读懂的字节。要理解它,逆向分析一般要经过四层「翻译」:
机器字节 → 汇编指令:一段一条对应到具体操作;
汇编指令 → 伪 C 代码:把相近逻辑还原成接近高级语言的可读片段;
函数与调用关系:谁调用谁、参数怎么传、分支往哪里跳;
行为归纳:结合字符串、导入表、资源信息,判断这段代码大概在实现什么功能。
打个比方,这不像厨师照着菜谱做菜,更像把一台已经组装好的机器拆开:先认零件,再看装配关系,最后理解每个部件的作用。需要先记住一点:这是「理解现有程序」,而不是把原始工程图纸原样找回来。
02
PART
先澄清一个误会:它不是新造的反编译器
MISUNDERSTANDING · 先分清能力边界
一句人话:
REA 全称 Reverse Engineer Anything(可理解为「逆向一切」),是一个开源的本地 MCP 服务与命令行工具;它本身并不重新发明反编译引擎,而是把 Ghidra、JADX、angr 等已经成熟的工具组织成一套可调用的分析流程。本工作台做的事,是把 REA 与这些引擎、环境配置、报告模板和提示词,整合进一个中文可视化桌面界面,解压之后点选即可使用。
一句提醒:名字里的「逆向一切」指的是可以覆盖的目标种类宽度,并不等于分析深度;能不能分析透,仍然取决于底层引擎、目标本身以及人的判断。
一句排除:它不是「一键还原原始源码」的魔法。包括所有同类工具在内,反编译器都无法保证还原出原始工程代码:原始变量名、注释、类型结构,以及作者的设计意图与架构取舍通常都会丢失,得到的是一份逻辑上的近似伪代码;它也不是破解、去壳或绕过授权的工具。
一句关系:它面向想学习软件原理、研究自有或开源程序、做上线前自查的开发者与技术爱好者,把原本需要自行安装 Node、配置命令行、阅读英文文档的门槛,收进一个点选界面。
03
PART
内置哪些引擎,分别管什么
ENGINES · 多引擎协同分工
工作台内置多套成熟引擎,按目标类型自动选路,各自负责擅长的环节:
工作台当前支持的目标类型包括:exe、安装包、APK、ELF、JS / Electron、.NET,以及鸿蒙 hap、abc、app。
首次启动会自动进行环境自检:检测 Node、Ghidra、JDK、REA 脚本、JADX、管理员权限、磁盘空间、CPU、内存与 GPU 显存;缺什么、怎么补,界面上直接给出指引。
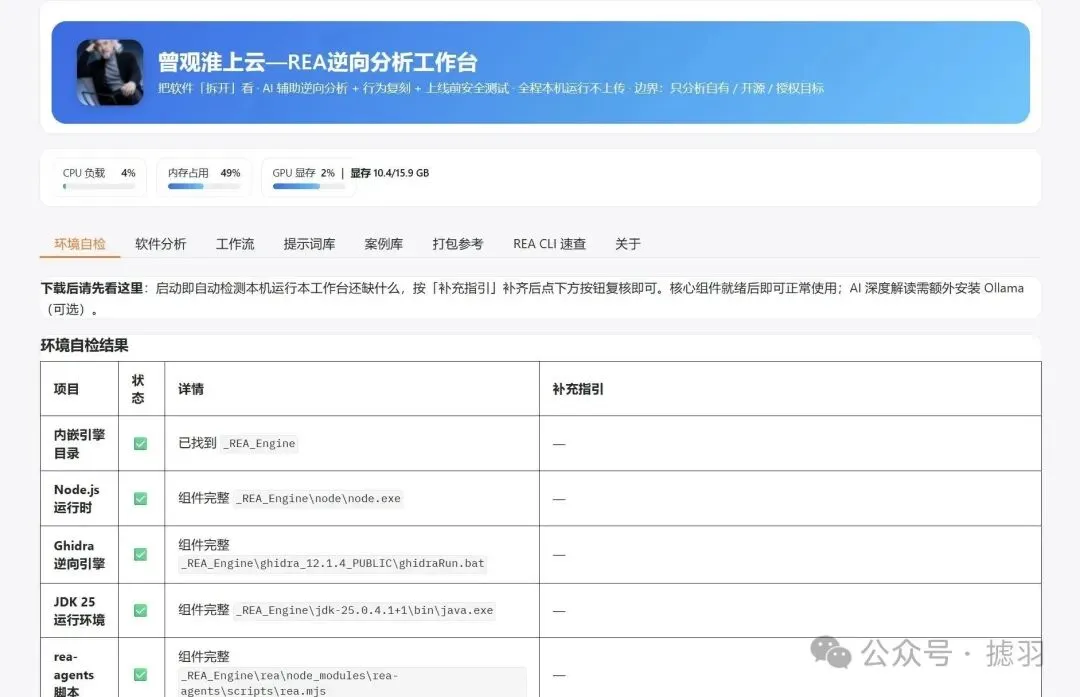
— 首次启动自动环境自检,依赖状态与缺失项一屏看清
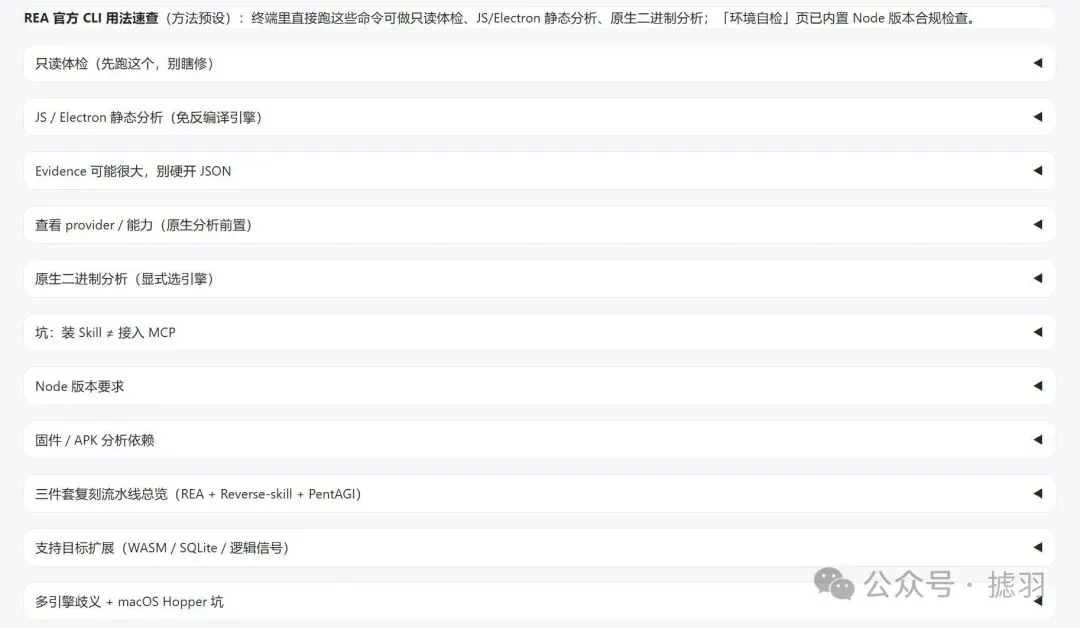
— 内置命令行速查清单,常见分析入口一屏可查
04
PART
一次分析,完整走哪些步骤
WORKFLOW · 九步闭环与证据分级
工作台内置一条九步闭环工作流:目标收窄 → 环境体检 → 提取元信息与格式识别 → 函数与结构识别 → 字符串、导入表、区段取证 → 反编译与伪代码 → 调用关系追踪 → 证据整理与置信度标注 → 生成分析报告。如果接入本地离线 AI,还会再由 AI 把报告要点梳理成自然语言解读。
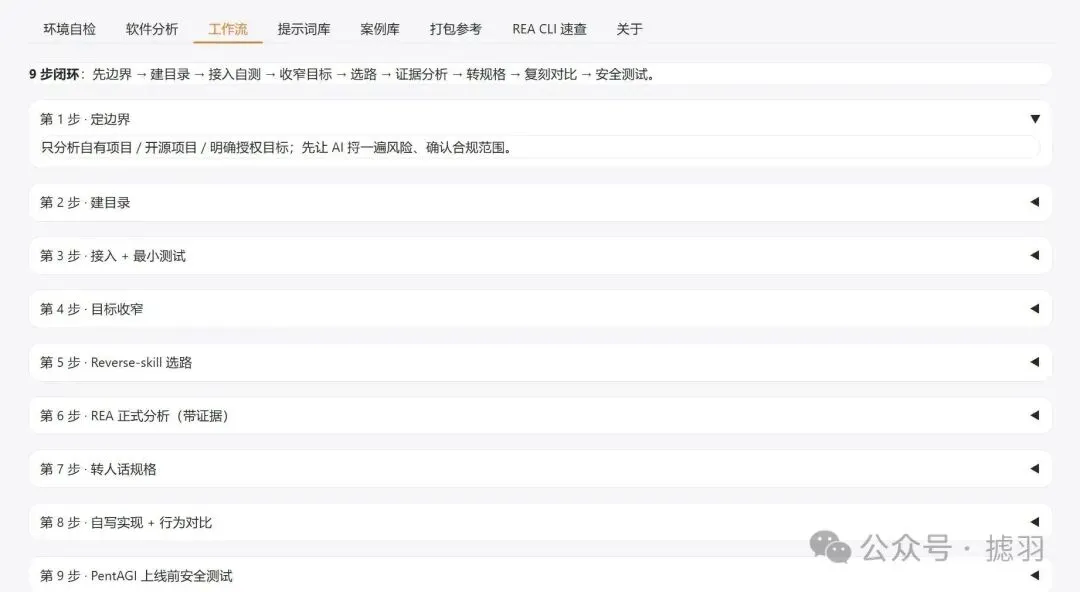
— 九步闭环工作流:从目标收窄到报告生成,照着走即可
每一条结论都要求连同依据一起呈现:结论来自哪个文件、哪个函数或偏移位置、属于哪种证据等级,以及仍未搞清楚的未知项,都会在报告里标明。证据等级分三档:observed(工具直接观察到)、derived(按规则推导得出)、inferred(推测判断);推测部分单独标出,不与观察事实混在一起。
需要提醒:静态分析画出的调用关联,不等于程序运行时一定走过那条分支;关系集合即使标注为已覆盖,也不代表所有运行时调用都已找到。只分析过部分样本、部分功能,不能据此宣布整款软件已经被完整还原。
下面是本机实测记录(angr 轻量引擎、离线运行、未启用 AI,测试时间 2026-10-29):
程序越小、函数越少,出结果越快;函数规模上去之后,耗时会明显增加。遇到超大二进制,工作台设有超时兜底:在保留已经拿到的静态信息后降级返回,不会一直卡死主线程。
一个被官方文档收录的入门案例
Windows 标准模式计算器输入 200 + 10% = 220,这并不是 bug。加号之后的百分号按第一个数计算,10% × 200 = 20,于是 200 + 20 = 220;工作台可以从编译产物中把这条被藏起来的运算顺序还原出来。
另一类公开社区案例:有人用 REA 追踪 Obsidian 快速切换器的模糊匹配与评分规则,用于理解其排序思路;本文不引用未经核实的具体对比样本数量,需要时以原始案例记录为准。
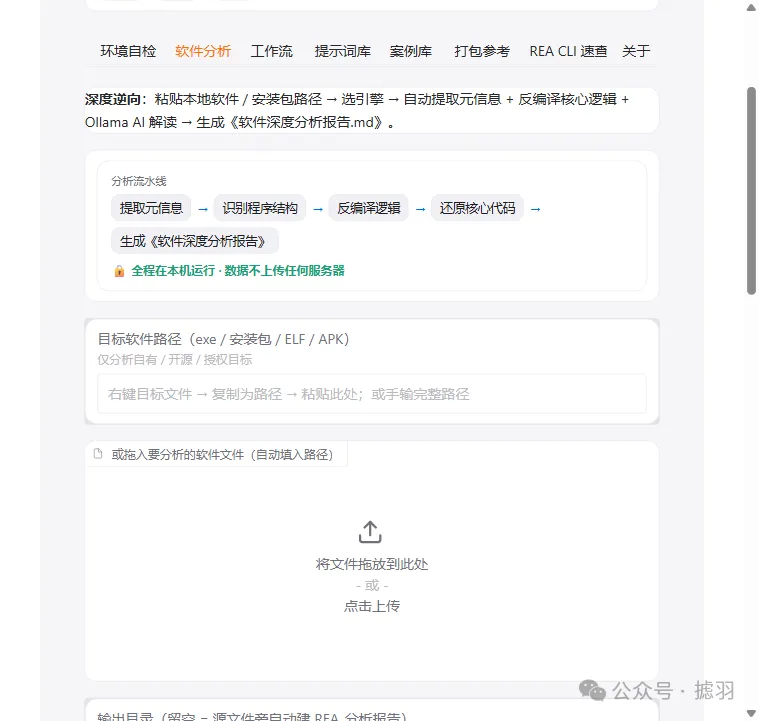
— 软件分析界面:选择引擎、目标类型,拖入文件即可开始
05
PART
什么样的目标,最适合先拿来练手
PRACTICE · 选对第一题
综合公开使用经验,一个目标满足下面的条件越多,越容易得到清晰、可验证的分析结果:
比如只想搞懂某一个按钮或某一条规则;
结果可以观察、反复验证;
不依赖大规模云端状态;
代码结构相对容易展开阅读。
按上手难度大致可分三档:第一档不需要额外引擎,Electron / JS 应用、网页脚本等文本可读目标最容易出清晰结果;第二档才需要 Ghidra 一类引擎拆解原生二进制;简单 APK、核心逻辑在本地的小程序与独立算法模块属于第三档,依赖更多外部条件,建议在前两档熟悉后再尝试。新手建议先从第一档练起。
适合谁:想学习软件原理的开发者与爱好者、教学练习、互操作研究、自有软件的上线前自查,以及分析自己有权查看的开源或已授权程序。
不适合谁:指望一句话白嫖商业软件、一键复刻出对等产品,或期待这套工具替代专业逆向工程师的人。反过来,想一上来吃透整套商业软件、核心逻辑又放在云端的产品,并不适合作为入门第一题。
提问也有技巧:一次只问一个具体功能、按钮或函数,不要一上来就要求「把整个程序逆向出来」;最好先拿自己熟悉、心里有预期结果的小程序当天然校验器,确认结论和实际行为对得上,再逐步换更复杂的目标。任务过大时,先缩小范围、保存已有证据,之后再接着分析。
06
PART
和传统专业工具相比,省在哪,差在哪
COMPARISON · 客观对照,不夸大
省下的事:不必自己安装和搭配 Node、Ghidra、JDK、JADX,不必记忆命令行参数,在中文界面按步骤选择即可开始分析。
需要诚实说明的差距
覆盖范围:本工作台是 REA 与几款开源引擎能力的子集封装,目标类型与分析深度不及 REA 本体;工作台未捆绑 IDA Pro、Hopper、JEB 等商业反编译器,不内置也不授予其使用许可,更无法替代这类商业专业工具;
平台:当前仅支持 Windows;
自动化:目前以界面点选为主,暂未提供对外脚本 API 与无头批量运行模式;
AI 闭环:AI 解读是本地离线小模型的可选增强,与行业第三代 Agent + MCP + RAG 的持续对话方案相比,仍属于「一次性解读」;
复杂目标:加壳、强混淆、服务端逻辑仍需专业工具与人工复核。
07
PART
三步上手,不需要先会写代码
QUICK START · 点选即可开始
很多人一听「逆向分析」就觉得要会写代码、记一大堆命令。这个工作台要解决的,正是这件事——解压、双击、点选。
双击启动
双击「启动.bat」,工作台自动启动并打开浏览器界面,首次启动约 10–20 秒属正常现象。
查看体检结果
环境自检通过即可开始分析;若提示组件缺失,按自检指引补齐后再点「立即重新检测」。
选择目标开始
在「目标软件路径」粘贴或拖入要分析的程序,选好引擎,点击「开始深度分析」,等待报告生成。
提示词库内置 12 条场景模板,一键复制即可使用:只想分析某个功能、梳理调用关系、整理证据与不确定项等常见问法都已写好,不必自己组织提问语言。
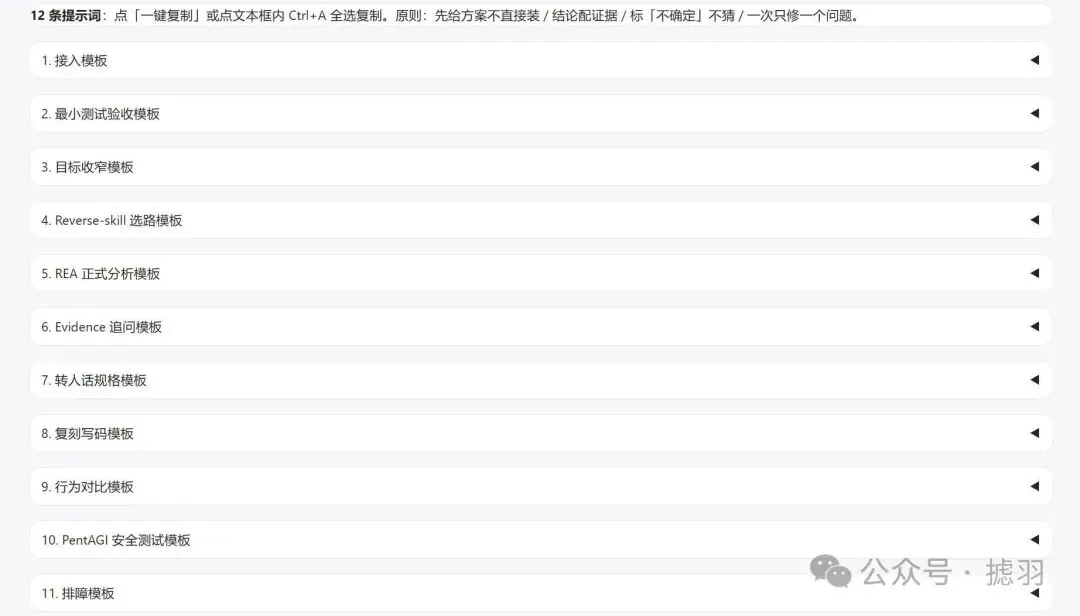
— 12 条场景提示词模板,点选复制即可提问
✦ 可选增强
AI 解读属于可选增强:配套离线 qwen2.5 7b / 14b 模型;不安装配套模型,不影响反编译与引擎分析的核心功能,仅 AI 解读不可用。
08
PART
它拆不动什么:边界必须先说清楚
LIMITS · 先知道做不到
💡 在开始使用前,请先了解下面这些明确做不到或做不好的地方。
还原产物是近似伪代码,不是原始源码;原始变量名、注释、工程结构与作者设计意图都会丢失。
加壳,以及 VMP、Themida 一类强虚拟化保护,静态分析通常无法正常展开。
跑在服务器上的核心逻辑、网络协议与云端数据,本机静态分析接触不到;纯服务端 SaaS 应用没有本地二进制可供分析,不在工作台可分析范围内。
本工作台以本地静态分析为主,不包含动态调试与运行时抓包链路。
目标文件中出现的文本、伪代码、日志与内嵌提示,都可能藏有诱导性指令,属于不可信内容,不能当作可执行命令照搬;工作台只做本地静态分析,不会自动运行目标程序。
有权检查一个文件,不等于有权运行它、抓包分析它,或改动它所在的设备;分析动作的范围同样需要获得相应授权。
程序体量极大时分析缓慢,受单次会话长度与模型上下文限制,可能卡顿或中断;此时应拆成更小的目标分段分析,超时后降级保留已得信息,并非所有文件都能一次跑通。
本地 AI 解读可能误读,报告结论应结合证据人工复核,不能直接当作定论。
看得懂某段功能,不等于能复刻出完整对等的商业软件;文件格式兼容、硬件适配、插件生态、长期稳定性与用户数据,都不是反编译能够解决的。
09
PART
合规红线:只碰该碰的目标
COMPLIANCE · 授权与复刻边界
第一层,授权前提:
工作台只用于分析自己拥有、开源,或已经获得明确授权的程序;不用于破解软件、去除混淆、绕过授权验证或非法牟利。
第二层,复刻边界:为学习研究、理解原理或实现兼容互通而进行逆向,与把逆向得到的代码实质性复制进自有产品、破解保护措施后采集服务端数据、照搬素材,或让 AI 换一种语言重写后当成独立开发,是性质不同的两件事,后者并不当然免责。开源代码同样不等于使用者可以随意复制分发;研究理解一个软件,与把分析成果公开分发或商业化,也需要分开看待。使用前请确保已获得相应授权,具体法律问题必要时咨询专业法律意见。
其中,REA 深度引擎需要管理员权限;主界面与 angr 轻量分析在非管理员状态下即可正常运行。
///
LAST
写在最后
TRUST · 门槛、责任与安全
逆向分析真正降低的是「入场门槛」:过去要花几年啃反汇编、手动追踪调用图的事,现在普通开发者和爱好者可以先从一个小软件、一个明确功能起步,理解它、验证它。
但门槛降低,不等于判断责任消失:证据需要复核,边界需要尊重,授权必须干净。看懂一个程序,和复制出一个成熟产品之间,还隔着多道护城河:服务端逻辑与数据、文件格式与周边生态、插件与协作流程、稳定性与兼容性、品牌与持续更新支持,以及历史项目积累下来的使用习惯;这些大多无法靠拆解本地客户端得到。
我把网盘下载地址放在了评论区,有需要的自取。
技术不该是用来吓人的,而是用来被理解、被掌握、被创造的
打开它,从看懂一个软件开始。
信任与安全声明
本工作台由「曾观淮上云」发布,是对官方 REA 开源能力的第三方本地打包封装,并非 REA 官方发行;REA 官方从未发布 Windows 一键安装包或 GUI 程序。公开渠道曾出现伪造的「REA Windows 独立版 exe」被安全软件判为木马,属于仿冒先例,请只认准唯一发布渠道下载。
运行前可用包内 SHA256.txt 核对程序校验值;哈希与清单不一致,说明文件已被改动,请勿运行。样本应在本人有权分析的环境内进行。
目标文件全程在本机处理,不上传云端;可选 AI 解读默认使用本地 Ollama 模型,分析结论同样不出本机。若未来改用云端模型,分析结论会离开本机,届时界面会另行标注;本工作台默认采用本地路线。
内容验真与配图说明
1. 文中各工具的费用与开源协议口径以对应官方页面为准;本机实测的函数数与耗时随机器配置、程序版本不同会有差异。
2. Obsidian 案例仅保留「社区曾用 REA 追踪其模糊匹配与评分规则」的现象表述,未引用未经核实的对比样本数字。
3. 文中五张工作台图片为本工作台界面实拍截图;开篇水墨头图为 AI 生成示意图,非现场照片;未使用来源不明或未经核实的第三方图片。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING · 曾观淮上云