ARTICLE · 1284393
爱可可AI前沿推介(10.31)
LG - 机器学习 CV - 计算机视觉 CL - 计算与语言 AI - 人工智能
1、[AI] Proving and Improving the Platonic Representation Hypothesis with JEPAs
2、[LG] Training Foundation Models with a Single Algorithm
3、[LG] Skillful and realistic precipitation forecasting with reinforced diffusion
4、[AI] MoLRSI:A Recursive Self-Improving AI agent for Molecular Discovery
5、[LG] Rethinking Neural Thickets Without Weight Perturbations
摘要:以 JEPA 验证并提升柏拉图表征假设、以单一算法训练基座模型、基于强化扩散模型的高精度与高逼真度降水预报、用于分子发现的递归自我改进型AI智能体、重新审视神经丛
1、[AI] Proving and Improving the Platonic Representation Hypothesis with JEPAs
R Balestriero, Y LeCun
[Brown University & New York University]
以 JEPA 验证并提升柏拉图表征假设
要点:
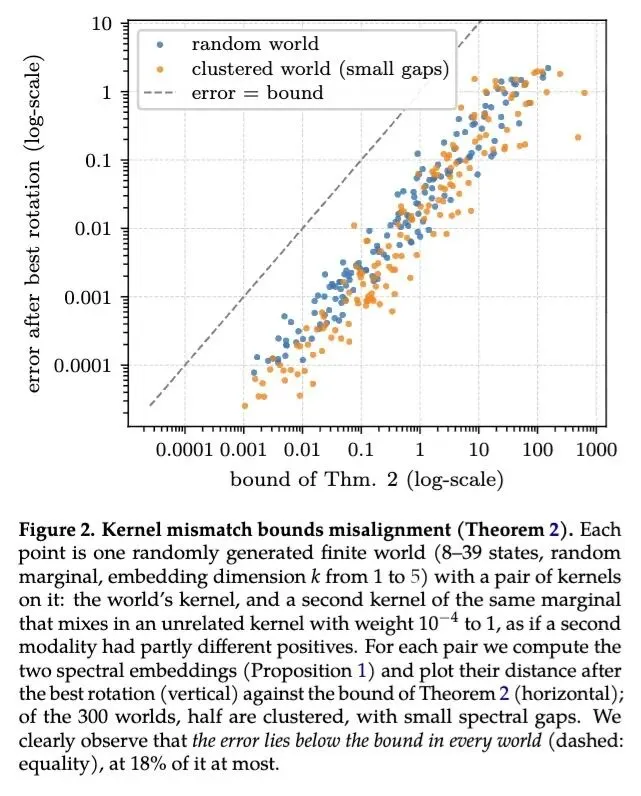
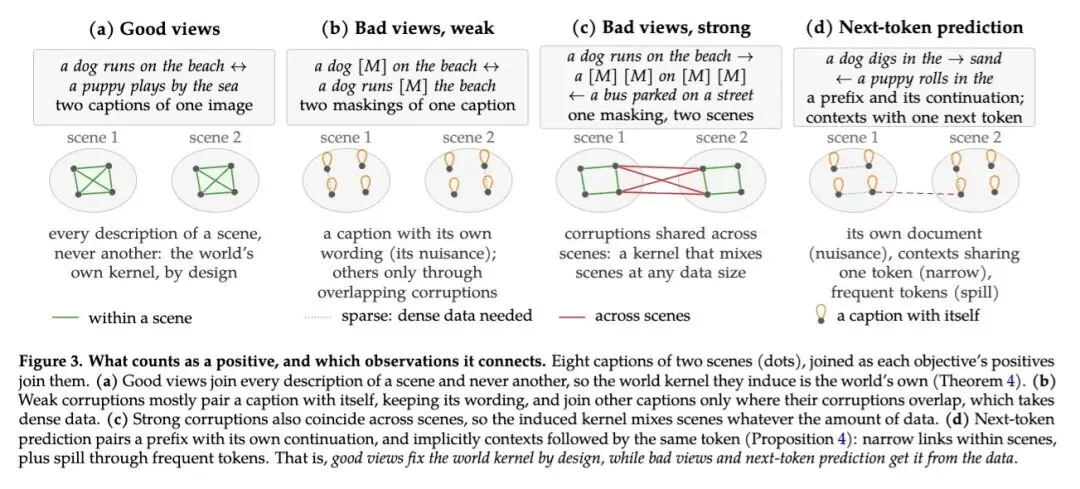
将柏拉图表示假说(PRH)从经验性观察升级为严格的数学定理,证明了基于联合嵌入预测架构(JEPA)的多模态对齐机制。 在数学上严格证明:如果独立训练的多模态JEPA模型使用好视角(即对同一个客观世界场景的不同模态观察)作为正样本对,它们将学习到完全相同的表示空间,两者之间仅相差一个正交旋转矩阵。 揭示了一个极具反直觉的理论:当前大语言模型(LLM)的核心基石“下一个Token预测”,在数学上等价于使用了坏视角(对单次观察的局部破坏或掩码)的JEPA。这迫使语言模型浪费表征维度去编码模态特定的噪声(如作者特定的遣词造句习惯),从而严重阻碍了其与视觉等其他模态的对齐。 暴露了当前LLM依靠堆叠数据来逼近世界模型的极端低效性:使用好视角训练的文本JEPA,要达到与“下一个Token预测”完全相同的跨模态对齐水平,所需的样本量锐减了42倍。 展现了令人震惊的“以小博大”实证结果:一个参数量仅为1.09亿(109M)的纯文本JEPA模型,在与视觉编码器(如DINOv2、CLIP)对齐时,其对齐程度全面击败了参数量高达720亿(72B)的最先进大语言模型。 实现了一种无需联合训练的图像字幕生成新范式:不需要任何成对的图文数据来微调网络权重,只需通过一个简单的线性旋转矩阵,就能将独立训练的视觉模型和语言模型无缝拼接,生成高质量图像描述。 在完全无配对数据的情况下,仅利用两个空间内在的几何结构进行对齐,该109M小模型在零样本图像分类精度上甩开了包含80亿参数的先进大语言模型十几个百分点。
主旨: 本文旨在探讨并解决人工智能领域的一个核心问题:分别在不同模态上独立训练的模型,最终是否会收敛到对这个世界相同的内部表示(即柏拉图表示假说)。文章试图将这一假说从单纯的实证观察转化为严密的数学定理,并解释为何目前规模庞大的大语言模型在多模态对齐上效率极为低下,进而提出一种通过优化数据样本视角来高效实现完美跨模态对齐的方法。
创新:
理论视角的降维打击:首次用严密的数学公式证明,在联合嵌入预测架构(JEPA)下,只要正样本对共享相同的世界状态,多模态模型必然殊途同归,将经验玄学变成了确定的定理。 解构语言模型的神话:创新性地将“下一个Token预测”在数学上拆解重构,证明其本质不过是一个捕捉“模态特定冗余”的低效对比学习框架,打破了自回归预测是通向通用人工智能唯一路径的迷信。 重塑文本预训练范式:摒弃传统的自回归或掩码重构,提出直接使用同一图像的不同文本描述作为正样本对(好视角)来单独预训练文本模型,精准剥离文本的语法噪音,直击语义本体。 几何同构的应用创新:首创基于纯几何旋转的跨模态组装技术,彻底抛弃了耗费巨大的图文对联合训练(如CLIP式训练),仅靠找出一个旋转矩阵就能让互没见过的视觉和语言模型合作完成复杂的图像字幕生成任务。
贡献:
理论奠基:为柏拉图表示假说提供了坚实的理论证明基础,明确界定了模型学到客观世界表示的充分条件(即正样本必须跨越局部冗余,锚定同一个世界状态)。 效率革命:通过实证揭示了当前基于扩展定律(Scaling Law)的多模态对齐策略的极度低效,证明了仅需千万级数据和一亿参数的模型,只要视角选择正确,就能超越万亿数据和数百亿参数的巨兽模型。 机制揭秘:明确提出了“模态特定噪声”这一概念,用以量化评估模型是在学习世界的客观规律,还是仅仅在死记硬背特定模态(如特定语言的句法)的独有特征。 开源实践:提供了一套完整、低算力成本的工具和训练配方,证明了依靠几何同构性,可以在极低资源下实现多模态系统的零样本对齐和应用,为中小机构的AI研究提供了新路径。
提升:
样本效率极大跃升:在相同的训练语料下,达到同等程度的视觉-文本对齐效果,好视角JEPA模型比传统下一个Token预测模型少消耗42倍的训练样本。 跨模态对齐指标历史性反超:在WIT和COCO等标准基准测试中,109M文本JEPA与DINOv2视觉特征的互近邻(Mutual 10-NN)和中心核对齐(CKA)指标,全面碾压包括Llama-3-70B、Qwen2.5-72B在内的顶尖大模型。 无配对数据对齐精度大幅提高:在仅提供未配对图像和文本(即打乱对应关系)的盲匹配任务中,该模型零样本图像分类精度高达64.4%,远超同等条件下8B语言模型47.6%的成绩。
不足:
理论假设过于理想化:数学定理的证明建立在世界状态数量有限、各模态是世界状态的单射(即无损映射)等完美假设之上,而现实中的图像和文本通常是高度有损且充满歧义的。 好视角数据的获取成本极高:为了构建理想的好视角正样本对,系统需要确切知道哪些不同的文本是在描述同一个场景。目前实验高度依赖人工的高质量密集标注(如Flickr/COCO的一图多句)或现有视觉大模型的二次标注,这在纯无监督的互联网野外数据中极难自动提取。 泛化验证的局限性:目前的理论和实验压倒性地集中在图像和文本这两种模态上,尽管作者声称该理论适用于视频、音频和动作等,但缺乏对这些连续且高维模态的深入实证。 经典卷积网络的适应性:作者在局限性中隐晦提到,该框架和理论对当前高度依赖掩码或局部裁剪的图像自监督模型(如MAE、基于局部裁剪的DINO)更契合,但在解释一些全局视角的经典问题时可能需要进一步扩展。
心得:
自回归或许并非AGI的唯一圣杯:我们当前对大语言模型的崇拜,很大程度上掩盖了其机制的低效。本文极其犀利地指出,下一个Token预测迫使模型花费大量神经元去记忆特定的语法和作者风格(模态噪音),而不是理解句子背后的世界客观真理。这启发我们,未来颠覆Transformer/LLM统治地位的,可能正是这种致力于消除模态冗余、直接对齐世界状态的新型目标函数。 数据定义的质量远胜于参数规模的暴力堆砌:109M参数击败72B参数,这是本文最令人震撼的结论。它深刻地警示了整个AI行业:在当前的Scaling Law狂热下,我们可能在用极其低效的方法喂养怪物。只要我们在数学层面正确定义了模型应该看到什么(把数据整理成同一个客观实体的多维侧面),小模型完全能够长出比盲目吞噬海量数据的千亿模型更纯粹、更高级的认知结构。 积木式的多模态未来图景:本文描绘了一个极具吸引力的多模态系统组装方式。如果所有模态(听、说、看、触)的模型在预训练时都掌握了柏拉图式的世界表示,那么它们的潜空间在几何上就是同构的。这意味着未来的多模态大模型不再需要耗费天文数字的算力进行图文对齐微调,而是像拼接乐高积木一样,随便找一个视觉模型和一个语言模型,通过求取一个简单的旋转矩阵就能让它们瞬间具备看图说话的能力,这将彻底重塑多模态AI的产业生态。
一句话总结: 本文通过严格的数学推导将柏拉图表示假说升级为定理,揭示了主流大模型下一个Token预测由于深陷模态特定噪声而导致的惊人低效,并以极具冲击力的实证结果证明:只需正确构建同一场景多视角的文本模型,仅用1.09亿参数和极少的样本,就能在跨模态对齐和零样本组装能力上,跨级碾压规模达720亿参数的当红大语言模型。
Whether models trained on different modalities converge to the same representation of the world is central to AI. The Platonic Representation Hypothesis (PRH) conjectures that they do as they scale, but without a proof it offers neither a guarantee nor a recipe. We turn the hypothesis into a theorem. First, we prove a \emph{Platonic Representation Theorem}: Joint-Embedding Predictive Architectures (JEPAs) trained separately on any number of modalities learn the same representation up to one rotation whenever their positive pairs are two observations of one scene--\emph{good views}--and their misalignment is bounded otherwise. Second, we show that next-token prediction is a JEPA with \emph{bad views}, parts of a single document, which explains why language models align with vision only through scale. Third, we validate the theory from 145k captions to the texts of 940M web images, and uncover a scaling law of alignment that predicts unseen runs within seed noise. Good views need 42 times fewer training samples than next-token prediction on the same corpus to reach the same alignment, and a 109M-parameter text JEPA aligns with DINOv2 and CLIP's image encoders better than every language model we evaluated, up to 72B parameters, and than CLIP's text encoder: next-token prediction is a remarkably inefficient route to platonic representations. As a showcase, one rotation turns separately trained encoders into an image captioner (CIDEr .838 on COCO). Even that rotation needs no pair: on the latest pair-free benchmark, our text JEPA beats every zero-shot accuracy reported with language models up to 8B parameters, e.g., 64% against at most 56% top-5 on ImageNet-100. Positive views, and not scale alone, are thus the lever to build platonic representations.
https://arxiv.org/abs/2610.39302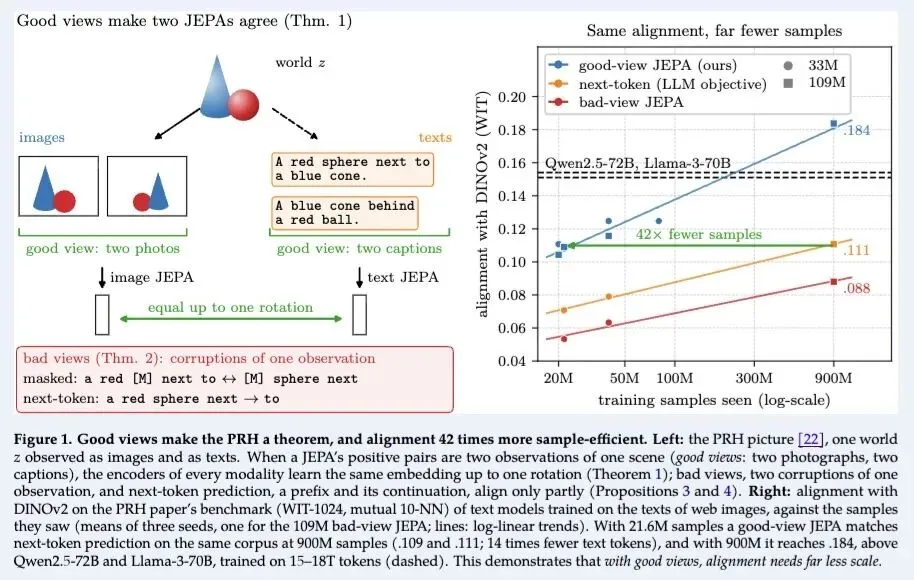
2、[LG] Training Foundation Models with a Single Algorithm
Y Song, A Zhang, F Tajwar, D Arora…
[CMU & Johns Hopkins University]
以单一算法训练基座模型
要点:
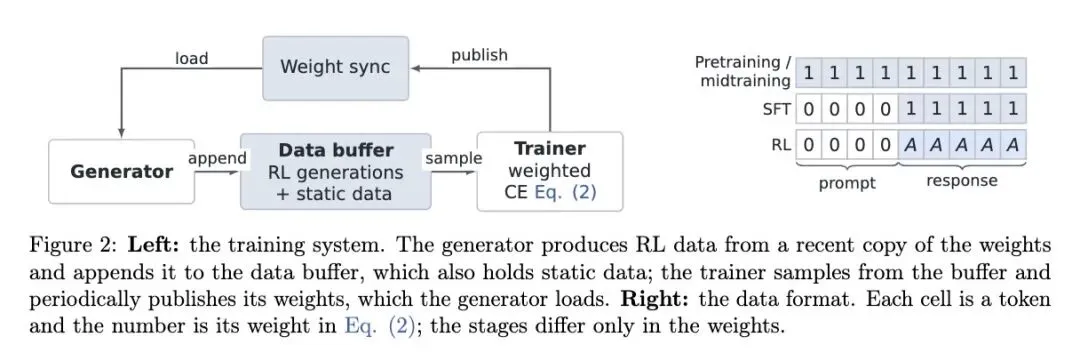
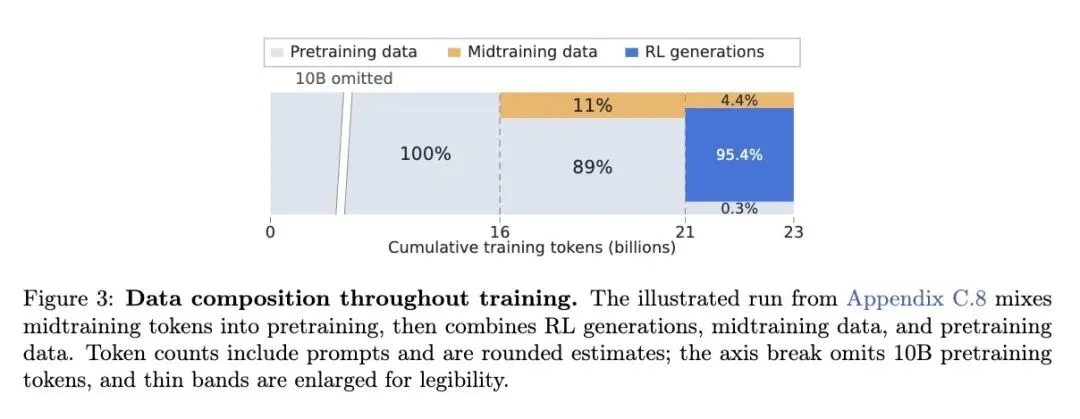
挑战了基础模型传统的分阶段训练范式(预训练、中期训练、监督微调和强化学习),证明这些阶段不需要依赖不同的学习算法。 提出“统一训练”框架,将基础模型的整个训练生命周期重新定义为由不断演变的数据分布驱动的单一最大似然估计(MLE)目标。 反直觉地证明了强化学习优化(通过MaxRL或REINFORCE等方法)在数学上可以完全转化为对条件成功目标分布的最大似然拟合。 将基础模型训练的核心设计问题从“依次选择训练算法”转变为“数据课程设计”:即决定模型应该学习什么数据、比例是多少以及在何时引入。 引入了一个异步训练系统,在该系统中,静态数据(语料库/演示)和动态RL生成数据共享完全相同的数据格式、似然损失和训练器。 实证表明,与传统的按顺序分阶段训练相比,在RL阶段持续混合中期训练或预训练数据,能够显著提升“准确率-算力”的性价比以及任务覆盖率。 揭示了统一训练在缓解通用能力灾难性遗忘方面,比标准的阶段性RL或带有KL散度惩罚的RL有效得多。 证明了统一训练能为持续学习(例如将专注于数学的模型适配到编程任务)提供更强大且更具鲁棒性的起点。
主旨: 这篇文章主要解决了基础模型在不同训练阶段(预训练、指令微调、强化学习)算法割裂、难以联合优化以及容易产生灾难性遗忘的问题。为此,论文提出了一种基于单一最大似然估计的统一训练框架,将不同阶段的训练本质统一视为动态数据混合的似然拟合过程,从而将整个生命周期的训练统合在一个算法和一套基础设施下。
创新:
理论视角的降维统一:将传统的策略梯度强化学习(如REINFORCE、MaxRL)巧妙地重构为对模型生成的条件成功分布的最大似然拟合,打破了生成式任务和判别式/优化任务的算法壁垒。 统一的系统架构设计:设计了将静态数据(预训练/SFT)和动态生成数据(RL)在同一个缓冲区内按比例混合,并在同一个损失函数下进行异步更新的训练基础设施,无需为各阶段维护不同的代码栈。 动态数据配比机制:将分阶段训练转化为一个软性的动态加权问题,允许不同类型的数据在时间线上重叠和演变,突破了传统阶段之间数据分布硬切换的限制。
贡献:
理论贡献:为基础模型的全生命周期训练提供了一个严谨的数学框架,证明了传统的阶段性训练仅仅是该统一框架下一种混合权重突变的极端特例。 系统贡献:构建并开源了支持异构数据混合的通用训练系统,大幅简化了现代大语言模型的后训练系统工程复杂性。 实证贡献:系统性地探讨了数据组成、混合时机和算力分配对最终模型能力的影响,揭示了数据混合在保持模型通用能力和提升特定推理任务性能之间的权衡机制。
提升:
算力效率与任务性能:在同等算力预算(FLOPs)下,统一训练在受控推理任务和真实数学任务中,均能达到比传统分阶段训练更高的绝对准确率和更广的解题覆盖率。 通用能力的保留:相比于传统的纯RL阶段或使用KL散度正则化约束的RL,统一训练在大幅降低预训练保留集困惑度(Loss)的同时,更好地维持了MMLU、SciQ等通用基准测试的分数。 持续学习的起点质量:在跨领域的持续学习场景中(例如先进行数学训练再进行编程训练,或转向WebInstruct任务),统一训练产出的中间模型展现出了更高的收敛上限和更好的新任务适应性。
不足:
缺乏普适的数据缩放定律:尽管揭示了数据混合比例和调度的重要性,但论文并未总结出具备强预测能力的Scaling Laws来指导未来在不同参数规模下应如何精确设定最佳混合比例。 复杂多任务冲突研究有限:实验大多集中在优化单一主导的RL任务(如数学或受控推理),尚未充分探讨在联合训练多个存在竞争关系的RL任务时,该框架应如何处理进展不均衡的问题。 优化器动态适配未被深入探讨:论文中改变了数据混合比例和批次大小,但并未系统研究优化器超参数(如学习率调度策略)应如何随数据课程的演进而动态自适应调整。
心得:
打破算法壁垒重塑训练流:将复杂的RL视为MLE的一种特殊形式,这是一个非常反直觉但极具启发性的视角。这提示我们在大模型系统架构设计中,不应盲目堆砌复杂的算法管线,而应探寻底层数学原理的统一,这能极大降低工程复杂性并打开联合优化的空间。 数据调度优先于算法设计:论文将模型能力的塑造归结为“数据课程”的演进。这启示我们在大模型后训练(Post-training)阶段,与其耗费大量精力去魔改强化学习算法,不如将精力集中在静态高质量数据与动态探索数据的合理配比与注入时机上,数据配方决定了模型的上限。 克服遗忘的物理干预优于数学约束:实验证明,试图在RL中仅靠KL惩罚来维持基座模型能力,效果远不如在训练批次中真实混入早期的静态数据。这深刻说明了大模型在持续学习中的能力维系高度依赖于原始特征的直接重现,数据回放机制比单纯的权重拉扯更符合神经网络的记忆规律。
一句话总结: 本文打破了基础模型训练必须经历不同算法阶段的传统认知,创新性地将强化学习重构为最大似然拟合过程,提出了一个仅用单一似然算法即可贯穿预训练、微调与强化学习的全生命周期统一训练框架;最反直觉的发现是,通过在强化学习阶段打破常规,持续混合早期的静态训练数据,不仅能在同等算力下获得更高的特定任务准确率,还从根本上超越了传统的KL正则化防遗忘方法,完美保留了模型的通用基础能力。
Foundation models are typically trained in stages: pretraining, midtraining, supervised fine-tuning (SFT), and reinforcement learning (RL), with changes in both data and learning algorithms. We show that this algorithmic separation is not fundamental. By deriving suitable RL objectives as maximum-likelihood fitting to model-generated target distributions, we place all of these stages under a single likelihood-based training algorithm, unified training. This perspective turns the foundation-model training lifecycle into a problem of choosing which data to train on, in what proportions, and when, with conventional staged training as a special case. We instantiate this framework in a unified training system that mixes static data and RL generations within a single trainer. Across controlled and real-world experiments, unified training improves the accuracy-compute tradeoff and task coverage while preserving broader capabilities, and provides a stronger starting point for continual learning. This work lays the groundwork for a unified science of foundation-model training, connecting mathematical principles, training infrastructure, and the development of model capabilities.
https://arxiv.org/abs/2610.40564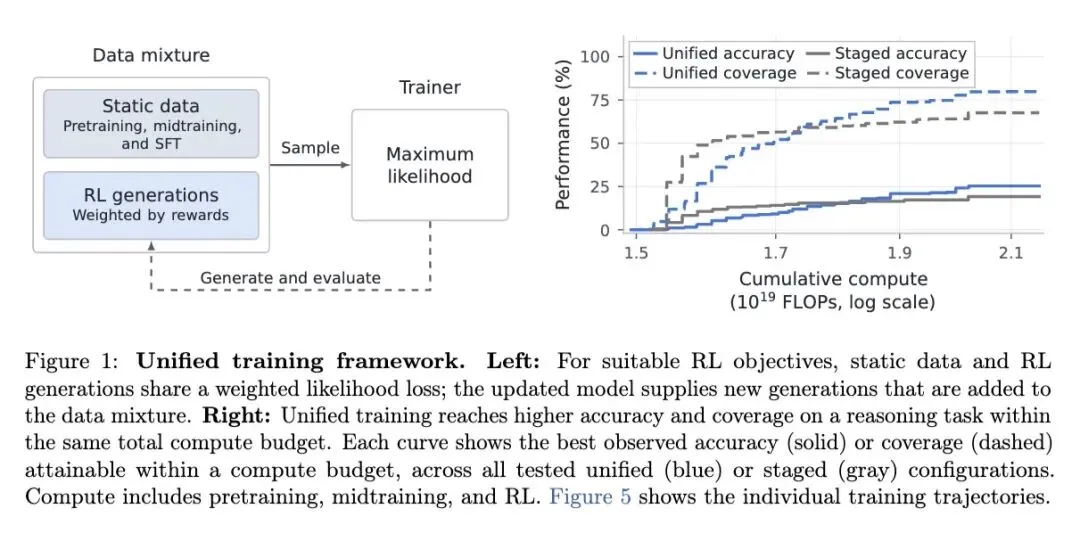
3、[LG] Skillful and realistic precipitation forecasting with reinforced diffusion
O Sener, A Avati, D Hafner, J Lin…
[Apple]
基于强化扩散模型的高精度与高逼真度降水预报
要点:
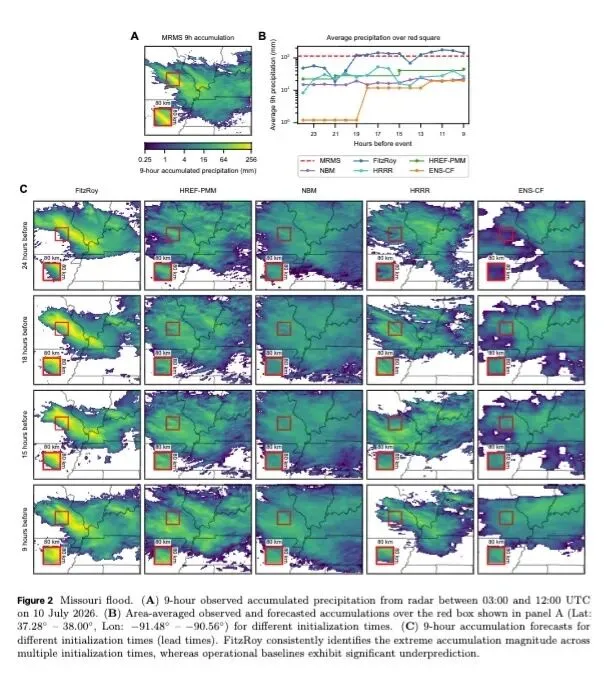
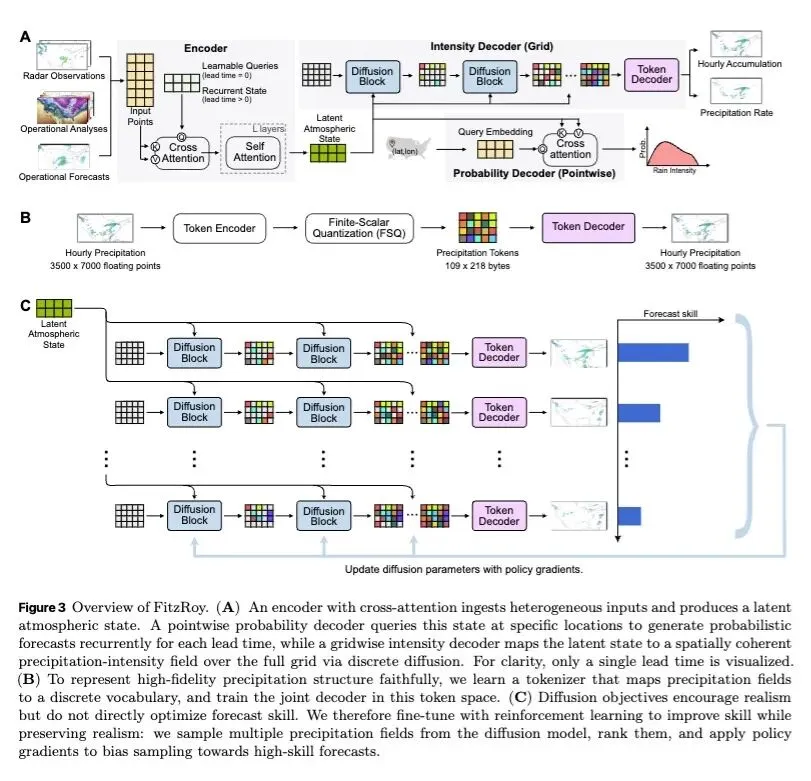
挑战了天气预报中长期存在的“准确率-真实度权衡”传统认知,证明了机器学习可以同时实现高统计准确率和物理结构的高保真度。 摒弃了传统的基于网格的输入,采用基于点的交叉注意力编码器,将异构气象数据(雷达、站点、网格)视为无序点云,从而构建灵活的、无网格的潜在大气状态。 揭示了标准回归机器学习模型的致命缺陷:为了对冲不确定性而生成“模糊”的预测,从而导致对极端天气事件的严重低估。 引入“强化扩散”(Reinforced Diffusion),使用通过强化学习(RL)微调的离散扩散模型取代传统回归,将采样轨迹引向高技能得分的结果。 使用结合了分数技能得分(FSS)和频率偏差(Frequency Bias)的独特奖励函数,有效缓解了臭名昭著的“双重惩罚”问题(即位置略有偏差但逼真的风暴受到的惩罚比无特征的模糊预测更严重)。 使用标记化技术(有限标量量化)将降水场离散化,将高维预测问题降维为条件离散Token预测。 证明了外部集合预报(如NBM)可以无缝集成到潜在空间中,使模型能够同时充当独立的预测器和学习型预报集成系统。 实现了长达24小时的SOTA预测能力,能够在初始化后几秒钟内成功捕获极端、未观测到的灾难性事件(如2026年密苏里州洪水),大幅延长了应急响应的有效预警时间。
主旨: 解决降水预报中物理模型(NWP)难以解析中尺度对流,而传统机器学习模型倾向于生成物理上不一致、平滑模糊且严重低估极端降水事件(即存在“准确率与物理真实度权衡”)的问题。为此,论文提出了FitzRoy,一个通过强化学习微调离散扩散模型的预报系统。
创新:
提出了“强化扩散”(Reinforced Diffusion)框架,将生成式离散扩散模型与强化学习微调相结合,从根本上消除了回归模型带来的模糊效应。 采用了无网格的、基于点云的交叉注意力编码器,能够打破刚性网格限制,直接融合雷达、地面气象站和网格分析等极度异构的数据源。 创新性地采用分数技能得分(FSS)和频率偏差作为强化学习的奖励信号,直接优化业务关注的评价指标,而非传统的像素级回归损失。
贡献:
理论贡献:打破了气象预测中长期的“准确率与真实度不可兼得”的瓶颈,证明了通过强化学习引导生成式模型不仅能保留物理真实性,还能达到极高的统计准确率。 方法贡献:构建了包含概率解码器(针对点级别)和强度解码器(基于Token的网格生成)的双轨架构,并证明了将外部预报(如NBM)作为条件注入潜在空间可以极大提升模型表现。 实践贡献:开发了极低延迟(秒级出图)的实用气象系统FitzRoy。在美国本土长达24小时的预报中,成功预测了现有物理模型和ML模型均漏报或严重低估的极端降水事件,具有极高的现实防灾价值。
提升:
预测准确率:在临近及24小时内的降水概率、瞬时降水率和累积降水量上,其CSI、F1-score和FSS等多项指标全面媲美或显著超越HRRR、ENS-CF等顶尖物理模型以及GraphCast等前沿ML基线模型。 物理真实度:生成的降水场在功率谱密度(PSD)和频率偏差上高度贴合真实雷达观测,完美保留了中尺度对流的锐利边缘和复杂结构。 运行与决策效率:推理延迟极低,将计算资源消耗和生成时间压缩至数十秒,相比需要数小时计算的高分辨率物理集合模型,为应急管理争取了极具价值的决策窗口。
不足:
空间泛化性验证有限:目前的模型训练和评估高度依赖美国本土(CONUS)的高质量、高频雷达数据(如MRMS),在缺乏此类高质量密集观测的其他全球区域,其适应性和效果尚待验证。 阈值敏感性与泛化:强化学习奖励函数中依赖了人为设定的特定降水强度阈值,针对不同气候区或更极端的罕见天气,可能需要复杂的超参数重新调优。 对上游预测的依赖:虽然消融实验表明在剥离外部预报(NBM)时模型仍具备强悍性能,但模型对极端重降水的最佳表现依然部分依赖于高质量的短期NWP预测作为输入指导。
心得:
摒弃回归损失是攻克“模糊均值”陷阱的终极武器:在具有高度时空不确定性的任务(如降水、流体、交通)中,传统模型为降低MSE损失会本能地采取“模糊平均”策略。本文结合扩散模型保证样本真实度,再用RL定向优化,为所有极具随机性的时空预测任务提供了一个完美的通用范式。 降维升维的艺术,点云化表征对抗刚性网格约束:将结构化或半结构化的气象数据打碎为无序点云,利用交叉注意力机制进行编码,这一反直觉的操作实际上解决了多模态、多分辨率传感器数据融合的痛点。强行插值成网格会引入噪声,而将空间坐标作为特征嵌入的点云处理方式显然更加优雅且信息无损。 业务指标直接驱动梯度的暴力美学:气象学中长期存在的“双重惩罚”问题(预测对了形状但位置略偏,惩罚比瞎猜还大),导致模型不敢给出极端预测。本文跳出传统损失函数的窠臼,直接将最终的领域评价指标(FSS)转化为强化学习的Reward强行扭转梯度方向。这深刻启示我们:当标准损失函数与最终业务目标错位时,基于人类/业务反馈的强化学习(RLHF/RLOO)是跨越鸿沟的唯一桥梁。
一句话总结: 本文提出了FitzRoy模型,通过基于点云的异构数据融合与强化学习微调的离散扩散框架,首次在降水预报中打破了“统计准确率”与“物理真实度”的长期权衡,实现了兼具极高精度与真实中尺度空间细节的秒级极端天气预报。
Accurate precipitation forecasting remains elusive as physics-based models struggle to resolve mesoscale convection and machine learning often yields physically inconsistent, blurred results that consistently underestimate extreme events. We present FitzRoy, the first system that simultaneously achieves state-of-the-art predictive skill and physical realism over the continental United States. Through a reinforced diffusion framework, where a conditional discrete diffusion model is refined via reinforcement learning, FitzRoy effectively resolves the long-standing trade-off between pointwise accuracy and structural fidelity. Across lead times up to 24 hours, FitzRoy consistently matches or exceeds state-of-the-art models while preserving structural realism and capturing extreme events. Its low-latency inference further enables deployment in real-time operational settings. In case studies such as the 2025 Texas Hill Country floods and the 2026 Missouri floods, FitzRoy signals record-breaking accumulations that existing models largely missed. By bridging the gap between realism and skill, FitzRoy establishes a new frontier for high-fidelity precipitation forecasting.
https://arxiv.org/abs/2610.38775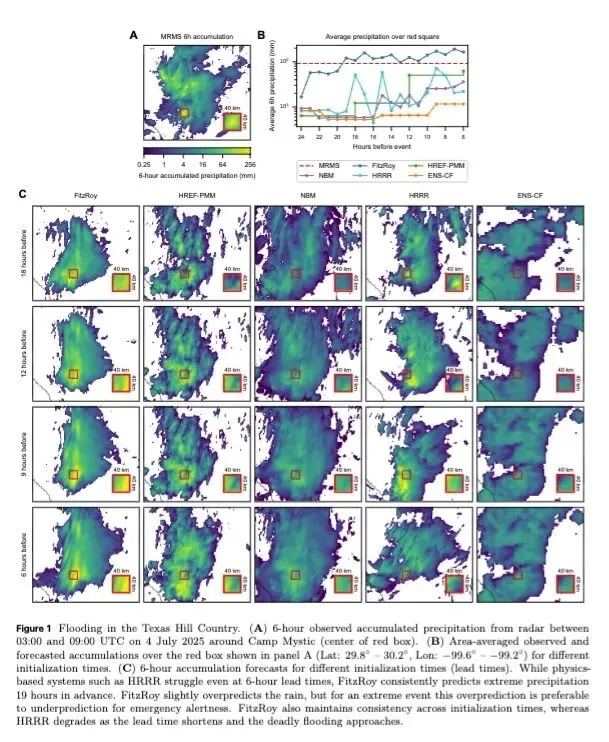
4、[AI] MoLRSI: A Recursive Self-Improving AI agent for Molecular Discovery
Y Zhang, X Cheng, M Yuan, Y Zhang…
[Northeastern University & Harvard University]
MoLRSI:一种用于分子发现的递归自我改进型AI智能体
要点:
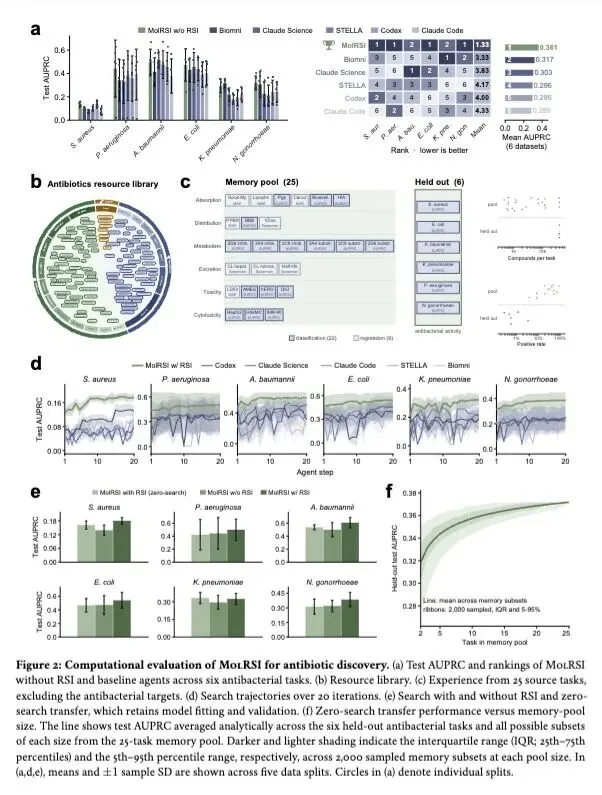
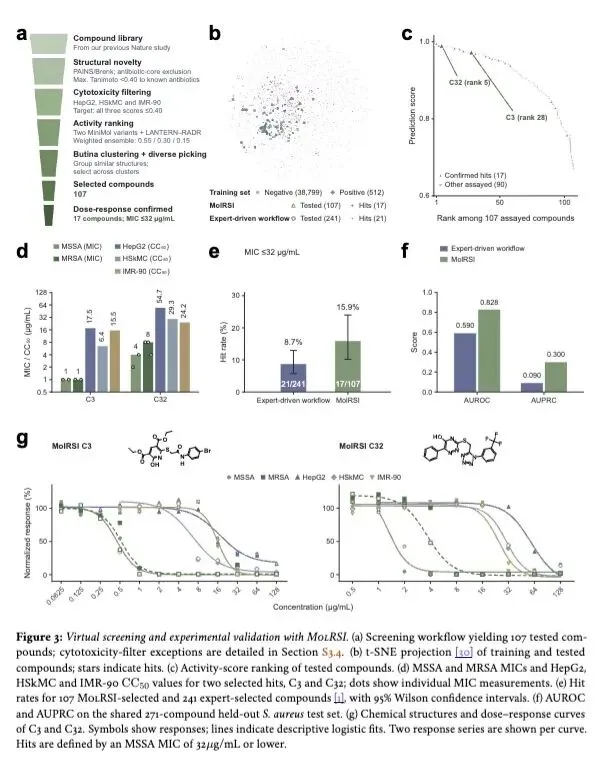
指出了当前AI for Science领域的一个关键空白:尽管AI智能体可以自动化工作流,但它们通常孤立地对待每个项目,无法将工作流工程的经验教训迁移到新任务中。 提出了MolRSI,这是一种用于分子发现的AI智能体,它通过将经验引导的蒙特卡洛树搜索(MCTS)与持久的跨任务记忆相结合,实现了递归自我改进(RSI)。 MolRSI利用三种类型的持久记忆:解决方案记忆(工作流及其性能)、优化记忆(修改、修改理由及其结果,包含失败的教训)以及执行记忆(运行指标和成功的错误修复记录)。 揭示了一个反直觉的“零搜索迁移(zero-search transfer)”现象:直接复用来自完全不同历史源任务的高度优化工作流,而不进行任何新的搜索,其效果通常优于为目标任务从头开始构建新工作流。 在真实的抗生素发现任务中(需要平衡抗菌活性、细胞毒性和结构新颖性),MolRSI实现了15.9%的实验命中率(在107个测试化合物中找到17个命中,MIC <= 32ug/mL)。 令人惊讶的是,在使用完全相同的训练数据和包含1200万个化合物的筛选库的情况下,MolRSI自主构建的工作流与被高度引用的由人类专家主导的工作流相比,命中率相对提高了82%(15.9% 对比 8.7%)。 在从头设计多肽-MHC(pMHC)结合蛋白这一高度受限的任务中(需要同时满足目标结合和脱靶区分),MolRSI生成了8个经过实验验证的针对MART-1和SARS-CoV-1的命中蛋白。 暴露了当前通用科学智能体的局限性:在完全相同的约束和计算预算下,最先进的Claude Science智能体在pMHC任务中完全未能产生任何实验命中(0个命中),证明了如果没有结构化搜索和跨任务记忆,仅靠LLM推理是不够的。 强调了“负面知识”的价值:通过在优化记忆和执行记忆中记录失败的修改和执行错误,MolRSI避免了在未来任务中重复相同的错误,从而大幅提高了搜索效率。
主旨: 解决现有科学AI智能体在分子发现任务中由于缺乏跨任务经验积累,导致每次面对新问题时都需要从头试错、无法优化工作流开发策略的问题。为此,论文提出了MolRSI智能体,通过建立持久的跨任务记忆和经验引导的树搜索机制,让AI能够在不同分子发现项目中实现搜索策略的递归自我改进。
创新:
构建了包含“解决方案、优化、执行”三个维度的持久记忆系统,不仅记录成功的模型架构,还记录失败的参数修改和代码debug经验。 将大型语言模型(LLM)与蒙特卡洛树搜索(MCTS)结合,提出了一种经验引导的工作流搜索策略,使得智能体可以根据历史表现动态调整探索与利用的平衡。 提出了针对科学计算任务的“零搜索迁移”范式,证明了基于历史记忆直接迁移顶尖工作流的有效性,打破了针对新任务必须重新执行完整神经架构搜索的传统设定。
贡献:
方法贡献:提出了首个具备跨任务记忆和递归自我改进能力的分子发现AI智能体框架MolRSI,为科学智能体的长期演进提供了有效路径。 实践贡献:在抗生素虚拟筛选中,使用与人类专家相同的数据和分子库,取得了显著优于人类专家设计的工作流的实验命中率(15.9% vs 8.7%)。 突破性应用:在极具挑战性的多肽-MHC(pMHC)结合蛋白从头设计实验中,成功设计出8个高特异性的结合蛋白,填补了全自动智能体在复杂双重目标(结合+抗脱靶)蛋白质设计上的空白。 深入基准测试:全面对比了包括Claude Science、Biomni、STELLA在内的多个前沿科学智能体,揭示了当前通用科学智能体在处理受限物理空间和特定领域复杂流程时的短板。
提升:
实验命中率:在抗生素筛选任务中,相比顶级人类专家主导的历史工作流,将体外实验命中率从8.7%提升至15.9%。 复杂蛋白质设计成功率:在pMHC结合蛋白设计中,相比于完全未获得命中蛋白(0/288)的最先进智能体Claude Science,MolRSI显著提升了成药潜力的转化率(获得8个高特异性命中)。 计算与搜索效率:通过跨任务记忆,智能体能在极少的评估步数内(甚至0步新搜索)达到或超越基线智能体经过20轮迭代搜索后的预测性能(如AUPRC和Enrichment Factor指标)。
不足:
理论边界不够完备:虽然有界传递分数作为经验选择先验在实践中有效,但论文缺乏对目标任务或节点级遗憾(regret)保证的标准理论证明。 经验池依赖性:算法的表现高度依赖于“源任务”经验池的质量和多样性。如果之前的任务与新任务的底层生物物理逻辑差异过大,历史记忆的迁移可能会失效甚至产生负面引导。 闭环验证未彻底打通:目前智能体的策略更新仍依赖于计算代理分数(如AUPRC、对接分数等),并未直接将实验室的湿实验结果(Wet-lab outcomes)反哺到策略更新的闭环中。
心得:
“负面知识”是智能进化的核心阶梯:MolRSI的成功很大程度上归功于它不仅记住了什么有效,还记住了什么是无效的(包括代码报错和性能下降的尝试)。在AI for Science中,失败的实验数据和踩过的坑,其信息熵往往高于成功的实验,这启发我们在构建垂直领域大模型时,必须建立“失败经验数据库”。 组合优于单体,流程重于模型:MolRSI在抗生素任务中打败人类专家,并不是因为它发明了什么惊世骇俗的新神经网络,而是因为它在使用完全相同的数据和组件库时,通过AI搜索找到了更优的过滤、排序和组装策略。这深刻揭示了在复杂科学发现中,“工作流工程(Workflow Engineering)”的优化空间可能远大于单个模型架构的微调。 LLM的通用推理无法替代结构化的领域搜索:Claude Science在代码编写和通用推理上极其强大,但在严苛的pMHC蛋白设计中却全军覆没。这给我们的启发是,让大模型直接“做科学”是极其低效的,大模型真正的角色应该是作为MCTS等结构化搜索算法中的“启发函数”或“操作员”,只有将LLM的生成能力与经典的系统搜索、持久化记忆强绑定,才能解决真实的科学硬骨头。
一句话总结: 本文提出了具备持久跨任务记忆的递归自我改进智能体MolRSI,它打破了AI在每次科学任务中都要从头试错的局限,最反直觉的是,它仅靠复用并重新组装历史任务中积累的工作流经验,就在使用完全相同数据的前提下将抗生素发现的实验命中率从人类专家的8.7%提升至15.9%,并在Claude Science等先进智能体完全失败的复杂蛋白质设计任务中成功获得了8个验证靶点,证明了结构化记忆与工作流优化在科学发现中比单纯的大模型推理更为关键。
Molecular discovery requires navigating vast combinatorial search spaces while balancing competing biological objectives. AI agents can automate expert-defined molecular design protocols, but automation alone does not address how to optimize workflows for new tasks or improve their development through experience. Here we introduce MoLRSI, an AI agent that combines systematic optimization of workflows and model architectures with persistent cross-task memory to recursively improve its search policy for molecular discovery. Workflow performance, refinement outcomes, and execution feedback guide subsequent searches, allowing the agent to improve both its workflows and its strategy for developing them. We evaluate MoLRSI in two challenging molecular discovery settings that require balancing competing properties. In antibiotic discovery, MoLRSI developed a screening workflow balancing antibacterial activity, cytotoxicity and structural novelty, achieving an experimental hit rate of 15.9%, compared with 8.7% for a previous expert-led workflow using the same training data and screening library. In de novo peptide-MHC binder design, MoLRSI developed workflows that jointly consider target binding and specificity, producing eight experimentally validated hits against MART-1 and SARS-CoV-1 pMHCs with preferential binding over tested off-targets while Claude Science completely failed. These findings demonstrate how experience-guided workflow optimization can address competing discovery objectives while improving the search strategies used in subsequent campaigns.
https://arxiv.org/abs/2610.39714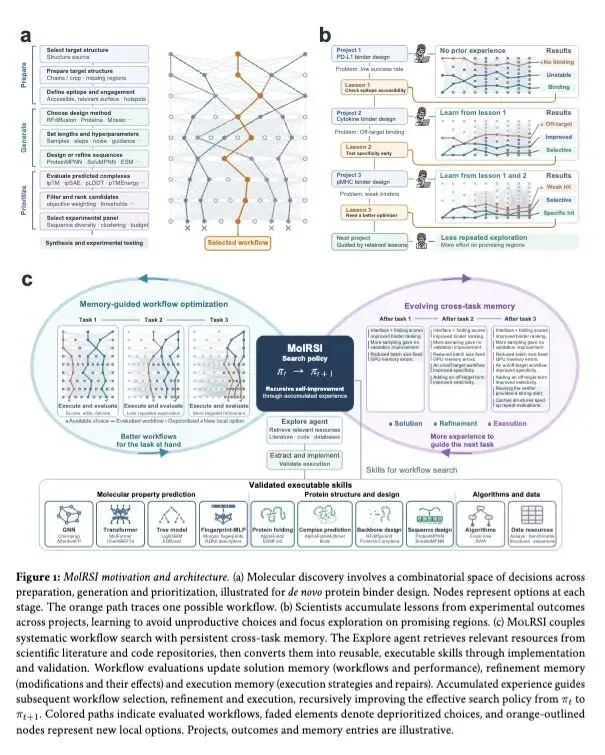
5、[LG] Rethinking Neural Thickets Without Weight Perturbations
N Dufour, E Gardès, A Dravid, P Pérez…
[Kyutai & Meta FAIR & UC Berkeley & Google DeepMind]
重新审视神经丛:无需权重扰动的新视角
要点:
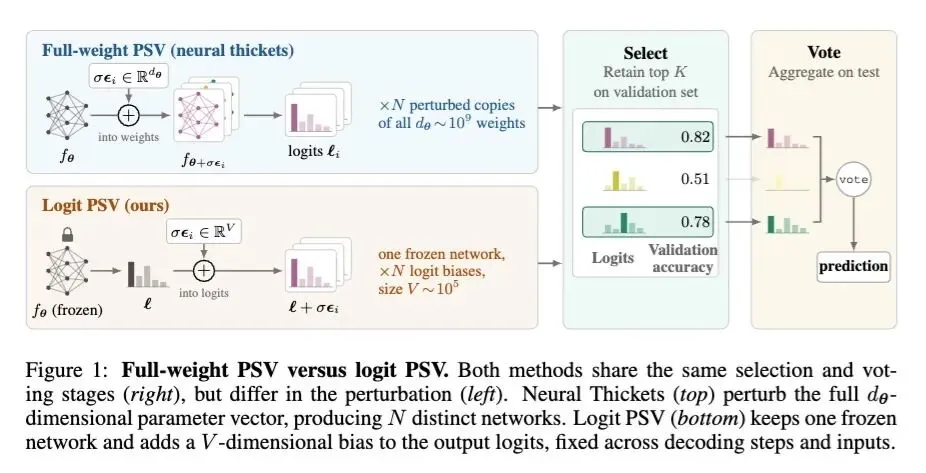
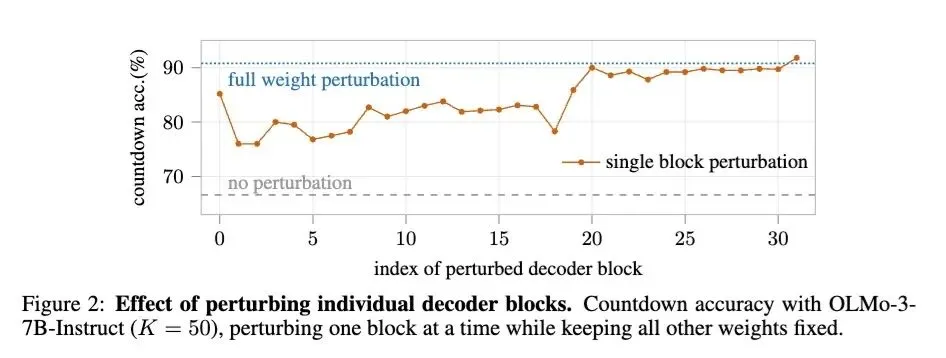
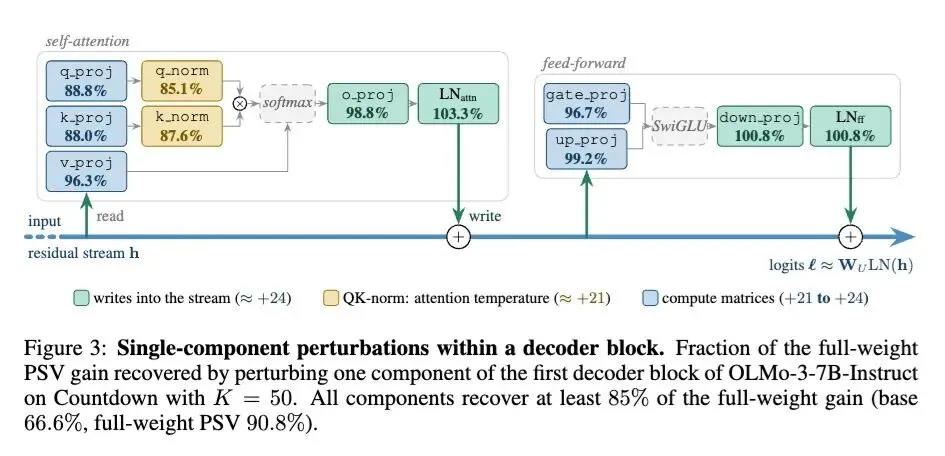
挑战了“神经丛(Neural Thickets)”假说,该假说原以为预训练语言模型在局部权重空间中密集存在着特定任务的专家模型,且可通过随机高斯扰动被发现。 证明了全权重扰动是完全不必要的;仅仅扰动单个解码器块,甚至扰动单个组件(如Value投影),就能恢复绝大部分的性能提升收益。 提出了Logit PSV(扰动-选择-投票)方法,这是一种无需训练、保持模型权重完全冻结的方法,仅在解码时向输出Logits添加固定的随机高斯偏置,其效果即可媲美甚至超越动用十亿级参数的全权重扰动集成。 通过一阶泰勒展开在数学和经验上证明,内部权重扰动本质上只是在输出Logits上引发结构化偏移的一种低效迂回的方式。 揭示了此前被归因为局部权重空间几何特性的巨大性能提升,实际上来源于经典的推理期机制:输出多样化、基于验证集的过滤选择以及多数投票(集成)。 实验表明,在强大的基座模型上,简单的温度调节多数投票(TT-MV)就能媲美全权重扰动,这证明多样性和投票机制解释了大部分收益;而较弱的模型则更依赖基于验证集的选择机制来过滤低质量输出。 将结论扩展至面临领域偏移的预训练视觉模型(如DINOv3),表明仅Logit扰动就能显著提升分布外性能(本质上起到了输出重校准的作用),而全权重扰动几乎没有带来任何额外收益。
主旨: 探究大模型“Neural Thickets(神经丛)”现象背后的真正机制,指出通过随机扰动预训练语言模型权重带来的任务性能巨大提升,并不需要“权重空间中存在局部任务专家”这一复杂的几何解释,而是可以通过更简单的、无需修改任何权重的输出空间扰动(Logits干预)来实现相同甚至更好的效果。
创新: 提出了Logit PSV(扰动-选择-投票)方法。该方法彻底放弃了对模型内部参数的修改,将大模型权重完全冻结,仅在模型输出的Logits层面上添加固定的随机高斯偏置来生成多样化输出序列,随后结合小批量验证集评估筛选出表现最好的偏置策略,并在测试时利用这些保留下来的策略进行多数投票,从而实现一种极度轻量级且免训练的推理期优化范式。
贡献:
理论纠偏:证伪了必须进行全网络权重扰动才能获得推理提升的直觉,通过消融实验证实单层乃至单组件扰动即可生效,澄清了学界对权重空间局部几何特性的误解。 机制降维:将复杂的权重空间现象成功降维解释为经典的统计与推理机制组合(采样多样性、验证选择和自洽性投票)。 理论架桥:通过一阶近似分析,从数学上严密地建立了内部权重扰动与输出Logit偏移之间的等价联系。 跨模态验证:成功将Logit PSV方法推广至视觉模型的领域适应任务中,证明了该机制在语言和视觉领域的普适性。
提升: 在极大地降低了计算、存储和显存开销(无需保存和前向传播数千个包含数十亿参数的受扰动模型,只需在推理末端维护十万级维度的Logit偏置向量)的前提下,Logit PSV在MATH-500、GSM8K、Countdown等多项复杂推理任务上取得了与全权重扰动相当或更高的准确率。在视觉分布外数据集(如FMoW和Waterbirds)上,Logit PSV将最差组准确率提升了5到6个百分点,而耗时费力的全权重扰动几乎毫无提升。
不足:
模型规模局限:目前的语言模型实验最高验证到7B参数规模,更大规模(如70B或千亿参数)的模型中是否存在Logit扰动无法轻易捕捉的深层权重空间效应尚不可知。 任务场景受限:PSV框架依赖带标签的验证集来进行成员选择,并且需要能够对生成的最终答案进行精确比对以完成投票,这限制了它在无法明确评判对错的开放式生成任务中的应用。 推理成本增加:尽管免去了训练和权重复制的成本,但在测试时仍需要对每个输入进行K次完整的模型前向评估(生成K个候选),相比于单次贪婪解码,其推理算力成本成倍增加。 近似条件苛刻:论文中建立的权重扰动与Logit偏置之间的一阶线性近似关系,仅在扰动尺度(sigma)极小时才严格成立,大尺度扰动下的非线性效应未被完全涵盖。
心得:
警惕深度学习中的“奥卡姆剃刀”陷阱:研究者很容易为偶然发现的经验现象赋予过于宏大或神秘的理论解释(如“高维权重空间中的神奇神经丛”)。本文极具启发性地指出,很多看似神奇的现象,其本质可能只是一些最朴素的机制(引入随机噪声带来的多样化+集成投票)在现代大模型上的简单投影。这提醒我们在研究中应始终遵循“如无必要,勿增实体”的原则,先去寻找最简单的机制解释。 权重空间与输出空间的深刻对偶性:论文揭示了“权重扰动”和“Logit扰动”之间的一阶等价性,这暗示了一个重要视角——对神经网络深层黑盒的复杂内部干预,往往可以被线性化并等价映射为对最终输出层(Logits)的直接干预。这为未来设计更高效的模型对齐、控制、水印嵌入和微调算法提供了新思路:或许我们不需要费力去微调百亿参数,只需学好如何巧妙地“调控Logits”。 适应新任务的本质往往是“重校准”:在视觉任务的领域偏移实验中,复杂的全权重搜索毫无建树,而极其简单的Logits偏置却大幅提升了分布外泛化能力。这启发我们重新思考模型Adaptation的本质,很多时候大模型并非缺乏解决特定任务的内部知识,它只是在输出概率分布上缺乏正确的置信度校准。通过极低成本的输出层重校准来“唤醒”模型已有能力,比盲目改变模型权重更具性价比。
一句话总结: 本文打破了“大模型局部权重空间密集存在任务专家”的传统几何假设,证明只需完全冻结模型并在输出Logits上施加随机偏置(Logit PSV),结合验证选择与投票机制,就能以极低成本复现甚至超越耗费巨大的全权重扰动所带来的性能飞跃,揭示了该现象的本质仅仅是推理期的输出多样化与集成,为低成本激发大模型潜力提供了全新的免训练范式。
The Neural Thickets hypothesis posits that pretrained language models lie in dense neighborhoods of task-specific experts in weight space, which random Gaussian perturbations can uncover. We reproduce the reported gains, but show that they do not require this geometric explanation. Perturbing a single decoder block already recovers much of the improvement, while keeping the model entirely frozen and adding a random bias to its output logits matches or exceeds full-weight perturbations on most reasoning tasks. This suggests an alternative explanation based on output diversity, validation-based selection, and voting. We formalize this view as Perturb-Select-Vote (PSV), a general procedure that generates perturbed predictors, selects high-performing members on a small validation set, and aggregates their predictions. This interpretation connects Neural Thickets to established inference-time methods, including sampling, self-consistency, and verifier-guided selection. A firstorder analysis further shows that small weight perturbations act primarily through their induced logit shifts. We extend this analysis to vision, where logit PSV substantially improves performance under domain shift, including on Earth observation, while full-weight perturbations provide little additional benefit. Together, these results suggest that the gains attributed to nearby weight-space experts can instead be obtained through output diversity, selection, and voting. Logit PSV realizes these benefits with a fully frozen model, providing a simple, trainingfree alternative to full-weight perturbation ensembles across language and vision.
https://arxiv.org/abs/2610.40649