ARTICLE · 1293839
实时数仓开发插件拆解第二篇 | 状态机负责当前位置与合法转场详解
目录
• 一条聊天记录装不下实时任务的状态[2] • 状态机负责当前位置与合法转场[3] • 证据台账负责把完成写成可核验事实[4] • 平台回读与用户确认各管一边[5] • 两种模式改变确认节奏[6] • 跨会话续跑先和平台对账[7] • 这套机制能证明什么,不能证明什么[8]
一条聊天记录装不下实时任务的状态
实时任务做到一半换个会话继续,最容易接错的地方通常不在 SQL。上一次对话里说过“编译没问题”,平台上的编译结果却可能是另一版。有人记得已经发布,实际只完成了提交。任务界面显示运行中,恢复点用的是哪一天却没有记录。
这些说法在当时都有依据,隔一段时间就只剩下语气。实时任务又一直处在变化中,开发版、发布版和运行实例可能对应不同版本,对象版本一变,之前拿到的回读也可能失去效力。只靠上下文的记忆继续往下做,风险会落在实际消费流量的那一步。
实时数开流水线把这件事拆成两套记录。状态机回答任务现在走到哪里,下一步允许去哪里。证据台账回答刚才那一步凭什么算完成,哪份平台输出能够支持这个判断。两套记录各做一件事,缺一套都不够。
状态机负责当前位置与合法转场
整条流程有八个阶段。
1 2 discover → design → build → debug → configure → submit → publish → start发现 设计 构建 调试 配置 提交 发布 启动
状态文件保存任务对象、文件级编号、版本、当前阶段、阶段历史、运行模式、Goal、已满足的门控和最近一次更新。它让新会话一打开就知道任务正在哪里,无需从几百条聊天里拼时间线。
阶段推进有方向。正常情况下一次只走一个阶段,跨阶段或回跳必须写明原因。回跳会出现在真实开发里,比如发布前发现字段口径需要重做,任务就得回到设计或构建。系统允许这类返工,同时把“为什么回来”留在记录里。下一名接手者能看到返工程序,知道当前版本为什么和旧证据对不上。
当前阶段也不自动证明阶段已经完成。停在 build 只表示任务正在构建,编译是否成功要看对应回执。停在 publish 也不表示对象已经发布,发布回读还要单独补齐。状态机管顺序,不替平台作证。
阶段历史与当前状态要分开看。当前状态可以随工作推进而更新,历次转场、置门和执行动作进入追加记录。这样既能快速知道现在在哪,也能追查怎么走到这里。
证据台账负责把完成写成可核验事实
实时流程目前登记四类结构化证据。
refs_readback | |
compile_receipt | |
submit_receipt | |
publish_receipt |
登记证据时,原始 JSON 会独立落盘,同时记录 SHA-256、产生它的工具、执行命令、观测时间,以及登记时的对象身份和版本。门控记录保存证据编号和哈希。后续自检重新计算哈希,发现文件被改动就拒绝通过。
证据还要通过内容校验。引用表回读里只要有一张表不是 published=true,整份回读不能开门。编译或提交状态仍在运行,不能当作成功。发布回执必须带对象回读,界面里的“操作完成”不足以说明审核过的对象已经就位。状态词、必填字段、证据类型和门控类型会一起检查,随便放一个文件进证据目录不会自动变成证据。
证据与对象身份绑定得很紧。任务还是同一个文件,版本从 v1 换到 v2,旧编译回执就失效。换成另一个文件级编号,即使版本号相同,旧证据也不能继续使用。对象变化后,状态查询会重新列出缺口,阶段推进同样会被拦住。
这解决了一个很常见的交接问题。记录里确实有一份 SUCCESS,它可能属于上一个版本,也可能属于另一条任务。身份和版本一并保存,才能判断它是不是眼前这次动作的结果。
平台回读与用户确认各管一边
门控分成两类,来源不能互相顶替。
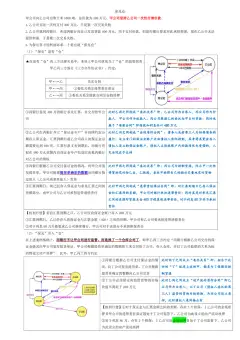
引用表发布、编译、提交和发布使用平台回读。调试结论、SLA 决策和启动使用用户确认。两者描述的是不同事实。回读证明现场状态,确认表达行动授权。发布阶段拿到对象回读,只能说明准备启动的是审核过的版本。它没有授予任务消费真实流量的权力。启动前还要有当次确认,迁移任务还要确认原任务已经停止,并给出明确的恢复点。只有确认、没有回读,系统不知道启动的是哪版对象。只有回读、没有确认,系统知道对象没接错,却没有人授权改变线上状态。
确认也带时间边界。默认的有效期可以通过项目配置调整,过期的确认不能给今天的高风险动作签字。阶段确认只对当前阶段推进有效,走到下一阶段要重新确认。恢复点是单独的确认项,必须由用户给出具体值,引擎不会自动把当前时间填进去。
图里最后一次确认只代表启动动作获得授权。迁移场景还并列着原任务已停和恢复点两个确认项,三个条件要分别满足。
两种模式改变确认节奏
开工前,用户要明确选择 manual 或 auto,并创建一个描述目标、范围、验收口径和启动策略的 Goal。模式选择写入追加式预检台账,Goal 与模式必须一致,运行中不能靠一句“这次自动做吧”临时改掉。
manual 在每个阶段推进前记录当前阶段的用户确认。它适合生产首次上线、口径复杂、启动会消费真实流量或上下游影响很大的任务。确认不能传递,上一阶段同意过,进入下一阶段仍要再说清楚。
auto 让阶段连续推进,用户不必守在每个阶段出口。证据门仍然逐项存在。引用表发布、编译终态、提交回执和发布回读都要过,缺一份就停。启动恢复点必须提前写进 Goal,执行过程还要留下动作记录和平台追踪 ID。自动模式扩大了连续执行的范围,没有取消现场证据。
这种分法解决了一个实际矛盾。全人工确认适合高风险场景,却会让低风险测试任务反复等消息。全自动执行省时间,如果把回读也省掉,系统很快会变成只会转发完成提示的代理。模式只改变谁来按确认键,证据底线留给两类模式共同遵守。
范围也应该写进 Goal。自动执行允许做什么、环境是哪一个、哪些动作必须停下、启动采用什么恢复策略,都属于事前授权的一部分。授权范围外的写操作需要重新确认。执行完成后,动作记录要带上平台追踪 ID,拿不到追踪结果就如实记失败或未验证,不能把“命令发出去了”写成“任务已经成功”。
跨会话续跑先和平台对账
新会话接手任务时,第一步是读当前阶段和缺口,第二步是回读平台上的对象、版本、提交或发布状态,第三步把观测结果与本地记录逐项比较。
对账一致,续跑记录会保存这次观测,任务可以继续。对账不一致,流程停下并列出字段差异,例如本地记为文件 F-1,平台回读却是 F-2。此时本地状态不会被平台结果自动覆盖,也不会继续推进。先处理差异,才能恢复工作。
这套顺序比“让 AI 回忆上次做到哪”可靠。聊天记录会丢,状态文件可能落后于平台,平台也可能出现人工操作。把当前状态、平台回读和证据账本放在一起核对,才能知道哪份记录需要修正。
运行时自检还会检查证据文件哈希、门控引用和证据类型。证据被改动、门控指向不存在的证据、类型与阶段要求不一致,都会在收口时暴露出来。阶段历史、门控记录、执行记录和证据索引因此能互相参照,任务交接不必依赖某个人的记性。
这套机制能证明什么,不能证明什么
它能证明一份回执文件的字段满足规则,哈希在登记后没有被改动,证据绑定的对象和版本仍然对应当前任务,门控类型没有混用,跨会话对账也没有发现已知差异。
它不能替平台证明文件来源。工具名和命令由执行者填写,伪造一份结构完整的 JSON 仍然可能骗过格式校验。宿主 hooks 能拦住直接修改证据目录的常见动作,平台账号权限、MCP 服务端权限和原始输出真伪仍由人和运行环境负责。证据台账让责任边界清楚,不能替代平台审计。
它也不能替人决定业务口径。重复消息怎样去重、窗口按哪条时间切分、SLA 是否合理、恢复点选在哪里,都要由业务和开发判断。平台 CLI 与 MCP 路径目前仍按未完成真实环境验证呈现,接入自己的环境前要做执行器检查和低风险联调。
状态机让实时任务可以持续往前走,证据台账让每一次继续都有依据。一个人临时记得不算交付,系统能拿出对象、版本、回执和确认,下一名接手者才敢接着动线上任务。
项目地址 MrSuiChuan/realtime-data-pipeline[1]许可证 Apache-2.0
引用链接
[1] MrSuiChuan/realtime-data-pipeline: https://github.com/MrSuiChuan/realtime-data-pipeline实时数仓开发插件拆解第一篇 | 开发到上线八个阶段详解