ARTICLE · 1295478
三个模板默认均线,最差的那组差一半
三个模板默认均线,最差的那组差一半
5/10、5/20、10/30,同一条中证500
创作|程飞 编辑|程飞 | 正文共:4,945字,预计阅读时间:13分钟
周一 07:10 · 工具杂记
周六上午本来想装个新平台试试,装完打开策略模板,默认参数是5日和20日两根均线。我顺手把我手上另外两套模板的默认值也翻出来,一个是5日/10日,一个是10日/30日。三个值摆在一起,我突然想到一个很土的问题:如果一个人什么都不改,直接用默认值跑,结果差多少?周日花了3小时把这个问题跑完,答案比我想的难看。顺便说一句,上周五收盘四个指数分化得厉害,中证500单日回落2.91%、20个交易日回落17.81%,这种环境恰好是参数差异被放大的时候。
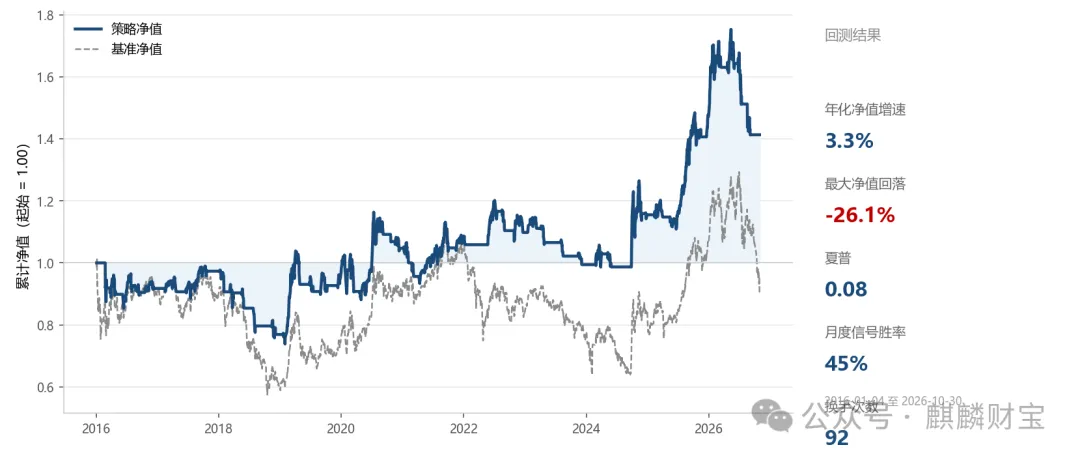
导读:同一指数(中证500)、同一区间(2016年1月4日到2026年10月30日,2628个交易日)、同一成本(单边0.5‰),只换均线参数。三组结果的规则净值是1.0229、0.7332、1.4131,最大回落是-37.64%、-50.50%、-26.14%,换手是162次、300次、92次。本文把这三条线拆开,再说清参数网格里哪些格子是陷阱,以及平台还藏着哪些默认值。
A|三组默认值,差别不在数字大小
我不点具体平台名,因为各家版本不一样,点名容易变成抬杠。重点是这三组值本身代表三种思路:5/10是超短周期,把均线当滤网用,追求快速反应;5/20是短线,长线只用来定方向;10/30偏中线,两边的周期都拉长了一截。这三种思路没有对错,但它们对成本的敏感度差了一个数量级。
三组值,最好的规则净值1.4131,最差的0.7332,中间差将近1倍。也就是说,同一个人、同一台电脑、同一段数据,只是在模板里少改一个数字,结果的量级就换了一个档。这一点比任何“参数优化技巧”都重要,因为它是默认发生的,不需要你做错什么。
还有一个容易被忽略的差异:三组参数的月度信号胜率是41.73%、41.28%、44.66%,全部低于50%。也就是说,这三组参数在自己的持仓月份里,大多数月份是负的。这不是参数没调好,是趋势型规则的常态:它们靠少数几个大月份吃饭,剩下时间在挨打。接受不了这个结构,就不应该用趋势型规则。
B|三条净值线,形状完全不同
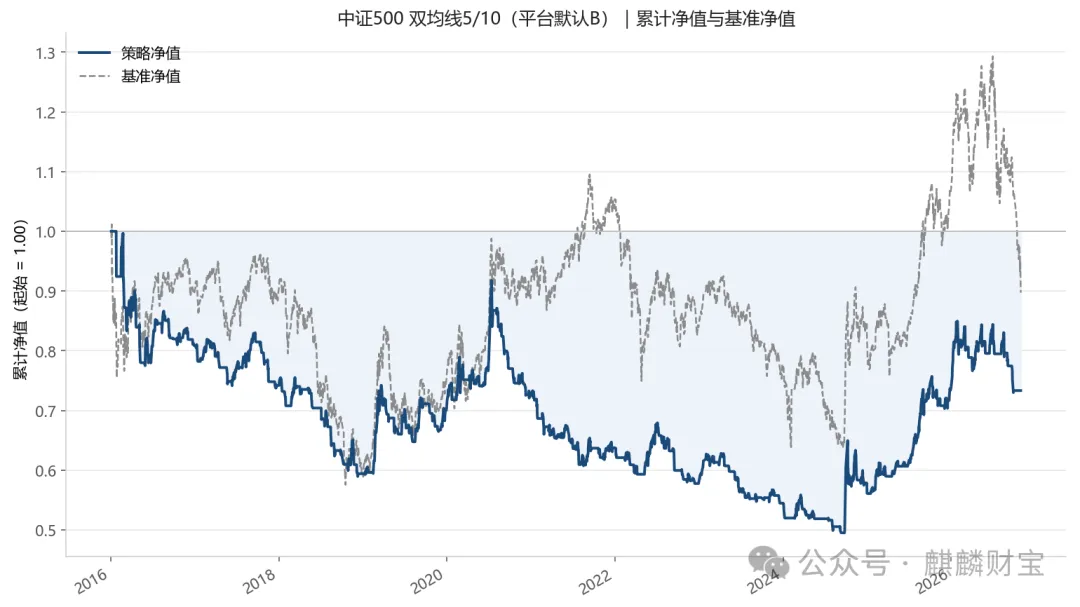
先看5/10那条。它的特点是上下震荡幅度大,净值在0.7到1.1之间来回,末端收在0.7332。这条线的问题不在方向判断,在换手:300次换向,10.77年,平均每年28次,差不多每9个交易日改一次主意。
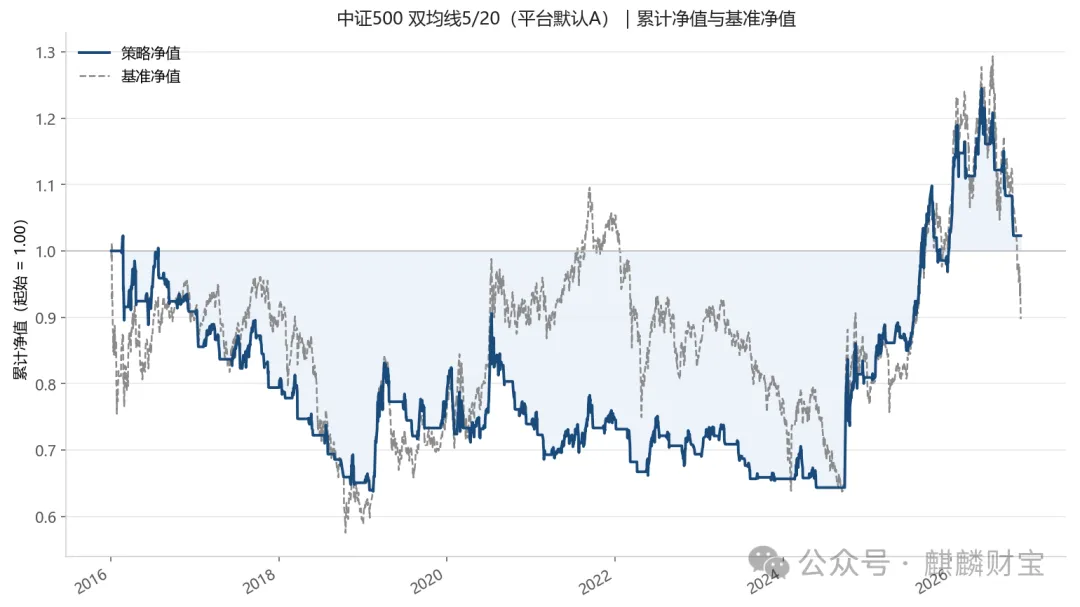
5/20这条明显平缓,净值在0.9到1.1之间走,末端1.0229,微微高过1。它的换手162次,比5/10少了近一半。这个改善不是参数“更准”,是“更少动”。
10/30这条是三条里唯一一个稳稳站在1.2以上走完大部分时间的,末端1.4131,最大回落-26.14%,换手92次。
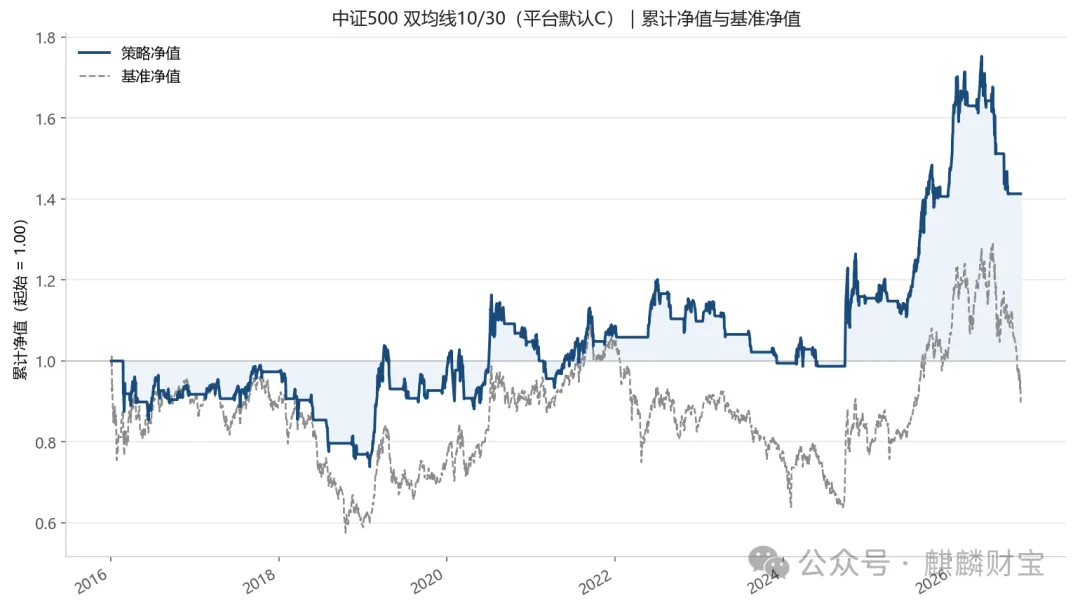
如果只看到这里,结论会是“把参数拉长就行”。这个结论是错的,下面两节会说为什么。你在同一段数据上看到的“更好”,很可能只是这段数据的性格。
C|换手300次的那条,坏在结构不在参数
5/10的分年度净值变化值得单独看:2016年-19.13%(基准-10.31%),2017年-8.26%(基准-0.20%),2018年-19.93%(基准-33.32%),2019年+18.41%(基准+26.38%),2020年+3.06%(基准+20.87%),2021年-12.07%(基准+15.58%),2022年-9.40%(基准-20.31%),2025年+31.40%(基准+30.39%)。
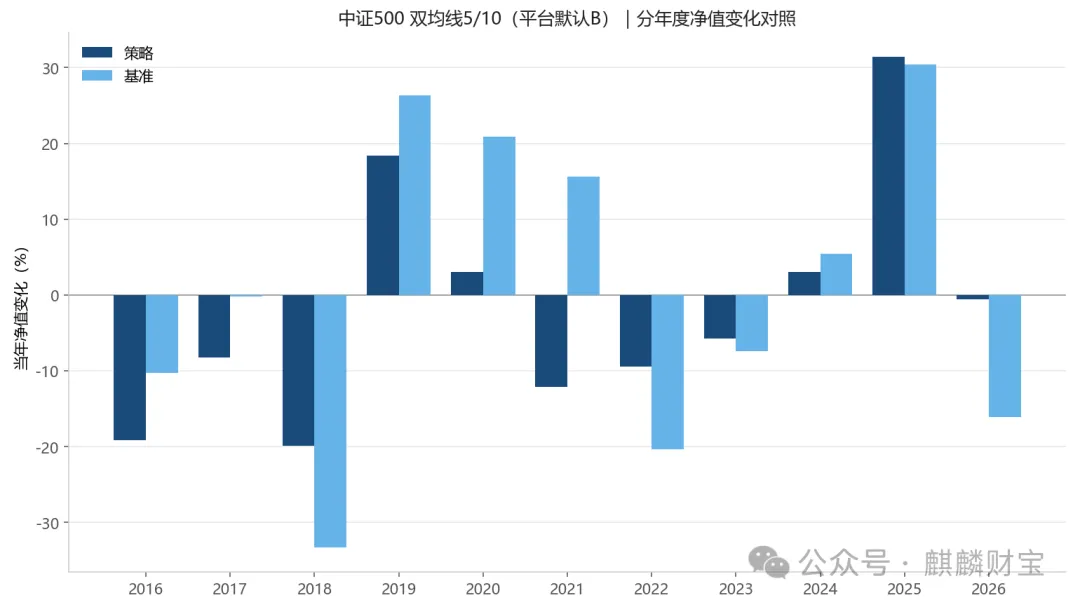
11个年度里只有4年跑赢基准,而且赢的幅度小、输的幅度大。2021年基准涨15.58%,它做-12.07%,差27.7个百分点,这种差距不是运气问题,是结构问题:短周期均线在震荡上行的年份里,会被每一次回踩打出去,然后再追回来,一进一出就是两次成本。一年28次换向,就是56次成本动作。
所以我一直说,短周期参数的敌人不是市场,是摩擦。同一套逻辑,把成本从0.5‰加到1‰,5/10会比10/30先崩。判断一组参数能不能用,先看它的换手,再看它的净值。
D|-50.50%这个数字是怎么来的
5/10的最大净值回落是-50.50%,10/30是-26.14%,两者差了24个百分点。这个差不是同一次行情里的深度差,而是“在场时间”的差。5/10在场时间占比52.82%,10/30在场50.27%,看起来接近,但分布完全不同:5/10的在场时间大量集中在急跌之后的反弹段,那一段最容易被下一根阴线埋掉。
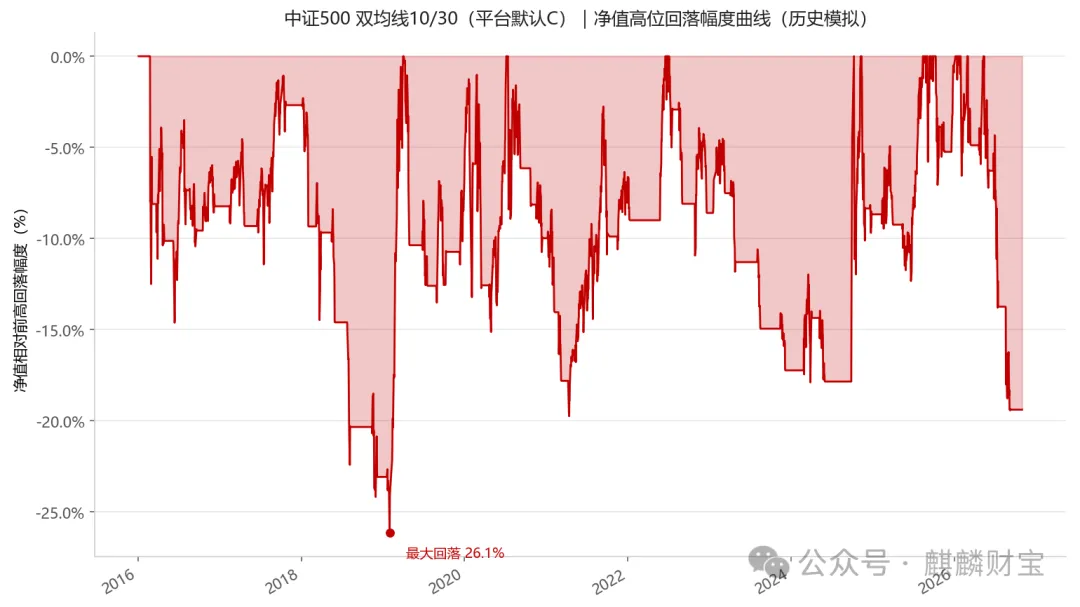
10/30的回落曲线明显平缓,最深的一段发生在2019年1月31日附近。这里有个反直觉的点:更长的均线并没有让你少在场,它让你少在最差的时候在场。在场时间几乎一样,结果差近1倍,差别全在“什么时候在场”。
E|25个格子里,几格是好格子
我把短周期按5、10、20、30,长周期按30、60、90、120交叉成16格跑了一遍(图上按4乘4排布),结果如下:净值高于1.0的只有3格,分别是10/30的1.4131、20/120的1.0569、10/120的1.0542;净值最低的一格是20/60的0.7541;还有一格很特殊,30/30的净值恒等于1.0,因为快慢线完全相同,永远不产生交叉,程序从头到尾没做过一次动作。
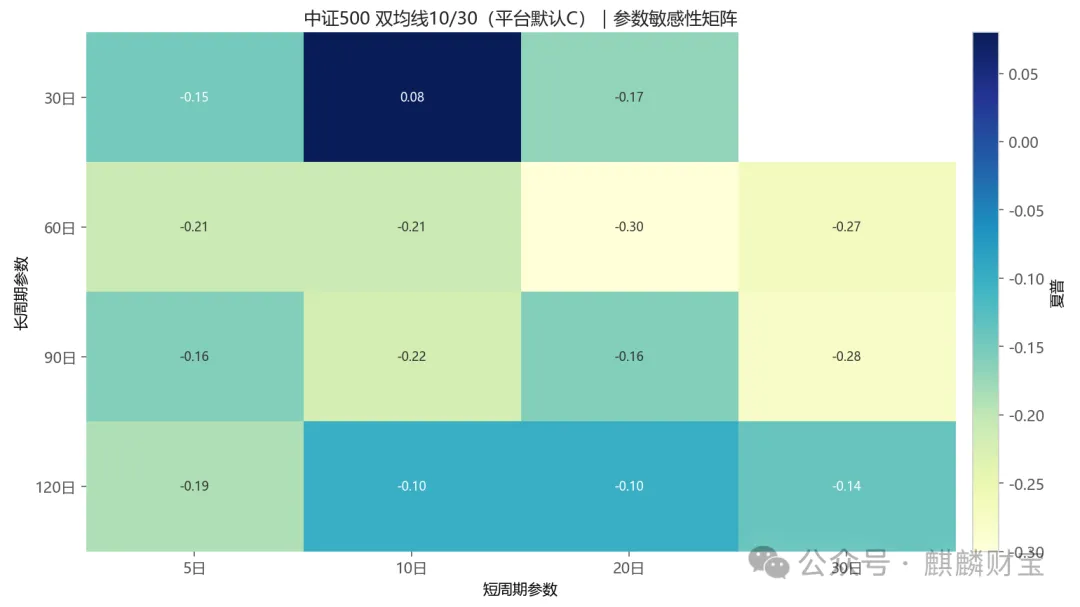
16格里3格能用,听着好像还能挑,但这里有个必须说清的问题:我是先看了结果才说哪3格好的。如果换一个指数、换一段起点,这3格会换位置。所以网格图的正确用法不是“挑最好那格”,而是看“好格子是不是连成片”。如果好格子是孤立的几个点,说明这是噪声;如果是一整片区域都不错,那这块区域才值得信。
这张图里的好格子是散的:10/30好、20/120好、10/120好,中间夹着20/60的0.7541。这种形状我给它的判断是“不可依赖”。连不成片的最优解,基本都是拟合出来的。
F|用前4年挑参数,挑到的那个在后7年变成负的
为了把“挑参数”这件事说透,我把同一批16格拆成两段重算:2016年1月到2019年12月为一段,2020年1月到2026年10月30日为另一段。如果当年只拿前4年做决定,我会挑中谁?
前段第一是5/90,段内净值1.141,在所有16格里最漂亮;它到了2020年之后变成0.827,整个后半段是负的,全段合起来只有0.9616。而全段第一的10/30,在前段只能排到第六(0.967),一点都不起眼。更夸张的是5/30,前段排最后一名(0.748),后段反而跑到1.272。同一个池子、同一套规则,两段行情给出两套完全相反的排名。
这张表就是参数优化的全部真相。真实工作里,大多数人是拿全部样本挑参数,然后拿同一段样本验证,自然怎么看都对。要假装对真实世界诚实,至少得把挑参数的那段和验证的那段分开,而且不能事后回头改。我自己的规矩是:只用前半段挑,挑完当参数封死,后半段只跑一次,跑完不改。
G|成本从0加到3‰,净值从1.4796滑到1.1222
这一组是我每次都要做的:把单边成本从0逐步加到3‰,看净值怎么走。10/30这组的结果是:0成本时净值1.4796、年化3.70%、最大回落-25.13%;0.5‰时1.4131、3.26%、-26.14%;1‰时1.3495、2.82%、-27.14%;2‰时1.2307、1.95%、-29.09%;3‰时1.1222、1.08%、-30.99%。
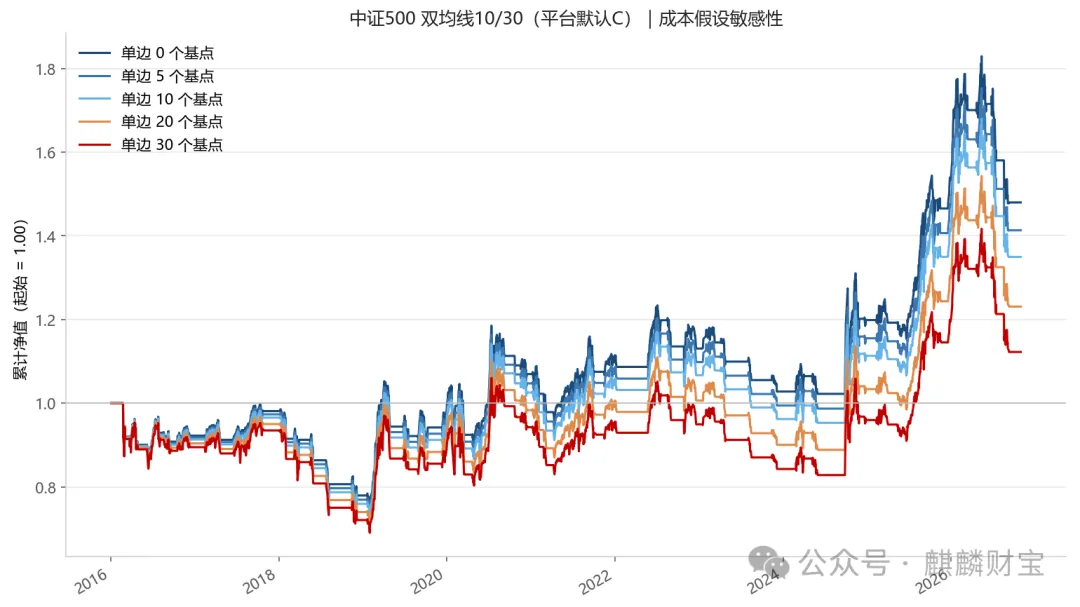
从0到3‰,年化从3.70%掉到1.08%,掉了2.62个百分点,净值从1.4796掉到1.1222,掉了约1/4。这个衰减速度对92次换手的规则来说是正常的,对300次换手的那条会快得多。成本敏感性不是一个“保守一点更安全”的选项,它是判断参数能不能用的硬门槛。
我的具体门槛:如果一组参数在单边1‰下净值跌破1.0,我就不再用它,不管它在0成本下多漂亮。理由是1‰在实际交易里一点都不高,佣金、过户费、买卖价差、冲击成本加在一起,很容易超过这个数。用0成本回测出来的结论,等于在用一个不可能存在的前提做决策。
H|代码:把默认值参数化
下面的骨架只做一件事:把参数、成本、执行假设全部显式写进函数签名,不允许任何默认值藏在里面。这是我被默认值坑过之后改的习惯。
def ma_rule(close, fast, slow, cost, exec_lag=1):
"""fast/slow/cost/exec_lag 全部必填,不给默认值"""
mf = close.rolling(fast).mean()
ms = close.rolling(slow).mean()
raw = (mf > ms).astype(int)
pos = raw.shift(exec_lag).fillna(0) # 执行滞后
sw = pos.diff().abs().fillna(0)
ret = close.pct_change().fillna(0)
net = pos * ret - sw * cost
nav = (1 + net).cumprod()
return nav.iloc[-1], int(sw.sum())
for pr in [(5,10), (5,20), (10,30)]:
nav0, n0 = ma_rule(close, pr[0], pr[1], 0.0)
nav1, n1 = ma_rule(close, pr[0], pr[1], 0.001)
print(pr, round(nav0,4), n0, round(nav1,4), n1)
这段代码有两个刻意的设计。第一,exec_lag是显式参数,不写成默认1,因为总有人想试0和2,写死在函数里等于把未来函数藏起来。第二,每组参数都同时打印0成本和1‰成本两个净值,逼自己看到成本的牙齿。我原来只打0成本,结果每次都在自我感觉良好里选参数。
I|平台还藏着哪些默认值
均线参数只是第一个坑。我这几年在几个平台上碰到的默认值还有:不复权、按收盘价成交、停牌日剔除、手续费万分之二点五、不扣印花税。这五项每一项都能单独把结论改掉。复权方式影响长样本的连续性,按收盘成交影响信号的执行价,停牌剔除会让样本股票数在长样本里悄悄变化,手续费和印花税影响所有高换手规则。
我现在拿到一个新平台,第一件事是把这五项挨个改成自己认的口径,改完再跑一遍空规则(直接持有)对一下基准净值。如果平台算出来的持有净值和我自己算的差超过1%,就说明还有一项默认值没对齐。对不上账之前,任何策略结果都不看。
还有一个平台层面的事得提一句:回测里的“按收盘价成交”在T+1的规则下并不能总是实现。信号在收盘后生成,你最早也只能在下一个交易日的开盘或盘中成交,这中间隔了一个隔夜跳空。本文这16格全部按“信号滞后一天、按收盘成交”算,已经包含了一个交易日的滞后,但没有把隔夜跳空的价差单独建模。这层差异会让高换手参数再难看一截,5/10这种300次换手的尤其明显。
写这行的结论很朴素:默认值不是中性的,它是一组被选定的假设。改不改不是重点,知道你用的是哪一组才是重点。
回到开头那个问题:如果什么都不改直接用默认值,三组结果差将近一倍。这还不是最坏的情况,最坏的是你改了参数、改了成本、改了复权,最后挑出一组1.4的净值,却不知道它是这16格里唯一运气好的那格。这两件事的区别,决定了你下一次还有没有饭吃。
这周兄弟号在写
窥市寻真放了四个指数的同一套规则;真龙现身拆机器学习模型的换手成本;寻真记算长期持有的时间账;聚宝葫芦写小区驿站那点事。
文中净值、回落、换手均为公开指数日线的历史回测结果(模拟),不预示未来表现,也不构成任何操作依据。