ARTICLE · 1299548
梯度累积到底省了什么?从公式、DDP 源码到 4090 D 实测
梯度累积到底省了什么?从公式、DDP 源码到 4090 D 实测
固定每次更新的有效 Batch 时,梯度累积通过缩小 Micro-batch,主要降低单次前反向的激活显存;参数、累积梯度和优化器状态通常不会随之按比例缩小。
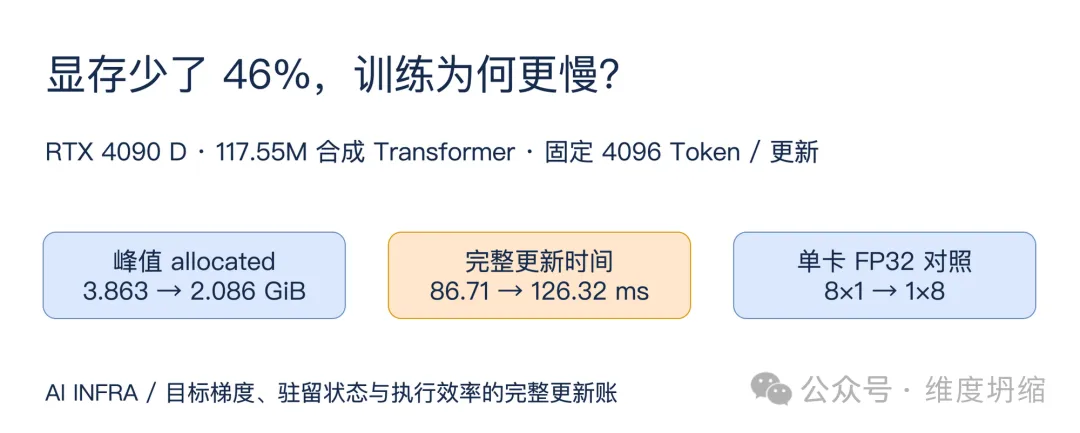
同一张 RTX 4090 D,同一个模型,每次更新处理同样的 4096 个 Token。把一次处理 8 条序列,改成每次处理 1 条、累积 8 次后,FP32 的显存峰值从 3.863 GiB 降到 2.086 GiB,平均每次更新时间却从 86.71 ms 增加到 126.32 ms。
显存减少约 46%,每次更新反而慢了约 45.7%。这组数据来自一个约 1.18 亿参数、随机初始化的合成因果 Transformer,测的是输入驻留 GPU 后的完整更新循环,不包含取数和主机到设备搬运。
要判断梯度累积是否正确、是否划算,需要把目标函数、状态生命周期、通信时机和执行形状放到同一个更新窗口里分析。
一、先把目标函数写清楚:究竟在平均什么
假设采用普通数据并行,共 W 个副本,每个副本在一次更新前依次处理 K 个 Micro-batch。W 是数据并行组大小,不能把协作处理同一份输入的张量并行进程也乘成额外样本。
设第 r 个副本、第 k 个 Micro-batch 有 nᵣₖ 个有效预测目标,Sᵣₖ(θ) 是这些目标的损失之和。若要求所有有效目标等权,一次更新应当优化:
N = Σᵣ Σₖ nᵣₖ
L(θ) = [Σᵣ Σₖ Sᵣₖ(θ)] / N
g = [Σᵣ Σₖ ∇Sᵣₖ(θ)] / N
梯度能够分批累加,来自求导与求和的关系。前提是窗口内使用相同的 θ,损失按这些目标相加,相关计算也满足拆批条件。如果每个 Micro-batch 都更新一次参数,后面的梯度就来自已经改变的权重,优化器历史也随之推进,不能再视为同一次更新的执行拆分。
接着处理 DDP 的平均。普通 DDP 默认平均各副本的梯度;因此,若各副本只反传自己负责的损失和除以全局 N,最终还会额外除以 W。[1] 在没有其他自动缩放或自定义聚合语义时,每个 Micro-batch 应贡献:
Lᵣₖ = W × Sᵣₖ / N
DDP 平均后,W 抵消,得到的才是全局目标梯度。很多教程中的 mean_loss / K,其实是它的特殊情况:所有副本都有相同 K,每个 Micro-batch 都有相同数量 n 的有效目标,因而 N=WKn。
W × Sᵣₖ / N = Sᵣₖ / (Kn) = mean_lossᵣₖ / K
所以,除以累积次数不是任意变长任务都成立的定义。以两个 Rank、各累积两次为例,目标数分别为 2、6、4、8,总数为 20。若每批先取 mean,再除以 2,最后 DDP 再平均,一个目标实际获得的系数就是 1 / (4nᵣₖ)。
最小批次中是 1/8,最大批次中是 1/32,而正确的等权系数应统一为 1/20。程序可以不报错,所有 Rank 的参数也能保持一致,但优化的目标已经变了。
因果语言模型还需要按实际参与损失的预测标签计数,处理位移和忽略位置。[2] 输入张量长度、非填充输入 Token 数、有效预测目标数可能不同。若目标改成按序列平均或带权平均,应重新定义分母,而不是沿用 Token 平均的公式。
实现上,可以先统计本地窗口的有效目标,再在数据并行组内汇总计数。计数只需要交换少量标量,但不必因此把整个窗口的大张量提前搬到 GPU。也可以设计最终同步后的梯度归一化,不过必须处理它与 AMP、裁剪、自定义通信 hook 的顺序,并考虑未归一化梯度的数值范围。
窗口状态因此不只包括 K,还包括有效目标总数、数据并行组、最后一次反向标记,以及本次是否真正更新参数。把这些状态明确维护,比在训练循环里散落多个取模条件更容易核对。
混合并行时,N 的汇总范围也必须与执行梯度平均的数据并行组对应。把另一个组的目标数加入分母,或者用整个作业的进程数替代 W,都会改变缩放。检查实现时,应同时核对 DDP 使用的进程组、目标计数 collective 的进程组及其大小。
还需要区分“汇总 loss 用于展示”和“构造 loss 用于反向”。日志里把各批 loss 求个平均,只是在汇总标量;它不会自动修正已经按错误权重生成的梯度。检查训练器时,应沿真正传给 backward 的张量追踪,而不是仅看进度条上显示了什么。
同理,两个方案恰好得到接近的平均 loss,也不能单独证明梯度一致。它们可能在不同参数方向上赋予了不同权重,只是最终标量碰巧接近。因此,本次验证直接比较参数梯度向量,并保留更新后的参数误差,而不是把 loss 曲线是否重合当成唯一判据。
二、省下的是哪些显存:从生命周期到实测下限
通常的累积方式,是一个 Micro-batch 前向结束后立即反向,把梯度累加到参数的 .grad,然后处理下一批。PyTorch 自动求导会向相应叶子张量的梯度字段累积贡献。[3] 激活服务于当前反向,梯度保留到更新,优化器历史则跨更新保留。
如果把多个带计算图的 loss 都存起来,最后才一起反向,多个计算图的激活可能同时驻留。若 Micro-batch 完全没变,只提高累积次数,单次激活需求也没有因此变小;变化的首先是有效 Batch。
显存峰值应按同时存活的数据计算:
M_peak = maxₜ [M_state(t) + M_activation(t) + M_workspace(t)]
M_state 是实际驻留的参数、梯度与优化器状态,M_workspace 是执行和通信需要的临时空间。某个模块的激活峰值与另一个时刻的工作区峰值,不能不看生命周期就直接相加。
本次模型有 P=117,549,056 个参数,参数和梯度均为 FP32。若按参数、梯度以及 Adam 两份 FP32 矩状态列账,主要状态合计约 16P 字节,即 1.752 GiB;原始记录中的优化器 CUDA 状态约 0.876 GiB,与两份矩状态的字节量一致。
这给出了一个直观下限:Micro-batch 缩小,激活可能减少,但这些状态不会一起按样本数缩小。FP32 的 1×8 峰值仍有 2.086 GiB,正说明单次激活之外,还有需要持续保留的数据。
存储格式必须来自实际实现。不同框架可能保存低精度权重、独立主权重、不同精度的梯度或优化器状态;本次 BF16 组使用 autocast,参数和梯度仍是 FP32,不能将它描述为“整个模型都改成了 BF16”。[4]
窗口开始时若 .grad 为 None,第一次反向才建立梯度存储;后续 Micro-batch 的新激活,会与已累积梯度同时存在。测量应在优化器状态已初始化后覆盖完整累积窗口,将常驻状态计入显存;首次初始化过程的峰值需另行测量,不能用稳态峰值代替。
同步策略也可能改变驻留。FSDP1 的 no_sync() 可能在同步前保留完整梯度而不是梯度分片。[5] 因此,DDP 中减少中间同步的做法,不能不加分析地当作所有分片训练的省显存开关。
“显存占用”本身还需要标出口径。allocated 描述 PyTorch allocator 管理的活跃分配,reserved 描述它保留的内存;设备工具看到的总占用还可能包含 CUDA 上下文和库的其他分配。本文用 allocated 对照张量执行的峰值,不能把 2.086 GiB 直接解释成整张 GPU 只占用了这么多内存。
测试在各配置的独立进程里执行,先完成模型与优化器的预热,再重置峰值统计,避免把上一个大配置留下的 allocator 缓存直接当成小配置的结果。重置统计只改变计数的起点,不会清除仍然活着的参数、梯度或优化器状态。
BF16 autocast 也有类似的口径问题。脚本在低精度计算路径后,把 logits 转成 FP32 来计算交叉熵;参数和梯度仍然是 FP32。这里比较的是混合精度执行策略,而不是把所有张量统一换成两字节,所以不能用一个“精度减半”的比例去预测整个峰值。
三、单卡测到了什么:容量省下来,时间去了哪里
单卡性能测试使用 RTX 4090 D、PyTorch 2.14.1+cu130、CUDA runtime 13.0,驱动为 580.173.02。模型为 8 层因果 Transformer,hidden 1024、16 heads、FFN 4 倍宽度、vocab 8192,使用 LayerNorm、GELU 和 PyTorch SDPA;无位置嵌入、无预训练权重,Dropout 为 0。
每次更新固定 8 条、每条 512 Token。对照 8×1、4×2、2×4、1×8,分别表示 Micro-batch 与累积次数。优化器为 AdamW,关闭 foreach、fused、TF32 和 torch.compile,SDPA 自动选择实现。
各组预热 3 次更新,再测 3 个重复,每个重复包含 5 次更新。下面的时间是三个重复均值的中位数;显存是测量窗口内 PyTorch allocator 的峰值 allocated,GiB 按 2³⁰ bytes 换算。
FP32 的四组结果为:8×1,86.71 ms、3.863 GiB;4×2,91.14 ms、3.034 GiB;2×4,105.30 ms、2.401 GiB;1×8,126.32 ms、2.086 GiB。
BF16 autocast 对应为:8×1,35.91 ms、3.121 GiB;4×2,38.89 ms、2.765 GiB;2×4,56.13 ms、2.368 GiB;1×8,103.26 ms、2.176 GiB。
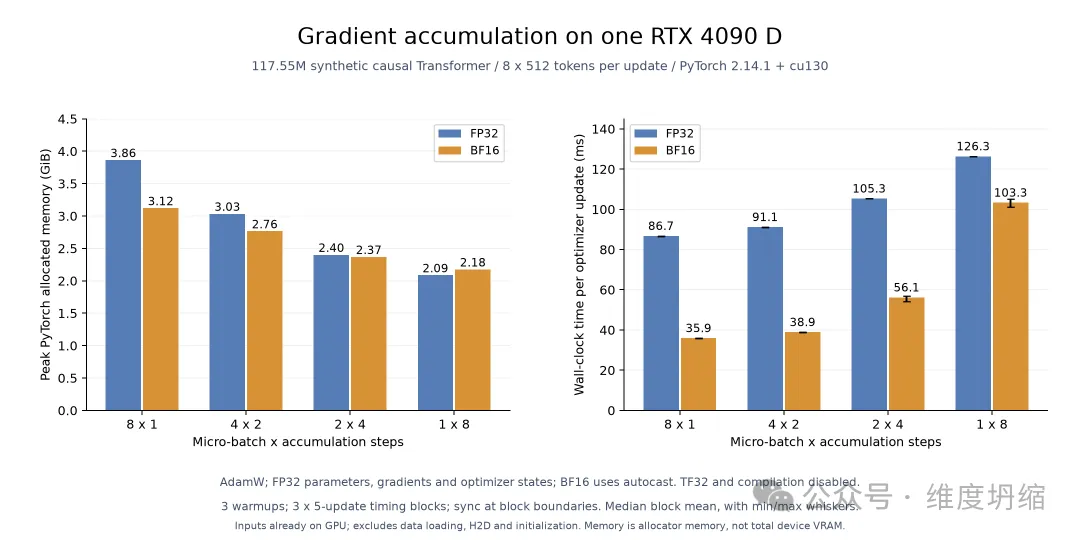
图一:真实单卡实验。每个计时窗口连续执行 5 次完整更新,开始前和结束后执行 CUDA 同步;总墙钟时间除以 5 得到平均每次更新时间。时间柱为三个窗口均值的中位数,误差线为最小与最大窗口均值;显存为稳态峰值 allocated。输入预先驻留 GPU,不包含取数、H2D、首次初始化过程或编译。
FP32 从 8×1 改为 1×8,峰值 allocated 减少约 46.0%,平均每次更新时间增至 1.457 倍,有效吞吐下降约 31.4%。BF16 对应显存减少约 30.3%,平均每次更新时间增至 2.876 倍,有效吞吐下降约 65.2%。
固定本地有效 Batch 为 B,令 Micro-batch 为 b、K=B/b,可以用下面的近似模型拆解更新:
T_update ≈ T_forward_backward + T_dispatch_exposed + T_comm_exposed + T_optimizer + T_input_exposed
T_forward_backward 与 T_optimizer 分别统计前反向和优化器的 GPU 执行区间;三个 exposed 项只统计未被计算及其他已归因区间覆盖的提交、通信和输入等待。各项按不重叠的关键路径区间记账,同一段墙钟时间只能归因一次,不能把 CPU 提交总时间与 GPU 执行总时间直接相加。单卡这一组没有 DDP 通信。
总样本量不变,不代表 T_forward_backward 不变。设线性层输入为 T×H、权重为 H×D,前向主要矩阵乘法约有 2THD 次浮点运算。在输入、权重、输出都用 q 字节元素、各触及一次的简化模型下,算术强度约为:
2THD / [q(TH + HD + TD)]
当输入 Token 维 T 减小,权重项 HD 不跟着减小,单次权重访问能够摊销的计算可能减少;矩阵分块与并行度也会变化。[6] 实际缓存、融合和反向仍需单独分析,不能把这条估算式直接当成 HBM 实测流量。
Profiler 给出了执行形状的直接证据。对 FP32 的 8×1 与 1×8 各采集一次完整更新,aten::mm 调用由 67 次变成 536 次,aten::addmm 由 32 次变成 256 次;efficient attention 前向和反向各由 8 次变成 64 次。对应矩阵的 Token 维也从 4096 变成 512。
这些记录支持“更多、更小的调用改变了执行成本”的解释,但不能把调用数乘八说成耗时也乘八。Profiler 与正式计时分开,聚合算子和底层 kernel 可能展示同一份工作,未将表格各行时间直接相加。
跨精度还有一个值得保留的观测:BF16 的 1×8 峰值略高于 FP32。这说明精度名称不能直接替代显存测量;本轮未做逐张量存活分解,尚不能把差异归因于单一缓存或工作区。
图中的误差线也有明确含义:它表示三个重复均值之间的最小与最大值,不是置信区间,更不是生产尾延迟。每次重复内部连续测五次更新,再计算平均,因此本文没有把十五次更新当作十五个彼此独立的样本。
原始记录同时保留了 CUDA Event 与主机墙钟计时。前者标记设备流中的测量窗口,后者包含主机提交和等待完成等成本;它们可以相互帮助定位,但不是同一统计口径。本文的更新时间统一使用墙钟结果,未从两种时钟里分别挑选更好看的数值。
例如 BF16 的 2×4 组,三个均值约在 54.23—57.01 ms 之间;1×8 组约在 101.18—105.03 ms 之间。实验没有锁定 GPU 频率,短时调度与运行状态仍可能影响结果。保留这些原始范围,比只给一个没有测量条件的“加速比”更容易复核。
还有一个实际决策前提:本次 8×1 基准本来就能装下,比较的是拆批的代价。如果真实模型在目标有效 Batch 下直接 OOM,完整大批次就不是可运行方案;此时累积的首要价值是让训练能够执行,再在能放下的 Micro-batch 中寻找效率更好的配置。
四、进入 DDP 源码:延迟更新,不会自动延迟同步
下面的源码与 GPU 实测统一对应 PyTorch 2.14.1,提交为 5c4886908584029761b579af026dcfb627c84070。讨论普通 DDP 路径,未启用 static graph、unused-parameter 搜索或自定义跳过归约策略。
DDP 默认在反向过程中同步梯度。若只是把 optimizer.step() 推迟到窗口末尾,而每次前向和反向仍走正常同步路径,中间归约就不会自动消失。数据并行同步的是参数梯度,同一组可训练参数的梯度张量,通常不会因为 Micro-batch 缩小就等比例变小。
Python 层的 no_sync() 会临时把 require_backward_grad_sync 设为 False,退出时恢复。关键读取时机在前向后的 _post_forward():正常路径会调用 Reducer 的 prepare_for_backward()。[7]
进入 C++ 的 reducer.cpp,prepare_for_backward() 设置 expect_autograd_hooks_ 并重置 bucket 计数;后续梯度就绪事件推动参数与 bucket 的就绪状态,mark_bucket_ready() 再按顺序推进归约。[8]
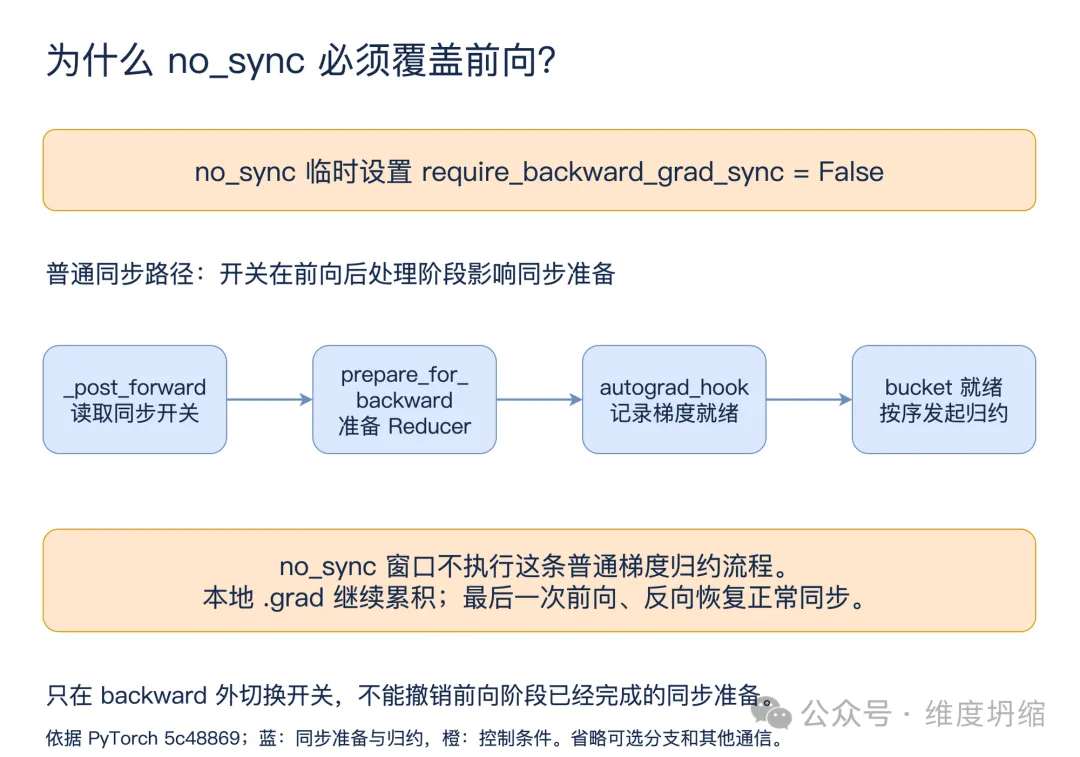
图二:按 PyTorch 2.14.1 对应提交绘制的普通 DDP 控制路径。橙色为同步开关,蓝色为准备与归约路径;省略可选分支和其他类型通信。
因此,前向已经在正常上下文里执行完,再只把 backward 包进 no_sync,不能假定前面完成的同步准备会被撤销。正确的普通累积结构,是把前 K−1 次的前向和反向一起覆盖,最后一次恢复正常同步。
这里要区分两类职责:自动求导向参数 .grad 累积局部贡献,Reducer 的 hook 则观察就绪状态并推进分布式归约。关闭普通归约路径的准备,不会取消本地梯度计算,因此窗口里的梯度仍然能够累加。
bucket 准备好,也不等于它可以任意抢先归约。各 Rank 需要维持可匹配的 collective 序列。出现等待时,应把梯度就绪与前序计算放进同一条时间线,再判断是否存在传输瓶颈。
本次计数 hook 委托 PyTorch 官方默认 all-reduce hook,保留其平均语义,只记录梯度 bucket 的提交次数。[9] 如果自定义 hook 改变求和、除数或压缩行为,第一节的缩放系数就要重新核对,不能沿用默认 DDP 的结论。
no_sync 的范围也仅限于它管理的梯度同步。本次实验里,模型初始化、全局目标计数和结果收集仍然有通信。更复杂的模型若在前向包含其他 collective,还要单独检查,不能把前 K−1 次反向未归约写成“前 K−1 次完全没有通信”。
最后一次同步也可能仍需等待掉队者。某个 Rank 的输入准备或反向更慢,其他 Rank 即使少做了中间归约,也可能在窗口末尾重新等待。同步次数减少是机制变化;暴露等待减少多少、完整更新是否更快,则要由对应负载的时间线回答。
五、先证明梯度对,再判断通信是否省了
正确性与性能使用同一合成 Transformer 结构,但正确性输入故意设置不等长有效目标,总数为 3228。分别构造 FP32、BF16 的全批参考,再比较同精度下的累积梯度,并执行一次学习率 0.01 的 SGD 更新。
这里屏蔽的是部分预测标签,并没有裁掉相应输入张量;前向仍处理原来的输入形状。所以 3228 描述损失的有效目标,不代表 GPU 只执行了 3228 个输入位置的计算。性能组则使用全部 4096 个有效目标,两组数据不能混在同一个吞吐分母里。
FP32 三个累积配置的梯度最大绝对误差约为 1.34e-9—2.91e-9,相对 L2 误差约为 9.47e-7—1.11e-6。BF16 对应约为 1.44e-5—1.66e-5 和 0.00565—0.00607。
实验前设定的判据是:FP32 最大绝对误差不超过 1e-4、相对 L2 不超过 1e-3;BF16 分别不超过 2e-2 和 5e-2。正确配置均通过。阈值是此次验证选择的数值判据,不是所有模型的统一精度标准。
BF16 全批相对 FP32 全批的梯度相对 L2 差异约为 0.00563。因此,改变批次形状后的 BF16 差异,需要与精度本身的变化一起解释,不能承诺逐位相同,也不能看到非零差异就断言累积公式出错。
负对照把每个 Micro-batch 的 mean 等权累积,忽略不等长目标的全局分母。FP32 梯度相对 L2 误差约为 0.1814,BF16 约为 0.1822,均被检测出来。“约 18%”描述的是梯度向量相对误差,不能解释为模型准确率下降 18%。
接着在两张真实 GPU 上运行 NCCL 对照。为清楚检查同步行为,这一组使用 float64 的小型线性模型,20 个目标按 2、6、4、8 分配,模型和目标规模与单卡性能组不同。
正确全局归一化、每批同步时,每个 Rank 的梯度 bucket hook 调用为 2 次。前向和反向一起 no_sync 后为 1 次;只给 backward 套 no_sync,仍为 2 次。三个方案相对全批参考的梯度最大绝对误差均约为 5.55e-17。
错误 mean 等权累积也只同步一次,却产生约 0.09484 的梯度最大绝对误差。两 Rank 观测一致,没有 hook 的 native DDP 对照也通过。模型只有一个梯度 bucket,计数不包含初始化、目标计数与结果收集等 collective。
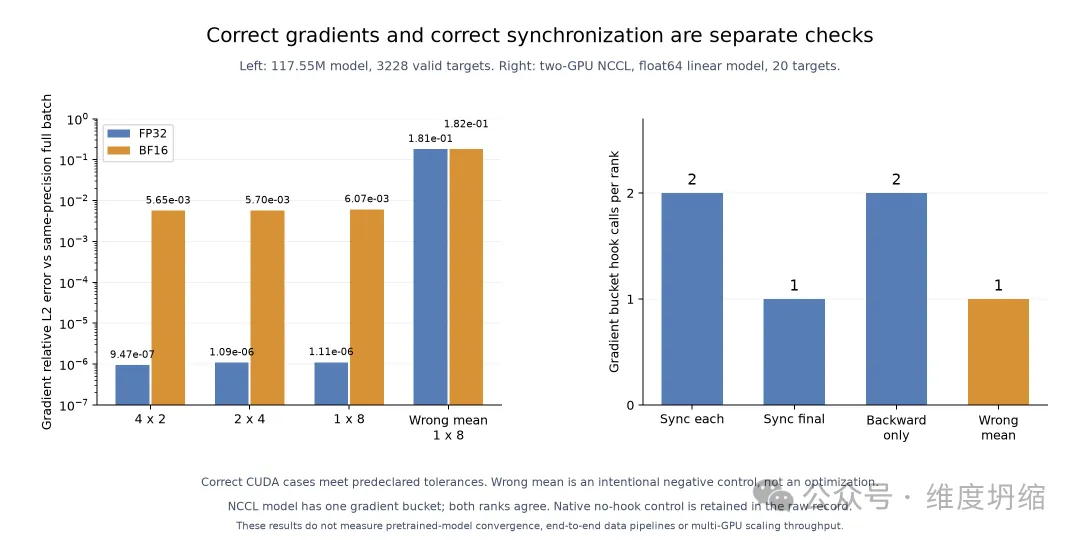
图三:左侧为单卡合成 Transformer 的梯度相对 L2 误差;右侧为实际双卡 NCCL 小模型的梯度 bucket 调用次数。两组实验分别验证数值与同步,没有测量双卡扩展吞吐。
这组对照说明了一个工程问题:通信流程正确、所有 Rank 一致、程序顺利结束,都不足以单独证明目标函数正确。测试还必须覆盖等权 mean 化简不成立的输入;如果所有小批次恰好同样长,这个错误反而可能被测试掩盖。
正确性测试采用 SGD,是为了清楚观察一份梯度如何映射成一次参数变化;性能测试采用 AdamW,则是为了把常驻矩状态和实际优化器更新纳入成本。两组测试的优化器不同;一次参数更新核验也不涉及长期收敛。
误差数字还需要与参考对象一起保存。同精度累积相对同精度全批的误差,用来观察拆批带来的数值变化;BF16 全批相对 FP32 全批的误差,用来观察精度路径变化。若把这两个参照混用,就可能把量化与舍入的影响错误归到同步流程上。
六、落到真实训练:围绕一次完整更新组织代码
先明确目标是按 Token、按序列还是按样本权重平均,再确定全局分母。已经使用 Trainer、Accelerate 等封装时,要检查框架是否完成了累积或损失缩放,避免再次机械乘 W、除 K。[10]
对于已正确处理预测标签、采用默认 DDP 平均、没有其他缩放的情况,核心结构如下。所有 Rank 需要按一致的窗口边界执行:
optimizer.zero_grad(set_to_none=True)
for i, batch inenumerate(window):
    context = ddp.no_sync() if i < len(window) - 1else nullcontext()
with context:
        logits = ddp(batch.inputs)
        loss_sum = task_loss_sum(logits, batch.labels)
        loss = loss_sum * dp_world_size / global_valid_targets
        loss.backward()
optimizer.step()
这里 task_loss_sum 必须求当前批有效目标的损失和,global_valid_targets 是整个数据并行窗口的有效目标总数且大于零。它是说明更新结构的片段,完整可运行实验脚本附在文末。
使用 GradScaler 时,同一个累积窗口应保持相同缩放因子;累积结束后再 unscale,并在需要时裁剪,然后执行 step 与 update。[11] 中途把部分梯度取消缩放,再混入新的缩放梯度,会破坏这份梯度账。
裁剪顺序可以用一维例子理解:两份贡献为 3、−2,阈值为 1。分别裁剪后相加为 0,先相加再裁剪为 1。即使没有分布式,两种流程也已经对应不同的更新。
尾部不足 K 次的窗口要按实际有效目标处理;某个 Rank 没有有效目标,也不能独自跳过分布式协议要求的计算和同步。若全局分母为零,应让各 Rank 统一处理该窗口,避免除零与通信分支失配。
等价条件同样要检查。BatchNorm 在训练时依赖当前批次统计量,拆批会改变计算。[12] Dropout、批次相关操作与浮点归约顺序,也可能使两种执行产生差异。梯度可加这条数学关系,需要与具体计算路径一起使用。
性能验收则固定模型、精度、输入分布、有效 Batch 与并行规模,覆盖前向、反向、最终同步和优化器更新。GPU 是异步执行的,主机完成提交不代表更新已经结束;在测量窗口边界处理异步完成,也不要靠每个 Micro-batch 强制同步来改变原来的流水。[13]
真实作业还要把取数、搬运、评估、保存和故障恢复纳入完成时间。记录输入 Token、有效目标和成功更新次数,也能避免两个“相同 Step”的任务实际消耗不同工作量。
把数据管线加入计时后,还应保持相同样本顺序、预取策略和有效工作量。若任务原本受输入供给限制,GPU 驻留输入的结果不能直接预测端到端收益;反过来,只看端到端时间,也可能掩盖算子已经改善、等待却转移到取数阶段的情况。
参数调优可以分成两轮:先固定有效 Batch 和目标函数,只改变 Micro-batch 与累积次数,确认梯度和执行成本;再依据释放的容量探索更大的有效 Batch。后一轮同时改变了优化设置,应重新验证训练行为,不能把它与前一轮混成纯系统提速。
梯度累积的价值,是让有限显存承接合适的有效 Batch。真正值得保留的配置,应当同时满足三件事:目标梯度正确、容量能够承受、相同训练工作量的完成时间符合要求。
附录:复现代码
单卡脚本保存为 benchmark_cuda.py,双卡脚本保存为 verify_ddp_cuda.py。实验环境为 PyTorch 2.14.1+cu130;性能脚本需要一张可用 CUDA GPU,NCCL 脚本需要两张。以下命令中的 profile 与正式计时独立执行:
单卡脚本分为两段。将两段按顺序写入同一个 benchmark_cuda.py,两段之间保留两个空行。
CUDA_VISIBLE_DEVICES=0 python benchmark_cuda.py --mode correctness
CUDA_VISIBLE_DEVICES=0 python benchmark_cuda.py --mode benchmark --micro 8 --precision fp32
CUDA_VISIBLE_DEVICES=0 python benchmark_cuda.py --mode benchmark --micro 1 --precision fp32
CUDA_VISIBLE_DEVICES=0 python benchmark_cuda.py --mode benchmark --micro 8 --precision bf16
CUDA_VISIBLE_DEVICES=0 python benchmark_cuda.py --mode benchmark --micro 1 --precision bf16
CUDA_VISIBLE_DEVICES=0 python benchmark_cuda.py --mode profile --micro 8 --precision fp32 --trace trace_mb8.json
CUDA_VISIBLE_DEVICES=0,1 python verify_ddp_cuda.py
"""Controlled synthetic causal-Transformer probe, not a pretrained LLM benchmark."""
import argparse
import contextlib
import gc
import hashlib
import json
import platform
import statistics
import time
from pathlib import Path

import torch
import torch.nn as nn
import torch.nn.functional as F


CONFIG = {"vocab": 8192, "hidden": 1024, "heads": 16, "layers": 8,
"sequence": 512, "effective_batch": 8, "dropout": 0.0}
TOLERANCES = {"fp32": {"max_abs": 1e-4, "relative_l2": 1e-3},
"bf16": {"max_abs": 2e-2, "relative_l2": 5e-2}}


classBlock(nn.Module):
def__init__(self):
super().__init__()
        h = CONFIG["hidden"]
self.n1, self.n2 = nn.LayerNorm(h), nn.LayerNorm(h)
self.qkv, self.proj = nn.Linear(h, 3*h), nn.Linear(h, h)
self.up, self.down = nn.Linear(h, 4*h), nn.Linear(4*h, h)

defforward(self, x):
        b, s, h = x.shape
        qkv = self.qkv(self.n1(x)).reshape(b, s, 3, CONFIG["heads"], h//CONFIG["heads"])
        q, k, v = [qkv[:, :, i].transpose(1, 2) for i inrange(3)]
        a = F.scaled_dot_product_attention(q, k, v, dropout_p=0.0, is_causal=True)
        x = x + self.proj(a.transpose(1, 2).reshape(b, s, h))
return x + self.down(F.gelu(self.up(self.n2(x))))


classModel(nn.Module):
def__init__(self):
super().__init__()
self.embedding = nn.Embedding(CONFIG["vocab"], CONFIG["hidden"])
self.blocks = nn.Sequential(*[Block() for _ inrange(CONFIG["layers"])])
self.norm = nn.LayerNorm(CONFIG["hidden"])
self.head = nn.Linear(CONFIG["hidden"], CONFIG["vocab"], bias=False)

defforward(self, x):
returnself.head(self.norm(self.blocks(self.embedding(x))))


defmodel_and_data(variable_targets=False):
    torch.manual_seed(42)
    model = Model().cuda().train()
    g = torch.Generator().manual_seed(2026)
    ids = torch.randint(CONFIG["vocab"], (CONFIG["effective_batch"], CONFIG["sequence"]+1), generator=g)
    inputs, targets = ids[:, :-1].contiguous(), ids[:, 1:].contiguous()
if variable_targets:
for row inrange(CONFIG["effective_batch"]):
            targets[row, CONFIG["sequence"]-31*row:] = -100
    count = int(targets.ne(-100).sum())
return model, inputs.cuda(), targets.cuda(), count


defautocast(precision):
return torch.autocast("cuda", dtype=torch.bfloat16) if precision == "bf16"else contextlib.nullcontext()


defaccumulate(model, inputs, targets, count, micro, precision, wrong_mean=False):
for start inrange(0, inputs.shape[0], micro):
        x, y = inputs[start:start+micro], targets[start:start+micro]
with autocast(precision):
            logits = model(x)
            total = F.cross_entropy(logits.float().reshape(-1, CONFIG["vocab"]), y.reshape(-1), ignore_index=-100, reduction="sum")
if wrong_mean:
                local_count = int(y.ne(-100).sum())  # Correctness-only negative control.
                loss = total / local_count / (inputs.shape[0]//micro)
else:
                loss = total / count
        loss.backward()


defflat_cpu(values):
return torch.cat([x.detach().float().reshape(-1).cpu() for x in values])


deferror(actual, reference):
    delta = actual-reference
return {"max_abs": delta.abs().max().item(),
"relative_l2": (delta.norm()/reference.norm().clamp_min(1e-30)).item()}


defclear():
    gc.collect()
    torch.cuda.empty_cache()


defcorrectness():
    references, rows = {}, []
for precision in ("fp32", "bf16"):
for micro, wrong in [(8, False), (4, False), (2, False), (1, False), (1, True)]:
            clear()
            model, x, y, count = model_and_data(variable_targets=True)
            optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
            optimizer.zero_grad(set_to_none=True)
            accumulate(model, x, y, count, micro, precision, wrong)
            torch.cuda.synchronize()
            gradients = flat_cpu(p.grad for p in model.parameters())
            optimizer.step()
            weights = flat_cpu(model.parameters())
if micro == 8andnot wrong:
                references[precision] = (gradients.clone(), weights.clone())
            ge = error(gradients, references[precision][0])
            we = error(weights, references[precision][1])
            tolerance = TOLERANCES[precision]
            passed = ge["max_abs"] <= tolerance["max_abs"] and ge["relative_l2"] <= tolerance["relative_l2"]
            row = {"precision": precision, "micro_batch": micro, "accumulation": 8//micro,
"normalization": "micro_mean"if wrong else"global_target_mean",
"effective_targets": count, "gradient_error": ge, "weight_error": we,
"within_declared_tolerance": passed, "negative_control": wrong}
if wrong:
assert ge["relative_l2"] > 1e-3, row
else:
assert passed, row
            rows.append(row)
del model, optimizer, x, y, gradients, weights
    cross_precision = error(references["bf16"][0], references["fp32"][0])
    clear()
return {"tolerances_declared_before_run": TOLERANCES, "cases": rows,
"bf16_full_batch_vs_fp32_gradient": cross_precision}


defbenchmark_case(micro, precision, iterations, repeats):
    clear()
    model, x, y, count = model_and_data()
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4, foreach=False, fused=False)
defupdate():
        optimizer.zero_grad(set_to_none=True)
        accumulate(model, x, y, count, micro, precision)
        optimizer.step()
for _ inrange(3):
        update()
    torch.cuda.synchronize()
    torch.cuda.reset_peak_memory_stats()
    base = torch.cuda.memory_allocated()
    samples = []
for repeat inrange(repeats):
        begin, end = torch.cuda.Event(enable_timing=True), torch.cuda.Event(enable_timing=True)
        torch.cuda.synchronize()
        started = time.perf_counter()
        begin.record()
for _ inrange(iterations):
            update()
        end.record()
        torch.cuda.synchronize()
        wall = time.perf_counter()-started
        samples.append({"repeat": repeat, "wall_ms_per_update": wall*1000/iterations,
"cuda_event_ms_per_update": begin.elapsed_time(end)/iterations,
"effective_tokens_per_second": count*iterations/wall})
    state_bytes = sum(v.numel()*v.element_size() for state in optimizer.state.values() for v in state.values() if torch.is_tensor(v) and v.is_cuda)
    row = {"precision": precision, "micro_batch": micro, "accumulation": 8//micro,
"effective_targets_per_update": count, "warmup_updates": 3,
"iterations_per_repeat": iterations, "repeats": repeats, "samples": samples,
"wall_ms_per_update_median": statistics.median(s["wall_ms_per_update"] for s in samples),
"effective_tokens_per_second_median": statistics.median(s["effective_tokens_per_second"] for s in samples),
"baseline_allocated_bytes": base, "peak_allocated_bytes": torch.cuda.max_memory_allocated(),
"peak_reserved_bytes": torch.cuda.max_memory_reserved(), "optimizer_cuda_state_bytes": state_bytes,
"parameter_dtype": str(next(model.parameters()).dtype), "gradient_dtype": str(next(model.parameters()).grad.dtype)}
del model, optimizer, x, y
    clear()
return row


defprofile_case(micro, precision, output):
    clear()
    model, x, y, count = model_and_data()
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4, foreach=False, fused=False)
for _ inrange(2):
        optimizer.zero_grad(set_to_none=True)
        accumulate(model, x, y, count, micro, precision)
        optimizer.step()
    torch.cuda.synchronize()
with torch.profiler.profile(activities=[torch.profiler.ProfilerActivity.CPU, torch.profiler.ProfilerActivity.CUDA], record_shapes=True) as p:
        optimizer.zero_grad(set_to_none=True)
        accumulate(model, x, y, count, micro, precision)
        optimizer.step()
        torch.cuda.synchronize()
    p.export_chrome_trace(str(output))
return {"micro_batch": micro, "precision": precision, "trace": str(output), "table": p.key_averages().table(sort_by="self_cuda_time_total", row_limit=12)}
defmain():
    parser = argparse.ArgumentParser()
    parser.add_argument("--mode", choices=["correctness", "benchmark", "profile"], required=True)
    parser.add_argument("--micro", type=int, default=8)
    parser.add_argument("--precision", choices=["fp32", "bf16"], default="fp32")
    parser.add_argument("--iterations", type=int, default=5)
    parser.add_argument("--repeats", type=int, default=3)
    parser.add_argument("--trace", default="trace.json")
    args = parser.parse_args()
assert args.micro in [1, 2, 4, 8]
assert torch.cuda.is_available()
    torch.set_num_threads(4)
    torch.cuda.set_device(0)
    torch.backends.cuda.matmul.allow_tf32 = False
    torch.backends.cudnn.allow_tf32 = False
    torch.set_float32_matmul_precision("highest")
    metadata = {"torch": torch.__version__, "torch_git": torch.version.git_version,
"python": platform.python_version(), "cuda_runtime": torch.version.cuda,
"gpu": torch.cuda.get_device_name(), "compute_capability": torch.cuda.get_device_capability(),
"model_config": CONFIG, "tf32": False, "compile": False, "sdpa_dispatch": "automatic",
"parameter_count": sum(p.numel() for p in Model().parameters()),
"script_sha256": hashlib.sha256(Path(__file__).read_bytes()).hexdigest(),
"timing_scope": "Resident synthetic GPU inputs; complete forward/backward/optimizer loop. Excludes data loading, H2D, init and compilation."}
if args.mode == "correctness":
        result = correctness()
elif args.mode == "benchmark":
        result = benchmark_case(args.micro, args.precision, args.iterations, args.repeats)
else:
        result = profile_case(args.micro, args.precision, Path(args.trace))
print(json.dumps({"environment": metadata, "mode": args.mode, "result": result}, indent=2))


if __name__ == "__main__":
    main()
"""Two-GPU NCCL semantic probe, not a GPU throughput benchmark.

Run: python verify_ddp_cuda.py
One global batch: 20 independent classification targets, split across 2 ranks
and 2 unequal micro-batches per rank. Float64, deterministic linear model.
"""

import contextlib
import hashlib
import json
import platform
import tempfile
from datetime import timedelta
from pathlib import Path

import torch
import torch.distributed as dist
import torch.multiprocessing as mp
import torch.nn.functional as F
from torch.distributed.algorithms.ddp_comm_hooks import default_hooks
from torch.nn.parallel import DistributedDataParallel as DDP


CASES = (
    ("token_native_final", "token", "full_context", False),
    ("token_sync_each", "token", "none", True),
    ("token_sync_final", "token", "full_context", True),
    ("token_backward_only", "token", "backward_only", True),
    ("micro_mean_sync_final", "micro_mean", "full_context", True),
)


defmake_model():
    torch.manual_seed(42)
return torch.nn.Linear(4, 3, bias=True, dtype=torch.float64)


defdata():
    generator = torch.Generator().manual_seed(2026)
    x = torch.randn(20, 4, generator=generator, dtype=torch.float64)
    y = torch.randint(0, 3, (20,), generator=generator)
return x, y


defflatten(values):
return torch.cat([value.detach().reshape(-1) for value in values])


defcount_allreduce(state, bucket):
    state["calls"] += 1
# Delegate averaging to the official hook rather than changing semantics.
return default_hooks.allreduce_hook(state["group"], bucket)


defworker(rank, world, init_method, queue):
    torch.set_num_threads(2)
    torch.cuda.set_device(rank)
    dist.init_process_group(
"nccl", rank=rank, world_size=world,
        init_method=init_method, timeout=timedelta(seconds=60),
    )
try:
        x, y = data()
        device = torch.device("cuda", rank)
        x, y = x.to(device), y.to(device)
        reference = make_model().to(device)
        reference_optimizer = torch.optim.SGD(reference.parameters(), lr=0.1)
        reference_loss = F.cross_entropy(reference(x), y, reduction="sum") / 20
        reference_loss.backward()
        reference_gradient = flatten(p.grad for p in reference.parameters())
        reference_optimizer.step()
        reference_weights = flatten(reference.parameters())

# Rank 0 has 2 + 6 targets, rank 1 has 4 + 8 targets.
        spans = ((slice(0, 2), slice(2, 8)),
                 (slice(8, 12), slice(12, 20)))[rank]
        local_count = sum(x[span].shape[0] for span in spans)
        total_count = torch.tensor(local_count, dtype=torch.int64, device=device)
        dist.all_reduce(total_count, op=dist.ReduceOp.SUM)
        total = total_count.item()
assert total == 20
        rows = []
for name, normalization, sync, instrument in CASES:
            model = DDP(make_model().to(device), device_ids=[rank])
            optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
            state = {"calls": 0, "group": dist.group.WORLD}
if instrument:
                model.register_comm_hook(state, count_allreduce)
            optimizer.zero_grad(set_to_none=True)
for index, span inenumerate(spans):
                suppress = index == 0
                outer = (model.no_sync() if suppress and sync == "full_context"
else contextlib.nullcontext())
with outer:
                    output = model(x[span])
                    loss_sum = F.cross_entropy(output, y[span], reduction="sum")
if normalization == "token":
                        loss = loss_sum * world / total
else:
                        loss = loss_sum / y[span].numel() / len(spans)
                    backward_context = (
                        model.no_sync() if suppress and sync == "backward_only"
else contextlib.nullcontext()
                    )
with backward_context:
                        loss.backward()
            gradient = flatten(p.grad for p in model.module.parameters())
            optimizer.step()
            weights = flatten(model.module.parameters())
            row = {
"case": name,
"rank": rank,
"gradient_bucket_hook_calls": state["calls"] if instrument elseNone,
"gradient_max_abs_error": (gradient-reference_gradient).abs().max().item(),
"weight_max_abs_error": (weights-reference_weights).abs().max().item(),
            }
if normalization == "token":
assert row["gradient_max_abs_error"] < 1e-12, row
assert row["weight_max_abs_error"] < 1e-12, row
else:
assert row["gradient_max_abs_error"] > 1e-4, row
if instrument:
                expected_calls = 1if sync == "full_context"else2
assert row["gradient_bucket_hook_calls"] == expected_calls, row
            gathered = [None] * world
            dist.all_gather_object(gathered, row)
if rank == 0:
                rows.append({"case": name, "ranks": gathered})
del model
if rank == 0:
            queue.put({"reference_loss": reference_loss.item(), "cases": rows})
finally:
        dist.destroy_process_group()


defmain():
ifnot dist.is_nccl_available() or torch.cuda.device_count() < 2:
raise RuntimeError("This probe requires NCCL and two CUDA GPUs")
    context = mp.get_context("spawn")
    queue = context.SimpleQueue()
with tempfile.TemporaryDirectory(prefix="gradient-semantics-") as temp:
        rendezvous = (Path(temp) / "rendezvous").as_uri()
        mp.spawn(worker, args=(2, rendezvous, queue), nprocs=2, join=True)
        result = queue.get()
    report = {
"environment": {
"torch": torch.__version__, "torch_git": torch.version.git_version,
"python": platform.python_version(), "platform": platform.platform(),
"backend": "nccl", "device": "cuda", "dtype": "float64",
"cuda_runtime": torch.version.cuda,
"gpu_names": [torch.cuda.get_device_name(i) for i inrange(2)],
"nccl_version": torch.cuda.nccl.version(),
"world_size": 2, "micro_batches_per_rank": 2,
"target_counts": [[2, 6], [4, 8]],
"cuda_available": torch.cuda.is_available(),
"script_sha256": hashlib.sha256(Path(__file__).read_bytes()).hexdigest(),
        },
"scope": "Two-GPU NCCL one-update gradient/weight semantics and bucket hook counts only; no throughput or memory benchmark",
        **result,
    }
print(json.dumps(report, indent=2))


if __name__ == "__main__":
    main()
资料来源
[1] PyTorch DDP:默认梯度平均[1]。
[2] Transformers:梯度累积与预测目标计数[2]。
[3] PyTorch:Autograd mechanics[3]。
[4] PyTorch:Autocast[4]。
[5] PyTorch:FSDP1 no_sync 的梯度驻留[5]。
[6] NVIDIA:矩阵乘法与算术强度[6]。
[7] PyTorch 2.14.1 对应 Python DDP 源码[7]。
[8] PyTorch 2.14.1 对应 C++ Reducer 源码[8]。
[9] PyTorch 官方默认 all-reduce hook[9]。
[10] Accelerate:变长目标的梯度累积与框架缩放[10]。
[11] PyTorch:AMP 的累积、unscale 与更新[11]。
[12] PyTorch:BatchNorm2d[12]。
[13] PyTorch:CUDA 异步执行与计时[13]。
参考链接
- PyTorch DDP:默认梯度平均: https://docs.pytorch.org/docs/2.14/generated/torch.nn.parallel.DistributedDataParallel.html
- Transformers:梯度累积与预测目标计数: https://huggingface.co/docs/transformers/grad_accumulation
- PyTorch:Autograd mechanics: https://docs.pytorch.org/docs/2.14/notes/autograd.html
- PyTorch:Autocast: https://docs.pytorch.org/docs/2.14/amp.html
- PyTorch:FSDP1 no_sync 的梯度驻留: https://docs.pytorch.org/docs/2.14/fsdp.html#torch.distributed.fsdp.FullyShardedDataParallel.no_sync
- NVIDIA:矩阵乘法与算术强度: https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html
- PyTorch 2.14.1 对应 Python DDP 源码: https://github.com/pytorch/pytorch/blob/5c4886908584029761b579af026dcfb627c84070/torch/nn/parallel/distributed.py
- PyTorch 2.14.1 对应 C++ Reducer 源码: https://github.com/pytorch/pytorch/blob/5c4886908584029761b579af026dcfb627c84070/torch/csrc/distributed/c10d/reducer.cpp
- PyTorch 官方默认 all-reduce hook: https://github.com/pytorch/pytorch/blob/5c4886908584029761b579af026dcfb627c84070/torch/distributed/algorithms/ddp_comm_hooks/default_hooks.py
- Accelerate:变长目标的梯度累积与框架缩放: https://huggingface.co/docs/accelerate/usage_guides/gradient_accumulation
- PyTorch:AMP 的累积、unscale 与更新: https://docs.pytorch.org/docs/2.14/notes/amp_examples.html
- PyTorch:BatchNorm2d: https://docs.pytorch.org/docs/2.14/generated/torch.nn.BatchNorm2d.html
- PyTorch:CUDA 异步执行与计时: https://docs.pytorch.org/docs/2.14/notes/cuda.html