ARTICLE · 1301451
100 个客户用 AI 自建应用,95 个死在这七道关
深度调查 · 企业 AI 落地
100 个客户用 AI 自建应用,95 个死在这七道关
追踪 300+ 个项目之后,我们画出了这条死亡路径
约 2900 字 · 阅读 8 分钟
过去一年,几乎所有企业都在试同一件事:让业务人员用 AI,把自己想要的系统“说”出来。
演示视频里,一句话生成一套审批流,两分钟上线一个客户管理后台。真实的项目里,这句话后面还跟着 94 天。
我们梳理了 IDC、Gartner、中国信通院、MIT、Veracode 等机构 2025—2026 年的 20 余份调研,又对照了 300 多个 AI 自建应用项目的落地轨迹。数字不太好看,但很有用。
01 真相
先记住一句话
AI 能在三天里做出你想要的样子,却做不出你敢上线的东西。
纯 AI 一键生成的企业级应用,落地失败率 71%。十个项目里,七个撑不过验收。约 60% 的 AI 生成原型从未进入生产环境,全部卡在“最后 20%”。
更刺眼的是归因:失败主因里约 80% 不是技术问题——组织治理缺位、需求定义模糊、数据准备不足。模型很少是那个拖后腿的。
02 路径
七道鬼门关,每一关都在筛人
把一个 AI 自建应用的生命周期拆成七段,看每一段还剩多少人活着。这张表几乎能解释所有“做到一半没了”的项目。
注:存活率为基于国内外调研口径的估算值,不同行业差异较大,用于看趋势而非精确预测。
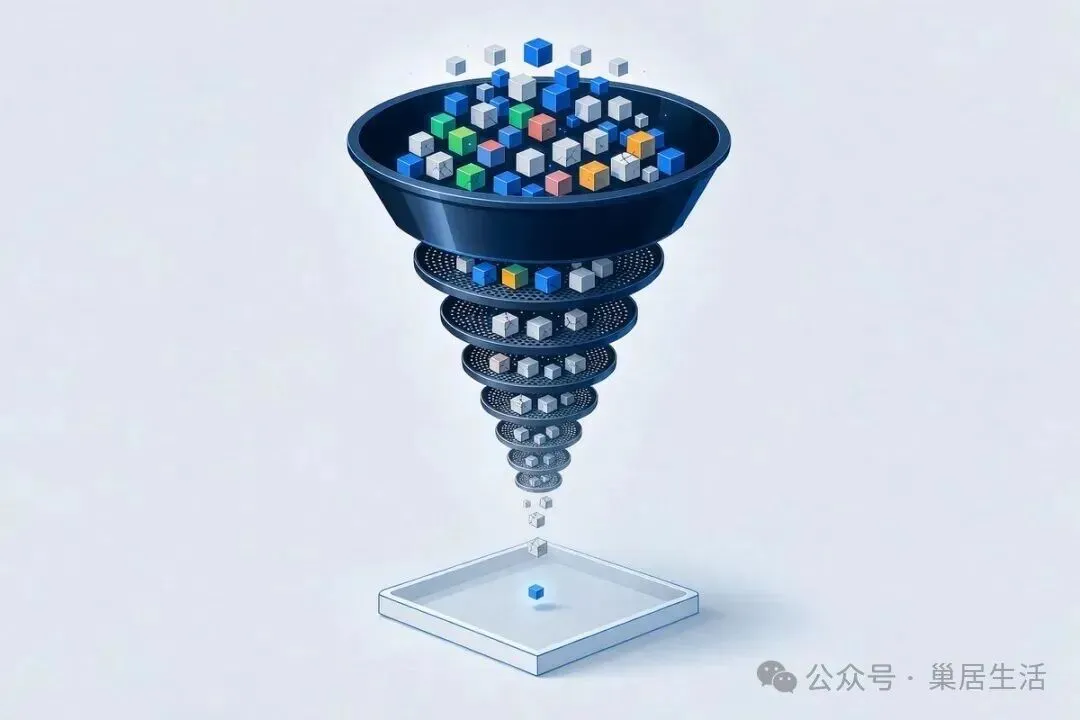
七层筛网:每一关都留下一批项目,走到最后的不到 5%
第一关就足够残酷。RAND 2024 年的研究把 AI 项目失败的五大根源全部归到组织层面,没有一条是模型能力。麦肯锡的对照结论类似:AI 高绩效企业里,有明确执行发起人的比例是普通企业的 3 倍。
IBM Watson for Oncology 是这一关的标准案例。40 到 50 亿美元投入,因为没有先锁定具体临床用例,系统给出的治疗建议多次出现不安全错误,MD 安德森终止合作,Watson Health 最终被以约 10 亿美元低价出售。
03 死因
死得最狠的三关:数据、集成、安全
关卡 03
数据准备|“我们有几年的数据”
这句话通常会变成三周的数据清洗。格式不一致、标注标准不统一,两个标注员按同一份指南标注,边界案例的分歧率能到 30%。
提醒:Gartner 预计到 2026 年,60% 的 AI 项目会因数据不够 AI-ready 被放弃。中国企业还多一层——只有 15% 建立了统一且真正能用的数据分类标准。
关卡 04
系统集成|打通比搭建还贵
平均 57% 的工作量花在系统集成和数据打通上,而不是搭应用本身。ERP、CRM、OA 的接口权限、数据格式、权限映射层层受阻。抽样 32 个项目,集成成本普遍超过开发成本。
提醒:真正能独立完成跨部门流程应用的业务人员只有约 14%,且集中在运营、HR、财务这些流程标准化程度高的岗位。
关卡 05
安全合规|上线即事故
Veracode 2026 报告:AI 生成代码平均安全通过率 56%。SQL 注入能到 83%,跨站脚本只有 15%,日志注入只有 12%。45% 的样本含 OWASP Top 10 级别的漏洞。
提醒:Gartner 预测,公民开发者构建的应用不经治理直接上线,到 2028 年软件缺陷将增长 2500%。
典型案例
Moltbook 的事故足够说明问题。创始人全程用 AI 生成代码,没写一行。上线 3 天,一个配置错误的 Supabase 数据库把 150 万个 API 认证令牌、3.5 万个邮箱地址和大量私密消息全部暴露在公网。
“Demo 里没有审计日志这一栏,但生产环境里,它决定项目能不能过评审。”
—— 一位金融行业架构师
04 边界
最后 20%,才是真正的工程
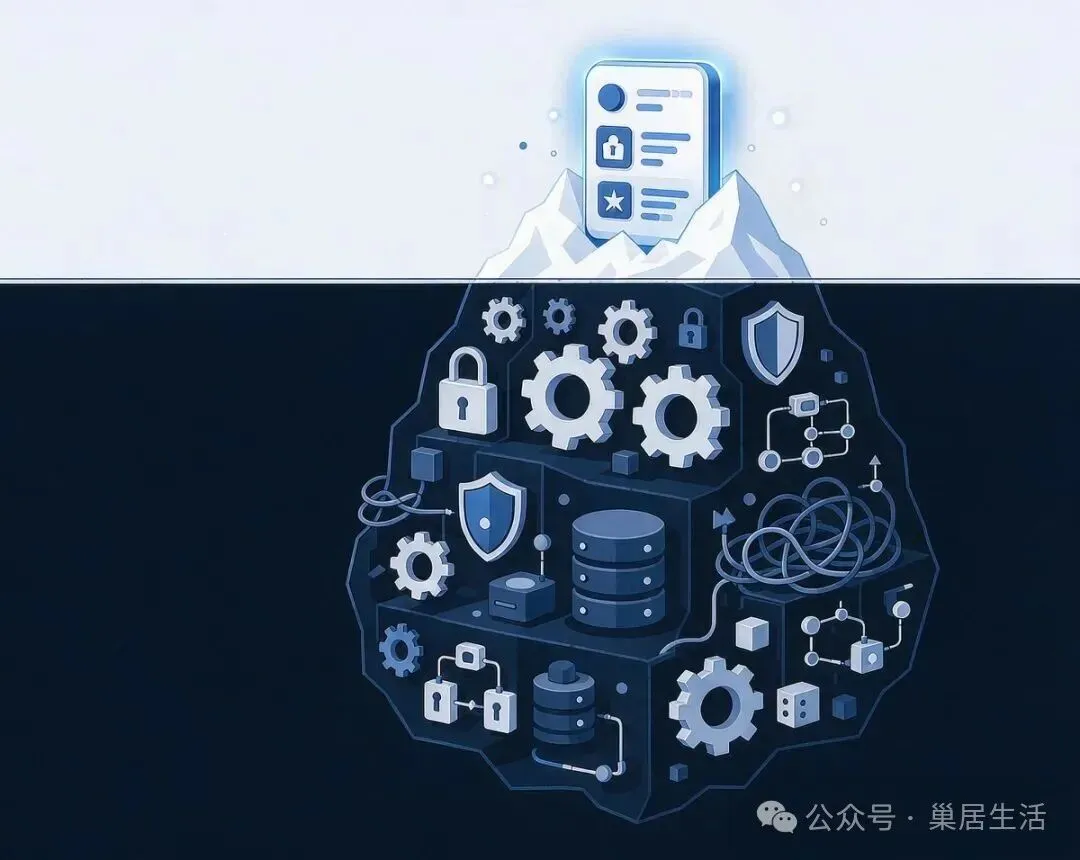
水面上是你看到的界面,水面下是认证、权限、集成、审计与容灾
业内把这叫“80% 问题”。AI 能在几天内完成 60%–70%:界面、基础流程、增删改查。剩下的 30%–40% 是工程硬骨头,而且无法事后补缀。
01 界面、CRUD、简单流程:AI 生成正确率超过 90%,效率提升是真实的。
02 权限模型、审批链、并发事务:经常出错,因为它需要深度上下文理解。
03 安全架构、容灾、合规审计:基本无法独立完成,需要专业工程判断。
POC 平均 11 个工作日,从 POC 通过到生产上线中位 94 个自然日,差 8.5 倍。这 8.5 倍不是开发慢,是单点登录、数据权限、并发压测、灾备方案、运维监控——demo 里全都没有。
05 差异
同一条曲线,两边形状不一样
国内更多死在集成与合规,海外更多死在安全与规模化。同样是 71%,病灶并不在一处。
海外的另一面是 vibe coding。约 1 万家初创公司尝试用 AI 助手构建生产应用,超过 8000 家现在需要重建或救援工程。Apple App Store 已经开始以“未审核的 AI 生成模块”为由封禁这类应用。
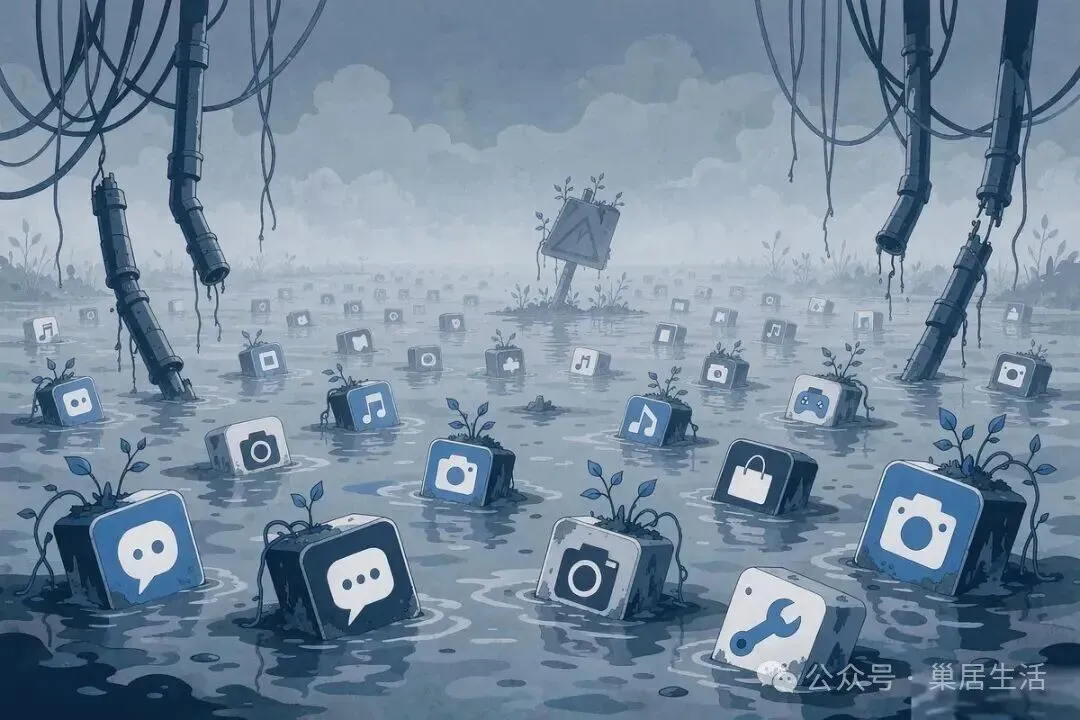
应用沼泽:应用越堆越多,退役的没人清理,权限混乱,数据重复定义
06 清单
避坑:把 95% 的失败率压下来
选型三原则
01 真实场景 POC:至少在 3 个真实业务场景验证功能覆盖、性能与扩容成本,别用厂商的演示数据。
02 分清 AI 的层级:外挂式 Copilot 只提效,AI 原生架构才可能质变。区别在于 AI 是否理解业务模型、角色权限、审批与审计。
03 集成按 50% 预估:不要按“开箱即用”做预算,集成成本按一半工作量留口子。
建设四步
01 需求澄清:角色、流程、规则、权限边界、成功指标写进文档,业务方签字。
02 数据先行:先做盘点、清洗、标准化,可用数据集覆盖率过 80% 再谈 AI。
03 小步快跑:先做最小可用版本,核心流程跑通、日活过阈值再扩。
04 安全左移:开发阶段就嵌安全扫描与权限审计,按 OWASP Top 10 与等保预案验收。
治理还有三件事:应用目录与退役机制(没有退役机制,就一定会长出应用沼泽)、公民开发者培训 + 工具 + 审核(不是放任,也不是一刀切禁止)、成本与 ROI 追踪(定期清理没有价值产出的应用)。
07 结语
失败率会降,但不会归零
预计到 2027 年,纯 AI 生成项目的失败率会从 71% 降到 55% 左右——仍是高位。纯 AI 生成替代不了工程底座,“AI 原生低代码”会成为企业级应用的标准构建方式;治理工具会变成一个独立市场。
而业务与 IT 的关系不会消失,只会从“业务提需求、IT 开发”变成“业务搭原型、IT 做硬化”。
最后三句
01 失败率高,不是因为 AI 不行,而是因为能被 AI 替代的,只有那 70%。
02 越是想跳过工程化,越会在最后 20% 付更高的代价。
03 选型先看 AI 有没有扎进业务模型,再看它能不能生成界面。
如果团队正在评估 AI 建应用,把这篇转给负责选型的人,也许能省掉一次 POC 的钱。
下一篇:拆解“AI 原生低代码”到底原生在哪,以及怎么用一次 POC 把它验出来。
数据引自公开研究报告与行业调研,口径以原报告为准;案例仅用于说明风险类型,不构成对任何厂商或产品的评价。