ARTICLE · 1307632
GPT出题,物理AI接招:LiberAI发布Liber-0,长程Zero-shot涌现于220万小时人类数据 | CMC Portfolios


如果让 GPT 给机器人出一套题,会发生什么?
题目可以越出越难。但有个条件:不能针对这些题,提前给机器人补课。
LiberAI 把这个设想搬进了现实——
此次发布的世界动作模型 Liber-0,接受了一套由 GPT-6 提出的 60 个任务测试。每个任务试验 10 次,共计 600 次。没有针对目标任务采集的机器人示范训练,模型直接上手。
结果,Liber-0 的Zero-shot能力一路从抓取放置,延伸到了更复杂的多步骤灵巧操作。
这背后,是超过 220 万小时的人类经验——把人每天都在体验的灵巧操作经验,变成机器人可以调用的泛化能力。
而在发布的另一段完整视频中,Liber-0 又接下了一份更难的工作:做奶茶。
机器人开始能够根据不同口味订单,自主组合操作技能,完成长程奶茶制作,一镜到底。
从接住完全没练过的题,到接下一杯奶茶订单,Liber-0 的Scaling路径,正在展现从通用能力走向真实泛化应用的强大潜力。
01
Zero-shot的题,这次让 GPT 来出
机器人演示视频,我们已经看过不少。
让人好奇的往往是视频背后的事:它为这个任务练了多久?换一种物体还能不能做?那个看起来很流畅的长流程,究竟有多少能力可以带到全新新任务上?
LiberAI 团队请 GPT-6 提出 60 个任务,组成一套零样本测试。任务分成三组,每组 20 个,难度逐级上升。
第一组是抓取放置,也就是 Pick-and-Place,简称 PnP,考察基本的识别与操作能力。
第二组是 Non-PnP,要求机器人完成超出简单抓取的操作,处理更具体的接触关系和物体状态变化。
第三组,则是最具有挑战性的多步骤、长程 Non-PnP 任务。到这里,机器人需要连续协调多个灵巧动作,把任务推进到最终结果。
“零样本”的设定也很明确:模型没有接受针对这些目标任务采集的机器人数据。
Liber-0 在三组任务上的成功率分别为 63.5%、34.0% 和 10.5%,总体成功率达 36.0%。其中最具突破性的是多步骤长程任务:在没有目标任务机器人示范的情况下,Liber-0 已经能够零样本完成做饭、打包食品袋等一系列连续的灵巧操作。
长程任务的挑战远不止多个动作的简单叠加。机器人需要理解动作之间的依赖关系,在不断变化的物理环境中调整抓握、接触与操作策略,并克服误差累积,最终完成整个任务。
10.5% 的成功率虽然仍处于早期阶段,却标志着一项重要的里程碑:零样本泛化开始从单一动作延伸至复杂的长程灵巧操作,并展现出完成真实场景随机复杂任务的能力。随着 LiberAI 人类经验数据与模型规模持续 Scaling,Zero-shot 能力有望进一步扩展至更复杂、更多样的各类任务。
在同一套 60 个任务中,LiberAI 还测试了 Astra 直接作为机器人策略的表现,三组任务成功率仅为 8.3%、5.0% 和 1.7%。实验显示,通用推理模型在精细物理操作上仍面临显著挑战,也凸显了物理模型的价值。
Liber-0 已支持接入 Astra 等上层 Agent,由 Agent 跟踪任务状态、动态调整中间目标,再由 Liber-0 将规划转化为实际的灵巧操作。 Liber-0 在长程任务上的 Zero-shot 突破,也让这一组合展现出更大的想象空间:上层 Agent 负责理解和规划未知任务,Liber-0 则提供可泛化的物理执行能力。随着人类经验数据与模型能力持续 Scaling,机器人有望将越来越多从未训练过的复杂任务,自主拆解并转化为真实行动。从单一技能的零样本泛化,到复杂长程任务的自主规划与零样本执行,通向真正通用机器人智能的曙光已经初现。
看完演示,你也可以给它出一道题。
有意思的是,LiberAI 还把物体级零样本测试做成了一个交互式在线模拟器(sim.liberai.work)。用户可以自行上传物体,在虚拟环境中查看 Liber-0 对其进行操作。它考察的是物体级零样本迁移,与前面的 60 项任务级零样本测试形成互补。
这让模型发布多了一个很有意思的环节:测试对象可以由屏幕前的你来提供。
任何一个人都可以拿自己的物体观察模型能否应对:哪些形状容易操作,哪些物体会让它犯难,已有经验又能迁移多远。
220 万小时人类经验究竟学出了什么?现在,你可以带一道自己的题,去看看它的表现。
02
220万小时人类经验的背后,
是何 Scaling 链路?
220 万小时,是一道数据规模与工程能力的双重门槛。 Liber-0 的人类经验中,人类视频达到 200 万小时,将此前 DYNA-2 展示的百万小时量级进一步推高。支撑这一规模的,是 LiberAI 完整的自动化数据管线与数据 Infra。
把海量人类视频交给模型学习,听起来很自然。如此丰富的经验,为什么不能直接拿来训练?
难点藏在“直接”里。视频里能看到一只手转动了物体,却未必看得清每根手指的位置。遮挡、视角、深度误差,都会让动作还原变得困难。
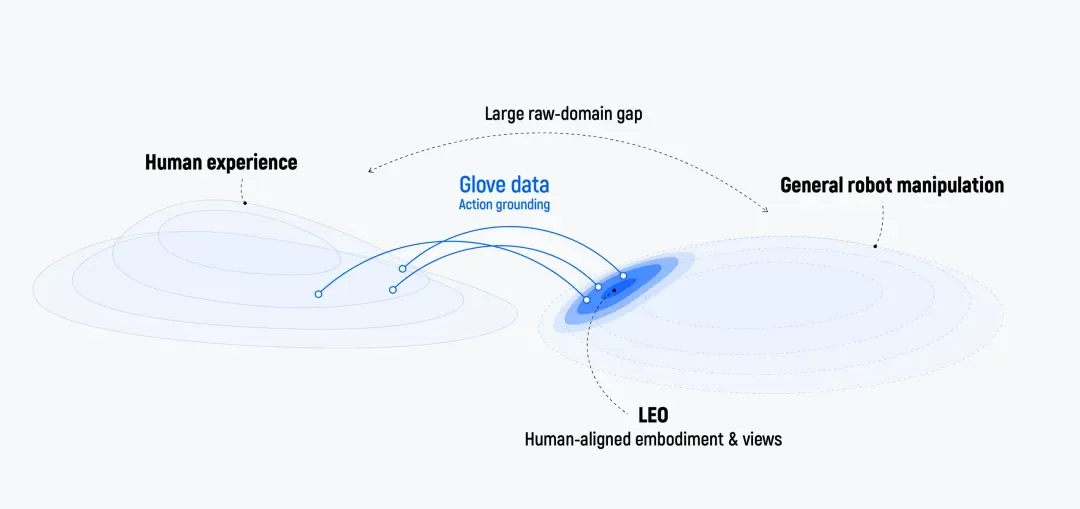
LiberAI 的思路,是沿着人类经验迁移的路径突破缺口。数据 Recipe 中,一个关键角色是自研的 LiberSense Glove:它以精确的 action grounding,为海量人类视频补上从“看见操作”到“学会行动”的连接。
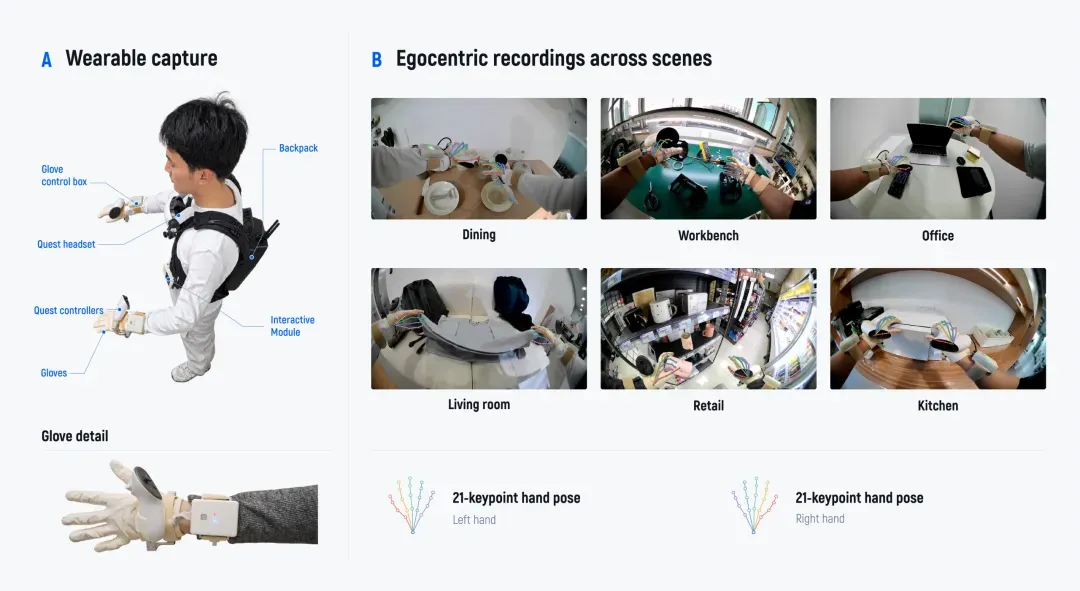
LiberSense Glove 是一套轻量化可穿戴采集系统,通过直接记录手部姿态与运动轨迹,配合第一视角和双腕部摄像头,同步捕捉“人看到了什么”与“手如何行动”。
它的价值,在于为海量人类视频补上通往动作的关键连接。互联网里蕴藏着丰富的操作经验,却普遍缺少精确的动作监督。手套记录提供了一批可靠的 Action 锚点,帮助模型把画面中的物体变化与具体的手部运动联系起来,进而撬动更大规模视频中的经验。高质量动作数据由此成为一种“催化剂”,让海量人类视频的价值进一步释放到机器人操作上。
这对攀登灵巧操作这座“珠峰”尤其关键。多指协同、精细接触、连续调整,都对动作监督提出了更高要求,而灵巧手遥操作数据又难以规模化获取。LiberSense Glove 为此打开了一个更广阔的入口:直接向每天都在熟练使用双手的人学习,让丰富的人类操作经验成为灵巧能力持续增长的来源。
目前,这套设备已批量进入 in-the-wild 的真实工作与生活场景。采集现场无需配置机器人,人佩戴设备完成操作,即可留下可供模型学习的经验。人类双手每天完成的工作,正成为机器人攀登灵巧操作“珠峰”的阶梯。
数据之外:本体差异,能否成为下一个 Scaling 维度?
从遥操作到 UMI,一种常见思路是让采集端尽可能接近部署端:面对本体差异,大家首先想到的是如何缩小它。
LiberAI 则进一步追问:如果把“身体有什么不同”直接告诉模型,差异本身能否成为模型能力增长的来源?
为此,Liber-0 创新性引入统一 Embodiment 表征,将人的身高、臂长、手部几何,以及机器人的几何与运动学条件,纳入动作预测的上下文。
模型既学习“要完成什么”,也学习“不同的身体应当如何完成它”,从多种身体执行同一技能的经验中,建立身体条件与动作之间的联系。
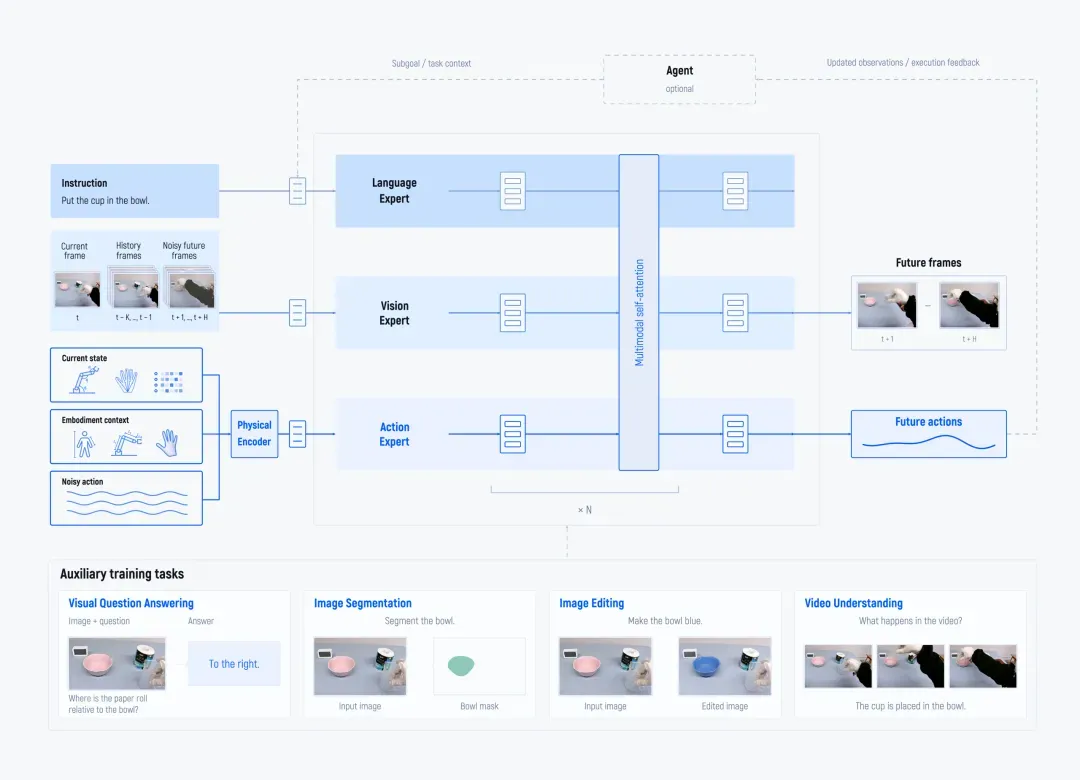
这让 Embodiment 有机会成为全新的 Scaling Axis:除了增加数据量,还可以扩大身体形态的覆盖,让更多人的操作经验参与模型能力的增长。LiberAI 的实验也提供了支持——在手套数据总量不变的条件下,增加示范者的形态覆盖,机器人操作表现仍持续提升。
本体差异由此成为一种值得主动扩展的训练资源,也为技能跨越不同身体、迁移到机器人身上,打开了新的可能。
全栈的价值,不仅在于打通各个环节,更在于让每个环节的进步相互放大。 更精准的动作释放海量人类视频的训练价值,更丰富的身体形态拓展模型的泛化边界,而模型能力的提升又能反过来指导数据采集与本体设计。通过数据、模型与本体的协同 Scaling,LiberAI 正在将人类经验的规模优势,持续转化为物理智能的增长引擎。
03
智能的涌现:
人类动作示教,可“杀死真机”?
Scaling 的关键,在于让每一份数据、每一分算力都带来更高的能力回报。哪些数据最值得投入、最能推动模型智能增长?LiberAI 用对照实验,为这笔 Scaling 的“投入产出账”寻找答案。
LiberAI 对自研手套数据、互联网人类视频、开源第一视角数据等来源做了对照实验。模型分别预训练后,再使用相同的机器人数据进行后训练。
这些实验用 0—100 的平均进度分记录表现:任务完整完成可以得分,完成了部分关键步骤也会被计入。
在所比较的数据源中,手套数据表现出最陡峭的性能增长趋势。当规模从 1,000 小时扩展到 10,000 小时,PnP 和 Non-PnP 的平均进度分分别增加 14.7 分和 13.1 分。
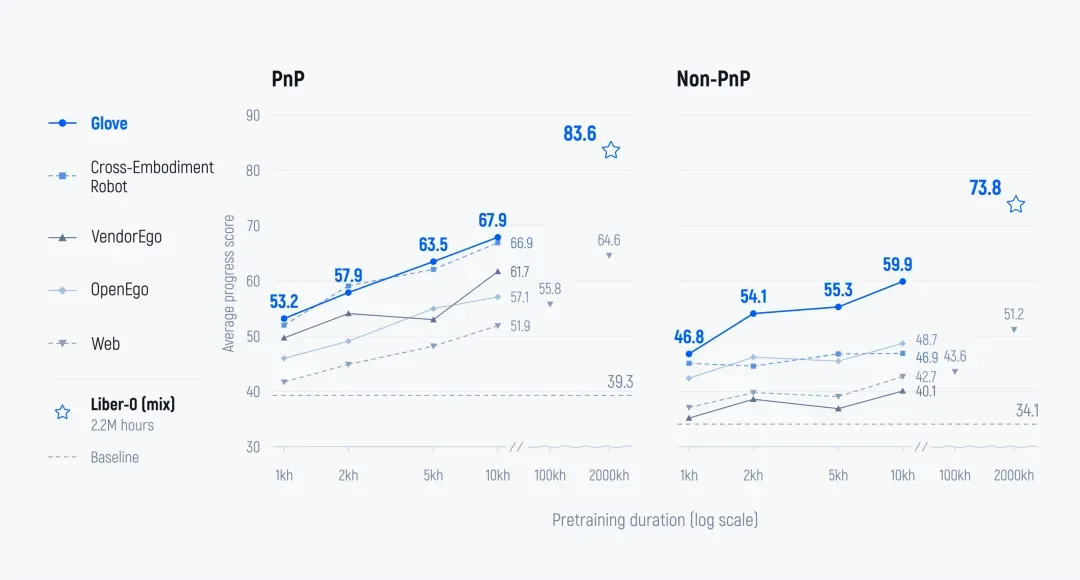
对需要精细接触和持续操作的 Non-PnP 任务来说,这个结果尤其关键——准确的动作监督开始体现出价值。
但接下来这组实验,更能说明问题。
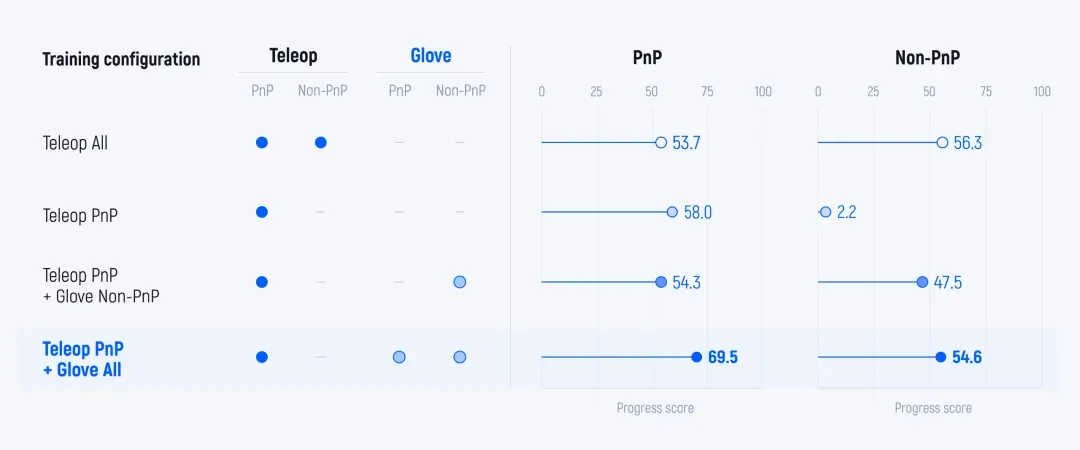
团队先只给模型提供PnP(抓取放置类)的机器人示范。此时,模型在 Non-PnP 上的平均进度分只有 2.2。
随后,加入人类通过手套采集的 Non-PnP 操作数据。对应的机器人示范仍然没有补充,分数却升到了 47.5。
再加入同时覆盖 PnP 和 Non-PnP 的完整手套数据,分数进一步达到 54.6,已经接近使用完整两类机器人示范训练的参考结果 56.3。
这组实验最有分量的地方,在于技能从哪里来。
机器人示范没有提供相应的 Non-PnP 行为,模型却通过人的操作获得了这类能力——手套数据带来机器人示范未覆盖的操作技能,人类物理数据开始承担“教会新技能”的角色。
如果这种迁移方式继续扩展,技能采集的空间就会变大:许多机器人还不熟悉、但人已经很擅长的操作,有机会通过人类示范进入模型能力。采集新经验时,人类可以更直接地参与进来,技能增长对真机遥操作资源的依赖也会随之降低。
这些证据从不同角度,指向人类经验作为可扩展技能来源的价值。手套把人类示教变成低成本、轻量化的技能入口。 随着采集深入真实工作场景,人类日常操作就能成为模型学习的素材,为 LiberAI 打通“人类经验示教—模型训练—部署验证”的快速路径,让人类经验的规模优势转化为商业化落地的速度优势。
04
下一站,不止一杯奶茶
零样本能力让人看到通用性的潜力。到了具体应用场景里,问题就更具体了:能不能把一整套复杂流程做完?调整新的需求,能不能灵动调整完成?
LiberAI 给出的展示,是做奶茶。
经过少量后训练,Liber-0 可以执行长程奶茶制作任务,并支持不同口味订单下的技能组合。
值得关注的,是两个层面。
首先,是连续复杂灵巧任务执行。
制作流程涉及多个复杂不规则物体和多段操作,从拿取杯子、接冰块,到操作勺子精细添加小料、挤出糖浆、添加茶底等,只有各个环节衔接起来,最后才是一杯做完的奶茶。
其次,是订单变化。
一杯奶茶看起来只是一个任务,但口味不同,配料组合和相应流程也会变化。模型需要根据新的订单要求,调用和组合已经学会的操作技能。
这正是组合泛化的看点:同一套技能,能随需求变化,组织成不同的完整任务。
对应用部署而言,这种能力很实际。用户不会永远下同一张订单,场景也不会总按同一种方式重复。能够从已有技能出发适应组合变化,意味着模型有机会覆盖更丰富的需求,减少逐项开发与适配。
做奶茶还远不是商业部署的终点,但它已经把通用能力与具体应用之间的关系,摆到了一个直观的位置:预训练 Scaling 积累泛化经验,少量后训练接入流程,组合泛化扩展需求覆盖。
从 GPT 出题,到机器人接单,Liber-0 展示的能力正在沿着这条路径向前延伸。
05
结语
回看 Liber-0 的发布,真正值得关注的,不只是一次模型性能的突破,而是 LiberAI 正在验证一条通向通用物理智能的 Scaling 路径:让海量人类经验成为物理AI能力来源,让机器人逐步摆脱对特定任务示范的依赖,自主应对越来越多未知的物理世界任务。
从 GPT 随机出题下的长程 Zero-shot 突破,到与 Astra 等 Agent 结合实现自主规划与灵巧执行,再到完成不同订单的奶茶制作,Liber-0 正在让通用泛化能力一步步走向真实应用。从单一技能的零样本泛化,到复杂长程任务的自主组合与执行,机器人面对未知任务也能灵活应对的未来,已经初现曙光。
每一段人类经验,都蕴藏着智能的一块拼图。 每一次观察、每一次触碰、每一次与物理世界的交互,都承载着人类积累的物理知识。LiberAI 正在将这些散落于亿万日常瞬间的经验汇聚起来,让人类智能跨越身体的边界、不再止步于理解世界,而是真正走进世界、与世界交互,成为物理世界的一部分。
参考链接
官方技术Blog:https://www.liberai.com/blog/liber0
官网:https://www.liberai.com/
LiberAI完成新一轮数亿元融资,世界模型登顶RoboDojo榜单 | CMC Portfolios
2026-09-18
CMC资本投资LiberAI,瞄准物理AI和世界模型赛道 | CMC Portfolios
2026-07-31
以科技积蓄内在精力:今日宜休首发两款睡眠科技旗舰新品 | CMC Portfolios
2026-10-30
从单点技术到全链路底座:CMC 资本投资厘清智能,布局 Physical AI Infra | CMC Portfolios
2026-10-09