ARTICLE · 1311985
AI 真能让自己越改越强吗?2024–2026 递归自我改进(RSI)与自动化科研 (4Research) 基准全景综述 (15篇论文)
§1 技术路线图(必读,5 分钟建立全局认知)
1.1 核心问题
本方向要解决的核心问题是:如何客观、可复现地测量「AI 自己改进自己」的能力,尤其是改进能否迁移到它没见过的数据上,而不是在可见反馈上把分数刷高。多数工作没有给出通用形式化定义,而是把它落成同一套协议:给定一个「能跑但很弱」的初始基线、一份可见数据和一份密封的隐藏数据,让智能体在预算内自主迭代,最后提交一个产物,再由评测方在独立划分上从零重跑并归一化打分。
1.2 演化图谱
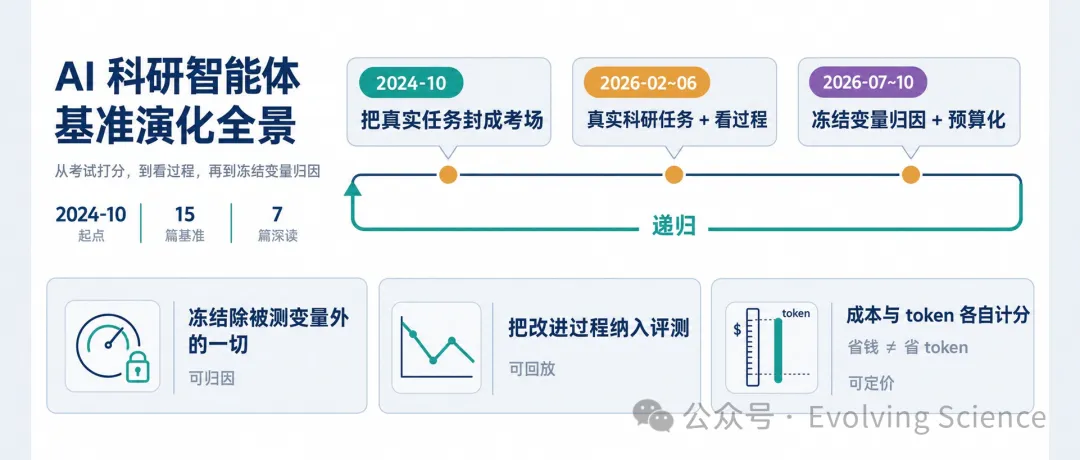
图:AI 科研智能体基准演化全景(2024-10 至 2026-10)。 一条从左到右的时间轴,串起本文覆盖的 15 篇基准,主线分三步:先把真实任务封成考场,再把题目升级为真实科研并开始记录过程,最后冻结其他变量、只算被测变量的贡献,并把训练到评测统一成按预算计费的服务。底部三张卡片是全篇反复出现的三个动作:可归因、可回放、可定价。下方时序表为逐篇对照版。
★ = 本文 §2 深度展开的 7 篇关键论文;未标 ★ 者为贡献被就近吸收的对照工作2024-10 MLE-bench ─────── 真实 Kaggle 竞赛 + 人类奖牌线,先把"能干活"折算成人类名次 ★2024-10 ScienceAgentBench ─ 44 篇论文抽 102 题、专家逐题把关(早期"论文变考题"对照)|2026-02 SciAgentGym ───── 1780 个科学工具沙箱 + 分级题库 + 工具依赖图批量造训练数据 ★2026-02 AIRS-Bench ────── 20 道顶会论文题、不给基线代码(真实任务轴并入 MLE-bench)2026-02 ResearchGym ───── 5 篇获奖论文改 39 个子任务(覆盖过窄,并入 NatureBench)|2026-06 SciAgentArena ─── 跨尺度约 200 题 + 逐步验证(科研任务轴并入 NatureBench / SciAgentGym)2026-06 SEAGym ────────── 把"每一次自我改进"冻结成可回放快照(从看分数转向看过程) ★2026-06 NatureBench ───── Nature 系论文造 90 题、以论文自报 SOTA 归一化打分 ★|2026-07 RSIBench-Data ─── 锁死外围栈,只让智能体改"数据策略",干净归因数据侧贡献 ★|2026-08 PAST-Bench ────── 配对对照隔离"经历 --> 更好行为"的通路(过程审计轴并入 SEAGym)2026-08 AI4AI-Bench ───── 把"算法/学习层设计"单独切出来测 ★2026-08 RSI-Exam ──────── 可见集只反馈、隐藏集只算一次分(计分口径并入 AI4AI-Bench / RSIBench-Data)2026-08 Terminal-Bench-Science ─ 科学家出题 + 社区共建 + 终端可复现(真实任务并入 MLE-bench)2026-09 Autoresearch-Bench ───── "研究能力 = 迭代进步速度"(并入 RSIGym)|2026-10 RSIGym ────────── 训练/推理/评测/沙箱统一成按预算计费的共享服务 ★├── 分支一:过程可审计(→ SEAGym)└── 分支二:成本与 token 前沿(→ RSIGym)
1.3 共享术语(仅收录两篇及以上工作共用的概念)
注:「通过率」指一个模型在全部任务里被判"通过"的比例(公告原文写作 Resolution Rate)。所以「双前沿」不是两套评分刻度,而是同一个通过率的两种花法:一条前沿比"花多少钱能买到多高的通过率",另一条比"烧多少 token 能买到多高的通过率"。
§2 关键论文深度分析(按贡献去重,只收录 7 篇代表性/突破性工作,每篇控制在一页内)
2.1 MLE-bench:让智能体去真实 Kaggle 竞赛里拿奖牌 ⭐⭐⭐⭐
一句话贡献: 第一次把真实 Kaggle 竞赛整体封成可离线自动评测的考场,并用人类排行榜的奖牌线把 AI 的绝对分数折算成人名次,使跨竞赛成绩可以汇总成一个数字。
出处: 📍 ICLR 2025(OpenAI,arXiv:2410.07095)· 🔗 阅读报告 · 📂 https://github.com/openai/mle-bench/
增量贡献
相比只取 13 个任务、且以「比给定基线好 10%」为口径的 MLAgentBench,它改为端到端跑完 75 场真实 Kaggle 竞赛(覆盖 15 个类别、三档难度),不预设模板化格式。
引入「奖牌化」外部标尺:不同竞赛的指标五花八门无法直接比较,但套用 Kaggle 按参赛队伍数分档的铜/银/金牌阈值后,名次档位可以跨竞赛汇总。
把数据污染当成一等公民实测:用熟悉度相关性、题面去标识、代码抄袭检测三套手段正面检验基准分数是否虚高。
建起标准化公平考场:断网 Docker、24 小时时限、只判格式不给分的验证服务器,并配套违规日志检测与提交代码查重。
方法总览
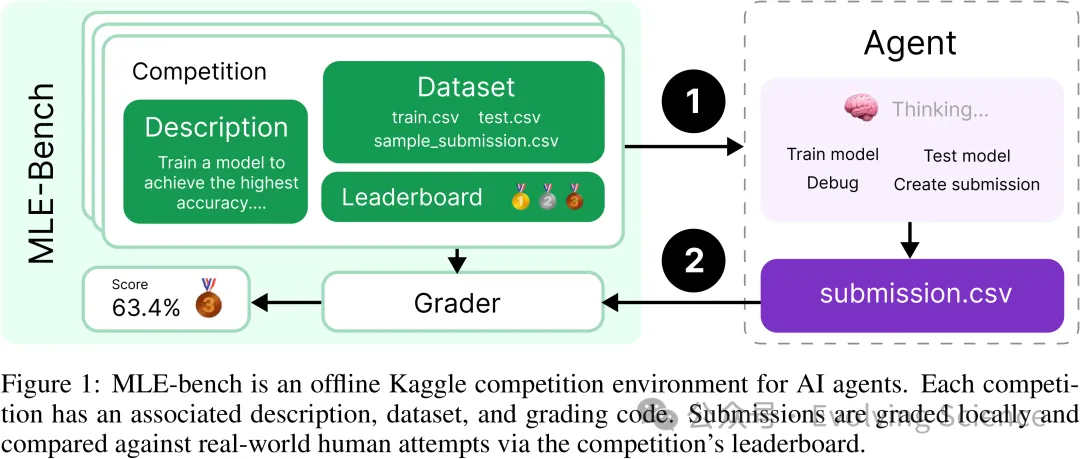
图:MLE-bench 的离线竞赛环境与评测流水线。 左侧是「竞赛包」三件套(题面、数据集、真实排行榜快照),右侧智能体在断网容器里思考、训练、生成
submission.csv,本地评分器打分后回排行榜比名次。
核心机制速览
要给「AI 会不会做机器学习工程」一个可信分数,最直接的办法是让它参加真人比赛。流程是:人工从 5673 场已结束竞赛里筛出 75 场并重做训练/测试划分、逐场配本地评分器;智能体在断网沙箱里 24 小时内自主产出提交;评分器打分后比对人类私榜,够线即发牌。之所以 work,是因为它把一个模糊的能力问题换成了「能挤进人类第几名」这一可比较的外部件:最强组合 o1-preview 配 AIDE 在 16.9% 的竞赛里拿到奖牌,多给机会(pass@8)时这一比例翻倍到 34.1%。
关键结论
主实验。 o1-preview 配 AIDE 在 16.9% 的竞赛里拿到铜牌及以上,约为次优的 GPT-4o + AIDE(8.7%)的两倍;多给机会(pass@8)时这一比例翻倍到 34.1%。
消融。 脚手架比底座更关键:同样用 GPT-4o,专为竞赛设计的 AIDE 拿到 8.7%,而通用框架 MLAB 只有 0.8%、OpenHands 只有 4.4%。
反直觉发现。 算力几乎不是瓶颈、时间才是:双卡 10.2% 与纯 CPU 9.1% 的差异落在误差内,而时限从 24 小时加到 100 小时只提升约 3 个百分点。
遗留问题:题目全部来自公开竞赛,污染只能缓解而无法排除,且入选竞赛都自带清晰题面、干净数据与明确指标,与真实研发里「连问题和指标都要自己定义」相去甚远;引出 2.2 SEAGym。
2.2 SEAGym:给自我进化 Agent 造一套可回放的评测环境 ⭐⭐⭐⭐
一句话贡献: 第一次把「harness 如何被一步步改动」这一过程本身立为评测对象,把每次自我改进冻结成可回放快照并接受多视图打分。
出处: 📍 arXiv 预印本(清华大学自动化系、北京信息科学与技术国家研究中心 BNRist,arXiv:2606.17546,公开日期 2026-06-16)· 🔗 阅读报告 · 📂 (见报告链接)
增量贡献
相比把每道题当独立回合、跑完即重置的静态基准(SWE-bench、Terminal-Bench),它要求状态跨题持久,使「自我进化」这一跨回合行为第一次可被测量。
把任务执行(rollout)与方法更新(update)拆成两个可插拔角色,并用同一组调度参数表达各种自进化节奏,接入新方法只需写一层薄薄的转换。
给出多视图证据链:更新证据、过程验证、分布内迁移、分布外迁移与回放五类视角分开看,回答「靠什么涨、能否迁移、忘没忘记」。
用回放把过程变化拆成「新解出多少题」与「新弄坏多少题」,相对初始快照给出修复率与遗忘率,而不只报首尾分数。
方法总览
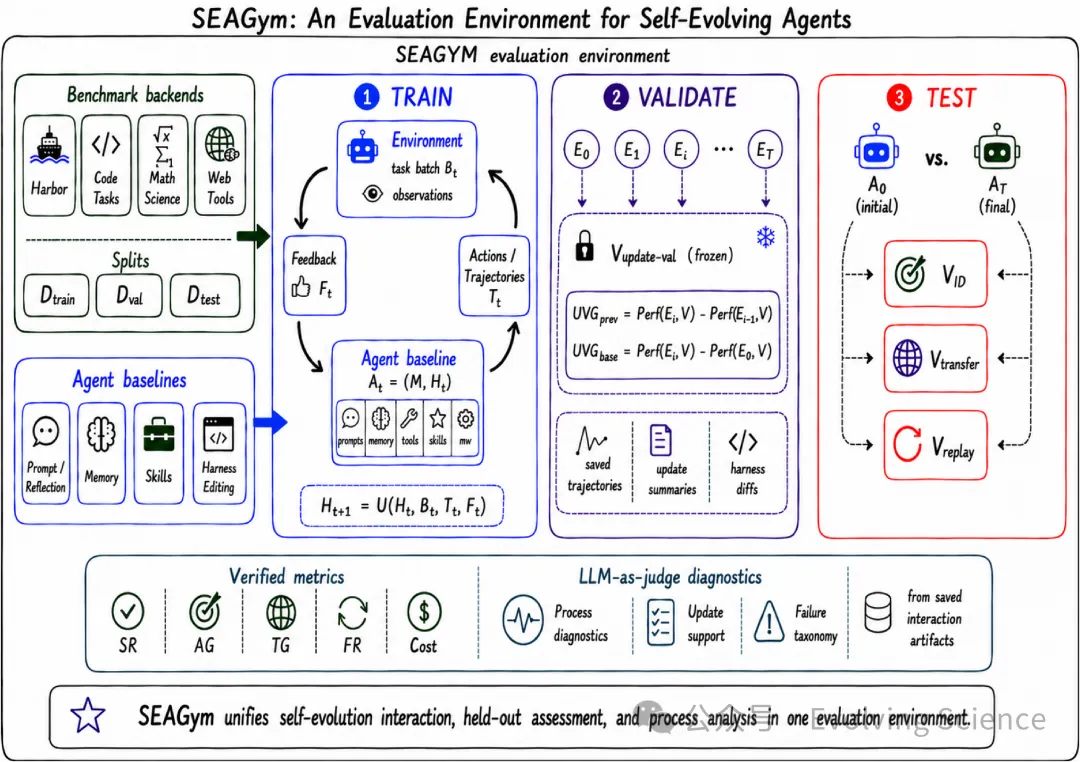
图:SEAGym 的整体流程。 环境从任务池采样训练批次,容器里的 Agent 跑出轨迹与验证器反馈,方法据此改写 harness,每个评测点冻结成一个快照,再由多视图与成本指标打分。
核心机制速览
动机在于:现实中 Agent 会存经验、改提示词、加工具,这些能持久保存的运行外壳才是自我进化的真正对象,而静态基准测不到这个过程。流程是:环境按批次抽题、在容器里跑出轨迹与反馈,方法用自己的规则更新 harness,每个 epoch 冻结一个快照,最后把初始快照与最终快照放到同一批没见过的题上比,并回放训练题看旧本事是否还在。之所以 work,是因为它让同样的总分背后「怎么变的」可被逐轮核对:AHE 是唯一让过程验证、分布内、分布外三项同时上涨的方法,分别提升 17.1、9.1、6.3 个百分点。
关键结论
主实验。 AHE 是唯一让过程验证、分布内、分布外三项同时上涨的方法(分别 +17.1、+9.1、+6.3 个百分点);ACE 三项涨幅最小,TF-GRPO 则验证涨而分布外反降 2.5 个百分点。
消融。 批次大小最关键:固定其余设置时 20 最优(验证 +17.1、分布内 +9.1),10 与 80 大幅倒退(验证分别 -14.3、-17.1),40 仅小幅为正。
反直觉发现。 最终分数会掩盖中途崩塌:AHE 回放首尾从 34/80 升到 43/80,看似稳步向好,但第 4 轮一度塌到 6/80 并伴随大量执行报错。
遗留问题:源只有 Terminal-Bench 2.0 与 HLE 两类、只测模型外部演化(不触及权重更新),且跨后端迁移并不稳定;评测停留在「这一轮涨没涨分」,改进能否迁移到完全没见过的隐藏任务仍未被隔离;引出 2.3 RSIBench-Data。
2.3 RSIBench-Data:只放开「数据策略」的数据中心化研究基准 ⭐⭐⭐⭐
一句话贡献: 第一次把外围训练栈全部锁死、只把「该喂什么训练数据」这一个变量交给智能体,使分数差异可以被干净地归因到数据研究能力本身。
出处: 📍 arXiv 预印本(Evolvent AI、新加坡国立大学,arXiv:2607.25886,公开日期 2026-07-28)· 🔗 阅读报告 · 📂 https://github.com/evolvent-ai/RSIBench-Data
增量贡献
相比把数据、优化、超参与实现一起交出去的端到端后训练基准(PostTrainBench),它固定底座、优化器、推理服务、沙箱、验证器与打分规则,只比较「数据策略」这一项。
智能体提交的是训练工件而非训练代码,任何外围组件都不能替换,从制度上杜绝「赢是因为工程更强」。
把选择分数与官方分数分离:迭代期只看受控的选择反馈,最终成绩在独立环境重跑,保证好成绩归因到研究能力而不是偷看答案。
全流程可审计,每次尝试都留下把数据策略、检查点与评测行为串起来的结构化记录,可解释「为什么涨、为什么跌」。
方法总览
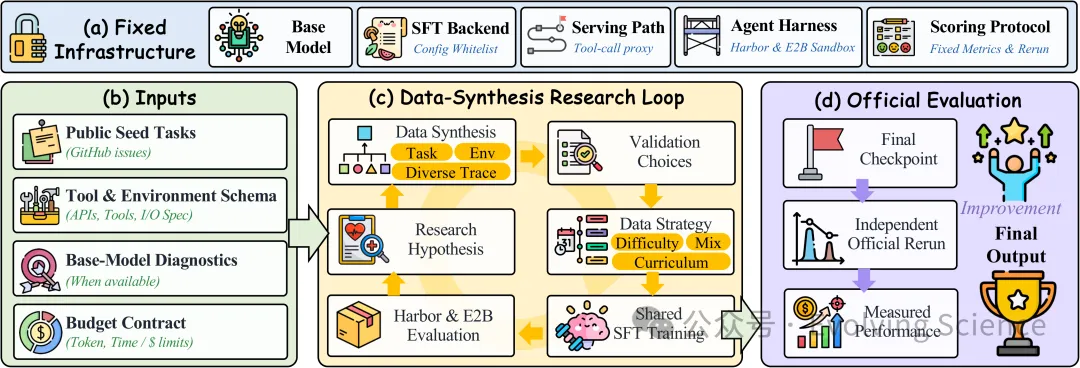
图:RSIBench-Data 总体框架。 顶部被基准锁死的组件加智能体的四类输入,共同驱动「假设、验证、造数据、训练、受控反馈」的研究循环,循环结束后把最终检查点送进独立官方评估。
核心机制速览
动机在于:递归自我改进的关键一环是数据中心化研究(诊断缺口、设计并验证训练数据),但既有基准把它和优化、推理、评测、工程搅在一起,赢了也说不清是哪种能力。流程是:智能体拿到题目、公开种子、工具与环境说明、底座诊断与预算(没有现成训练集),提出「模型缺什么能力」的假设并据此合成、过滤、配比数据,交给同一套 LoRA 微调训练,再由固定沙箱回传受控反馈来决定改还是停。之所以有诊断价值,是因为同一把尺能同时量出能力与局限:24 个设置里 14 个(58.33%)超越了首次尝试,但冲上峰值后继续搜索的 23 个设置里有 18 个(78.26%)最终尝试低于历史最好。
关键结论
主实验。 没有全能选手:三档 SWE 任务由三个不同智能体夺冠,同一基准上四者最高与最低分差 8 到 20 个百分点,最强也仅 SWE-bench Verified 46.00%、SWE-bench Pro 9.00%。
消融。 唯一能单独拨动的旋钮是推理努力度:同为 Sonnet-5 在 SWE-bench Verified,努力度从 high 提到 max,前四次平均选择分从 35.5% 升到 44.0%,官方分从 35% 升到 52%。
反直觉发现。 花更多钱不等于更好:Codex 只用 2.42 小时、10.37 美元在 GPQA Diamond 拿到 65.00%,而另一个配置花 8.87 小时、156.93 美元在 Terminal-Bench 2.0 上只得 5.62%。
遗留问题:每个设置只跑一次、选检查点与官方评测用同一批任务、只在一个目标模型上验证,且研究者身份与脚手架、推理努力度捆绑,无法单独归因;其中「经历能否真正变成更好行为」这一归因问题由 §3 对照表中的 PAST-Bench 用配对对照补充、本文不再展开;而数据层之外,「算法设计层」仍缺专门考场,引出 2.4 AI4AI-Bench。
2.4 AI4AI-Bench:把「算法设计」这一层单独切出来测 ⭐⭐⭐⭐
一句话贡献: 第一次把递归自我改进中「算法设计」这一层单独隔离成考场——冻住测量、放开方法,只许交源码不许交权重,并把「改了哪一层」做成可核查的标注。
出处: 📍 arXiv 预印本(Navers Lab、Einsia.AI 与清华大学,arXiv:2608.20318,公开日期 2026-08-20)· 🔗 阅读报告 · 📂 https://lab.einsia.ai/ai4ai
增量贡献
相比考提交预测的 Kaggle 类评测、最大杠杆在数据装配的 PostTrainBench、以及组件边界由人给定的 MLS-Bench,它把算法设计层单独切出,使收益只可能来自对训练机制本身的改动。
用「只许交源码、不许交权重与缓存」的迁移规则切断资源与缓存通路,补丁必须在全新容器里从初始化重跑,赢只能归因到代码。
把十个互不可比的指标压到同一把尺:0 代表不含任务信息的模型、0.1 代表仓库自带算法、1 代表任务最优,非线性指标先做变换再定标。
读提交的代码 diff 把改动分成跑法侧与学习侧八个家族,把胜负翻译成「agent 到底动了什么」的能力画像。
方法总览
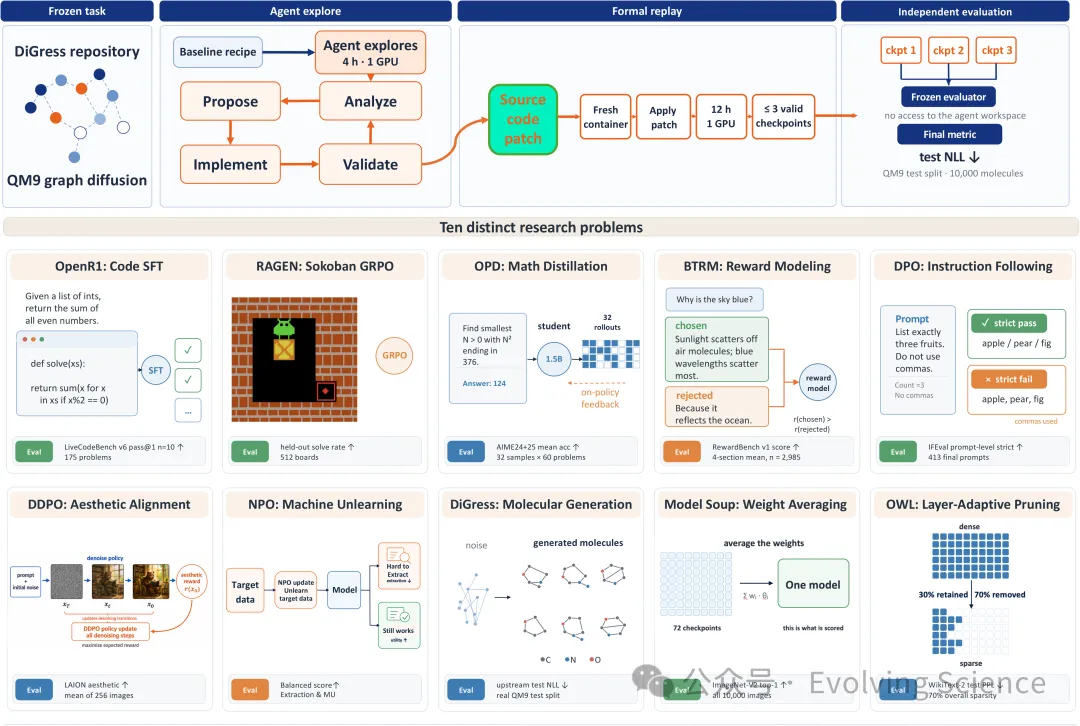
图:AI4AI-Bench at a glance。 上半部分是每道题统一的生命周期(冻结仓库与代理指标、四小时只交源码、干净重跑、独立评测),下半部分是覆盖十种训练算法家族的十个冻结仓库与各自指标。
核心机制速览
动机在于:算法层的收益会写进「算力换成能力」的汇率、被之后每一次训练继承,但此前没有基准把它单独隔离,赢家可能只是数据装配或工程更强。流程是:每道题冻结一个真实研究仓库、起始模型与廉价代理指标,agent 在单卡四小时内读码、改码、用代理指标试想法,只交出一份源码补丁;补丁在全新容器里从初始化重跑最长十二小时,由首次运行前就已固定、且无权访问 agent 工作区的评测器打分并换算到统一刻度。之所以能横比,是因为契约保证所有系统面对同样的硬件、预算、评测器与评测资产:六个系统 290 格平均只有 0.166,最强的 Claude Opus 5 也仅 0.250。
关键结论
主实验。 六个系统能被干净排出顺序(0.117 到 0.250),但整个研究都落在量表最低四分之一:290 格里有 124 格低于 0.1,最强的 Claude Opus 5 也仅 0.250。
消融。 唯一能单独拨动的旋钮是推理投入:从最低档到最高档,均分由 0.094 升到 0.196,触碰学习层的比例由 8% 升到 64%。
反直觉发现。 花得多不等于做得好:Opus 5 的探索成本中位数 181 美元,不到第二名 434 美元的一半,成绩却更高;且推理投入并不单调,Opus 5 在 medium 处最高。
遗留问题:到达学习侧更常伴随高分只是相关性而非因果(更强的系统本来就更容易去改学习层)、代理与最终指标可能同源、成本只统计了探索阶段。它只回答「改得动不动学习层」;至于改进能否迁移到完全隐藏的题目,本报告采用的「隐藏评测器 + 干净重跑」口径已与 §3 对照表中 RSI-Exam 的同名主张一致,故不再重复介绍;而把研究基础设施整体工程化,引出 2.5 RSIGym。
2.5 RSIGym:把研究基础设施全部服务化的递归自我改进环境 ⭐⭐⭐⭐
一句话贡献: 第一次把训练、推理、rollout、评测、沙箱全部做成共享服务,让同一个环境既能做单组件实验,也能做数据、训练设置与运行环境的联合优化。
出处: 📍 arXiv preprint,arXiv:2610.10310(2026-10-07,Evolvent AI / 新加坡国立大学)· 🔗 阅读报告 · 📂 arXiv
增量贡献
相对各自只放开一个自由度的前序基准(只改数据、只搜运行环境、只搭训练流水线),第一次把三者放进同一环境做联合优化。
提出 Everything as a Service:五类服务远程共享,用一把 run 密钥统一验权与计费,「实验能改什么」完全由权限定义。
提出 RSI-Index,用「剩余差距被补掉的比例」跨 5 个 benchmark 统一度量,让不同难度的领域能横向排名。
引入可审计闭环:checkpoint 来源检查、与评测任务的 13-gram 重叠筛查、以及对研究轨迹与提交物的 LLM 判官复核。
方法总览
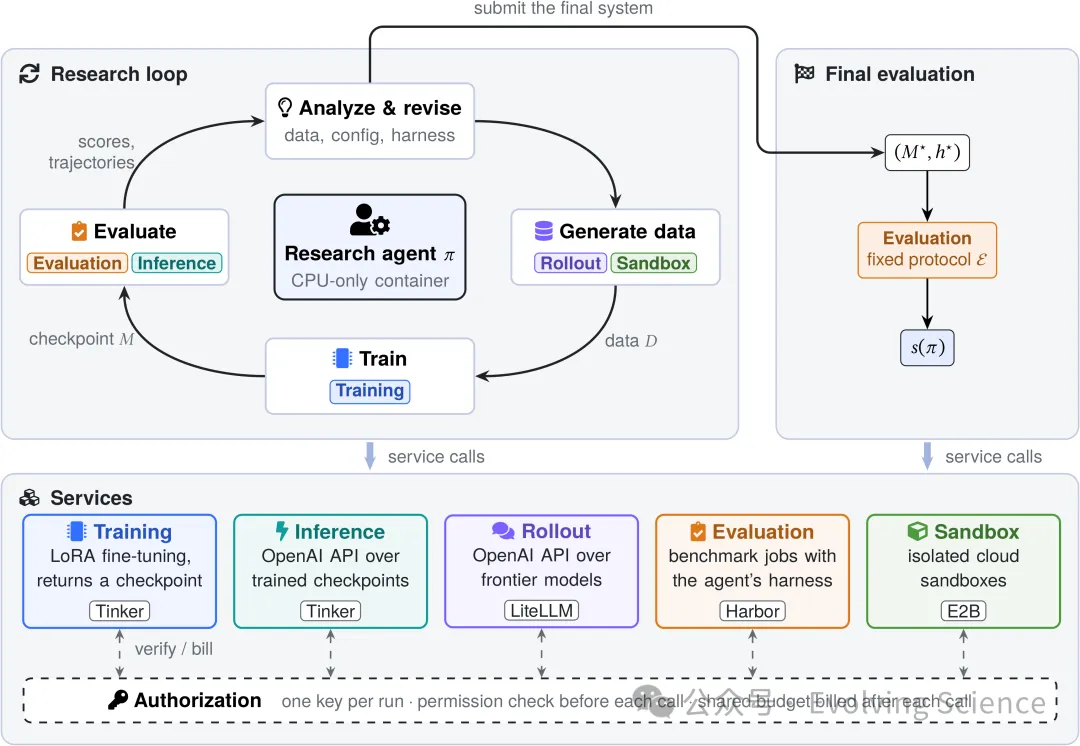
图:论文 Figure 1。 研究 Agent 在轻量 CPU 容器里依次走「评测、生成数据、训练、分析与修改」四步,底部是按统一预算调用的五类云服务,最下方的授权长条把五者串成一本账。它说明「研究循环」与「服务层」如何解耦,是后续所有结果的运行框架。
核心机制速览
动机是每次实验都要重搭训练、推理、评测流水线,Agent 把大量时间耗在例行基础设施上。流程是:Agent 只在纯 CPU 容器里写数据、训练配置与运行环境,通过五个接口(在 Tinker 上做 LoRA 微调的训练服务、把 checkpoint 变成接口的推理服务、经 LiteLLM 访问前沿模型的 rollout 服务、按 Harbor 格式跑 benchmark 的评测服务、经 E2B 的沙箱服务)拿到 checkpoint、补全、分数与轨迹,据此决定下一轮改什么,最后提交「模型加运行环境」由平台按提前固定的协议再评一次。之所以 work,是把研究决策与研究基础设施彻底解耦、预算与权限记在同一本账上,Agent 之间的分数差才真正反映研究能力——每次 benchmark 500 美元预算下六个研究 Agent 全部取得正增益,最好的 Opus 5 达 RSI-Index 0.4809。
关键结论
主实验。 Joint track、每次 500 美元预算下六个 Agent 全部正增益,Opus 5 以 RSI-Index 0.4809 居首,SWE-bench Verified 从 17.67% 提到 50.33%、AIME 从 31.67% 提到 97.78%。
消融。 只改运行环境最有效:权重锁定为 Qwen3.6-35B-A3B-Instruct、只让 Agent 改 DSH harness,Terminal-Bench 从 30.34% 升到 40.82%、三次全对的任务数从 15 升到 26;而只开数据几乎不涨分。
反直觉发现。 「训练越多不一定越好」:10 组同 harness 对照里 8 组更重的训练分数更低;花得最多的 Opus 5.5(2,083.50 美元)只排第二,冠军 Opus 5 反而更省。
遗留问题 分数并非 held-out、每个配置只跑一次因而没有方差估计、且最关键的「递归」闭环尚未被验证;全部工作的横向对比见 §3 与 §4。而把「真实任务」这条轴从 Kaggle 工程一路推到自然科学,就是下面两篇;引出 2.6 SciAgentGym 与 2.7 NatureBench。
2.6 SciAgentGym:把科学工具、分级题库与数据合成装进同一个沙箱 ⭐⭐⭐⭐
一句话贡献: 第一次把「工具依赖图」当成数据引擎——先用带类型签名的科学工具建起可执行环境,再从类型兼容的调用链上采样、真跑、改写成题,使「考场」与「训练数据工厂」共用同一块场地。
出处: 📍 arXiv 预印本(复旦大学 Fudan NLP Group,arXiv:2602.12984 [cs.CL],公开日期 2026-02-13)· 🔗 阅读报告 · 📂 arXiv
增量贡献
相比只看最后答案的科学问答基准(GPQA、SciCode 一类),它把 1780 个科学工具(带类型签名、可自动校验)连同文件系统、数据库、Python 解释器与沙箱打包成可执行环境,让「会不会一步步调工具」第一次能被逐步观察和打分。
出题先剔除前沿模型已能过半答对的简单题、再逐题在环境里跑通留痕,得到 259 题 / 1134 子问题,按推理步数分 L1(54)/ L2(126)/ L3(79)三档,并补一个按专家路径长度打折的效率分。
提出 SciForge 数据合成:把工具按输入输出类型连成依赖图,只在类型兼容的边上采样调用链、再在环境里前向执行,把「抽象链路」变成「真跑通的轨迹」。
把错误恢复当一等训练数据:工具报错时按诊断信息构造修正输入重跑,把「失败尝试 + 成功修正」成对插进轨迹,让模型同时学正确用法与照反馈改错的策略。
方法总览
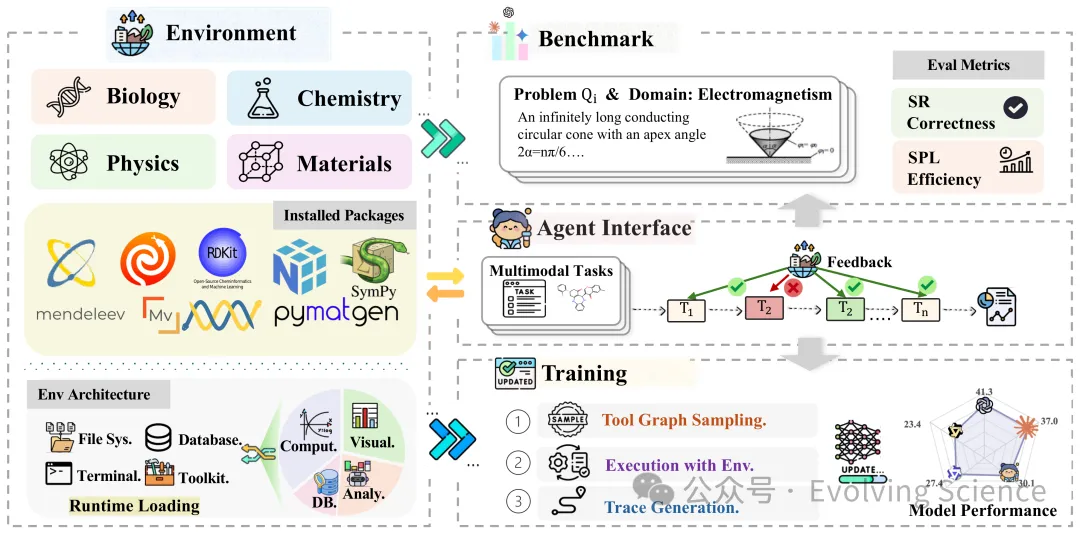
图:论文 Figure 2(环境总览图)。 左半是把工具、数据库与沙箱打包成的执行环境,右半是它同时支撑的三条线——多模态任务、带反馈的多步交互接口、以及在工具依赖图上采样后真跑的造数据流程,最后落到成功率与路径效率两个指标。
核心机制速览
动机在于:科学问答基准只看最后答案,看不出智能体到底会不会分步调工具,也缺少能反哺训练的带逻辑数据。流程是:环境先让工具「有类型、跑得通、留得下」(每个工具声明带类型的输入输出、执行全程录成可复现轨迹),再从公开题库筛出难题、在环境里验证可解性、按步数分档;数据侧则对每个领域建工具依赖图,用类型兼容判定连边,再施加参数绑定与阶段感知采样两道约束,把合法链路在环境里真跑成轨迹、反向改写成自然语言题。之所以 work,是考场与课堂共用同一块场地:判断难在哪里的证据,同时也成了训练模型补短板的原料——最强模型 GPT-5 带工具也只有 41.3%,而用合成轨迹微调的 8B 模型反超了 235B 大模型。
关键结论
主实验。 题目越难分越低:所有模型平均从 L1 的 47.4% 掉到 L3 的 16.4%(相对跌幅 65.4%),最强 GPT-5 带工具也只有 41.3%(L1 58.8% 到 L3 34.6%);用合成数据训出的 SciAgent-8B 达 30.1%,高于底座 Qwen3-VL-8B(23.4%)与 235B 的 Qwen3-VL-Instruct(23.9%)。
消融。 科学工具数据不可替代:换成非科学工具(网页搜索、文件操作、日历 API)的轨迹后整体从 23.4% 掉到 18.5%;只用干净轨迹(去掉错误恢复)则从 30.1% 降到 26.6%。
反直觉发现。 调得多不等于做得好:工具调用次数与成功率几乎不相关(),弱的 8B 平均调 16.55 次只得 23.4%,强的 GPT-5 只调 3.41 次就有 41.3%;6617 次报错里模型只有 32.9% 会回应错误、6.6% 会去改参数,瓶颈在「不会从错里爬出来」。
遗留问题:题目全部来自公开科学题库、效率分 SPL 绑死在单条专家参考路径上(走另一条同样正确的路线会被按步数打折)、工具规模与真实科研软件栈仍有差距;而题目来源的价值还可以再高一级——直接拿已发表论文当题面,引出 2.7 NatureBench。
2.7 NatureBench:把 Nature 系论文改造成考题、拿论文自报 SOTA 当标尺 ⭐⭐⭐⭐
一句话贡献: 第一次以「已发表论文自报的 SOTA 数值」直接作为 AI 的对照标尺,用方向归一化把 81 种异构指标压成同一把尺,回答「编程智能体离真实自然科学论文的最好成绩还有多远」。
出处: 📍 arXiv 预印本(Horizon Research / Frontis.AI 与清华大学、北京大学、哈佛大学,arXiv:2606.24530 [cs.CL],公开日期 2026-06-23)· 🔗 阅读报告 · 📂 https://github.com/FrontisAI/NatureBench
增量贡献
题目来源价值高:从 10 本 Nature 子刊 2022–2025 年的约 5500 篇论文起步,经三级过滤、对抗式复核与数据核对,最终留下 90 个可一键复现的容器化任务,覆盖细胞组学、蛋白质生物学、生物医学建模、物理建模、分子设计、关系推理六个自然科学领域。
提出 NatureGym 流水线:把「核心算法、数据、指标、SOTA 分数、基线」抽成结构化记录,并划出「方法分界」——只保留无论用什么方法都得给的公共输入,论文原创方法被信息防火墙挡在门外。
用 SOTA 归一化相对差距 把 81 种主指标(AUROC、RMSE、Spearman 、ARI、F1、MAE 等)折算成单一可比量,把「超过 / 打平论文 SOTA」当成头条口径。
统一预算加事后有效性判官:每题固定 4 小时、按需一块 GPU,跑完由判官核查伪造输出、用规则替代学习、直接还原答案、薅反馈、跳过训练五类捷径,违规运行整段判无效。
方法总览
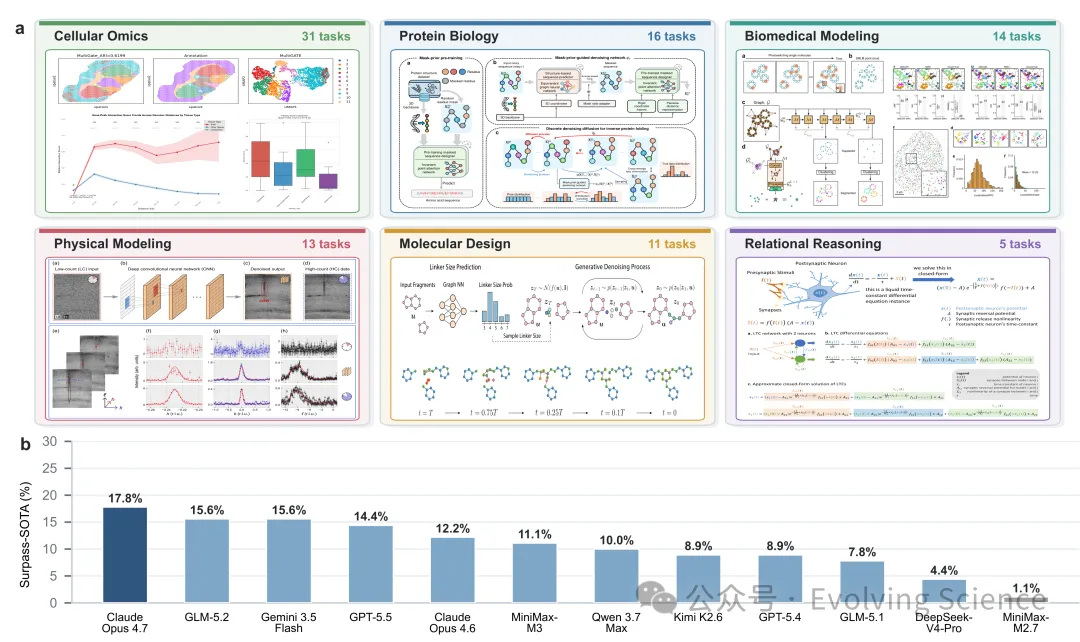
图:论文 Figure 1。 (a) 六个自然科学任务域及各自一张代表性论文原图;(b) 十二个模型按 Surpass-SOTA(明确超过论文 SOTA 的任务占比)排出的榜单——榜首 Claude Opus 4.7 也只有 17.8%。它把「跨六个领域出题」与「最强 agent 也只追平不到一半」两件事并置在一张图里。
核心机制速览
动机在于:既有的「智能体做科研」基准要么靠人工出题、要么环境各搭各的,别人很难原样跑起来,也说不清「AI 到底有没有超过人类最好水平」。流程是:NatureGym 三段流水线(论文筛选、数据获取与核对、任务包构建)各自挂独立评审,把一篇论文加工成带信息防火墙的容器包;智能体在隔离容器里只读题面与数据,4 小时内自己写代码、训练、反复交卷;评测器与真值放在它碰不到的宿主机上,打分前先校验格式与形状。之所以有参照价值,是因为锚点来自论文自己公布的成绩而非另设基线:在校准中两个模型共同成功的 16 个任务上,归一化差距 紧密聚在零附近(中位 ),说明 SOTA 锚点标定可靠。
关键结论
主实验。 最强也不够看:Claude Opus 4.7 只在 17.8% 的任务上明确超过 SOTA、47.8% 打平,其后是 GLM-5.2 与 Gemini 3.5 Flash(各 15.6%)、GPT-5.5(14.4%),最弱的 MiniMax-M2.7 仅 1.1% / 13.3%,没有一个模型追平过半任务。
消融。 贴近任务原本科学结构的解法更有效:与论文方法同族的运行 Match-SOTA 为 37.7%,异族只有 29.6%;跨学科任务比单学科更难(Match-SOTA 从 33.1% 降到 28.0%)。
反直觉发现。 赢靠「把科研题降维成工程题」、输在「选错方法」:900 次运行里 45.5% 的成功是把科学问题翻译成熟悉的监督预测题,工程类手段合计 82.7%,而真正「没看懂题」只有 3.1%,失败里方法层占 61.1%(选错方法 45.1%)、执行层占 28.7%(预算 / 时间不够 24.4%);域难度还是一条所有模型都认同的稳定梯度(关系推理 60.0% 最高、生物医学建模 17.9% 最低,十个 agent 的域排名 Spearman )。代价是单题平均约 2425 万输入 token、约 21.65 美元。
遗留问题:题目全部来自公开论文与公开数据,污染只能靠禁网与事后判官缓解而无法排除;只覆盖论文里能被自动、确定性评测的「核心定量切片」,数据超 50 GB 的实例被剔除; 以 SOTA 为分母,接近天花板的任务会把中等表现放大成很大的负值。它把「真实任务 + 外部标尺」这条线推到自然科学论文级,接下来按贡献去重做选型,见 2.8。
2.8 选型与覆盖关系:为什么只留这 7 篇
本综述按「贡献去重」选文:同一研究问题上只保留质量最高、覆盖最广的一篇深度展开,其余工作以 §3 清单一句话带过,避免重复介绍。入选 7 篇与其余工作的覆盖关系如下。
MLE-bench: 覆盖「真实任务端到端评测 + 人类外部标尺 + 污染实测」,一并取代 Terminal-Bench-Science 的「真活计」主张(其科学家出题与双前沿成本为增量,见 §3)。
SEAGym: 把「改进过程」而非产物分数立为评测对象,过程 / 机制审计轴覆盖 PAST-Bench 的配对持久化主张。
RSIBench-Data: 冻结外围栈、只放开「数据策略」做单变量归因,隐藏 / 官方重跑计分口径覆盖 RSI-Exam 的「可见集只反馈」协议。
AI4AI-Bench: 单独隔离「算法 / 学习层设计」做单变量归因,隐藏评测器 + 干净重跑同样覆盖 RSI-Exam 的迁移口径。
RSIGym: 做训练 / 推理 / 评测 / 沙箱服务化 + 数据与 harness 联合优化,预算化与迭代闭环覆盖 Autoresearch-Bench 的迭代进步速度轴,并给出成本前沿。
SciAgentGym: 把「真实任务」从 Kaggle 工程推进到多步科学工具链,覆盖「科学工具环境 + 分级题库 + 用工具依赖图合成带逻辑训练数据」,并以环境反哺训练数据的做法覆盖 AIRS-Bench 的「不给基线、硬碰 SOTA」主张(真实任务轴并入 MLE-bench)。
NatureBench: 覆盖「以已发表论文自报 SOTA 为外部标尺 + 跨学科归一化」。题目来源价值高于从论文代码库改造的 ResearchGym(仅 5 任务,覆盖过窄)与专家人工挑选的 SciAgentArena(跨尺度视角独特、但不同尺度之间的关联未被细致刻画)。
边界说明:PAST-Bench、RSI-Exam、Terminal-Bench-Science、Autoresearch-Bench 属本研究范畴,但贡献已被上表入选论文覆盖或吸收,仅在 §3 与附录作为对照保留。ScienceAgentBench、AIRS-Bench、ResearchGym、SciAgentArena 是「真实科研任务」这条线上的对照工作(前两者为早期工作、方法已无新意,ResearchGym 覆盖过窄,SciAgentArena 跨尺度关联未细致刻画、方法不新颖),同样只在 §3 与附录保留一句话定位。
§3 增量贡献速查(15 篇全部覆盖,每篇一段)
本清单覆盖全部 15 个工作;★ 为 §2 深度展开的 7 篇关键论文,其余为对照工作,其贡献已就近归入关键论文,只作一句话对照、不重复介绍。
1. MLE-bench ★(⭐⭐⭐⭐) 基于「真实 Kaggle 竞赛 + 既有智能体框架」;增量贡献:把 75 场真实竞赛封成断网离线考场,用人类奖牌线把 AI 的绝对分折算成人类名次;关键指标:16.9% 任意奖牌率(o1-preview + AIDE)。它是 §2 关键论文,也是「真实任务 + 外部标尺」这条线的源头。
2. SEAGym ★(⭐⭐⭐⭐) 基于自进化智能体方法(AHE / ACE / TF-GRPO);增量贡献:把 harness 的每一次自我改进冻结成可回放快照,按「证据、迁移、遗忘」多视图打分;关键指标:AHE 三项增益 +17.1 / +9.1 / +6.3 个百分点。§2 关键论文,代表「过程可审计」。
3. RSIBench-Data ★(⭐⭐⭐⭐) 基于「固定后训练栈 + 以数据为中心的研究」;增量贡献:锁死整条外围栈,只让智能体设计「数据策略」,从而干净归因数据侧贡献;关键指标:24 个设置中 14 个超越首版(58.33%)。§2 关键论文,代表「数据层单变量归因」。
4. PAST-Bench(⭐⭐⭐⭐) 基于个人智能体的记忆 / 技能持久化;增量贡献:用配对对照隔离「经历转成更好行为」的增益,并要求增益经由预期持久化通路产生;关键指标:固定基座下增益同为 +0.13,机制证据 0.57 对 0.64。对照工作,过程 / 机制轴与 SEAGym 重叠。
5. AI4AI-Bench ★(⭐⭐⭐⭐) 基于 10 个冻结训练仓库 / 10 类训练算法;增量贡献:把「算法设计层」单独切出来测,且只认动了「模型怎么学」的提交;关键指标:动了学习层的均分 0.226 对 0.126。§2 关键论文,代表「算法 / 学习层归因」。
6. RSI-Exam(⭐⭐⭐⭐) 基于「长周期可执行研究 + 隐藏集重跑」;增量贡献:可见集只给反馈、隐藏集只算一次分,把「能否迁移」写进唯一计分口径;关键指标:88 任务榜首 0.5357(低于 0.6 前沿线)。对照工作,隐藏集计分口径已被 AI4AI-Bench / RSIBench-Data 覆盖。
7. Terminal-Bench-Science(⭐⭐⭐⭐) 基于 Terminal-Bench / Harbor 沙箱;增量贡献:由一线科学家出题、用终端可复现测试评分,做成社区共建、可迭代的科研工作流基准;关键指标:0.1 版 70 题,最高通过率 30.0%。对照工作,真实任务轴并入 MLE-bench,成本前沿并入 RSIGym。
8. Autoresearch-Bench(⭐⭐⭐) 基于「可自评指标的迭代研究循环」;增量贡献:把「研究能力」定义为在可自评指标上 4 小时内迭代进步的速度,并跨任务归一化;关键指标:榜首模型在优化类任务约为平均的 2 倍。对照工作,迭代进步速度轴并入 RSIGym。
9. RSIGym ★(⭐⭐⭐⭐) 基于预算化共享服务(Tinker / LiteLLM / Harbor / E2B);增量贡献:把训练、推理、rollout、评测、沙箱做成按预算计费的统一服务,智能体只改数据与 harness;关键指标:六个研究模型全正增益,最好 RSI-Index 0.4809。§2 关键论文,代表「服务化 + 联合优化」。
10. ScienceAgentBench(⭐⭐⭐⭐) 基于 44 篇已发表论文里的真活儿;增量贡献:把论文里的数据处理 / 模型开发 / 数据分析 / 可视化改造成 102 道能跑的 Python 题、由 9 位专家逐题把关;关键指标:最强的 Claude-3.5-Sonnet + self-debug 独立做对 32.4%(给专家知识 34.3%),o1-preview 达 42.2% 但每题约 0.636 美元。早期工作(ICLR 2025),「论文变考题」这条线此后被 ResearchGym、NatureBench 接手,只作对照。
11. AIRS-Bench(⭐⭐⭐⭐) 基于 20 道顶会论文题、不给基线代码;增量贡献:用「问题 / 数据集 / 指标」三元组定义任务,逼智能体从零复现甚至超越作者;关键指标:14 个智能体平均有效提交率 59.3%、归一化得分 24.1%,仅 1.58% 的组合超过人类 SOTA。早期工作、方法无新意,真实任务轴并入 MLE-bench,只作对照。
12. ResearchGym(⭐⭐⭐⭐) 基于 5 篇 ICML / ICLR / ACL 2025 获奖论文的代码库;增量贡献:把「构思 + 实验」整条闭环封成闭卷考场、用论文原版脚本客观打分;关键指标:GPT-5 智能体 15 次运行仅 1 次(6.7%)超过仓库基线、平均只完成 26.5% 子任务。只有 5 任务 / 39 子任务、覆盖过窄,题目来源与规模被 NatureBench 覆盖,只作对照。
13. SciAgentGym ★(⭐⭐⭐⭐) 基于 1780 个带类型签名的科学工具与可执行沙箱;增量贡献:把工具依赖图当数据引擎——采样类型兼容的调用链、真跑成轨迹、再改写成题,考场与训练数据工厂共用同一块场地;关键指标:GPT-5 带工具 41.3%(L3 仅 34.6%),合成数据训出的 SciAgent-8B 30.1% 反超 235B 模型。§2 关键论文,代表「科学工具 + 数据合成」。
14. NatureBench ★(⭐⭐⭐⭐) 基于 10 本 Nature 子刊 2022–2025 年的约 5500 篇论文;增量贡献:把论文改造成 90 个可复跑的容器化任务、以论文自报 SOTA 做归一化打分;关键指标:最强 Claude Opus 4.7 仅 17.8% 超过 SOTA、47.8% 打平。§2 关键论文,代表「论文级题目来源 + SOTA 归一化」。
15. SciAgentArena(⭐⭐⭐⭐) 基于跨尺度真实科研任务(从分子到病人);增量贡献:把运行框架与评估框架分离、支持逐步验证,并配一组专测「题目本身是否成立」的有效性任务;关键指标:约 198 题 / 5 领域 / 18 个智能体,同一个 GPT 5.2 在通用题 AIME 上 100%、换成真实科研任务只有 29 到 80。跨尺度视角独特,但不同尺度之间的关联未被细致刻画、方法不新颖,只作对照。
💡 阅读提示: 每一篇自成一段,增量贡献已翻译成「谁做了什么、换来什么效果」的直白语言;关键指标只取各报告中最能代表成果的一个数字,详情见对应读书报告。
§4 横向对比与洞察
4.1 方法维度对比
MLE-bench —— 评测对象:完整 MLE 工程(模型 + 框架);基座是否固定:否(模型自选);计分口径:人类奖牌线折算名次;预算:单次主实验约 1800 GPU 小时。
SEAGym —— 评测对象:harness 的更新过程;基座是否固定:固定比较口径;计分口径:多视图(过程验证 / 分布内 / 分布外 / 回放);预算:5 个 epoch 训练,记录 token。
RSIBench-Data —— 评测对象:数据策略;基座是否固定:固定(后训练栈整体锁定);计分口径:官方重跑 + 归一化;预算:中位 6.55 小时、62.51 美元。
PAST-Bench —— 评测对象:经历到行为的持久化通路;基座是否固定:固定基座(比较框架);计分口径:任务分 + 机制证据;预算:每题约 3.2 万 token(Hermes+)。
AI4AI-Bench —— 评测对象:训练算法改写(学习层);基座是否固定:冻结仓库与隐藏评测器;计分口径:隐藏评测器指标;预算:4 小时探索 + 最多 12 小时重跑。
RSI-Exam —— 评测对象:可执行研究产物;基座是否固定:可冻结模型;计分口径:隐藏集归一化(0 / 0.6 / 1);预算:最长 12 小时,单任务约 5.22 到 53.39 美元。
Terminal-Bench-Science —— 评测对象:科研工作流;基座是否固定:不适用(比模型 + 脚手架);计分口径:每题 3 次试验的通过率;预算:双前沿,成本与 token 同时比较。
Autoresearch-Bench —— 评测对象:迭代研究速度;基座是否固定:不适用(比模型 + 脚手架);计分口径:归一化分(冻结除数);预算:4 小时自动研究循环。
RSIGym —— 评测对象:数据 + harness;基座是否固定:固定基座模型;计分口径:RSI-Index(多基准差距补齐平均);预算:每次 benchmark 约 500 美元服务预算。
SciAgentGym —— 评测对象:多步科学工具调用;基座是否固定:不适用(比模型 + 合成训练数据);计分口径:成功率 SR + 路径效率 SPL;预算:每题不限时,未给成本前沿。
NatureBench —— 评测对象:真实自然科学科研题;基座是否固定:固定(禁联网 + 统一 4 小时 / 单卡);计分口径:SOTA 归一化相对差距 (Surpass / Match-SOTA);预算:每题 4 小时 + 单卡,最强 agent 平均约 21.65 美元。
4.2 跨论文洞察
洞察:冻结除被测变量外的一切,是可归因的前提。 RSIBench-Data 锁死后训练栈、RSIGym 固定基座模型、AI4AI-Bench 冻结仓库与隐藏评测器——三处都用「只动一个变量」换来了干净的因果解释。(来自 RSIBench-Data、RSIGym、AI4AI-Bench)
洞察:计分口径正从「单一可见测试集」转向「隐藏集 / 官方重跑 + 归一化锚定」。 MLE-bench 用人类奖牌线、RSI-Exam 用 0 / 0.6 / 1 锚点、Autoresearch-Bench 用冻结除数、RSIBench-Data 用官方重跑,都是为了让不同任务、不同模型的分数能放在同一把尺子上,同时压住刷分;NatureBench 更进一步,直接拿论文自报的 SOTA 数值作分母做方向归一化,把 81 种指标压成一把尺,ResearchGym 则用「除以人类解法、1.0 为持平」的口径。(来自 MLE-bench、RSI-Exam、Autoresearch-Bench、RSIBench-Data、NatureBench、ResearchGym)
洞察:评测对象正从「产物分数」扩展到「改进过程」。 SEAGym 冻结每次 harness 更新并回放、PAST-Bench 要求增益经由预期持久化通路、AI4AI-Bench 区分「改怎么跑」与「改怎么学」——三者都在追问分数背后的机制,而不只看终值。(来自 SEAGym、PAST-Bench、AI4AI-Bench)
洞察:成本与 token 已变成一等指标。 Terminal-Bench-Science 画出成本与 token 两条前沿、AI4AI-Bench 报告探索成本中位数、RSI-Exam 记录单任务花费跨度、RSIBench-Data 给出中位耗时与花费——「同样的分数花了多少钱」开始和分数本身一样重要。(来自 Terminal-Bench-Science、AI4AI-Bench、RSI-Exam、RSIBench-Data)
洞察:正增益普遍存在,但不稳健、也未必来自预期通路。 RSIGym 在 30 个「智能体-基准」设置里有 29 个提升,RSIBench-Data 却有 78.26% 的设置在冲顶后继续搜索时最终低于历史最好,PAST-Bench 则发现分数相同、机制证据不同。(来自 RSIGym、RSIBench-Data、PAST-Bench)
洞察:时间预算被统一到「小时级」,但「多长才够」仍无共识。 RSI-Exam 给 12 小时、AI4AI-Bench 给 4 小时探索加 12 小时重跑、Autoresearch-Bench 给 4 小时、RSIGym 干脆改用美元计预算——行业还没找到一个公认的「足够长」。(来自 RSI-Exam、AI4AI-Bench、Autoresearch-Bench、RSIGym)
4.3 失败模式
可见集进步不迁移(假进步) —— 出现于 RSI-Exam、RSIBench-Data:在可见反馈上过拟合,隐藏集重跑后回落。
增益来自非预期通路 —— 出现于 PAST-Bench:只看分数无法区分增益究竟来自哪里。
只改「怎么跑」不改「怎么学」 —— 出现于 AI4AI-Bench:触及运行环境比触及学习层更便宜、更容易。
预算翻倍收益不增 —— 出现于 RSIGym:收益对预算不敏感(4 对里 3 对提升,两对不足 0.03)。
训练窄目标导致遗忘 —— 出现于 SEAGym:只训 HLE 时分布内降 22、分布外降 21.2。
§5 未来方向
验证「递归」本身。 把「这一轮的改进能否带进下一轮循环」当成核心假设去测,而不是只测单轮增益。(来源:RSIGym §局限)
把过程证据纳入标准报告。 不只手报首尾分数,还要报中间快照、中途回退与遗忘情况。(来源:SEAGym、PAST-Bench)
成本感知的评测与排行。 把美元与 token 和准确率并列,作为默认的前沿维度,而不是附录里的补充数字。(来源:Terminal-Bench-Science、AI4AI-Bench)
隐藏集与污染治理的工程化。 密封划分、全新容器重跑、定时轮换隐藏集,把「防刷分」做成基础设施。(来源:RSI-Exam、MLE-bench)
更难、更接近真实科研的任务。 允许问题与指标本身需要被定义,而不是只给干净数据和清晰指标。(来源:RSI-Exam、Terminal-Bench-Science)NatureBench 已把题目来源推到已发表论文、SciAgentGym 与 SciAgentArena 把任务推到多步科学工具与跨尺度真实科研;但 NatureBench 的失败仍有 24.4% 卡在预算、SciAgentArena 的跨尺度关联尚未细究,说明「任务够真」与「能力够用」之间仍有距离。
自己的一点思考: 目前多数基准仍以「一次性提交 + 一次重跑」为主,未来可考虑长期的多轮自我改进记账,把「累计进步曲线」而非单点分数当作主指标,这样才更接近「递归」二字的本意。
附录:工作演进时间线
按时间顺序一览各工作,供按需检索;建立全局认知请优先看 §1.2 演化图谱。★ 为 §2 深度展开的关键论文,其余为 §3 对照工作。
2024-10 · MLE-bench ★(⭐⭐⭐⭐) 核心贡献:真实竞赛 + 人类奖牌线的离线 MLE 工程评测。解决的问题:缺少端到端 MLE 能力的可比标尺。遗留问题:算力开销极大、数据污染难以排除。
2024-10 · ScienceAgentBench(⭐⭐⭐⭐) 核心贡献:把 44 篇已发表论文里的真活儿改造成 102 道可执行 Python 题。解决的问题:数据驱动科研缺少专家逐题把关的真实任务。遗留问题:题目规模偏小、结论受成本与模型差异干扰。
2026-02 · AIRS-Bench(⭐⭐⭐⭐) 核心贡献:20 道顶会论文题、不给基线代码硬碰 SOTA。解决的问题:真实科研题缺少可比的归一化标尺。遗留问题:统一 24 小时 / 单卡会卡住强模型、仅 1.58% 超过人类 SOTA。
2026-02 · SciAgentGym ★(⭐⭐⭐⭐) 核心贡献:1780 个科学工具沙箱 + 分级题库 + 工具依赖图批量造训练数据。解决的问题:科学问答只看答案,看不出会不会分步调工具。遗留问题:题目取自公开题库、效率指标绑死单条专家参考路径。
2026-02 · ResearchGym(⭐⭐⭐⭐) 核心贡献:把 5 篇获奖论文的代码库改成闭卷考场。解决的问题:研究闭环(构思 + 实验)缺少端到端可执行评测。遗留问题:仅 5 任务 / 39 子任务、覆盖过窄,题目来源与规模可被 NatureBench 覆盖。
2026-06 · SciAgentArena(⭐⭐⭐⭐) 核心贡献:跨尺度约 200 题 + 运行 / 评估框架分离 + 逐步验证。解决的问题:静态科学问答盖不住真实科研流程。遗留问题:跨尺度之间的关联未被细致刻画、领域集中于化学与生医。
2026-06 · SEAGym ★(⭐⭐⭐⭐) 核心贡献:把每次自我改进冻结成可回放快照。解决的问题:只看终值会漏掉中途回退与遗忘。遗留问题:只在两个基准、三种方法上验证。
2026-06 · NatureBench ★(⭐⭐⭐⭐) 核心贡献:把 Nature 系论文改造成 90 个容器化任务、以论文自报 SOTA 做归一化打分。解决的问题:说不清 AI 有没有超过人类最好水平。遗留问题:污染无法排除、只覆盖论文里可自动评测的切片。
2026-07 · RSIBench-Data ★(⭐⭐⭐⭐) 核心贡献:锁死外围栈、只归因数据策略。解决的问题:数据侧贡献难以从整栈里分离。遗留问题:每设置只跑一次、泛化性未验证。
2026-08 · PAST-Bench(⭐⭐⭐⭐) 核心贡献:配对对照 + 机制证据隔离持久化增益。解决的问题:分数提升不一定来自保留经验。遗留问题:绝对增益有限、未宣称普适。
2026-08 · AI4AI-Bench ★(⭐⭐⭐⭐) 核心贡献:单独测量「算法设计层」的改写。解决的问题:算法设计与工程调参混在一起。遗留问题:只测六套商业系统、归因是相关性。
2026-08 · RSI-Exam(⭐⭐⭐⭐) 核心贡献:可见集只反馈、隐藏集只算一次分。解决的问题:刷可见集分数不等于真进步。遗留问题:缺论文级细节与第三方复现。
2026-08 · Terminal-Bench-Science(⭐⭐⭐⭐) 核心贡献:科学家出题的社区共建科研工作流基准。解决的问题:教科书题与真实科研工作流脱节。遗留问题:任务数有限、偏重可终端验证的工作流。
2026-09 · Autoresearch-Bench(⭐⭐⭐) 核心贡献:把「研究能力」量化为迭代进步速度。解决的问题:自主研究缺少可自动打分的协议。遗留问题:未公开完整数值与日志、复现难。
2026-10 · RSIGym ★(⭐⭐⭐⭐) 核心贡献:训练推理评测沙箱统一为预算化服务。解决的问题:每次实验都要重搭流水线。遗留问题:「递归」这一核心主张尚未被验证。