ARTICLE · 1334579
别把PDF一股脑塞给AI:文献索引台这样搭
读文献最费劲的,有时不是读不懂,而是记不清:某个观点在哪篇文章里出现过?哪几篇文献讨论了相近的问题?手头的 PDF 一多,靠文件名和关键词很难找全。
我把 Zotero 文献库接入 AI 检索,做成一个“文献索引台”:先从库里找到相关研究,再让 Agent 读取对应条目或全文。它不是把所有 PDF 一次性塞进聊天框,而是把文献管理、内容索引和 AI 检索接成一条工作流。
让 Zotero 做文献主库,MCP 做连接层
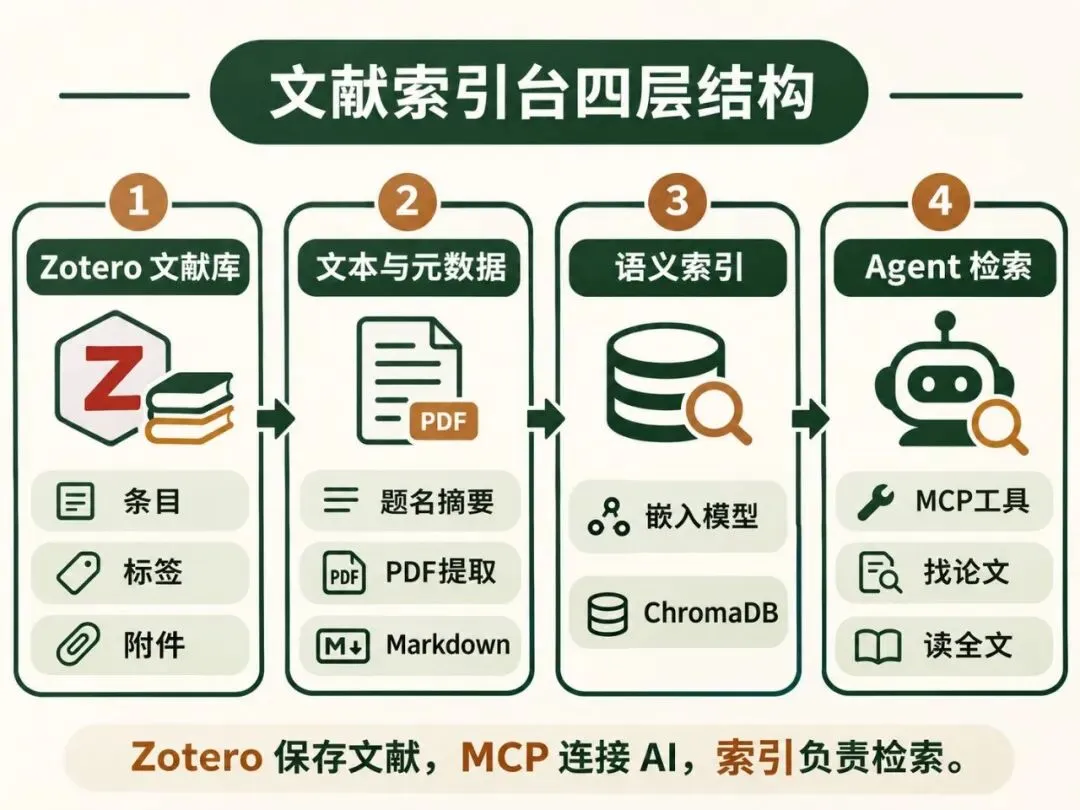
Zotero 保存文献,MCP 把检索能力交给 AI。
文献条目、作者、年份、摘要、标签和附件仍保存在 Zotero。这样不用另建一份容易过期的清单,已有的分类与管理习惯也能保留下来。
Zotero MCP 把文献库的检索、全文读取等能力交给 AI 助手。你可以按题名、作者、标签和收藏集查找,也可以用自然语言描述研究问题,让 Agent 从已有文献里寻找相关材料。
这层设计解决的是“怎么让 Agent 找得到我的文献”。Zotero 继续管理条目,MCP 负责把可用的检索工具提供给助手。
先建元数据索引,需要时再加入全文
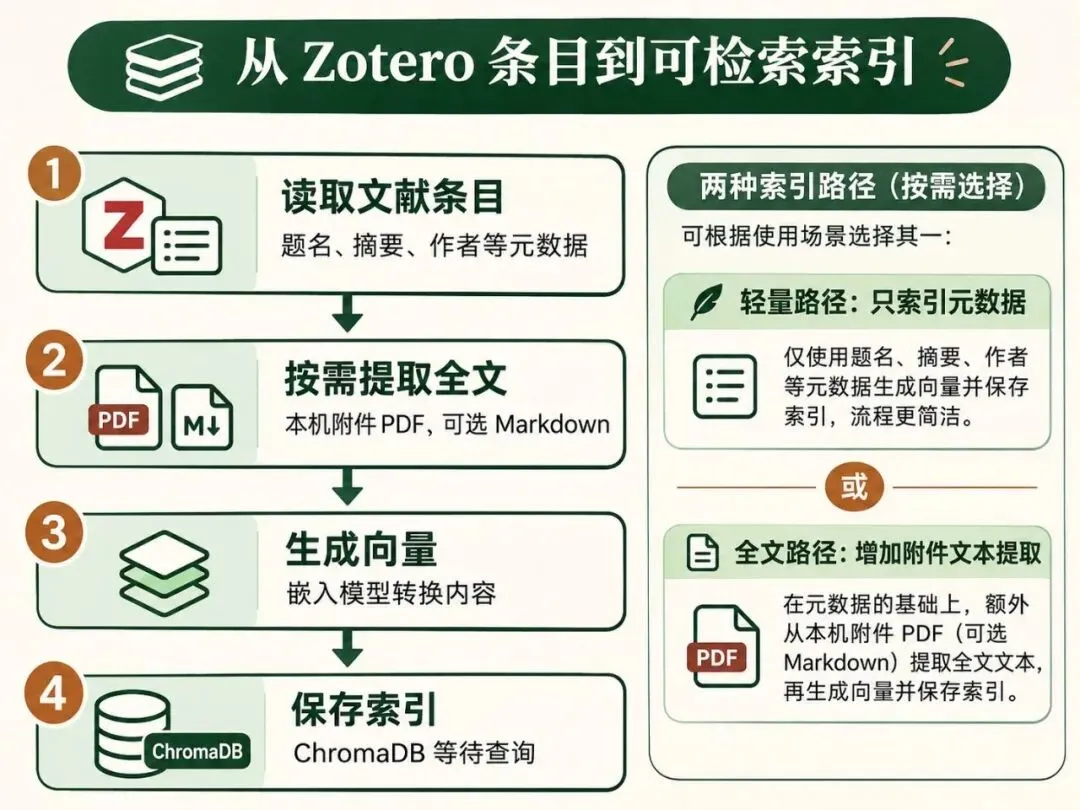
全文提取是可选步骤,先从轻量索引跑通流程。
索引可以从轻到重。先用题名、摘要等元数据建立语义索引,启动快,适合先把检索链跑通;需要查具体论述时,再从本机 Zotero 附件提取 PDF 全文。
PDF 文本可以整理成保留标题结构的 Markdown,再进入检索流程。索引时可以设定附件优先级、提取页数和是否分块;如果手头已有清理过的 Markdown,也能配置为优先读取它。
文字准备好后,系统用嵌入模型把文献内容转换为向量,存进 ChromaDB。查询时,同样把问题转换成向量,在索引里找语义相近的文献或文本片段。项目支持本地和在线嵌入方式,具体选哪一种取决于设备、隐私和质量需求;我没有把未核实的本机模型配置写成既成事实。
让 Agent 检索,再回到原文判断
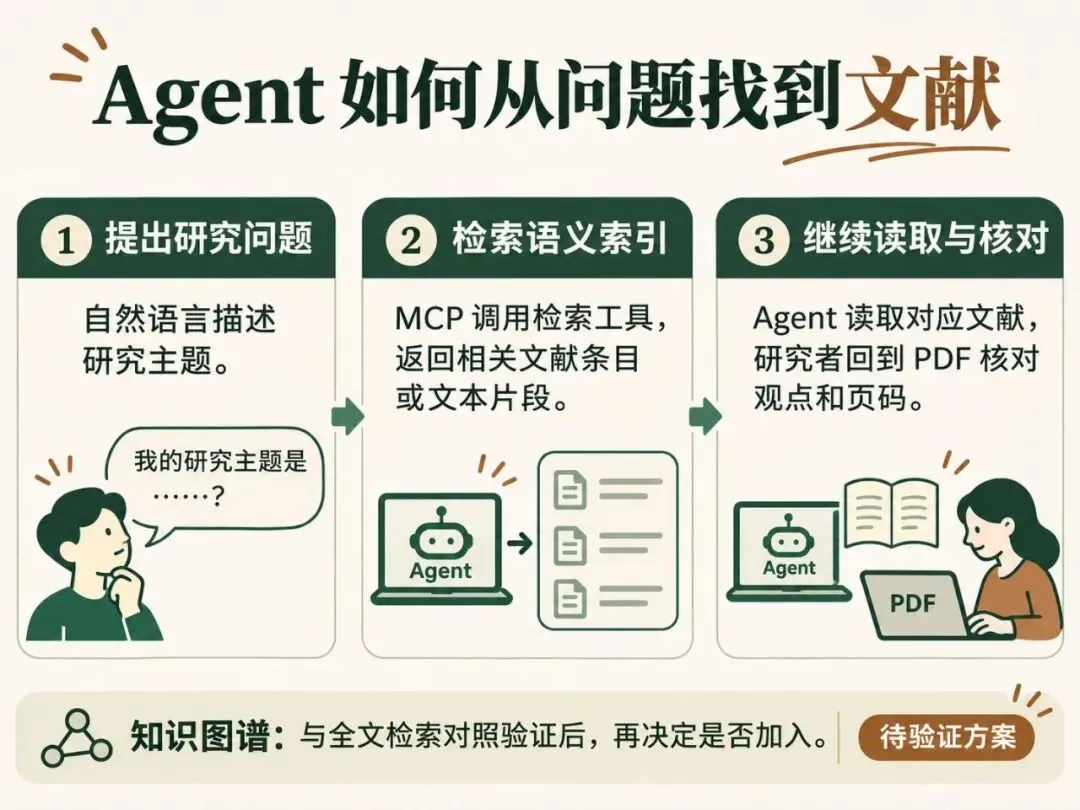
语义检索帮助找到材料,引用前仍要核对原文。
索引建好后,可以直接问:“哪些研究讨论了基层治理中的组织动员?”Agent 通过 MCP 调用语义检索,拿到相关条目后,再进一步读取全文或文献元数据。新增文献后,运行索引更新,就能把新条目纳入检索。
这里我没有把“知识图谱”直接当成已经完成的功能。仓库里的实验方案把元数据语义检索、全文分块检索、知识图谱和长上下文阅读放在一起比较,先看图谱是否真的改善跨文献综合问题,再决定要不要增加这层结构。
对研究者来说,这套流程的价值在于少花时间翻找材料,把精力留给比较观点、判断证据和形成论证。Agent 可以帮忙建索引、找论文、整理候选材料;引用观点和页码时,仍要回到原文核对。
项目地址: https://github.com/54yyyu/zotero-mcp
想要了解更多 AI 资讯?关注我,每天更新一个高质量 AI 项目。