ARTICLE · 1364005
AI 不再只会生成 Excel: Univer 想把表格、文档和计算变成 Agent 能操作的基础设施
销售打开一份报价表,指着 B2 说:“这两个席位加一下数量,顺便把利润那列重算,再给我一版汇总。”Agent 直接在表里改,公式自己重算,改错了能撤销。这和“把表格导出来丢给聊天机器人”是两件事。前者改的是一份正在被人使用的业务文件,后者只是生成一份新的。差别不在模型能力,在文件这一侧有没有可操作的接口。
一、导出再上传,断在三处
把业务表变成 xlsx,传给模型,让它算完回答——这条路径走不通的地方很具体。
公式断了。模型只会给一个数字。原来的 =B2*C2 变成了硬编码结果。下次数量变了,这张表不会再自己重算,它已经退化成一张静态截图。
结果回不去。答案在聊天窗口里,用户还得复制粘贴回 Excel。谁改的、改了哪几格、原来是什么,没有记录。
上下文丢了。哪个工作表、哪个口径、哪个版本,模型看到的只是一个被拍平的文本块。业务表里的合并单元格、数据验证、条件格式、筛选范围,在导出的那一刻全部消失。
这三处指向同一个结论:业务文件不是内容,是有依赖关系、有历史、有权限的运行状态。一次生成解决不了它。
二、Univer 的定位是 SDK,不是生成器
Univer 是一个 Office SDK,用来把表格、文档、演示、关系表和 PDF 做进自己的产品。它分三层:
开源仓库(Apache-2.0)给的是 Web SDK 的架构与引擎:内容模型与快照格式、插件与依赖管理、命令系统、公式与渲染引擎、Facade API。商业插件和 Server、AI SDK 扩展单独授权——这个边界要看清,下面说的能力以开源核心为准。
关键一点:Agent 用的是和应用同一套公开 API,没有另做一套“AI 专用接口”。官方报价表示例不依赖 AI SDK,纯应用代码就能完成编辑、计算、保存。
三、Facade API:修改有明确的对象和边界
Facade API 是面向应用的接口层,把 Workbook、Worksheet、Range 包成 FWorkbook、FWorksheet、FRange。写一次报价单只需要几行:
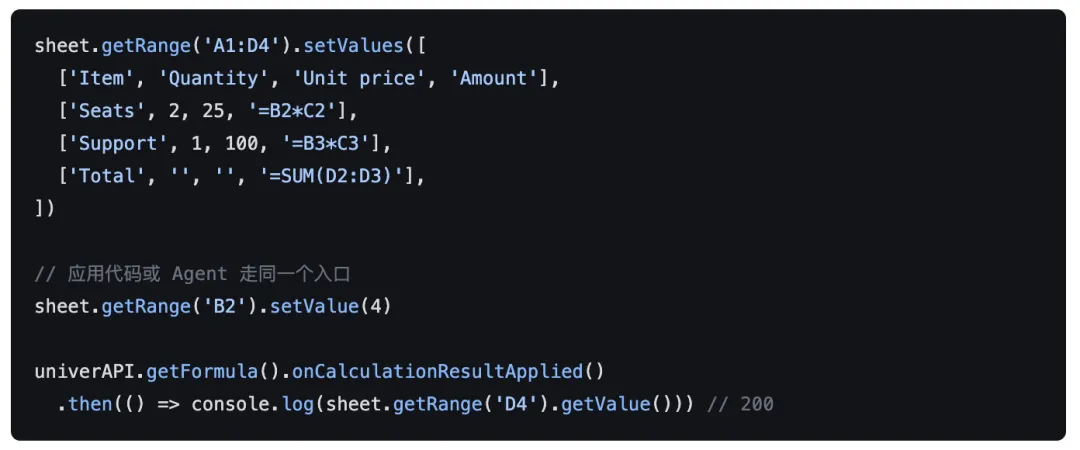
这段代码里有两件事值得注意。
写进去的是公式,不是结果。Agent 改数量,不是自己算出新总价再覆盖,而是改 B2 这个输入,让公式引擎重算。业务口径留在表里,下次换个销售打开,表还是活的。
结果是可等待、可验证的。onCalculationResultApplied 之后才读值。这意味着 Agent 可以不靠猜就确认“我改完,重算完了,这是新数字”。一次性生成文件做不到这一步——它生成完就结束了,没有回读。
配合 workbook.save() 拿到 JSON 快照,持久化交给应用自己管。表格状态可以被保存、恢复、比对,而不是一个二进制黑盒。
四、真正难的是“可控”,不是“生成”
Univer 的命令系统把动作拆成三类,这个划分解释了为什么可控修改比生成难得多:
Mutation 参数可序列化,是 Agent 场景里最重要的一条。它意味着每一次改动都能被记录、回放、审计——不是“AI 改了点什么”,而是“执行了哪个 mutation、改的是哪一格、原值是什么”。
一次动作会牵动多个功能。在筛选范围内插入一行,基础内容变了,筛选范围也要跟着变。两个功能各自提供正向和反向 mutation,Command 把它们合成一条撤销记录。用户按一次 Ctrl+Z,两处一起还原。
这一点直接对应 Agent 的风险:它一次改动往往跨多个功能,人工操作时靠直觉,Agent 操作时必须靠这套组合机制才不会留下半改状态。
拦截点就是护栏位置。BeforeCommandExecute 可以检查甚至取消一次执行,CommandExecuted 事后通知。让 Agent 只能改 D 列、不能删行、不能动公式区域——这类规则有地方挂,而不是写在 prompt 里求它别乱来。
五、公式引擎是 Agent 算术和业务口径的分界线
“让 Agent 算利润”听起来是模型的事,实际不是。
如果模型自己算,它给的是一个数字,对错无法复现,口径无法交接。如果 Agent 把利润写成公式,计算由引擎执行,那么:口径在表里、结果可复算、错了能定位到具体那一行。
模型负责理解“利润等于售价减成本再减平台抽成”,引擎负责每次都用同一个规则算。这条分工线,是把 AI 从“会算数的助手”变成“能改业务文件的组件”的前提。
六、Headless:Agent 不必打开浏览器
同一套内容模型、命令和计算可以在 Node.js 里复用,不需要交互式编辑器。这带来几个实际用法:后端批量处理、CI 里跑表格规则检查、Agent 在服务端读取并修改文件再交付。
对 Agent 来说这点很重要。它不该为了改一个单元格去驱动一个 GUI——那正是上一篇聊到的截图加坐标方案的成本来源。有 Headless 接口,表格操作就是函数调用,不是界面自动化。
七、说清边界
授权分层。核心仓库 Apache-2.0,但商业 Web SDK 插件、Server SDK、AI SDK 扩展单独分发。协作、历史、xlsx 导入导出这些能力,不在开源范围里。
扩展点没有稳定性承诺。官方明确区分公开 Facade API 与内部实现,依赖扩展点前要看 API Stability Policy。
它提供能力,不提供 Agent。Univer 不会替你决定 Agent 该改哪一格。模型和工具编排仍然是你的事——这也是它文档里反复强调的一句。
生成一份文件是一次交付,改一份正在用的表是一次服务。
Agent 要进入业务,缺的从来不是更会写表格的模型,
而是一层能让它安全、可撤销、可审计地动手的文件接口。