ARTICLE · 1400247
做了一个 Chrome 插件,两步法反推提示词
最近做了一个 Chrome 浏览器插件,叫传彩笔(CAIBI,Chrome Asset & Image Breakdown Inspector)。平时在网页上刷到喜欢的图,它可以帮助你顺手拆出提示词,用生图模型试试尝试复刻。
这个小工具走的是“发散—聚合”两步法,先让模型把画面描写得足够细,再把文字收拢成自然语言提示词。当然,光靠文字怎么也写不清一张具体的人脸,就补充了人物资产图提取和漫转真人捏脸的垫图功能。
01
PART
灵感来源
INSPIRATION
做 CAIBI 之前,我参考过付费提示词反推插件 Viko。它的功能很完整,主打提示词经验复利。我看不到 Viko 的内部工作流,只能从跑出来的结果去猜。它的条目设计明显偏重写真类图像,遇到设计感强的海报或者信息图,就会漏掉不少关键元素。
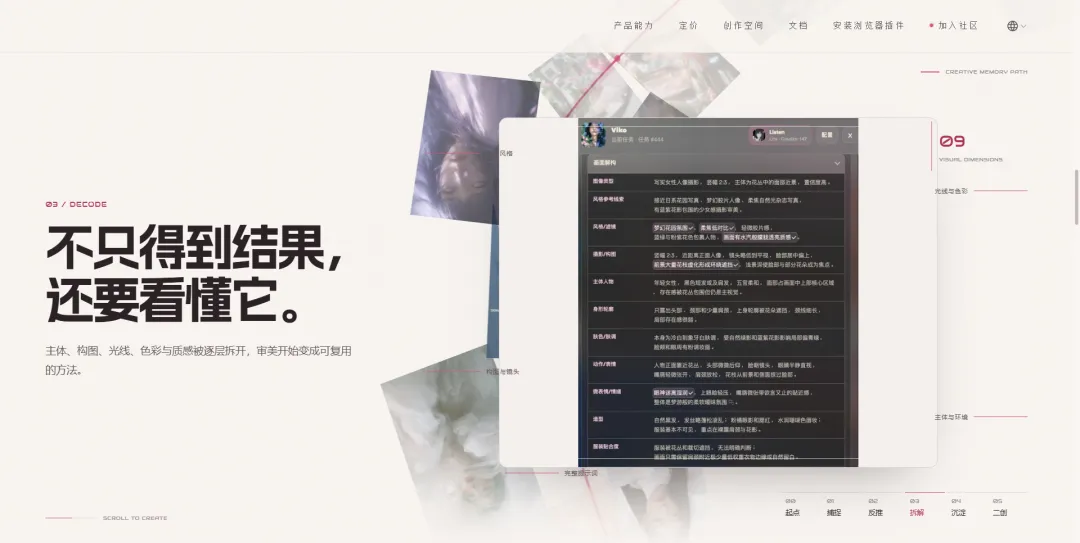
轮到动手写工作流,我还是延续了做 Bokemon 时的思路。先发散,后聚合。
我之前看过一版反推提示词(来自博主 @宝玉),内容很简单,是让模型自由写 JSON 字段,没有细致规定模型的关注点。这段提示词的优点是相信模型能力,不会成为优秀模型的负担,但真碰到构图复杂或者跨品类的图,单步直出很容易顾此失彼(后面会有具体对比案例)。
我把这件事拆成了两步:Agent 1 负责读图,先把能描述的“键”全列出来,再照着每个键把对应的“值”写细;接着交给 Agent 2,在(尽量)不丢信息的前提下,把整份 JSON 提示词改写成自然语言段落,可以缩减一些字符数。
另一条灵感来自博主 @南鸢 nuyoah 分享的人物资产图布局和拿漫画角色捏脸的玩法,我觉得挺有意思,就顺手写了两段不算长的提示词,放进插件里当独立的垫图辅助。
02
PART
反推提示词两步法
METHODOLOGY
两步法核心设计思路
Agent 1 和 Agent 2 的完整提示词太长,你可以去 GitHub 仓库下载查看,这里只写一下几点想法。
第一步交给 Agent 1 做发散视觉解构。我先给它定了 7 个固定基础键,分别是画幅比例、主体、风格媒介、构图机位、光影氛围、色板和细节肌理。
但光有这 7 个键是应付不过来各种图片的,所以我要求模型像电影里的“雨人”那样,从头到脚分区域把整张图扫一遍,再按画面复杂度动态追加细分键。画面有遮挡就加前景遮挡,有字的海报就加文字排版和原文抄录,遇到插画就加全局构成法则,尽量做到千图千方。
怎么往键里填值,直接决定了复刻结果像不像。
我之前记过一条 flomo 笔记:
FLOMO
NOTE科塔萨尔写过《关于上楼梯的指南》,这就是文生视频提示词给我的感觉。
下面引用的是范晔的译文,我放上一段,供你品鉴:
EXCERPT
范晔 译……上楼梯时一般应面对楼梯,因为侧身或背对楼梯进行将产生相当程度的不适。正常的做法是采取站姿,双臂自然下垂,抬头(但不要过分抬头以至于眼睛看不到下一级台阶),呼吸须平缓而规律。上楼梯应从抬起位于身体右下方的部分开始,该部分一般会被皮革覆盖,除个别情况外其大小与台阶面积吻合。该部分(为简便起见我们将该部分称作脚)安置在第一级台阶上之后,抬起左边对应的部分(也称作脚,但请勿与此前提到的脚相混淆),将其抬至与脚相同的高度,继续抬升直到将其放置在第二级台阶上,至此,脚在第二级台阶,同时脚在第一级台阶。(最初的几级台阶通常最为困难,在熟悉了必要的配合后情况将好转。脚与脚的重名也为说明造成了困难。请特别注意:不要将脚与脚同时抬起。)
你可能没有读完,就像我们对提示词的态度一样。
为了启发 AI 把图中动作拆到毫厘,我把这篇小说名写进提示词,让 Agent 1 照着这个路子写,把空间方位、遮挡关系、材质接缝和光影边界全写成可见事实,目标是让一个没见过原图的人照着文字去画,也能画到几乎分不出差别。
为了避免模型偷懒概括,我另外加了两条要求:一是,画面里能看见的字不管大小,都按原文逐字抄录并标明版面位置,不许自己改写。二是,要求前景、主体和背景统一用同一套造型或媒介质感,免得局部退化成普通画风。
还要把前端算出的主色彩和明度数据接到提示词里,后面聊到插件界面时会再提到。
到了第二步,就不需要 Agent 2 看原图了。它只拿 Agent 1 生成的 JSON 提示词,加上原图的画幅比例,把它们重写成一段中文自然语言提示词。这一步不设字数上限,也让 AI 概括。原图里的文字一字不漏留着,靠拿掉虚词、连接词和重复主语来省字符,电报体。
写完之后,还要让 Agent 2 站在下游生图模型的视角检查一遍,确认画面没有歧义再提交。
实测效果一览
说得很好,不如用两个有区分度的难题试一下。
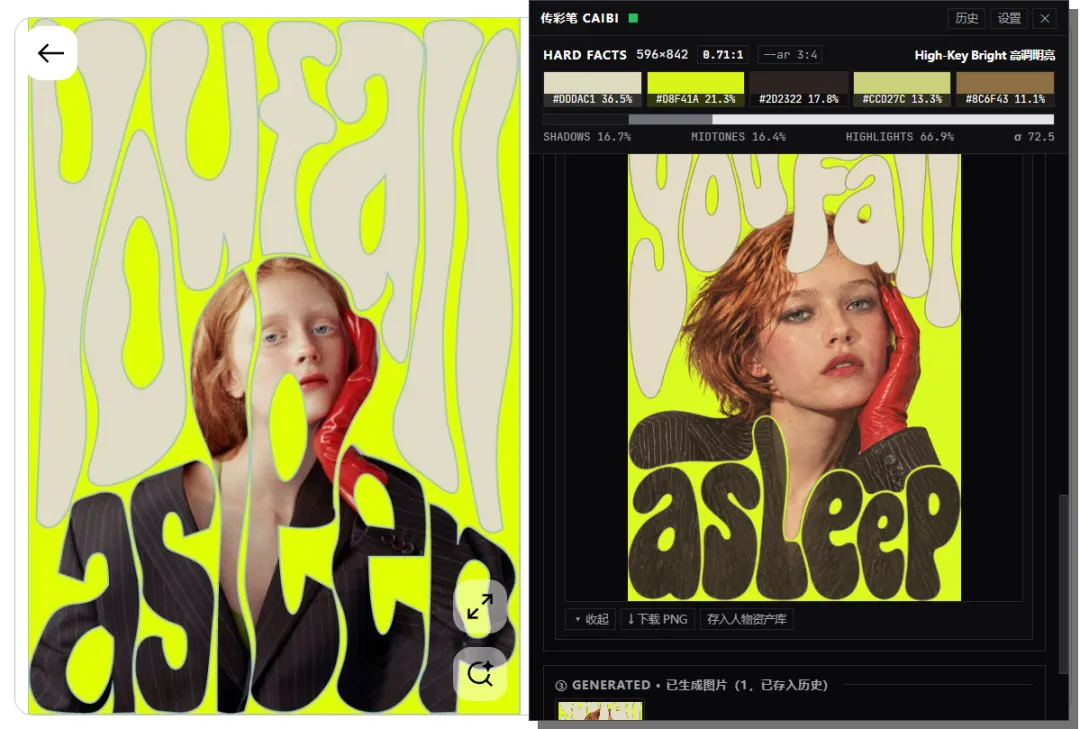
第一张测的是海报,上面写着艺术字——“you fall asleep”。跟普通写真照片跑出来的 JSON 对比一下,能看出 Agent 1 在两类图上抓到的重点完全不同。
图片中荧光黄绿底色、上下两行变形液态字体、条纹西装,还有托住左脸的那只亮面红皮手套,全都被留了下来。不过,面部特征的差距的确有些大,比如肤色、眉形、眼影和发质。
我后面还会提到生成任务资产图的功能,别急。
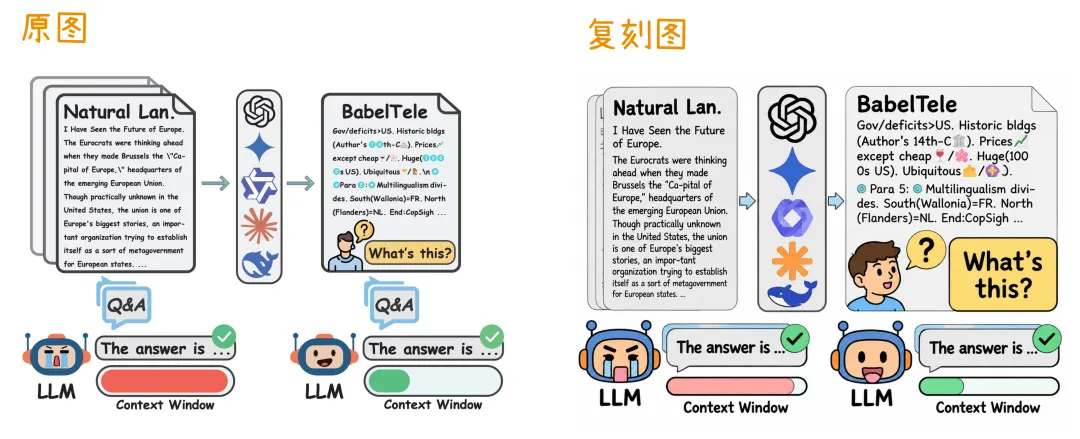
第二张则是文字和图标更密的信息图,图源是论文 “Large Language Models Do Not Always Need Readable Language”arXiv 论文,讲的是自然语言经过 5 家大模型压缩成“BabelTele”的过程。左边那整段英文原文、右边的符号缩写,甚至底部一哭一笑两个机器人的进度条,都基本对得上。
横向对照
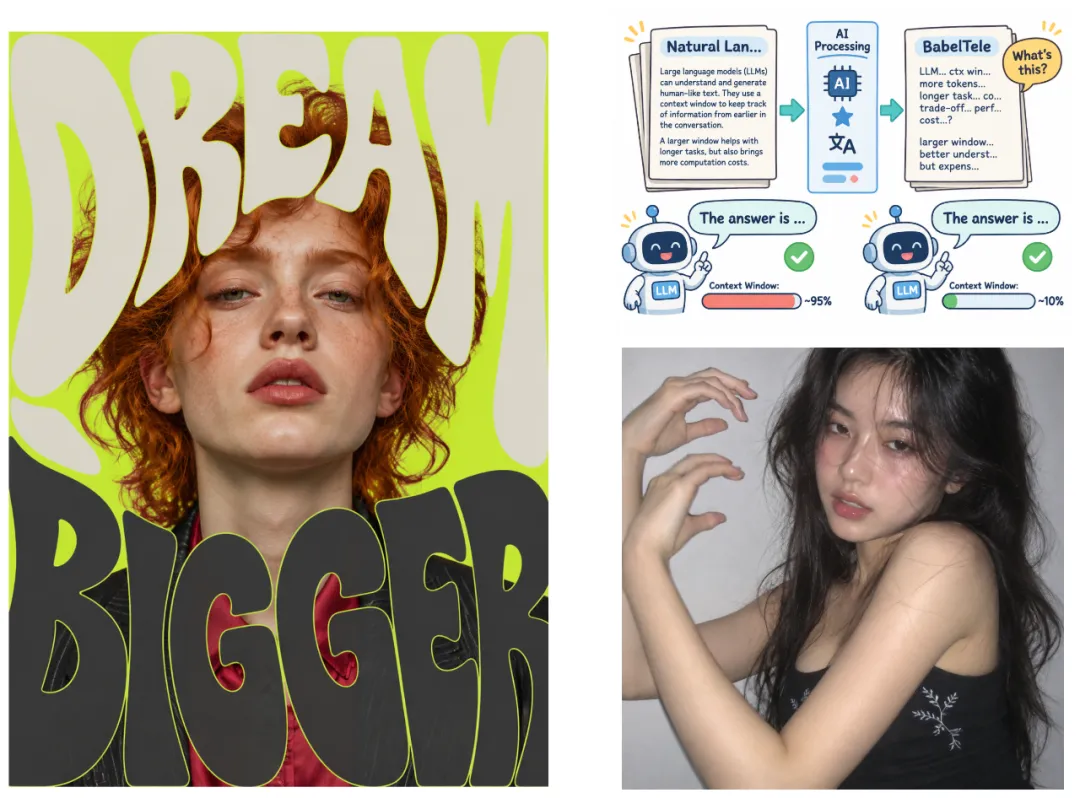
光看自己的结果不够客观,我把海报、信息图和一张人像写真(AI 生图)放在一起,用 Viko 跑了一遍对照。
Viko 的条目偏向写真人像,遇到复杂海报和信息图就有些水土不服。海报里的红皮手套没了,英文被改成了不相干的“DREAM BIGGER”。信息图左侧的真实测试段落被概括成套话,中间 5 个模型 Logo 无一幸免,底下两个机器人也一并挂上笑脸。
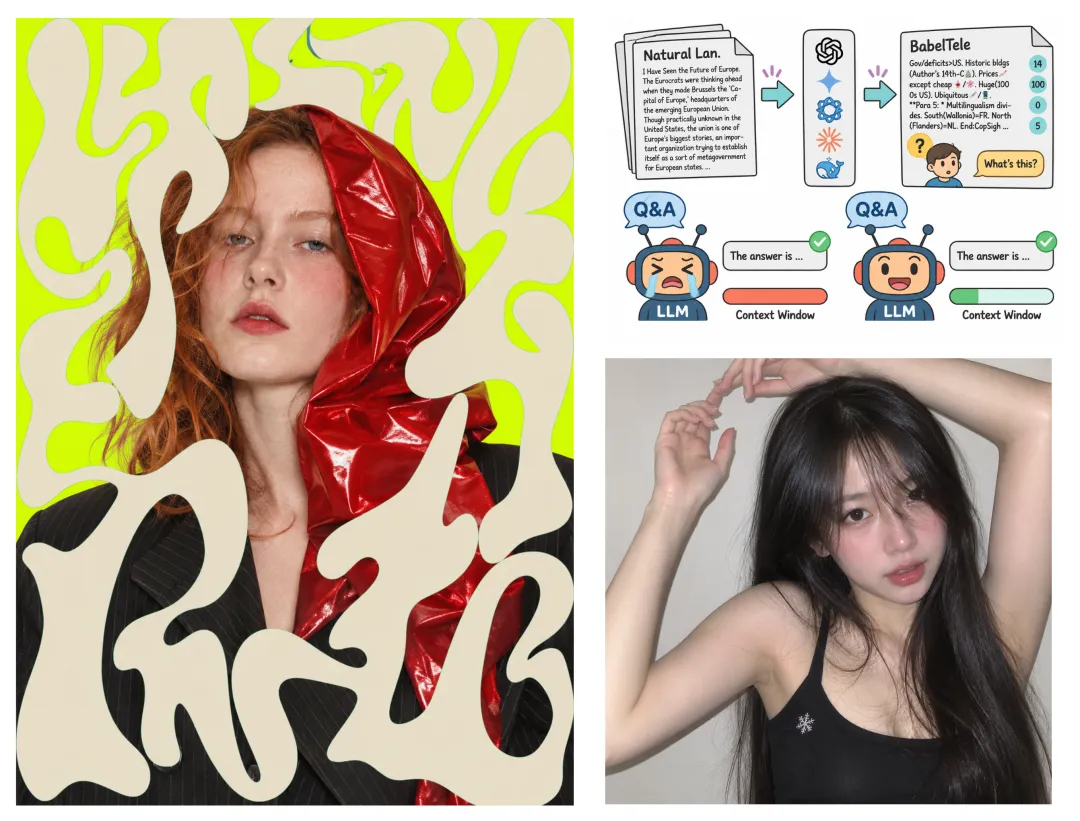
我也拿自己平时常用的简单反推提示词(来自博主 @宝玉)测了同一组图。
提示词很短,就下面这一段:
Provide a detailed and comprehensive JSON prompt describing all aspects necessary for accurately replicating the original image. Include specifics about objects, clothing, hairstyles, intricate details, accessories, photographic equipment, environment, lighting, style, body poses, and any other relevant elements, ensuring that every detail of the original image can be precisely recreated.
这段提示词让 AI 自己看图写 JSON,右上角信息图的排版和文字还原其实相当不错。可到了左边的海报上,红手套变成了小红帽,文字也变成了没意义的白色花纹,看着依然挺时尚,但不是复刻。可以看出两步法工作流虽然冗长一些,但在不同场景中表现更为稳定。
03
PART
垫图!垫图!垫图!
REFERENCE
回看前面的对比图,其他细节都复刻得八九不离十,就是人脸差距还是很大。语言天然描述不清具体的面孔,但人脑却最擅长分辨它们。
当然,也有人钻研过如何做面部提示词,锲而不舍、钻木取火的精神令我动容——怎么给眉形分成 15 种,怎么把妆容用 50 个字写清楚,但在我看来性价比不高,这些细节上“一图胜千言”不算夸张,何况很多人反推提示词的就是为了换上自己的脸。这种努力好像成了没有必要的执着,以史为鉴的话,照相机发明以后连小说家也不再在这个方向上努力了。
之前听《日谈公园》聊模拟画像的一期播客小宇宙,里面有个细节让我印象很深。林宇辉警官说,目击者往往用嘴形容不出嫌疑人长啥样,他就会反过来启发对方,“想想这个人长得像哪个明星或演员”,这跟我们用 AI 生图时说的垫图其实是一回事。
标准角色设定集
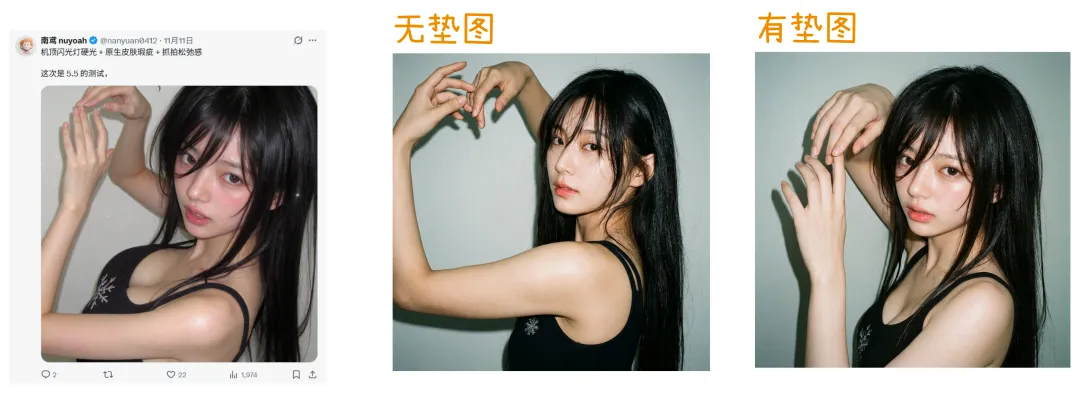
于是我在插件里加了人物资产图提取功能。测试图用的是博主 @南鸢 nuyoah 分享的一张 AI 生成的图片,左边是原图,中间是没垫图的生图结果,右边是先提取人物资产图再垫图的对比。
这段提示词也很短,可以直接附在下面。
画面按 16:9 左右平分,左半边放正面和背面全身照时,特意要求把正面全身的头部打码模糊,右半边再铺满大尺寸的高清脸部特写。这么做是为了防止生图模型在垫图参考时,被全身照里不够清晰的小脸带偏五官。
角色设定集,画面比例 16:9,画面左右平分。保持与参考图为同一人物,脸型、五官形态、发型、服装与体型一致;表情统一为中性放松,站姿自然。左半边:并排展示人物的正面全身(头部打码模糊)与背面全身。右半边:铺满大尺寸的四分之三侧面脸部高清特写。整体为纯中性灰影棚背景,柔和均匀平光,无强烈阴影与刺眼高光。
跨次元捏脸
另一段提示词同样受 @南鸢 nuyoah 的玩法启发,直接把动漫角色转成真人角色设定集。用这种跨次元方式捏出来的真人脸,往往骨相清奇,很有辨识度。
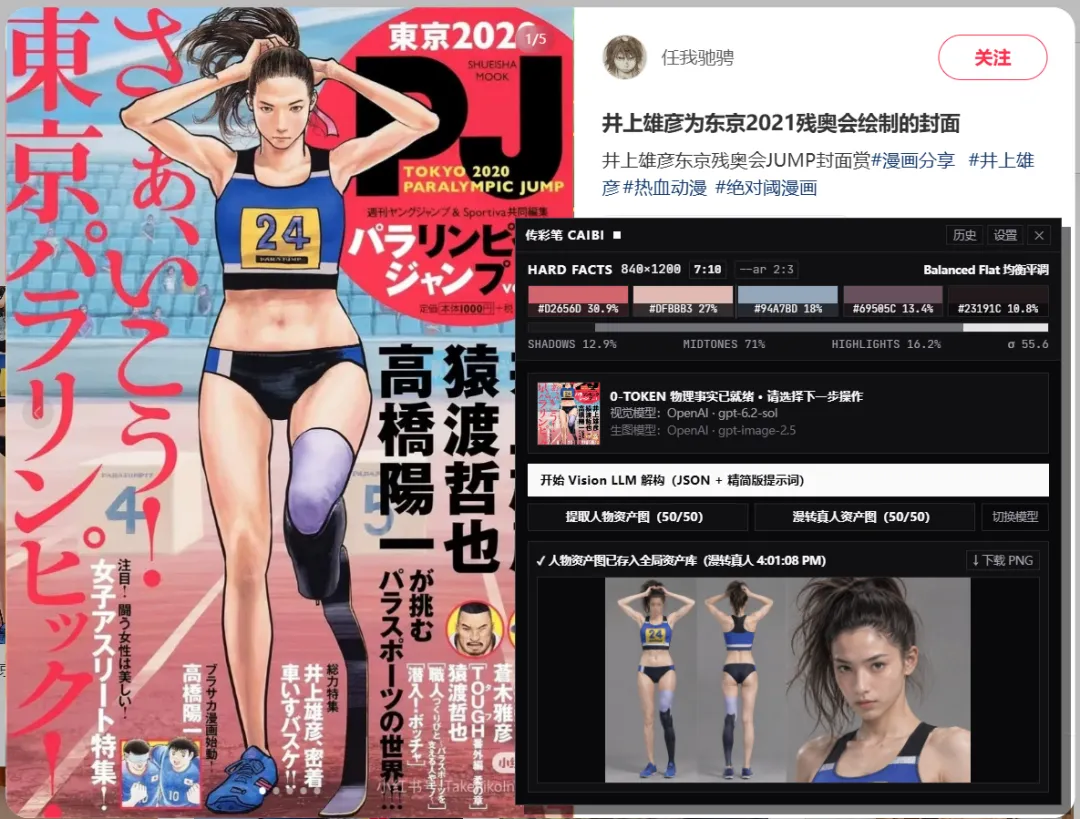
这段漫转真人提示词原文也附在下面:
将参考图中的动漫/漫画角色直出转化为真人摄影级角色设定集,画面比例 16:9,画面左右平分。左半边:并排展示真人化后的正面全身(头部打码模糊)与背面全身,保留原角色服装造型并转化为真实织物面料、剪裁与垂坠质感。右半边:铺满大尺寸的四分之三侧面真人脸部高清人像特写(85mm微单直出质感)。严格保留原角色的发色、发长、刘海走向、翘起碎发呆毛与发束层次,以及眼型、眉形、唇形等五官形态与气质,不要重新设计,面部表情统一为中性放松;五官转化为真实人类骨骼比例,剥离夸张二次元画风特征;还原真实自然人类肤色(剔除原画环境色染色,皮肤具真实毛孔、细小绒毛与自然明暗过渡,不磨皮),发丝根根分明带自然毛躁。整体为纯中性灰影棚背景,柔和均匀且有方向感的影棚主光,高光不过曝,暗部保留细节。避免:二次元插画感、塑料假人感、过度美颜、涂色皮肤、杂乱背景、改变原角色发型与五官形态。
04
PART
插件操作指南
GUIDE
前面讲的两步法反推和两段人物资产图提示词,我写进了 Chrome 插件里。下面演示一下用法:
第一步 触发面板并读取图片元信息
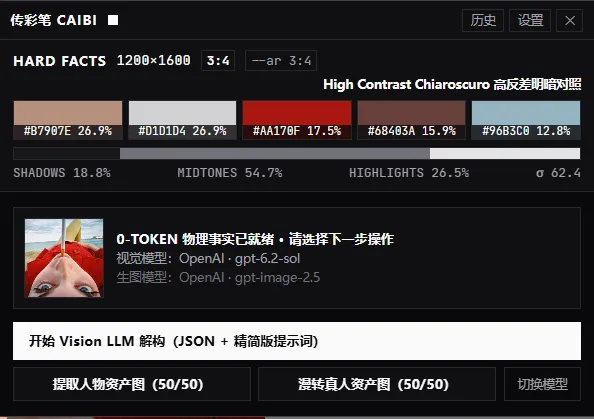
装好插件刷新网页,把鼠标挪到图片上,点一下右上角浮现的 [+] 按钮就会弹出面板。
插件会先在本地计算,把 5 个主色板的 Hex 色值与面积占比、阴影明度分布和画幅比例提取出来。这一步停在待确认状态,不花任何 API 额度。等到后面点击编译时,前端算出的色板和明度分布会一起送进 Agent 1,但不把原始百分比在提示词写死。
第二步 配置 API 接口
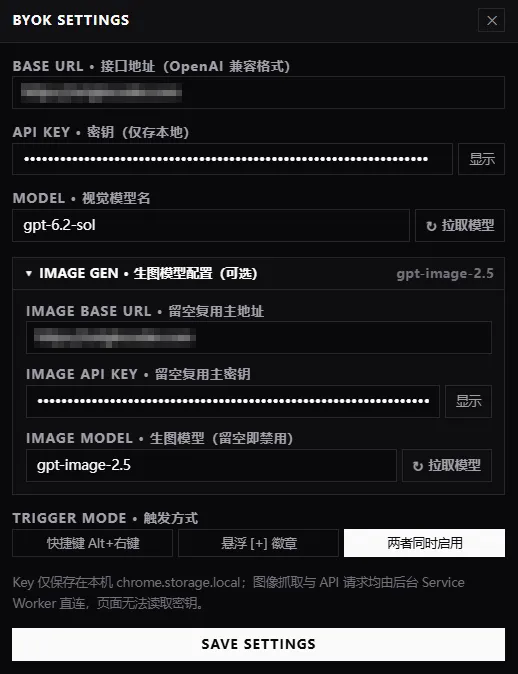
点开面板右上角的“设置”,可以配一个多模态语言模型和一个生图模型。生图模型是可选项,也可以不配。只配语言模型照样能反推出完整提示词,直接复制出去贴到常用的生图工具里就能用。我这次测试分别配的是 gpt-6.2-sol 和 gpt-image-2.5。
第三步 反推提示词并生图
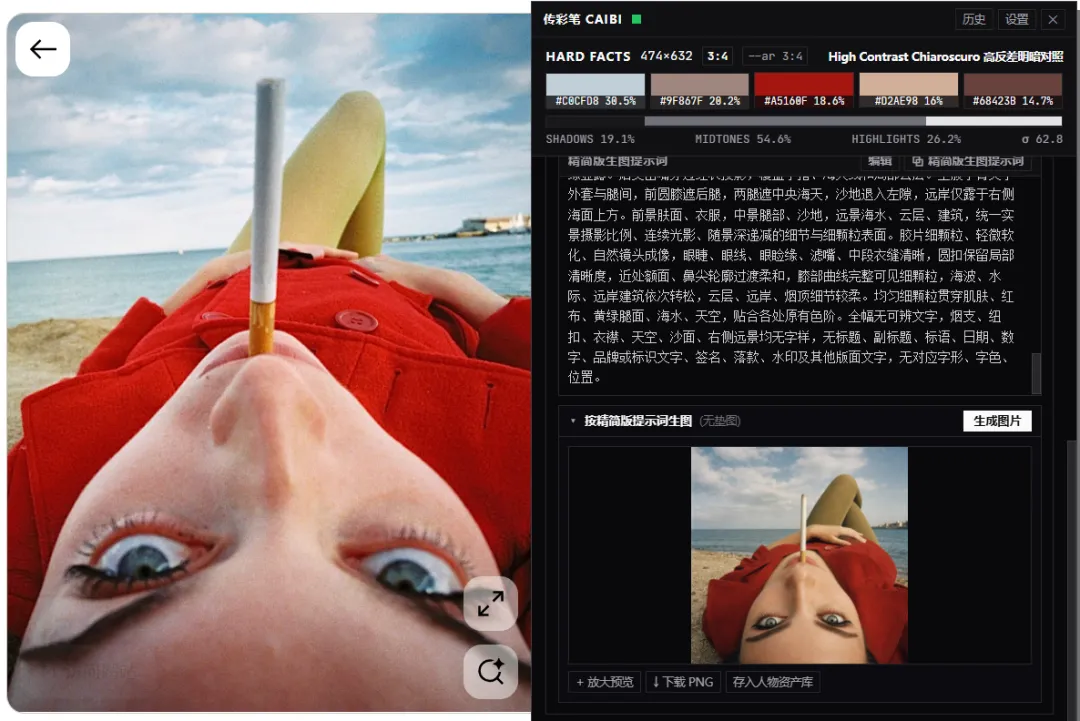
点下运行按钮,插件会依次跑完 Agent 1 和 Agent 2,输出 JSON 版和精简版两份提示词。因为是两步串行处理,耗时会长一些。如果配了生图模型,跑完直接点下方的“生成图片”,就能在当前网页原地看到效果。
整个插件的代码和提示词都整理放在了 GitHub 仓库 Joffoo/CAIBI。