ARTICLE · 1033478
RAG 答不准,先别调模型:文档在「读进来」那一刻就错了
很多人做 RAG 答不准,第一反应是「答不准就调模型」——调提示词、换 Embedding、改 Top-K,调来调去还是老样子。问题多半不在模型:文档读进来的那一刻,错误就已经发生了——脏数据不会被算法救回来,只会被算法精确放大。
这篇只讲两件事:加载和清洗。各自的原理、最容易出错的地方,以及做完之后怎么核对。
unsetunset一、加载:不是把字抠出来,是把关系留住unsetunset
加载干的事,是把 PDF、Word、网页这些格式不同的文件,读成一段能被模型处理的文本。难点在于,每种文件坏的地方不一样:
PDF:双栏排版容易读成串行,页眉页脚混进正文。要看阅读顺序有没有乱。 表格:数字都读到了,行列关系丢了,参数从此张冠李戴。要看表头还在不在。 扫描件:直接读出来是空的,要确认是不是一片空白。 网页:导航、脚本、广告比正文还多。要看正文有没有被噪声包住。 Word:段落和表格顺序容易乱,图表说明跟正文分了家。要看表格有没有被挪到文末。
例如有以下表格:
不经过特殊处理,读出来是一串这样的字符串「产品A 12 个月 2 个月 产品B 24 个月 3 个月」——数字一个没少,列名没了。这时候问「产品B 的保修期是多久」,手上只有两个以「月」为单位的数字,只能猜,猜错就是把供货周期当成了保修期。
所以加载做没做对,不看有没有读到字,看原文里的关系还在不在。
那怎么读?比如常见的做法是分级,能力不够就降一级:
优先:MinerU,排版、表格结构、图文对齐都能还原,适合正式文档。 次级:pdfplumber 取表格文本、PyMuPDF 取图片,表格还能保住,图文对齐的精度会掉。 兜底:pypdf,只保证有文本,结构不用指望。
分级的关键不是用哪个工具,是知道每降一级会丢什么。
扫描件不走这条链——它没有文字层,任何解析器都读不出内容,必须先过 OCR。还有一件事要在加载阶段做完:编码统一,乱码在这里拦下来最省事,留到清洗会连累后面的判断。
加载的产出不止文本。读完一份文件,结果至少要有三样:
正文:文本本身,以及表格的内容。 来源:文件路径、文件名、文件类型,以及能区分同名文件的标识。 附件:图片存在哪里,以及能取到的页码。
后面的清洗、排查、追溯,靠的都是这三样。
图片还要单独说一句。它从文件里取出来到最后被用上,中间要过四步:保存到目录、在正文里写上链接、登记进附件列表、传给需要它的任务。
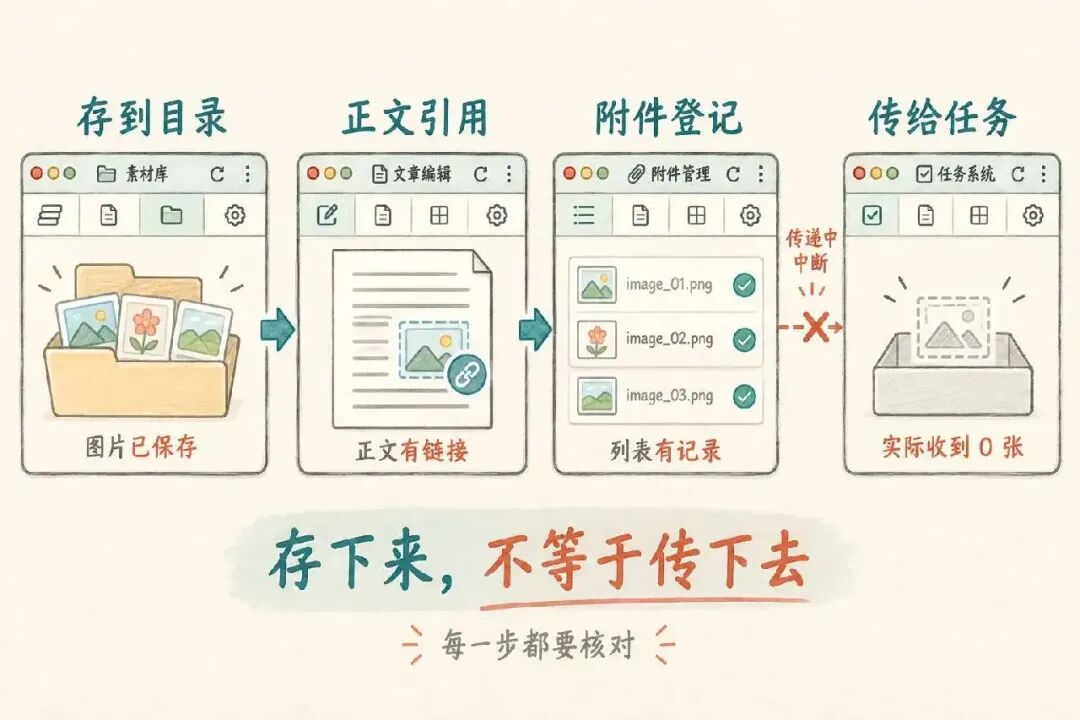
前面成功不代表后面拿到——附件列表空着,后面的任务又只从这个列表读图,已经存好的文件就漏掉了。
存下来,不等于传下去。
unsetunset二、清洗:删噪声容易,不碰正文难unsetunset
清洗只干一件事:把不是正文的东西拿掉,同时不动正文。难的是后半句。
要清的通常是五类:
空白和特殊符号:零宽字符、多余空行、异常空格。 页眉页脚水印目录:它们每页重复一次,会跟着正文被切进块里,检索时反复被命中。 重复段落:同一段内容出现多次,等于在检索里给它加了权重。去重按内容比对,不是按文件名。 断句和乱码:强制换行把一句话切成两半,语义就断了。 全角半角不统一:同一个词两种写法,检索匹配不上。
该不该删,看的不是形式,是用途。 网址可能只是无关链接,也可能是业务入口;缩进可能只是排版噪声,也可能是代码结构。同一个东西,在不同文档里是两个身份。
顺序也讲究:先确认正文范围,再删噪声,最后规整格式。反了就麻烦,格式一规整,特征就没了,想按特征删噪声会更难判断。
清什么多数时候不难判断,出事的往往是「删得对不对」。举一个最常见的,清理页码的规则如果写成这样:
页码[::]\s*\d+\s*/\s*\d+.*
末尾那个 .* 再配上 re.DOTALL,就会跨过换行——一路把后面的正文吃掉。文件确实变小了,程序也没报错,丢掉的却是正文。
同类的事还有:统一格式的规则套在代码和列表上,缩进和层级没了;脱敏按数字长度匹配,正常业务编号被一起替换。
所以每条规则上线之前,准备两个样本:一个该删的,一个长得像但必须留的。 能命中只证明它能删,没有误伤才说明它适合用。
unsetunset三、做完怎么确认unsetunset
四个看起来没问题的信号,都不能当成功:
文件变小了:不知道删掉的是噪声还是正文。抽几段跟原文比对。 程序没报错:跑完了不代表读完了。看结果里有没有半截句子。 报告说「全部成功」:成功只表示程序没崩。扫描件没做 OCR,读出来是个空壳,输出空文件也算成功。翻一遍成功列表里最短的那几个。 有脱敏记录:记录是操作次数,不证明漏的没漏。拿几个正常编号去搜一遍。
一句话:流程跑通,不等于内容是对的。 清洗之后再看一遍文本——变短不等于变干净,删掉之后还能用,才叫干净。
加载和清洗这两步做扎实,检索才有干净的东西可查:加载要读全,清洗要有边界,做完要能核对——这三句守住,你的库就干净了大半。
你踩过哪一种?表格答错、检索回来一堆页眉,还是图片白提取了? 评论区聊聊,也给后面看到的人留个参考。
下一篇讲分块:文本洗干净了,切多大、在哪儿断,才决定检索命中的是整句,还是半句。