ARTICLE · 1040982
这是一个能让 AI 助手省 99% token的利器
说实话,用 AI 编程助手(Claude Code、Cursor、Codex 这类)干过正经活的人,多半都撞过同一堵墙:
你让它"看看这个项目里认证是怎么处理的",它不会魔法,它得先去 grep。grep 是命中了几个文件,可它不敢只看那几行——万一同名、万一引用分散?于是它把命中的文件整个读进上下文。一个几万行的老仓库,光"找答案"这一步,就能烧掉几万甚至十几万 token。
钱是一方面,慢是另一方面。更气的是,有时候查了半天还没查到点子上。
Semble 就是冲着这个痛点来的。
一句话说清:Semble 是什么
Semble 是 MinishLab(就是做 Model2Vec 的那个团队)开出来的代码搜索库,专门为 AI 编程助手设计。
它跟你自己 grep 最大的区别在于:你不用"猜文件再读文件",而是直接用自然语言或代码去问,它把命中的代码片段直接甩给你。
semble search "How is authentication handled" ./my-project一下午能省下的事:不用自己抓 grep 结果、不用整文件读上下文、不用在无关文件里翻。它只回相关的那些代码块——根据官方基准,比 grep+read 省了约 99% 的 token。
而且它快得离谱:索引一个普通仓库端到端不到一秒,单次查询毫秒级,全程跑在 CPU 上。 不需要 API key、不需要 GPU、不需要连任何外部服务。
它到底解决了哪三件事
拆开看,Semble 精准打击的是三个老问题:
1. 省 token(省真金白银) AI 助手按 token 计费。grep+read 的玩法是"搜 + 读整文件",Semble 是"直接给你命中块"。官方数据是同召回率下约省 99% token——对用 Claude Code、Cursor Pro 这类按量计费、或者上下文有限的人来说,这是实打实的成本差异。
2. 提速 让模型自己 grep+读,来回要好几轮;Semble 是本地建好索引、一次查询毫秒级返回。整个查找过程从"分钟级"掉到"毫秒级"。
3. 提质 光快没用,得准。它不靠关键词硬碰,而是语义+词法双路召回再重排,把"定义某符号的那段代码"顶到最前面,而不是给你一堆引用。
工作原理:4 个步骤,快在哪里
很多人一听到"语义搜索"就以为要上大模型向量库、要 GPU。Semble 反着来,全链路本地 CPU:
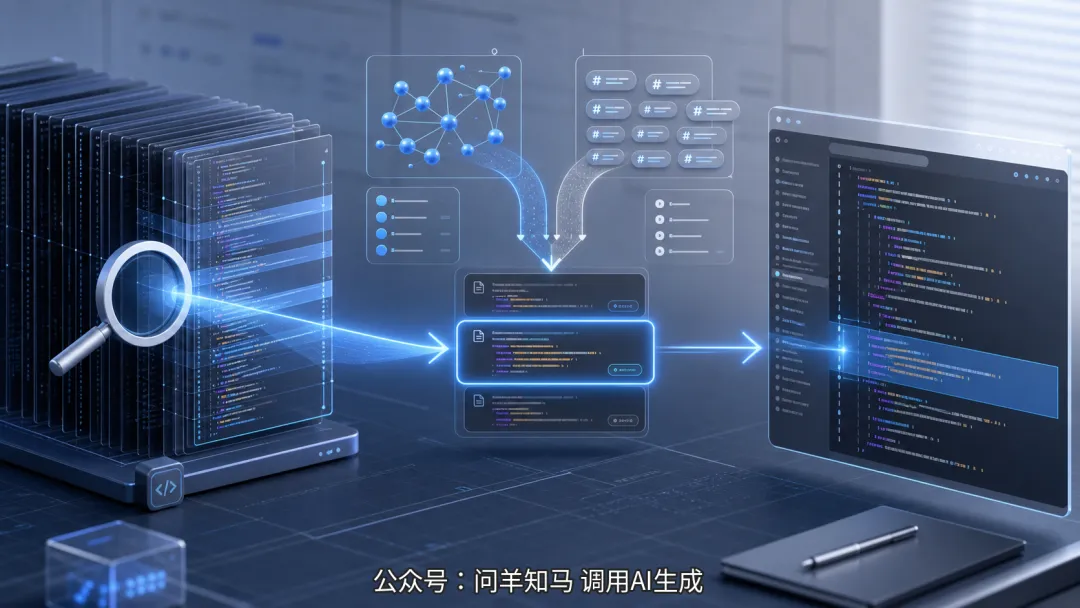
切块:用 tree-sitter 按代码结构把每个文件切成"代码感知"的块(不是按行数瞎切)。 双路召回:一路用静态 Model2Vec 向量(基于代码专用的 potion-code-16M-v2模型)做语义匹配;另一路用 BM25 做标识符、API 名的词法匹配。融合:用 Reciprocal Rank Fusion(RRF)把两路结果合并。 重排:再加一套代码感知信号——符号型查询加大词法权重、定义块优先、标识符词干匹配、同文件多块命中加分、测试/legacy/示例代码降权。这样命中的"定义处"会浮上来,噪声会被压下去。
关键点:embedding 是静态的,查询时没有 transformer 前向计算,所以才能在 CPU 上毫秒级跑完。这是它和那些"每次查询都要过一遍模型"的方案在根子上的区别。
和同类方案比,差在哪、强在哪
拿它跟三类常见做法比一下,心里就有数了:
一句话总结它的位置:想要 transformer 级检索质量,又不想付 GPU 的钱、不想等、不想把代码传到云端——Semble 正好卡在这个生态位上。
优势盘点:为什么值得一试
零环境负担:纯 CPU,无 API key、无 GPU、无外部服务。在自己机器上开箱即用。 快:索引普通仓库约几百毫秒,查询毫秒级。 省 token:约 99% 的 token 节省,这是它最"性感"的卖点。 准:NDCG@10 = 0.854,官方称对标 137M 参数的代码专用 transformer。 本地 + 远程通吃:可以传本地路径,也能直接传一个 git 仓库 URL,按需克隆建索引。 三用形态:MCP server(Claude Code / Cursor / Codex / OpenCode / VS Code 直接当工具调)、CLI 工具(写进 AGENTS.md)、Python 库(自己集成)。 增量索引:索引落盘缓存,之后按文件修改时间增量更新,不整库重建。 开源 MIT:出自 MinishLab(Model2Vec 团队),社区可信度在线。
怎么部署和使用:三步上手
部署真心不啰嗦,核心就三条命令:
1. 安装(需要先有 uv)
uv tool install semble2. 一键接入你的 coding agent
semble install它会自动检测你机器上装了的 agent(Claude Code、Cursor、Codex、OpenCode、Gemini 等),让你勾选要启用哪种接入方式:
MCP server:agent 直接把它当工具调用(两个工具: search搜代码、find_related找相似代码)Instructions:把 CLI 用法写进 AGENTS.md / CLAUDE.md Sub-agent:装一个专门的 semble-search子代理
想反悔就 semble uninstall。脚本/沙箱环境还能非交互装:semble install --agent claude --type mcp subagent --yes。
3. 用起来
CLI 三连:
# 搜本地仓库(首跑自动建索引并缓存)semble search "authentication flow" ./my-project# 搜远程仓库(按需克隆)semble search "save model to disk" https://github.com/MinishLab/model2vec# 找与某处代码相似的片段semble find-related src/auth.py 42 ./my-project# 只看文档/配置类内容semble search "deployment guide" ./my-project --content docs也可以当 Python 库用,方便自己写工具:
from semble import SembleIndexindex = SembleIndex.from_git("https://github.com/MinishLab/model2vec")results = index.search("save model to disk", top_k=3)print(results[0].chunk.content)还有几个很贴心的细节:
控制索引范围:自动读 .gitignore,也支持.sembleignore(可用!强制纳入.proto、.cob这类默认不索引的扩展名);node_modules/、.venv/、dist/这类天然跳过。看省了多少 token: semble savings直接给你一张累计节省报告,很上头。换模型:想用别的 embedding,设 SEMBLE_MODEL_NAME指到本地路径或 Hugging Face 仓库即可。换缓存目录:设 SEMBLE_CACHE_LOCATION。
性能数据速查
不想看细节的话,记住这几个数就够了(出处是官方文档与 benchmark,2026-08):
检索质量 NDCG@10 = 0.854 比 grep+read 省约 99% token(同召回率下) 相对代码专用 transformer(CodeRankEmbed),索引约快 220 倍、查询约快 17 倍 全程 CPU,无 API key / GPU / 外部服务
谁最适合现在就用
重度用 AI 编程助手、每个月 token 账单肉疼的人——省 99% 这个点直接命中。 手上捏着陌生/大型仓库、想让 agent 快速上手的人——语义检索比关键词 grep 靠谱太多。 在意代码隐私、不想把仓库同步到云端服务的人——它完全本地。 在 Cursor / Claude Code / Codex 之间切换的人——MCP server 形态对哪家都通用。
一句话总结:Semble 就是给 AI 助手的"本地代码导航仪"——又快、又省、又准,还不用求 GPU、不用交 API key。 如果你正在为"agent 在代码库里乱翻烧掉一堆 token"头疼,装一个试试,成本几乎为零,见效是真的快。
本文封面及插图均为本公众号调用AI工具生成
Qdrant:Rust 写的向量数据库,凭什么在 RAG 时代杀出重围?
受够了 TeamViewer 和向日葵?这个开源远程桌面神器,自己搭服务器才叫真自由
Yazi:这只终端里最快的鸭子,可能比你的Finder还好用