ARTICLE · 1041389
AI 审代码,先别急着问模型:阿里这个开源工具把审查流程拆开了
OPEN SOURCE WEEKLY · 2026 / 09
一个项目 · 一种值得看清的技术思路
导读 / WHY IT MATTERS
一份代码改动交给 AI,它能不能看全、看准,还能把意见贴到正确的行上?阿里巴巴开源的 Open Code Review 给出的思路,是先把审查中可以写成规则的部分固定下来,再让模型处理需要理解上下文的部分。
给 AI 一句“帮我审一下这个 PR”,听起来很顺手。真正用过的人通常还会追问三件事:它是否看完了所有该看的文件?指出的问题是不是确有其事?评论能否落在出错的那一行?一次改动只有十几行,这些问题不显眼;改动跨了多个目录、语言和配置文件时,答案就没那么简单了。
本周在 GitHub Trending 周榜上走热的 Open Code Review,正面处理这些琐碎但关键的工程问题。2026 年 9 月 19 日约 22 时(北京时间)查询时,页面显示它在滚动七日内获得 14,144 个 Star。这不是北京时间周一以来的精确净增量,只是 GitHub 当时的周榜口径;热度可以说明关注度,不能替代效果评测。
PART 01
它从哪里来
项目由阿里巴巴组织维护,仓库名是 alibaba/open-code-review,采用 Apache-2.0 许可证。官方介绍说,它脱胎于内部代码审查助手,现已开放为命令行工具。项目方披露了内部使用规模和自己的 AACR-Bench 测试结果;这些都是官方自述,本文没有独立复现,不能据此保证换一个代码库、模型和规则集后仍有同样表现。
值得读的地方在于架构,而不是宣传数字。它的核心 CLI 主要使用 Go,仓库同时包含 npm 分发入口、编辑器扩展和面向编码 Agent 的插件。使用者可以在本地审查工作区改动,也能针对分支、单个提交或完整文件运行扫描。后者适合接手陌生代码、手头没有可比较 diff 的情况。
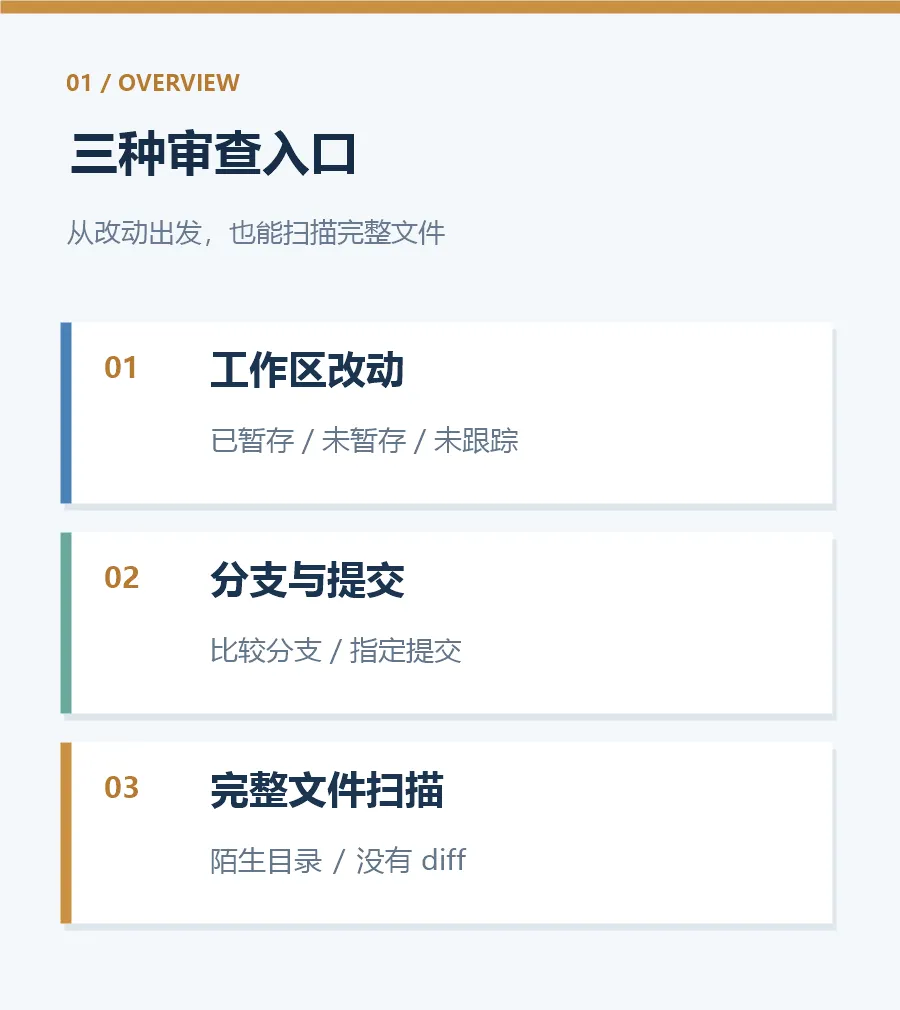
图 1|原创示意:从改动或完整文件进入同一条审查链路
PART 02
为什么不把整个仓库直接塞给模型
审查工作里有些判断不需要语言模型发挥想象力。比如一份 diff 涉及哪些文件、测试文件是否排除、某条规则适用什么路径、评论应对应哪一行。这些问题如果都交给提示词决定,结果容易随上下文和措辞波动。Open Code Review 先由程序筛选文件、把相关文件组成审查单元,再按文件特征匹配规则。每组任务有独立上下文,适合处理较大的改动。
模型随后进入它擅长的部分:读改动、查完整文件、搜索代码库、寻找跨文件的因果关系。一个新增参数是否破坏了调用方约定,通常无法只看当前几行回答;Agent 需要向外追踪。项目还在模型输出之后设置评论定位和复核环节,减少“说得像回事,却贴错位置”的情况。这里的“确定性”指流程约束,不代表最终判断百分之百正确。
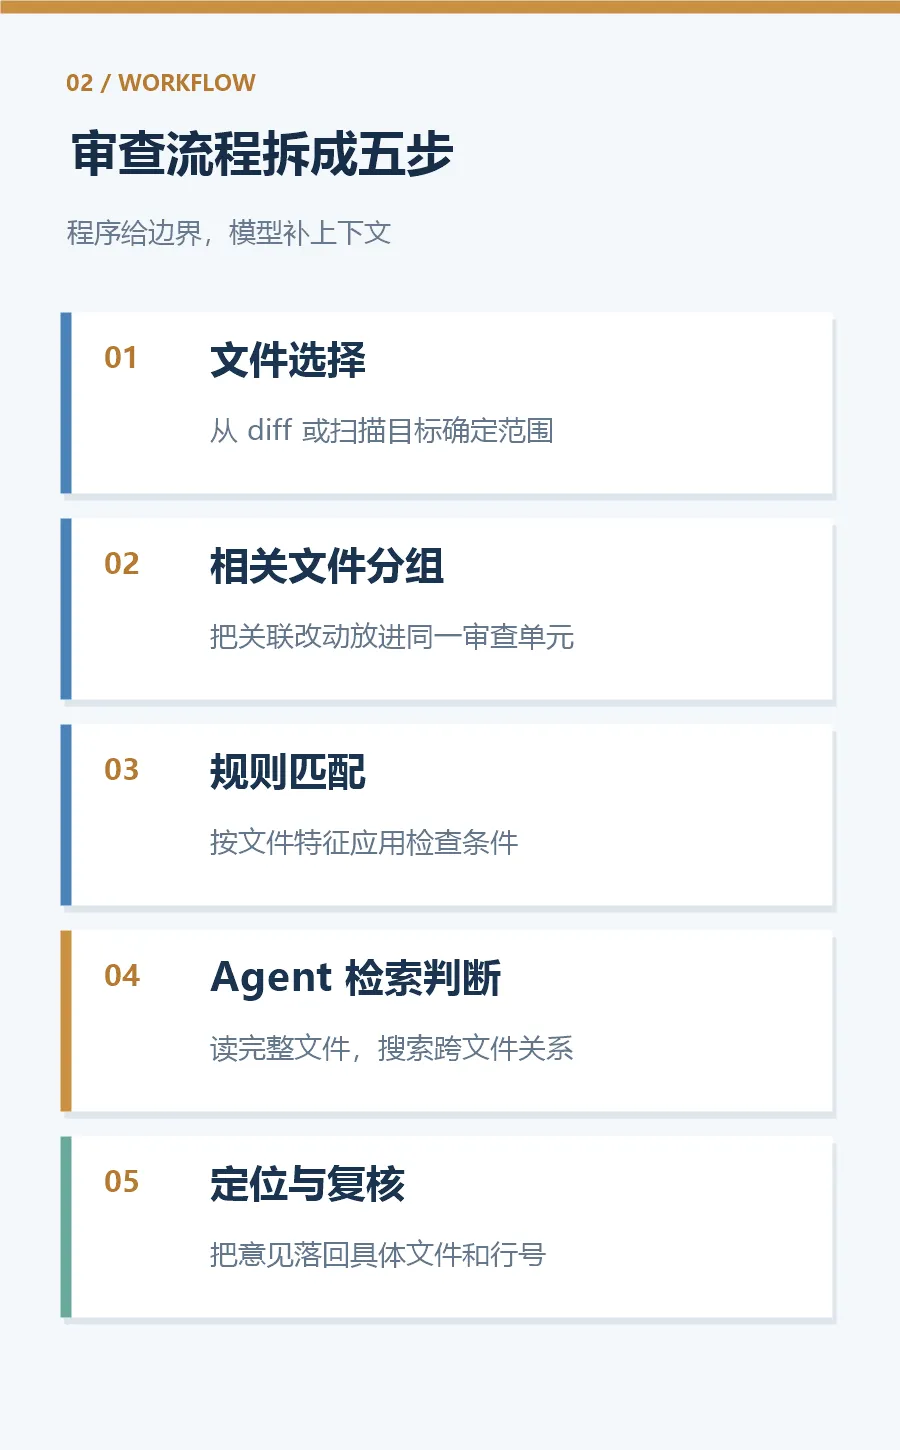
图 2|原创流程图:程序负责固定步骤,模型负责动态理解
这个分工也解释了它为什么提供规则体系。团队可以把反复出现的约定写成面向文件的检查条件,减少每次审查都让模型重新猜测“什么算问题”。仓库说明列举了空指针、线程安全、XSS 和 SQL 注入等多语言规则方向。规则只是审查线索,不等于静态分析器已经证明某处有漏洞;最终仍要回到代码与运行环境核对。
PART 03
怎么试,先从一份小改动开始
官方 README 给出的命令行安装方式是 npm install -g @alibaba-group/open-code-review,前提包括 Git 2.41 或更新版本。安装后先用 ocr config provider 选择模型服务,再用 ocr config model 选择模型。普通模式需要可用的模型端点和相应凭据。进入一个 Git 项目,执行 ocr review,它会检查工作区内已暂存、未暂存和未跟踪的改动;若想审一个分支范围,可以用 ocr review --from main --to feature-branch。
第一次尝试,建议挑一个自己熟悉、改动有限的 PR,先记下人工审查发现的问题,再看工具报出的文件、行号、理由是否经得起核对。若需要留档,CLI 支持 JSON 输出。针对没有改动记录的目录,ocr scan --path internal/agent 是另一条入口。它还能接入 CI 和编码 Agent,但在团队里上线前,先弄清模型端点、密钥、仓库权限和评论写回策略。
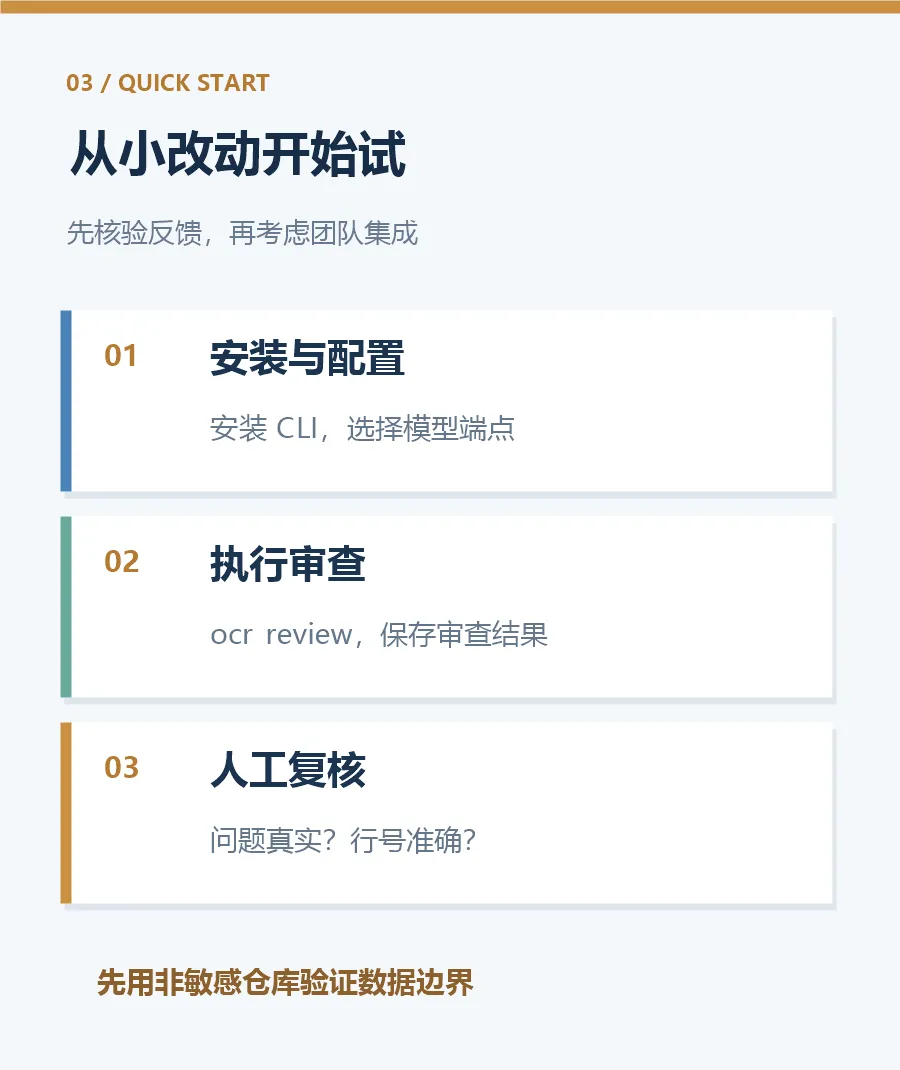
图 3|原创示意:从一份小改动开始验证反馈质量
PART 04
高精确率也意味着另一种代价
官方在基准介绍里强调精确率和 F1,并称相同底层模型下 Token 消耗更低;同一段说明也承认,召回率低于通用 Agent。换成日常语言:它倾向于少发没把握的意见,让开发者少处理误报,但可能漏掉一部分真实问题。安全关键路径、支付逻辑、权限边界和迁移脚本,依然需要人工审查与专门测试。别把没有评论误读为“没有缺陷”。
另一个边界是代码流向。README 明确说,审查时会将变更文件交给可配置的 LLM 端点。使用外部模型服务时,私有代码、配置内容乃至意外混入的密钥可能离开本机;具体保留和使用方式取决于所选服务商。企业代码先核对模型服务条款与内部政策,测试时可用非敏感仓库。即使改用本地端点,也要检查日志、缓存、CI 工件和插件权限。
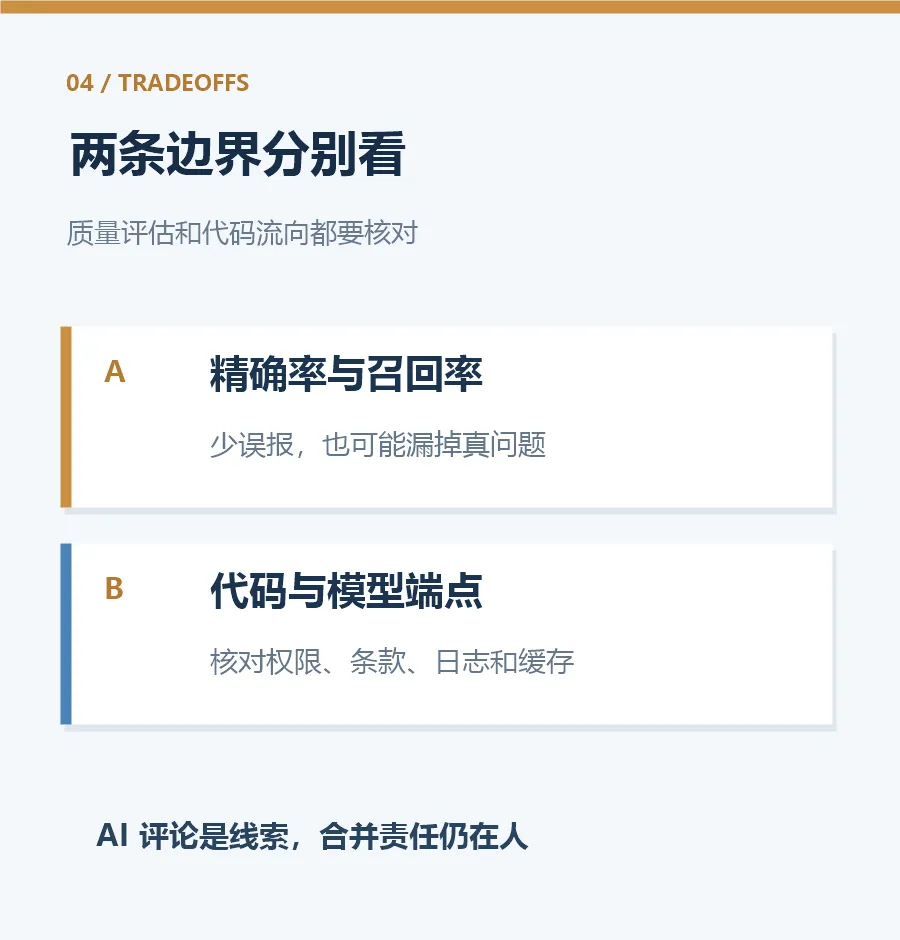
图 4|原创示意:少误报、少漏检与数据边界需要分别检查
PART 05
适合谁,现阶段该怎么看
如果你维护一个经常跨文件修改的项目,又不希望每次都从零写审查提示词,这个工具值得试。它也适合想把团队规则沉淀下来、把审查结果存为机器可读文件的团队。对普通读者而言,它展示了一条更稳妥的 AI 工具设计路子:在能明确编码的环节使用程序约束,在需要判断的环节调用模型,并保留可追溯的结果。
项目本周仍在快速调整。9 月 17 日至 19 日的提交涉及运行中 Token 预算、会话查看器、自包含 HTML 导出,以及非 ASCII 路径搜索等问题。更新积极,但也提示工具链仍在打磨。安装和集成前应查看最新提交、版本说明与安全策略,别把宣传中的基准数字直接套到自己的项目。
最后想说
AI 能帮人更快发现可疑代码,却不能替人承担合并责任。Open Code Review 最有价值的提醒是:好的 AI 审查,不只是“再问模型一遍”,而是把审查过程设计成一套能核查、能复盘、知道自己会漏什么的工作流。
项目原址 / SOURCE
https://github.com/alibaba/open-code-review
· END ·