ARTICLE · 1049171
科研人收藏!Codex 速通文献:从 PDF 生成可核查的科研文献证据链报告
科研人收藏!Codex 速通文献:从 PDF 生成可核查的科研文献证据链报告点击上方蓝字关注我们 
热门推荐本期WorkBuddy智能办公与自动化两天实战课程 点击上图查看 不知道大家读文献时,有没有遇到过这种总结话术: 
「提出新方法,实验效果好,研究意义重大。」 看着没有阅读门槛,但读完几乎一无所获。 核心科学问题、实验数据出处、方法实现步骤、图表和结果的匹配关系、得到了哪些结论、还有哪些研究缺口,全部说得模棱两可。文字写得再漂亮,也不过是把论文内容压缩复述。 Codex 做文献解析,本质就是结构化整理信息:工具从 PDF 抽取出完整研究线索,再靠人回到原文把关校验。 我们要的不是一段 AI 聊天记录,而是一份可以检索、方便反复核对的 Markdown 研究文档。 
1 STEP 1 · 第一步:先把要拆成几节定下来 刚拿到一篇 PDF,我看到的最常见的开场是: 「请帮我把这篇文章压缩成一段话。」——这是大家最容易问 AI 的一句话。 这句话没告诉 AI 任何结构,结果就完全靠它自己发挥。 它有时候会把摘要压成几行,有时候把背景讲一长串;可能花很多笔墨交代入门知识,也可能把最重要的方法参数直接跳过。 所以在让 Codex 打开 PDF 之前,我会先把要拆成几节讲清楚,一篇论文就对应一份主报告 所有内容集中在同一个文件里,同一句话不会再散落在好几个地方。回查的时候,搜一个关键词或一组数字就能找到;写综述前、做组会汇报前,都不用再把整段对话从头翻到尾。 
TIP · 指南 如果只看一段总结就够了,先告诉 Codex"按上面 9 节填",再让它跑,比直接问"帮我总结",前者输出清晰结构化文档,后者只会得到模糊笼统的概括。 2 STEP 2 · 先弄清这篇论文到底在回答啥 ▎ 本节例子:NATURE 论文 · Lam 等 · GraphCast 全球中期天气预报 整理论文信息的时候,重点不在题目、作者、期刊、DOI 这些元数据,而在研究问题本身——它要能让我拿过来和原文逐句对照。 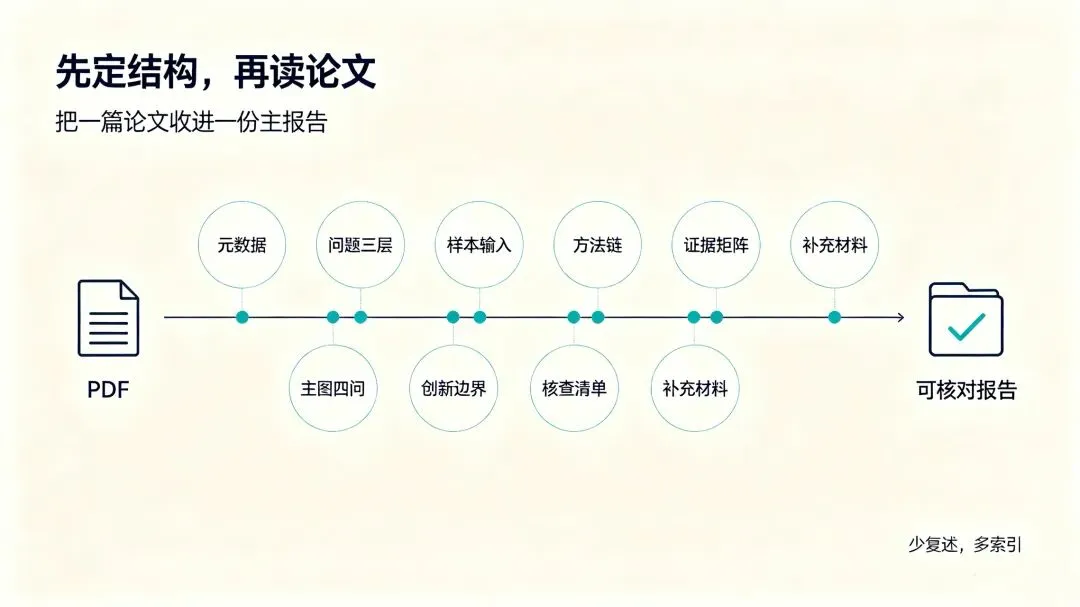
我拿一篇 Nature 论文做例子。 题目是《Learning skillful medium-range global weather forecasting》(GraphCast:用机器学习做高技巧的中期全球天气预报)。 看完后我理解下来,作者要解决的难题可以压成两条独立目标: ① 用图神经网络,能不能直接预测未来 10 天的中期全球气象? ② 这种 AI 模型的准确度,能否超过当下最主流的传统数值天气预报? "做了一个新模型"这种说法,在我看来跟标题党差不多。这两条目标对研究者更友好——它们一次把四件事说清楚: 研究对象被限定在全球网格化气象场(多个高度层的温度、风、湿度等变量); 起点是 ECMWF 四十多年的 ERA5 历史再分析数据; 核心方法是 GraphCast 图神经网络模型; 最后效果靠和 ECMWF-HRES / ECMWF-ENS 等基线对比来验证。 研究问题这一节,我建议按三个层次分开写: 这三层我分开写完,后面的数据、图表、局限性才有可挂靠的主线。 3 STEP 3 · 把方法串成一条可追的线 我读完方法部分,最常见的塌方是把方法写成软件名单。三句典型的写法我列在下面: 「作者用了图神经网络 + 自回归 + ERA5 数据。」——这是 AI 输出的典型名词堆叠。 「编码器-处理器-解码器三层结构。」——这一行看不出输入什么、输出什么。 「训练完直接出 10 天预报。」——这是把一整步压成一个词。 我读这种罗列的时候,最大的困惑是不知道每一步输入是什么、输出又接到哪里去。真要照着复现,还是不知道从哪一行代码开始敲。 我习惯的写法是按"输入 → 处理 → 输出 → 筛选条件"四件事给每一步都记下来,并把对应正文或图表位置写在同一行里。我之后翻查报告的时候,直接定位到原文就行。 我把 GraphCast 这篇论文的方法链大致拆成下面三步。 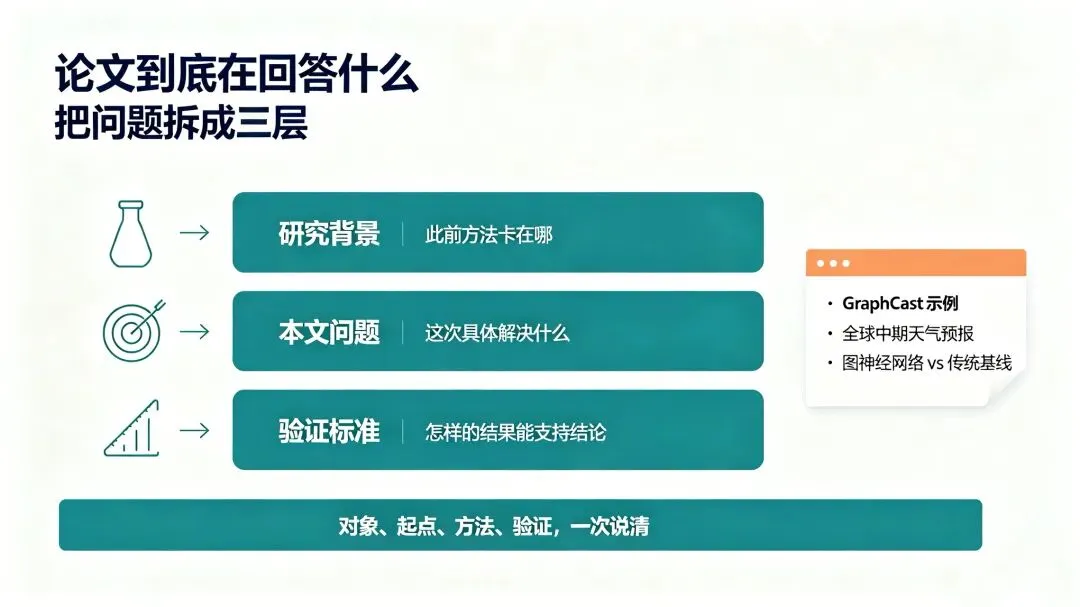
01 3.1 准备 ERA5 历史再分析数据 作者把 ECMWF 自 1979 年到 2017 年(训练时段)的 ERA5 全球气象再分析数据作为训练集。 网格分辨率约 0.25°,覆盖多个气压层(如 1000 hPa、500 hPa 等),多个变量(温度、风速、湿度等)。 数据按"过去 6 小时气象状态 → 未来 6 小时气象状态"成对切成样本,作为单步预测目标。 这一步的输出是上亿组"输入→输出"训练样本。 02 3.2 训练 GraphCast 图神经网络 模型架构按编码器 → 处理器 → 解码器三段式: 编码器把全球网格点映射成"图节点",节点之间的距离由真实球面距离决定; 处理器是图神经网络,多层消息传递更新每个节点的状态; 解码器把更新后的节点状态映射回网格,预测未来 6 小时的气象。 训练目标用真实的 ERA5 数据做监督,损失函数取预测值与真值在多变量、多层上的均方误差。 训练收敛后得到一个"6 小时预测器"。 03 3.3 自回归推理 + 与基线对比 推理阶段,把单步预测器串起来做"自回归":把上一轮的预测作为下一轮的输入,循环调用 40 次,得到 10 天(240 小时)预报。 评测指标包括 RMSE(均方根误差)、ACC(异常相关系数)等,按变量和时效展开对比。 基线选 ECMWF-HRES(确定性数值预报)和 ECMWF-ENS(集合预报),这是当下气象部门实际使用的系统。 结果放在一张张对比图里——这就是后面要读的 Figure 3 / Figure 4。 我看到这里,单纯堆动作的写法终于被重新整理成一条完整方法链: 我后续想回到某一步复核的话,按这条链直接跳到对应方法或补充材料即可。 
NOTE · 注意方法链如果只写"用了 A、B、C"等于没写。一定要把"输入是什么 / 处理做了什么 / 输出到哪里去 / 筛选按什么条件"四件事各填一行。 4 STEP 4 · 把数字归到一张表里 我读完结果部分,最大的感觉是:不能只挑"最高""最好""明显提高"这种形容词。 每一条结论至少要钉住四样东西: 原文里摘录出来的事实; 关键数值和单位; 对应的图号或表号; 这条证据最多能撑到多强的判断。 我继续用 GraphCast 这篇论文做例子。 训练数据:ERA5 全球气象再分析数据,时间跨度从 1979 年到 2017 年,约 40 年。 评测指标:在 RMSE(均方根误差)和 ACC(异常相关系数)上击败 ECMWF-HRES / ECMWF-ENS 等基线,其中对流层中高层(500 hPa 位势高度、850 hPa 温度等)优势最明显。 极端事件案例:在 2022 年欧洲热浪、巴基斯坦洪水等极端事件上,3-5 天前就能稳定给出可靠预警。 推理成本:在 TPU 上单次 10 天全球预报约 1 分钟级(具体以论文 Methods 为准)。 我把这些数字整理成证据表: 保留这最后一列,边界条件说明这一条结论在什么前提下成立、不能推广到哪些场景。 我真正想要的不是更多肯定的判断,而是知道每条结论能外推到多远。 5 STEP 5 · 每张图都要回答四件事 我读到图表解析的时候,最大的感触是:不能只写一句"这张图展示了结果"。 每张主图我要求至少要回答四个问题: 它对应论文推进的哪一步; 数据来源或样本规模是什么; 图中哪一块是正文结论的支撑点; 哪些视觉细节必须回到原图再核对一次。 我把这篇 GraphCast 论文的几张主图按下面这样读: 01 5.1 Figure 1 模型架构示意图 Figure 1 把 GraphCast 三段式架构画成一张大图。 它对应"模型长什么样"这一具体问题——编码器、处理器、解码器三层结构一目了然。 读图时要确认每一层的输入输出张量形状——这是后续能复现的前提。 02 5.2 Figure 2 自回归推理流程 Figure 2 把单步预测 → 自回归 → 10 天预报的推理过程可视化。 它对应"训练好的模型怎么用到未来时段"这一具体问题。 读图时除了看箭头流向,还要确认自回归的循环次数和每步的步长——这两点决定"端到端"是不是名实相符。 03 5.3 Figure 3 在 10 天预报上击败基线 Figure 3 把 GraphCast 在不同变量、不同时效上的 RMSE 和 ACC 表现,与 ECMWF-HRES / ECMWF-ENS 一并摆出来对比。 它对应"模型到底有没有用"这一关键问题——是论文最核心的支撑图。 读图时除了看曲线高低,还要留意横坐标的预报时长、纵坐标的变量名——这些标签一错就解释错位置。 04 5.4 Figure 4 极端事件回溯能力 Figure 4 拿 2022 年欧洲热浪、巴基斯坦洪水等案例,把 GraphCast 的早期预警和真实观测拼在一起看。 它对应"模型在极端情况下是否还靠得住"这一关键问题——这是数值天气预报长期被诟病的弱项。 读图时除了看预报轨迹是否贴近观测,还要看时间提前量——3 天前预警和 7 天前预警是两个量级的事。 报告若只写"AI 模型击败基线",就把原文读浅了——还要交代击败在哪些变量、哪些时效上。 6 STEP 6 · 创新和局限分两栏写 我在论文解析报告里,这部分建议拆成两栏。 一栏我作者明确写出来的贡献。 另一栏记自己从原文证据出发整理出来的审阅意见。两栏不能混写。 作者自己强调的方法优势是这样一句话:图神经网络首次在 RMSE / ACC 等关键指标上系统地击败主流数值天气预报系统,且推理成本低到分钟级。 这是论文里作者自己给出的方法学定位。 我从原文证据出发,再列出几处需要谨慎解释的地方: 这四条是我从原文整理出来的审阅意见,不是作者的原话。报告里要明确标注"本文审阅",让读者一眼区分作者主张和审阅意见。 
WARNING · 贴心提示 本节改用 GraphCast 论文作为例子。具体数字(训练时段、网格分辨率、推理时间、极端事件案例数)以原论文 Methods 与 Results 为准。这一期侧重"9 模块骨架方法论是否同样适用",不替代对原论文数字的核对。 7 STEP 7 · 一段能直接粘贴的 Codex 提示词 下面这段话我贴在 Codex 会话里,就能直接代替"请帮我把这篇文章压缩成一段话": 8 STEP 写在最后: 借助结构化报告,既能节约文献查阅时间,也可以快速发现研究的证据缺口。 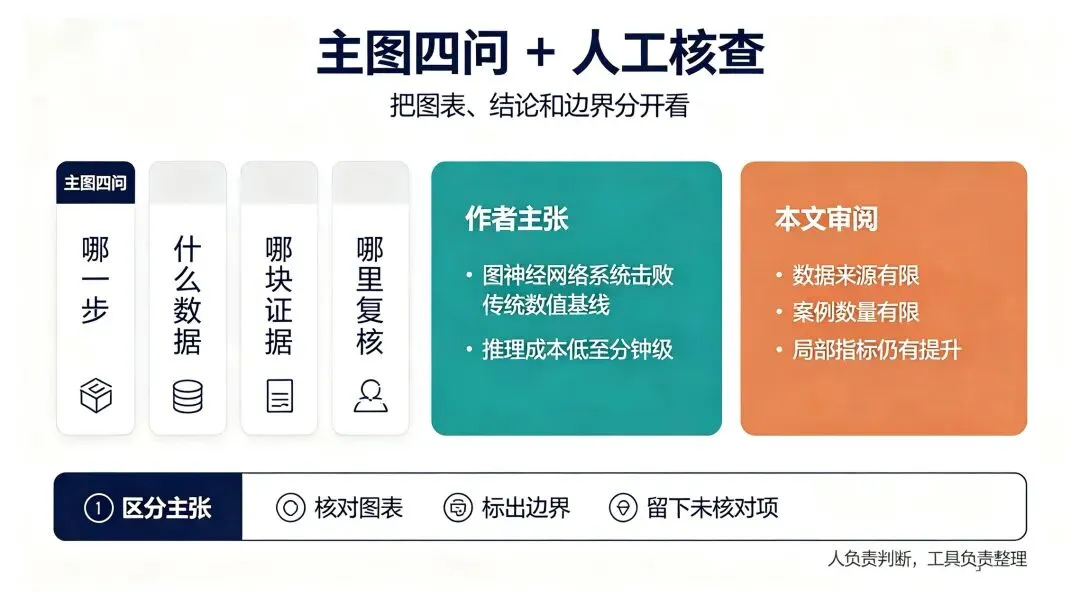
即便报告再规整,三件事仍要研究者亲自完成: 做好分工:Codex 搭建索引,原文提供证据,人负责学术层面的判断。 这便是这套流程的重点。 它不会代替我们读完论文,但是能把研究问题、方法、数据、图表梳理成完整证据链。 后续写综述、组会汇报、规划新实验,都能依托这份可复查的科研记录开展。 课程推荐: 我们联合中科启研重磅推出双 AI 智能体自动化科研工作流构建与应用实战课程,零门槛即可上手,全程名师实操带练,紧跟 AI 驱动科研变革新趋势,面向硕博、高校教师、科研从业者、企业研发人员等各类科研人群。 ✨课程三大核心|紧跟行业热门技术 1、AI 全流程科研赋能,解决科研全链路痛点 覆盖科研高频刚需:文献检索整理、创新选题挖掘、论文框架搭建、文稿精修润色、数据分析、科研可视化绘图、教学备课、科研项目申报。专业导师手把手拆解工具逻辑,搭建标准化 AI 科研工作流,告别低效摸索,提速论文产出与课题申报,少走大量弯路。 2、零代码搭建热门科研 Agent 智能体 无需编程基础,上手当下主流热门工具:Claude Code、Codex、WorkBuddy 智能办公自动化。手把手教你打造专属科研 AI 助手,自动完成文献批量处理、数据清洗分析、模型搭建、报告生成等重复工作,把宝贵时间留给核心创新研究。 3、核心技能+权威双认证,护航职业进阶 课程结业颁发事业单位、国家一级协会、工信部相关单位联合证书,行业认可度高,抓住 AI 科研风口提升个人竞争力。 🎁专属学习保障,无惧零基础起步 一次报名同类型课程,免费无限复训,课程持续迭代更新,紧跟 AI 科研前沿热点 专属答疑社群 + 永久回放,随时回看复盘,实操问题及时解决 限时报名赠送往期全套热门学习资料、往期培训视频,可提前预习占位 全程线下现场 + 线上直播同步授课,最近在北京、深圳、杭州、武汉等地开课,异地学员不受地域限制,随时随地学习,咨询对应完整课表和开课通知。 西西老师 17602178996(微信同号) 点击下图了解详细信息 
如果看完本篇内容找到科研新思路,欢迎 点赞、在看、转发 给还在深陷科研内耗的伙伴。关注公众号,持续解锁 AI 写作思路干货、大模型科研落地案例,带动你的科研效能强势增长。 
点击转发 鼓励一下吧!
codex-decode.md ← Codex 速通证据链报告├── STEP 1 · PDF 元数据卡├── STEP 2 · 问题三层(背景 / 本文 / 验证)├── STEP 3 · 样本与输入清单├── STEP 4 · 方法链(输入 → 处理 → 输出 → 筛选)├── STEP 5 · 证据矩阵(结论 / 数字 / 图表 / 边界)├── STEP 6 · 主图解读(每图四问)├── STEP 7 · 创新与边界分两栏├── STEP 8 · 待人工核对清单└── STEP 9 · 补充材料处理状态层次 要回答的问题1.研究背景 此前数值天气预报遇到什么瓶颈2.本文问题 作者这次具体提出什么方案3.验证标准 AI 模型在哪些指标上能赢过传统基线第一步 准备 ERA5 全球再分析数据作为训练样本(过去 → 未来 6 小时成对)第二步 训练 GraphCast 图神经网络(编码器-处理器-解码器)第三步 把训练好的单步预测器串起来做自回归推理第四步 循环调用 40 次,得到 10 天(240 小时)全球气象预报第五步 和 ECMWF-HRES / ECMWF-ENS 等基线做 RMSE / ACC 等指标对比第六步 在极端事件案例(2022 欧洲热浪等)上做回溯评估结论 证据 原文位置 边界───────────────────────────────────────────────────────────────────────────────────────────可基于 ERA5 直接训练 训练跨度约 40 年 / 多层多变量 Methods 历史时段,不能外推到未来气候可在 10 天预报上击败基线 RMSE / ACC 上优于 ECMWF-HRES / ENS Results 仅用 ERA5 单源数据训练可识别极端事件 2022 欧洲热浪 3-5 天前预警稳定 Results 案例数量有限推理成本可接受 TPU 上 1 分钟级 10 天全球预报 Methods 推理硬件依赖 TPU/GPU训练数据全部来自 ERA5 单源再分析,不能直接外推到气候变化情景; 极端事件案例数量有限(2022 年几条),泛化到其他极端事件还需更多验证; 评测主要看对流层中高层,对边界层、台风路径等仍有提升空间; 推理成本虽低,但模型权重公开与推理算力门槛与数值预报不可同日而语。
任务:用 Codex 把当前目录里的论文 PDF 拆成一份能反复查阅的 Markdown 报告。原则:每条结论在原文中能找到对应位置;找不到的,在该栏明确写"未核对"。四条硬性边界(违反任一条都判定为报告不合格):Ⅰ. 不得联网搜索或查外部数据库补充信息;Ⅱ. 不得用模型预训练知识补齐原文未写明的细节;Ⅲ. 不得直接复制原文长段落,所有概括必须重新表述;Ⅳ. 涉及补充材料的内容,若未实际读取,在该栏写"当前未核对"。执行顺序:先完整读完 PDF,再按第一节到第八节输出 Markdown。第一节 元数据 题目、作者、期刊、年份、DOI、研究对象,一行一项。第二节 问题三段式 研究背景(此前方法卡在哪) / 本文问题(这次具体解决什么) / 验证标准(怎样的结果能支持结论),三层独立写。第三节 样本与输入 逐行列出来源、数量、处理流程、用途。第四节 方法链 按"输入 → 处理 → 输出 → 筛选条件"四列展开;每一行末尾标注对应正文段、图表编号或补充材料位置。第五节 结果清单 每条结论给齐:原文事实 / 关键数字 / 对应图表 / 这条证据最多能撑到多强的判断。第六节 逐图说明 对每张主图依次回答:本图在论文中负责哪一步 / 数据或样本是什么 / 哪一块支撑正文结论 / 哪些细节需要回到原图人工核对。第七节 创新与局限 拆成两栏:作者自己明确陈述的贡献 / 基于原文证据整理的审阅意见(含边界与适用条件)。两栏不要混在一起。第八节 核查清单 列出所有未读取、无法确认或存在歧义的内容,每项标注对应章节。交付物:保存为 Markdown 文件,文件名按论文题目短缩写命名。报告末尾保留一行「补充材料处理说明」:若已读取补充材料,列出读了哪几节;若未读取,明确写"当前未核对补充材料"。甄别实验设计能否回应核心科学问题; 读懂图表颜色、线型、误差线蕴藏的信息; 权衡单一结果是否足以推导更大的学术论断。