ARTICLE · 1049815
安筱鹏:AI时代,数据如何构筑企业的护城河
本文作者:安筱鹏
题记
当AI智能体消耗的Token达到人类的5倍,数据究竟在被谁“使用”?2026年8月,全球顶级投资机构a16z的报告记录下这一切换:今年2月,智能体的Token消耗才刚刚追平人类,半年后已是人类的5倍;与此同时,前沿企业与一般企业的Token消耗差距,从2.6倍悄然拉大到8.3倍。另一组事实更反直觉:某养猪企业以日Token消耗百亿量级,穿越艰难猪周期。数据的消费主体正在从人换成AI,数据竞争力的密度正在被Token重新定义。在大数据产业博览会上,我们不谈流通、不谈确权、不谈入表,而是回到企业视角,追问数据要素的终极问题——如何提升核心竞争力,如何构筑自己的护城河。
本文主要观点源自2026年8月29日在贵阳举办的2026中国国际大数据产业博览会“词元——数据要素价值释放新路径”论坛上的主题分享,由阿里云智能副总裁、中国信息化百人会执委安筱鹏主讲,并根据演讲内容整理。
一、AI时代的数据正在创造“真金白银”的价值
在数据要素主题的论坛上,我们不谈流通、不谈确权、不谈入表,而是回到企业视角,思考AI时代数据对于企业的竞争力到底意味着什么?这本身就是一个判断。相比于制度设计层面的热闹讨论,企业端对数据价值的体感仍然模糊。把议题锚定在竞争力与护城河上,可以把数据要素从政策概念拉回商业现实。
那么答案在哪里?把目光转回到云上,其实并不远——就藏在三个反直觉的案例里。
第一个案例是某养猪企业。在很多人的印象里,养殖是第一产业中最“传统”的行当之一;但它的日Token消耗已达百亿量级,超过绝大多数第二产业企业——包括那些销售额几千亿、上万亿元的企业。正是在这个行业,数据、Token与AI咬合在一起,帮助企业的生猪养殖核心场景完成了从“人盯猪”到“AI盯猪”的转变。
第二家是美国公司Harvey。它基于100亿tokens的案例法内容和250多个知识源,训练出法律专业垂直模型,服务超过50%的美国百强律所,估值超过百亿美元,年化收入近2亿美元。
第三家是OpenEvidence。它基于医疗领域专业而独有的数据构建医疗垂直分析能力,覆盖40%以上的美国医生,估值120亿美元,成为全球生命科学领域最大的独角兽之一。
把三个案例摆在一起,共同逻辑其实只有一句话:不是“谁的模型更强”,而是谁率先构建了行业独有的数据资产,并完成了Token化。养猪行业身处第一产业,Token消耗却超过绝大多数第二产业——这恰恰是“数据护城河”命题最有说服力的反直觉证据:数据竞争力的密度,与行业的“高低”无关,而与数据的排他性、实时性和嵌入业务流程的深度正相关。
还有一组数据值得放在一起品味。麦肯锡前段时间的报告给出了一组对照:AI落地效果不好,是80%的任务中,AI无法获取上下文。这个数字指向的不是AI能力不足,而是企业数据准备度不足——这才是当前AI落地的真正瓶颈。读懂私有数据,正在成为企业的核心竞争力。
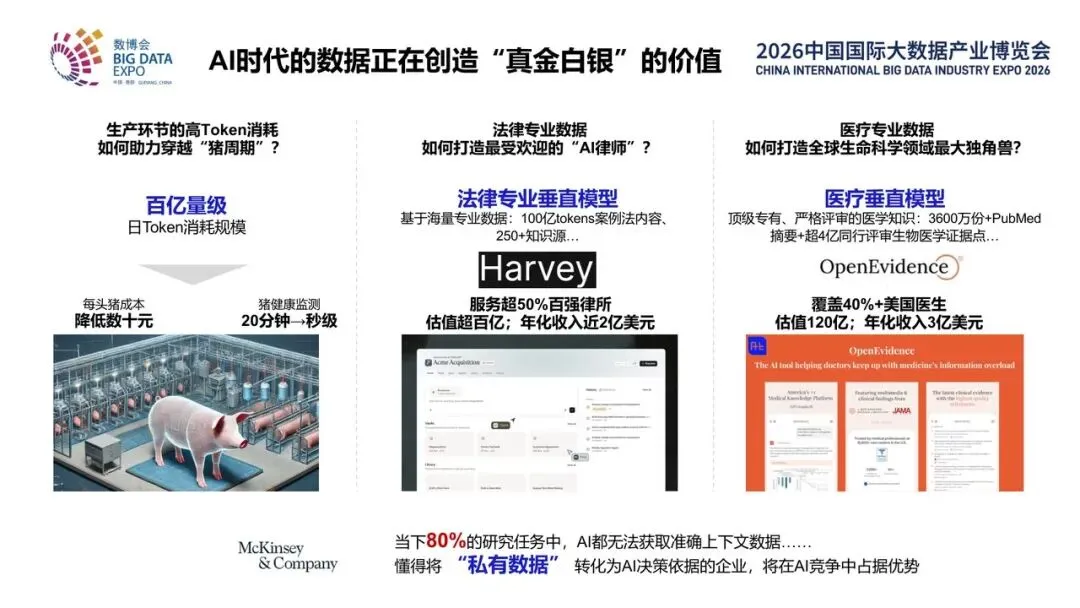
图1|从三个案例,看AI时代数据创造的“真金白银”的价值
二、从Digitalization 到 Tokenization:数据转化为竞争力的五种路径
要谈数据竞争力,有一对概念绕不开:数字化与数智化。很多人把它们看成同一条路上的先后两段,事实上,它们是两种不同的范式。
我们把它们极度简化:数字化,是把人类所能认知的原子世界转换为比特,核心关键词是Digitalization;数智化,是把已经比特化的信息转换为可被AI加工的Token,核心关键词是Tokenization。
举一个例子。你掏出手机拍一张照片,摄像头里的CMOS芯片把电磁信号转换成0和1——原子的信息变成了比特;比特再经算法描述、诊断、预测、决策,最终打印出来、装进相框。这是数字化。Tokenization则是在比特化之上再进一步:把一个概念变成一组向量,让大模型可以加工处理——一张照片可以被延展成一段视频、重构成一段声音,被AI加工后再还原出来。这就是从数字化到数智化的价值跃迁。
所以,数字化与数智化不是一条延长线上的先后关系。在“原子→比特→Token→大模型→Token→比特→原子”的完整链路中,比特只是忠实记录,Token才赋予数据“可被推理、可被生成、可被决策”的能力。中间那段“Token→大模型→Token”,恰恰是今天大多数企业尚未跨越的价值增量区间。
这个区分的战略含义很直接:过去十年在数字化上的投入——建系统、采数据、做报表——不会自动转化为AI时代的竞争力。数据的“量”不是问题,数据从比特到Token的“转化率”,才是企业之间真正的分水岭。过去十年的投入是门票,不是护城河。
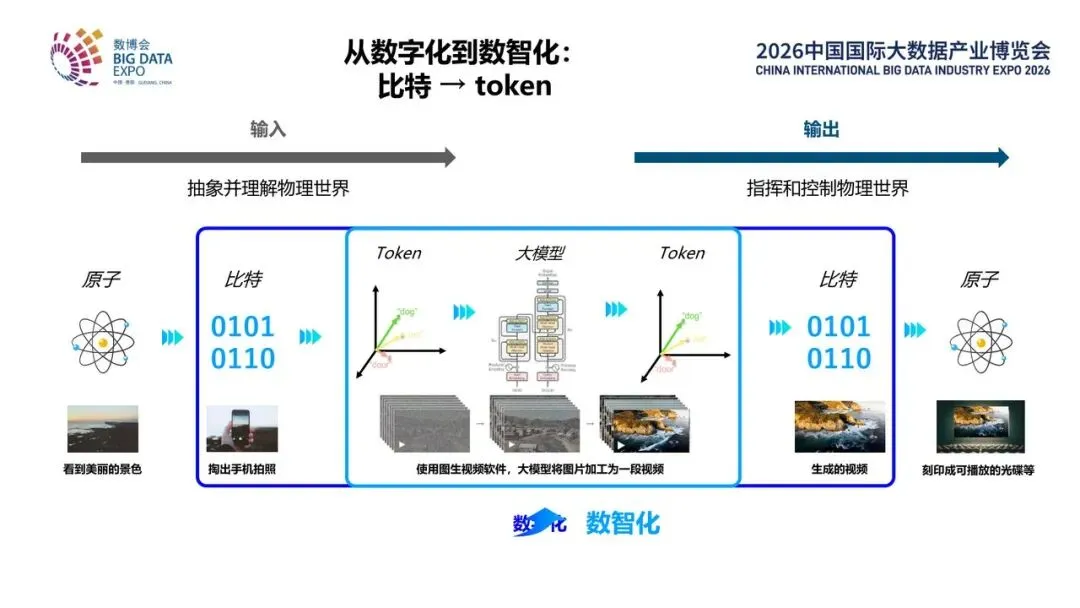
图2|从数字化到数智化的完整链路:比特→Token
我们追问一个问题:私有数据究竟通过什么路径转化为竞争力?从我们一线的观察看,有五种:
第一,把数据转化为模型预训练阶段的智能;第二,在预训练之上通过后训练和微调,使模型能力进一步增强;第三,用企业数据、行业数据构建基于RAG的知识库,可以检索、可以调用;第四,把数据、经验、流程、SOP变成企业和行业自己的Skills;第五,更重要的是,让所有数据构建起模型使用时所需的上下文。
这五种路径,构成一个递进的壁垒阶梯。用医学打个比方:第一层像“考上协和医学院的学生”,第二层像“协和医学院毕业的博士”,第三层像“医学文献和病例库”,第四层像“专科医生的执业经验”,第五层则是“了解某个病人的既往病史”。前两层的能力差距,正在被开源模型的涌现快速拉平;真正拉开企业间差距的是后三层——RAG提供外挂知识,但仍可被竞争者复制;Skills封装了流程经验,但需要长期积累;上下文工程深度绑定业务背景,几乎不可迁移。
这里要特别说一点。今天很多人讲模型不能用、效果不好——很多时候不是模型本身的问题,甚至也不是算法的问题,而是没有准备足够丰富的上下文。模型的竞争已经充分,上下文的竞争才刚刚开始。企业AI投入的重心,应当从“选模型”转向“建上下文”。
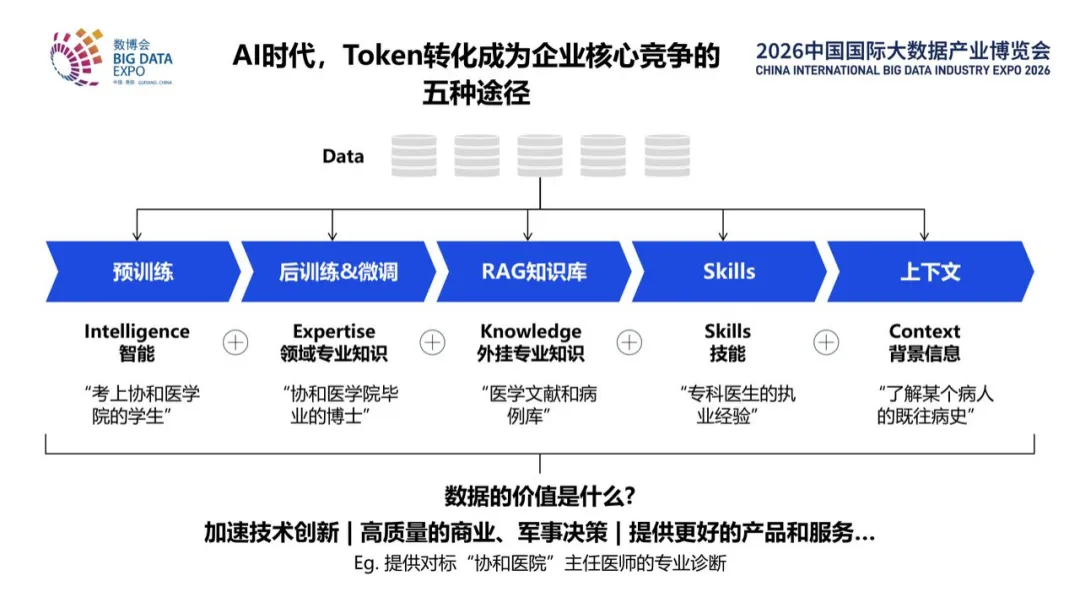
图3|Token转化为企业核心竞争力的五种途径与壁垒阶梯
三、Token消耗的分化趋势:AI时代的新“数字鸿沟”
Token消耗的主体正在发生一次静默的替换。全球顶级投资机构a16z在2026年8月的报告中测算:今年2月,AI智能体的Token消耗首次超过人类用户;到8月,已达到人类用户的5倍。数据的消费主体从人切换到AI,这不是渐进变化,而是主体颠覆。
OpenAI的数据更具警示意义:前沿企业(前10%)与一般企业(中位数)每月活跃用户输出Token的差距,从2.6倍扩大到8.3倍;以绝对值计,前沿企业已达一般企业的17.1倍。两组数据叠加,结论很清楚:AI时代的“数字鸿沟”,不再是“有没有上云”“有没有用AI”,而是Token消耗的量级差。不用AI的企业与深度使用AI的企业之间的生产力差距,正在以指数级速度撕裂;这种差距一旦形成,后来者追赶的成本将远高于先发者的投入。
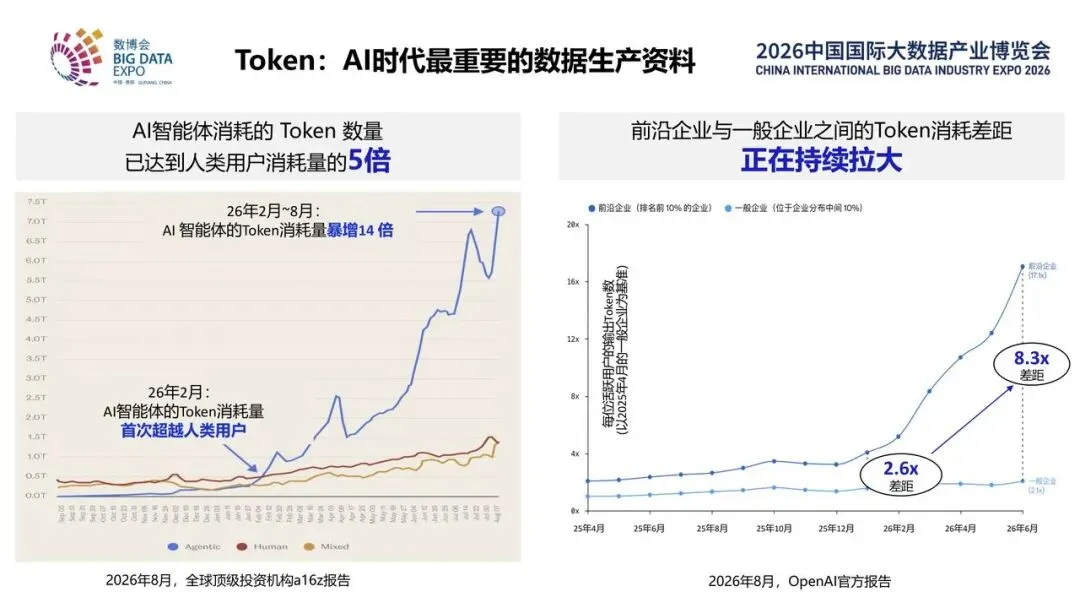
图4|Token:AI时代最重要的数据生产资料
我们再讲两个案例,具体地感受一下,Token到底是怎么变成企业竞争力的。
第一个案例是某养猪企业,其数据壁垒来自四个维度的叠加:特征精——1万多名兽医的临床经验,被标注成80余种业界独有标签;体量大——330多万台装备日新增20亿余条数据,动态监测4500多项指标,实时链路秒级进仓;链条全——自繁自养、数据口径统一、全量回收,采集贯穿180天全生命周期;积累深——30余年积淀、8年规模化数字采集,横跨多轮猪周期和猪疫病样本。模型侧基于千问基座后训练出养猪专属大模型:13万台声音监控“听咳嗽”,1万余台轨道巡检机器人、17项自动体检构成多模态实时检测;18种结构化数据加80余种体态标签多信号同时命中才报警,预警准确率95%以上;诊断报告每三天跑一轮、每轮一万份,600头批次检测从约20分钟缩短到秒级。效果是头均成本降低数十元,单人管理范围扩大3倍。
但最关键的指标是另一个:日Token消耗仅4个月就增长数十倍。这不是线性增长,而是数据喂养模型、模型优化决策、决策产生新数据的飞轮加速效应。先发者与后来者之间的差距,是指数级的。
第二个实践是自动驾驶,数据处理从“手工作坊”到“自动化流水线”。传统智驾研发是“数据手工小作坊”:数百台测试车的硬盘快递回数据中心,手动清洗、人工标注、人工挖掘、人编写规则代码、小集群训练多个小模型、仿真评测——模型迭代以数月计。某领先智驾企业基于云计算的研发则是“数据自动化生产线”:百万量产车数据实时回传上云,云数据管线自动处理,AI自动化标注、AI特征挖掘、大集群训练端到端模型、AI自动生成控制代码、云上自动仿真评测——模型迭代以数天计。
从“数月”到“数天”,不只是效率提升,而是竞争维度的根本转换:当一方以天为单位迭代、另一方以月为单位迭代时,模型性能的差距将在极短时间内拉开到不可逆的程度。端到端自动驾驶已进入白热化竞争,数据处理的工业化程度,直接决定谁能胜出。
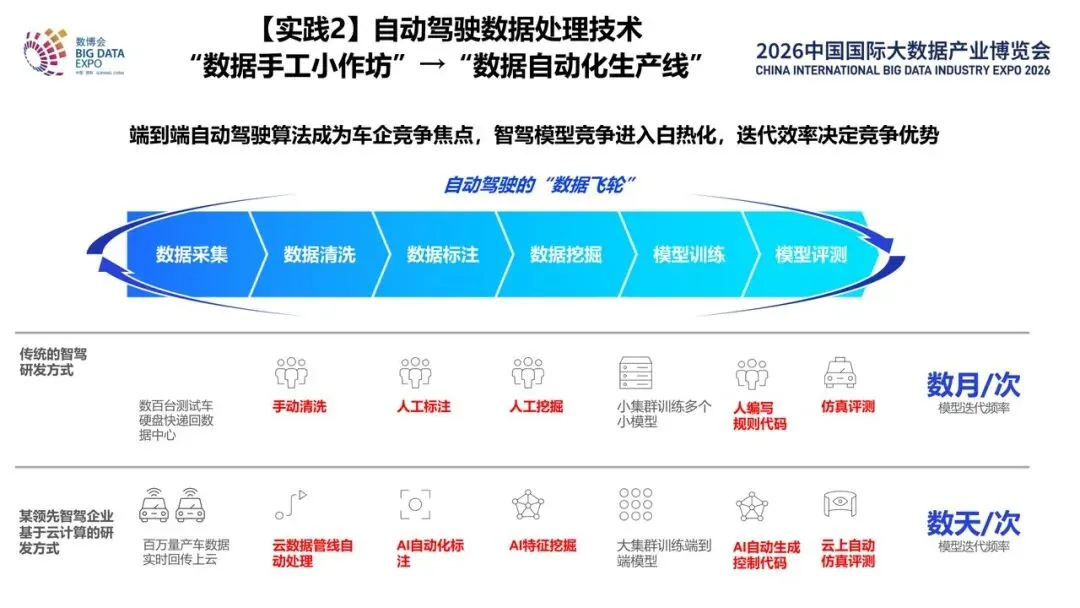
图5|自动驾驶数据处理:从“手工小作坊”到“自动化生产线”
四、企业的下一步:三个平台、两个飞轮与两大趋势
那么企业该怎么办?要让数据与Token真正转化为竞争力,企业架构需要重写。就像数字化时代ERP、CRM、数据仓库定义了企业IT架构一样,AI时代的企业架构正在收敛为三大平台:一是企业数据知识资产化平台,完成采集、清洗、治理、增强到Token化、向量化的全链路;二是企业模型管理平台,覆盖持续预训练、微调、强化学习、评测与推理优化;三是企业智能体开发运营平台,承担编排、多智能体协作、工具集成,以及智能体的运行时、身份、可观测与安全。
只有三个平台还不够,还需要两个飞轮。智能体在工业、养殖、金融、医疗场景中应用时,产生的交互数据回流到上下文网络,形成智能体运营飞轮;模型后训练产出的数据回流到知识资产平台,形成模型训练飞轮。两个飞轮咬合,回答了一个关键问题:如何让企业AI不是“一次性项目”,而是“越用越聪明的活系统”。
值得注意的是,这套实施过程需要一个新角色——FDE(Field Data Engineer)。AI落地正在从“交付软件”转向“交付能力建设”。
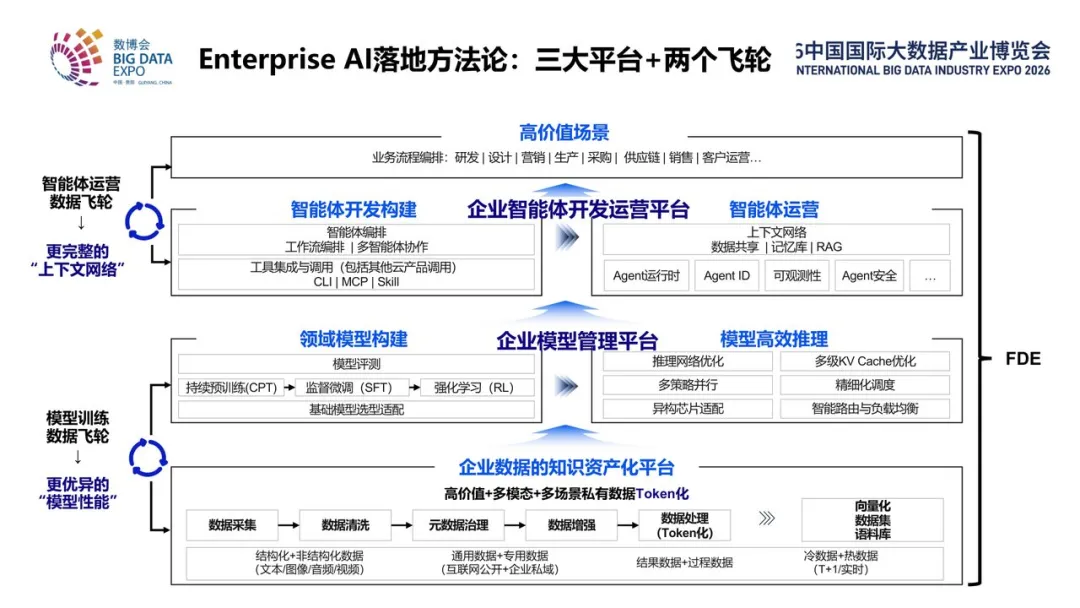
图6|Enterprise AI落地方法论:三大平台+两个飞轮
站在这套架构上往前看,有两个趋势已经清晰可见。
第一个是数据要素的升维。数据对象特征,从结构化冷数据走向非结构化热数据;数据服务主体,从服务人走向服务AI,要求高频、实时、精准的决策;数据处理技术,从人编写规则代码走向AI自动化处理。三个维度的变化叠加,指向同一个判断:Byte到Token,企业系统正在从记录系统进化为决策系统。
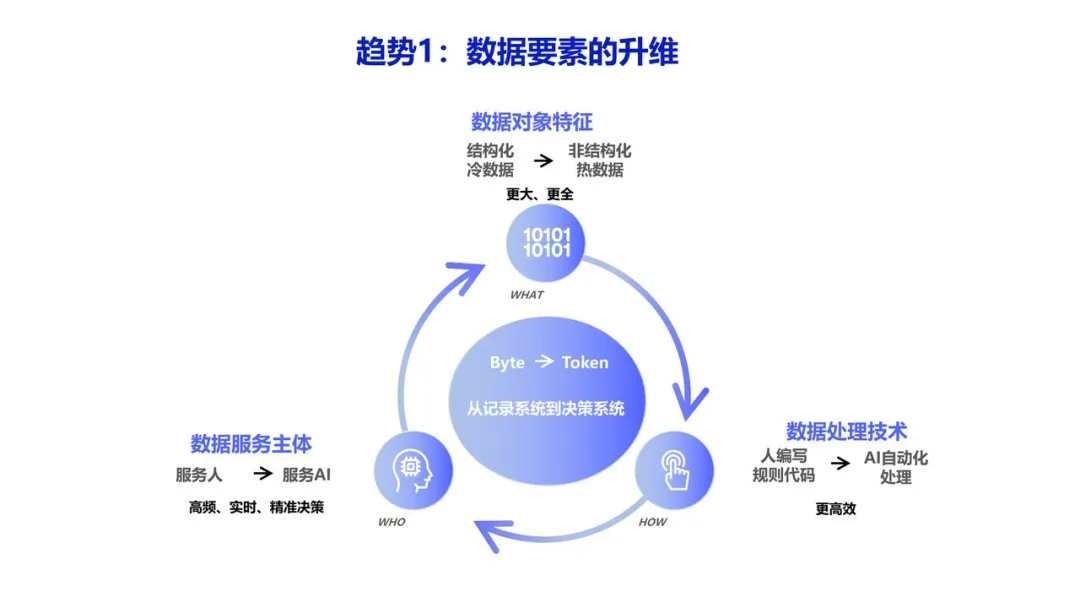
图7|从对象特征、服务主体、处理技术,数据要素三方面升维
第二个是超级智能体的崛起。过去半年,SAP从Embedded AI转向Autonomous Enterprise,Salesforce从Einstein走向Agentforce乃至Headless 360,Oracle Database 23ai把Skills在GitHub上开源——全球软件巨头集体转向。这背后是一个尖锐的判断:AI正在对软件产品发起一场“斩首行动”——软件的脑袋(入口层)被干掉了,身体(功能层)还留下。传统“流程+AI”(Embedded AI)的技术路线与商业模式越来越走不通,新范式正在成形:统一的超级智能体入口(如千问办公),加上软件功能原子化的Skill化、MCP化、CLI化,再加上AI+Data统一数据平台。如果入口层被智能体替代、功能层被原子化,软件产业的价值将向“数据层”和“智能体平台层”两端集中。
回到开场的问题:AI时代,数据如何构筑企业的护城河?答案其实已经写在文中——不在于存了多少数据,而在于把多少比特转化成了AI能理解、能推理、能决策的Token;不在于买到了多强的模型,而在于是否建起了别人拿不走的上下文、Skills与飞轮。比特只是记录,Token才是理解。当数据的消费主体已经从人换成AI,这场跃迁,每一家企业最终都要完成。