ARTICLE · 1064111
边端AI芯片技术栈(下):相同算力的芯片,为什么产品体验天差地别?
上篇我们拆了感知层——ISP 成像、AI-ISP 增强、机器视觉、视频编解码、语音交互。如果把感知层比作边端芯片的"手和眼",那今天这篇要拆的全栈版图——硬件架构、智算算法底座、工具链、SDK、场景化算法——就是它的"骨骼、大脑和神经系统"。感知层决定了设备能看见什么、听见什么,而底层全栈决定了它看得多稳、算得多快、落地多省心。
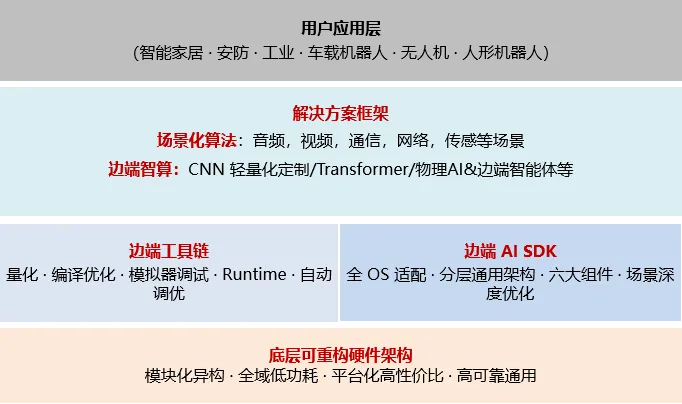
边端AI芯片软硬件全栈:四层堆叠(应用层、模型算法层、软件层、硬件架构) + 四维平衡(性能、功耗、成本、生态)。跑通 Demo 靠 TOPS,稳定量产靠全栈。
一、先看骨架(底层硬件架构):边端芯片的四大设计关键词
云端芯片的算力竞赛,维度相对单一——堆峰值、拼规模;毕竟在数据中心里,功耗、散热、成本都有人兜底。边端芯片不一样:它要在性能、功耗、成本、场景适配之间找一个多维最优平衡点——一块板子、一颗电池、一个散热片,就是全部家当。主流设计思路,概括成四个关键词。
关键词一:模块化异构。 边端场景高度碎片化,芯片采用 CPU、GPU、NPU、ISP、VPU 等各类可裁剪、可扩展的异构架构;外设接口完整适配多路摄像头、TOF 传感器、麦克风阵列、工业总线。软硬件双向裁剪,做到面向不同行业的 "一场景一配置" ——像裁缝量体裁衣,而不是买均码。
关键词二:全域低功耗。 常驻运行是边端设备的常态。芯片划分多个独立电源域:AI 计算、视觉、语音、待机各域可独立调压调频甚至断电;系统做智能动态算力调度,轻负载自动降频休眠,业务峰值释放满算力;同时通过内存复用、算子复用减少数据搬运,从根源上省电。
关键词三:平台化高性价比。 为支撑规模化量产,芯片基于统一架构衍生高、中、低全系列型号,驱动、工具链、算法优化全部共用;芯片高度集成、减少外围配套芯片,压低整机 BOM 成本,覆盖民用到工业、车载多档位终端。
关键词四:高可靠通用。 面向工业、车载、特种机器人等严苛场景,芯片要扛得住宽温、抗得了电磁干扰,同时兼容主流操作系统和推理框架——兼顾定制能力与生态通用性,缓解行业碎片化带来的适配周期长痛点。
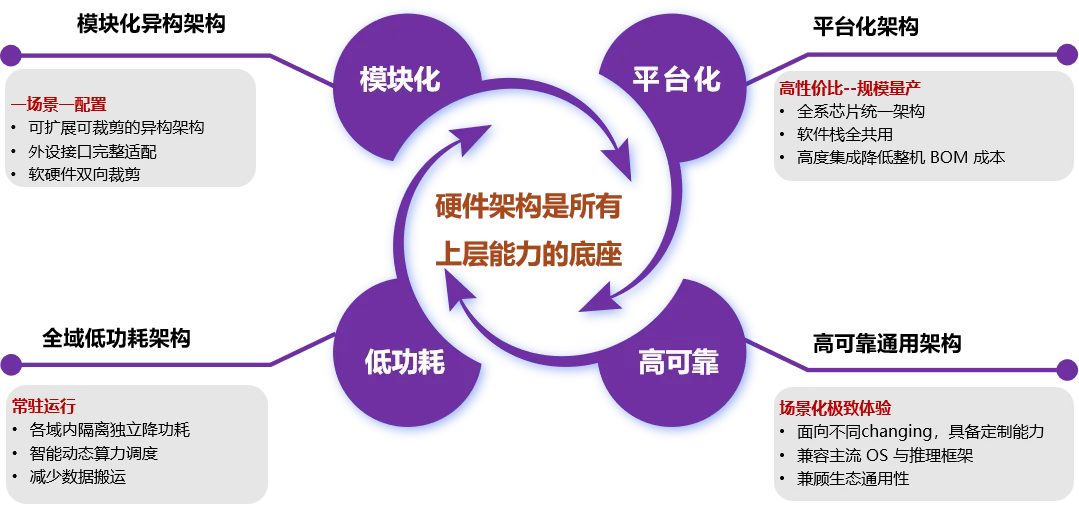
这四个关键词并非孤立存在,而是相互咬合的整体:模块化异构提供了裁剪的自由度,全域低功耗决定了常驻运行的可行性,平台化设计摊薄了量产成本,高可靠通用性则决定了芯片能不能走出实验室、走进工厂和车载现场。任何一个短板,都会让另外三项的努力大打折扣。
骨架立住了。但骨架要"活"起来,得看里面的算力怎么演——边端 AI 的算法底座,正在经历一场三代同台的剧变。
二、边端智算算法底座:三代同台,不是替代是叠加
边端 AI 任务已经发生根本变化:从过去 YOLO、ResNet 这类单一 CNN 视觉推理,升级为 CNN、Transformer、大语言模型、世界模型的多范式融合计算。边端 AI 任务长什么样,边端 NPU 的能力版图就长什么样——算法底座正经历三代跨越。
第一代是 CNN 轻量化时代。
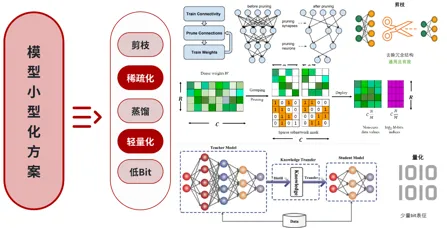
以 AlexNet、ResNet、YOLO 为代表的卷积网络,用一层层堆叠的 Conv+FC 结构完成“看懂一张图”的任务——安防监控里的人形检测、产线上的缺陷识别,都是它的主场。模型结构固定、计算规整,轻量化手段也以剪枝、量化为主,它是边端视觉当之无愧的出货主力,但能力边界同样清晰:只认识训练过的类别,不理解语义。
第二代是Transformer 与端侧大模型时代。
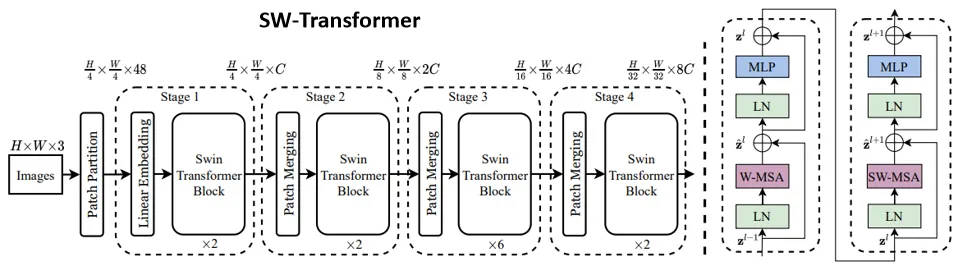
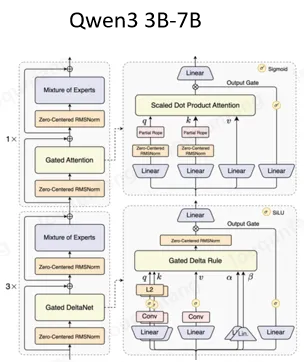
注意力机制让模型从“识别像素”走向“理解序列”:窗口注意力(W-MSA/SW-MSA)把 O(N²) 的开销压到边端可承受;MoE 混合专家、RMSNorm、门控注意力(Gated Attention)等结构不断压缩激活与访存开销;Gated DeltaNet 一类线性注意力变体更是从根本上削减了 KV Cache 的存储压力。正是这些算法层的进化,让 Qwen 3B–7B 级别的语言模型、视觉语言多模态模型第一次真正“塞进”了边端设备——智能对话、场景理解、语义分析不再是云端专属。
第三代是 物理 AI 与端侧智能体时代。
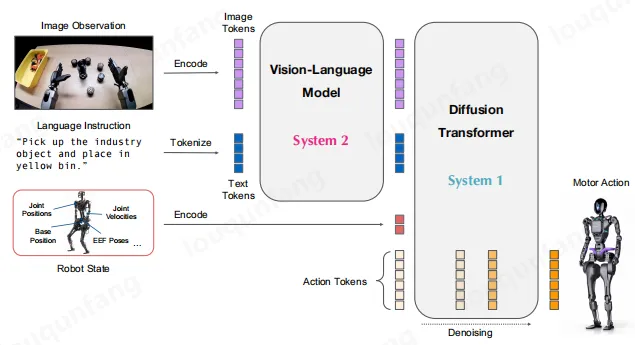
VLA(视觉-语言-动作)模型把感知直接映射为动作,世界模型让设备在“脑内”预演物理后果,强化学习赋予动态决策能力。算法形态从单一网络走向“深度学习 + 逻辑推理 + 知识检索”的异构组合,边端设备从“感知识别”升级为“理解、推理、决策、执行”的自主智能体——机器人的每一步,都是这三代算法的同台演出。
值得注意的是,这三代不是替代关系,而是层层叠加。今天的边端设备往往要同时跑传统视觉检测和大模型交互以及考虑模型算法未来的演进,所以现代边端NPU必须具备多算法兼容、多模态适配、高低算力灵活切换的能力,即深度适配模型算法的演进能力。同时深度贴合底层架构低功耗、可定制的设计特性。
怎么接住这种"既要又要"?一种思路是软件定义硬件——清微智能的可重构 CGRA 计算芯片架构,能在"数据位宽—算子操作—数据通道—计算模式"四个维度上按需动态重构,为不同计算任务构造出最优计算模式,是边端 AI NPU 的一个解法。
架构接得住算法,只是第一步。真正决定算力能不能"放出来"的,是另一层软件——工具链。这一层,恰恰是参数表上最看不见、也最见功力的一层。
三、边端工具链:算力能不能"放出来",就看它
硬件算力再强,也必须依托成熟的工具链才能充分释放价值。边端工具链是连接算法模型与芯片硬件的核心桥梁,直接决定终端开发效率、模型落地精度与最终能效表现。
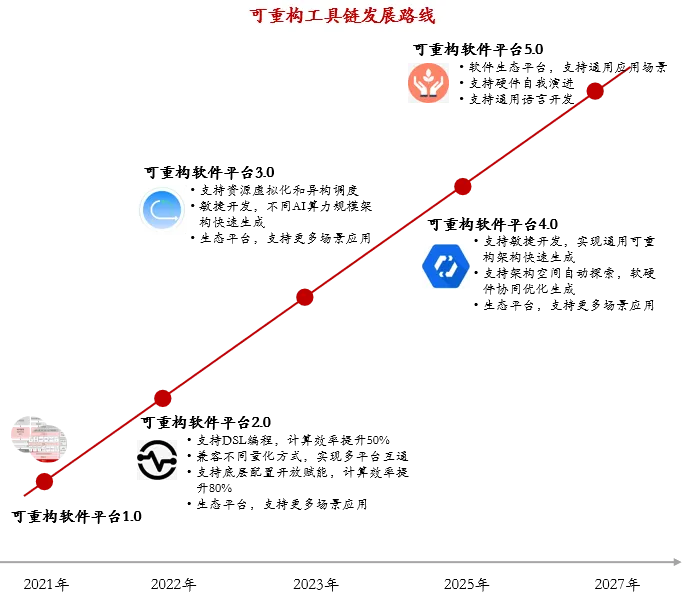
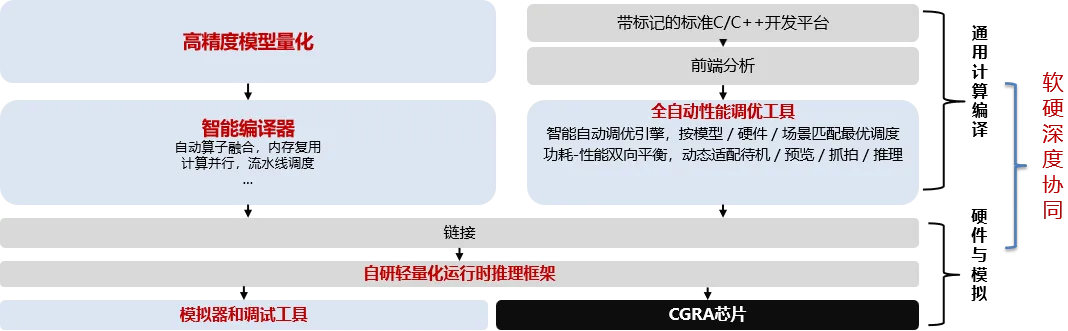
清微智能在边端 AI 可重构工具链软件平台上经过几代发展,沉淀了五大关键技术 :
一是高精度模型量化技术。 支持INT4/INT8/FP16/BF16全精度混合量化,通过量化感知训练、分层动态量化技术,根据网络层敏感度自动匹配最优精度,适配边端低存储、低功耗、高精度的推理需求。
二是智能编译优化技术。 全面兼容ONNX、TensorFlow、PyTorch等主流框架模型输入,具备自动算子融合、内存复用、计算并行、流水线调度等编译优化能力,可以将模型推理性能提升3-5倍;同时支持自定义算子快速扩展,针对性适配行业专属算法。
三是全自动性能调优工具。 内置智能自动调优引擎,根据模型结构、硬件资源、场景需求自动匹配最优算力调度策略,支持功耗-性能双向平衡调优,动态适配待机、预览、抓拍、推理等不同工作状态。
四是自研轻量化Runtime推理框架,充分发挥可重构在运行时软件定义硬件的低功耗优势。 自研轻量级运行时,支持多模型动态加载、并行推理、版本迭代管理;原生适配端云协同架构,支持模型增量更新、在线迭代、云端下发部署。
五是模拟器与调试工具: 搭载周期精确级硬件模拟器,可在芯片流片前完成模型性能、功耗、延迟的全维度评估,大幅缩短研发迭代周期;配套可视化调试分析平台,支持算子级性能拆解与瓶颈定位,实现软硬件协同精准调优。
算力放出来了,但产品要落地,还有一层软件在卡脖子——SDK。很多芯片硬件参数很漂亮,产品却落地困难,问题恰恰出在这里。
四、SDK:硬件决定上限,SDK 决定下限
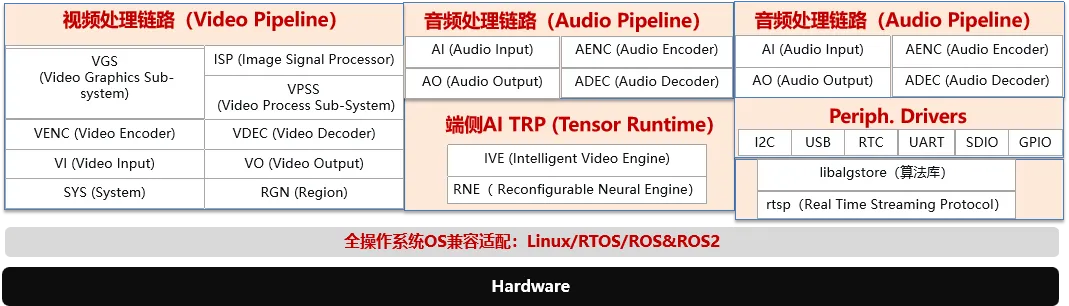
硬件决定性能上限,SDK决定芯片落地下限和生态广度。 SDK 普遍采用分层模块化架构,屏蔽底层硬件差异,对外输出标准化 API,降低客户开发门槛。在通用能力之上,还需要针对行业做深度定制:安防场景优化多路视频并发和告警链路;工业检测强化推理稳定性、时钟同步;机器人场景压低端到端感知延迟;低功耗 IoT 设备做好休眠与功耗管控。
整套 SDK 拆分为视觉、AI 推理、语音、编解码、3D 感知、设备管控等六大组件,组件可独立迭代,内置现成业务模板,帮助开发者快速搭建业务。同时原生支持端云协同,提供模型分层推理、增量更新接口。
边端设备的操作系统呈现高度分化格局,SDK 也分三路适配。RTOS实时系统(智能家居、小型IoT设备、低功耗传感器终端),提供极简裁剪版SDK,极致缩减内存占用与启动耗时,适配毫秒级实时响应;
Linux系统(智能安防、工业检测、高端消费终端),提供完整版SDK,支持多进程并发、多模型调度;
ROS/ROS2 机器人系统(工业机器人、人形机器人、无人车、无人机),深度适配消息机制、节点调度、运动控制逻辑。同时适配FreeRTOS、RT-Thread等衍生系统,实现全品类覆盖。
底座搭好了,路铺平了——但业务价值的兑现,还差最后一公里。
五、场景化算法:打通业务价值的最后一公里
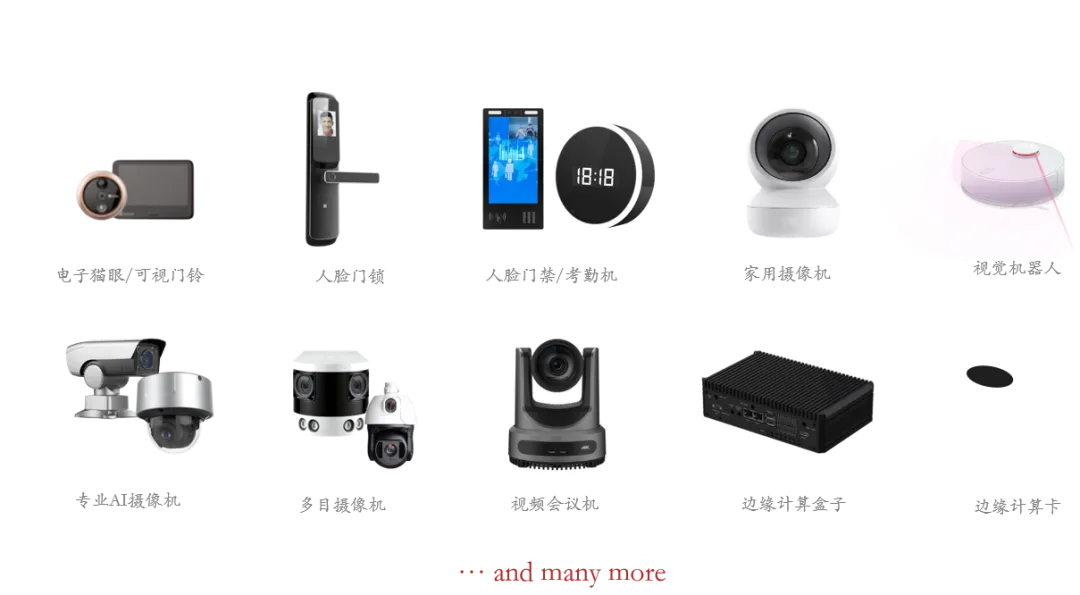
硬件、工具链、SDK搭建完成底座,场景化算法就是打通业务价值的最后一公里。一方面面向安防、工业、机器人等行业定制轻量化模型:软硬件协同剪枝、算子适配、网络重构,提升推理速度与能效;支持小样本学习,降低行业数据标注成本,加速小众场景落地,实现场景化轻量化算法定制。另一方面,依托多模态感知,构建端侧自主的感知-决策-执行闭环端侧智能体(Agent)。设备不再被动响应指令,而是自主理解环境、规划任务、动态调整策略,为人形机器人、无人设备这类具身智能打开新的想象空间。
六、总结:AI下半场,赢在边端全栈能力
完整复盘整套技术栈,可以得出五个核心结论。
第一,软硬件全栈一体化闭环。 异构硬件底座+NPU算力+工具链+SDK软件生态,串联ISP、AI-ISP、CV、编解码、语音、场景算法,形成完整闭环。
第二,通用兼容与场景定制双向平衡 模块化硬件加分层SDK架构,一方面降低开发门槛,另一方面针对碎片化行业做深度性能调优。
第三,软硬件深度协同构筑壁垒 行业竞争已经从硬件参数比拼,走向架构、工具链、SDK生态、场景算法的综合竞争。
第四,工程化平衡是核心壁垒 在碎片化、7×24小时运行、大规模量产的前提下,平衡性能、功耗、成本、可靠性,这才是最难的部分。
** 第五,安全合规原生赋能** 硬件安全启动+SDK安全组件,保护模型与数据隐私,满足各行各业的合规要求。
AI的未来,必然是云端赋能,边端落地。谁能够做好性能、功耗、成本、生态的四维平衡,掌握完整的全栈能力,谁就能拿到千行百业智能化的红利。 未来云边端协同的关键技术有哪些?请期待下一篇技术拆解**
[1] Swin Transformer: Hierarchical Vision Transformer using Shifted Windows
[2] Qwen3 Technical Report
[3] RDT-1B: A DIFFUSION FOUNDATION MODEL FOR BIMANUAL MANIPULATION
[4] GR00T N1: An Open Foundation Model for Generalist Humanoid Robots