ARTICLE · 1071233
论文不再只是 PDF:以后读完一篇论文,还可以直接调用它的方法!
很多人读论文时都有过一种感觉:
论文看懂了,方法也觉得很有价值,但真正想用的时候,事情才刚刚开始。
代码在哪?环境怎么配?输入文件是什么格式?参数怎么设置?论文里的图能不能在自己的数据上复现?如果原作者只给了一个 GitHub 链接,后面往往还要花半天时间自己摸索。
所以,一篇论文最后常常只留下了一份 PDF,方法仍然停留在文字、公式和图表里。
最近,Nature 发表了一篇很有意思的文章,讨论的是另一种可能:能不能把论文连同它背后的代码和工作流,一起变成一个可以被 AI 调用的“研究代理”?
这篇论文介绍的项目叫 Paper2Agent。
它和“让 AI 总结论文”不是一回事
现在很多工具都能回答这样的问题:
• 这篇论文解决了什么问题? • 作者用了什么方法? • 实验结果说明了什么? • 这篇论文和其他工作有什么区别?
这些能力解决的是“理解论文”的问题。
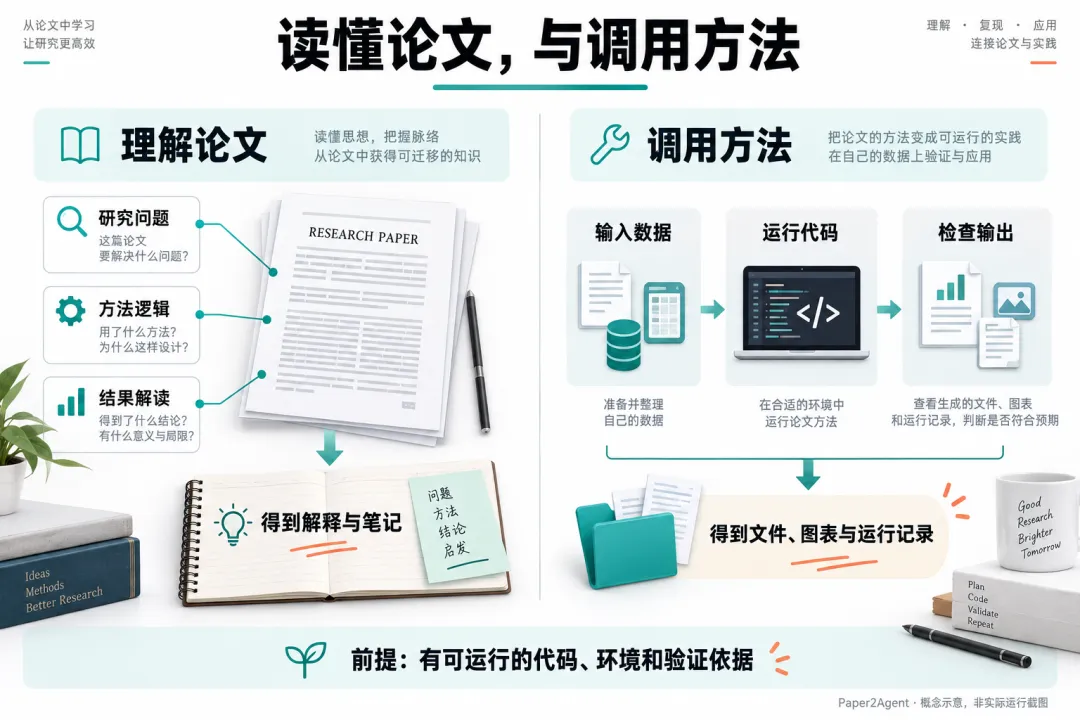
图 1|概念示意:理解论文与运行方法是两个不同的环节,并非实际运行截图。
Paper2Agent 想解决的,是下一步:
读完这篇论文以后,能不能直接调用它的方法?
比如,你读到一篇新的单细胞分析论文。传统的使用方式是先理解方法,再去找代码,配置环境,下载数据,照着教程运行,最后再把自己的数据替换进去。
如果这篇论文被转换成了一个可调用的研究代理,理想的交互方式会变成:
“请按照这篇论文的方法处理我的 .h5ad 文件,使用作者推荐的参数,输出聚类结果,并生成和论文中类似的图。”
这时,AI 不只是告诉你“论文采用了某种聚类方法”,而是尝试调用对应的代码,处理输入数据,运行流程,并返回结果。
当然,“尝试调用”非常重要。它并不意味着所有论文都能自动运行,也不意味着运行出来的结果天然可信。真正的关键在于:论文的方法有没有被封装成清晰的工具,并且经过了验证。
Paper2Agent 到底做了什么
Paper2Agent 不是简单地把 PDF 喂给一个聊天机器人。
它的思路是,让多个 AI agent 协同分析论文、代码仓库和相关材料,然后把其中可以执行的研究方法封装成 MCP server。这个 server 里通常包含三类东西:
1. 可以执行的方法工具
论文中的核心分析流程,会被包装成一个个可以调用的工具。
工具需要说明输入是什么、参数有哪些、输出是什么,以及它对应论文里的哪一部分方法。
这一步决定了论文里的“方法描述”能不能变成真正可操作的接口。
2. 论文和代码资源
除了工具本身,论文正文、补充材料、代码、数据说明、示例脚本和图表,也可以作为可检索的资源保留下来。
这样,AI 在调用方法时,不只是凭记忆猜参数,还可以回到原始材料里查找依据。
3. 复杂任务的操作提示
有些方法不是调用一个函数就结束了。
它可能需要先预处理数据,再运行主模型,然后进行统计分析和可视化。对于这类任务,还需要把“先做什么、后做什么、结果如何检查”组织成一个工作流。
Paper2Agent 会把这些工作流进一步整理成可以复用的提示和操作步骤。
简单说,它试图把一篇论文从“可阅读的文档”,变成一个包含文档、代码、数据说明、工具和工作流的研究对象。
它是怎样把论文变成工具的
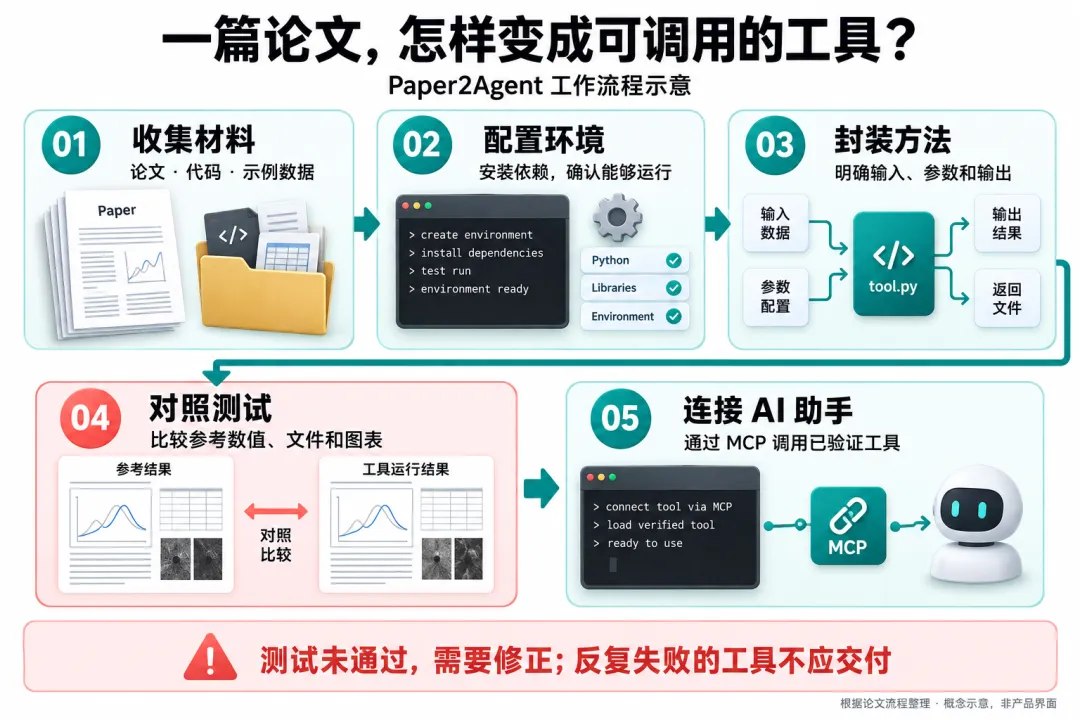
图 2|根据论文流程整理的示意图。对照测试是工具交付前的重要步骤,图中终端和结果均为示意。
从项目公开的流程来看,大致可以分成几步。
首先,系统需要找到论文对应的代码仓库,分析项目结构,识别入口文件、依赖环境、示例数据和主要运行方式。如果论文没有代码,或者代码无法运行,后面的工作就会受到很大限制。
接下来,多个 agent 会分别理解论文方法和代码实现,尝试找出适合封装的函数或分析流程,并为它们设计输入输出接口。
然后,系统会生成 MCP server,把这些方法暴露成可以被 Claude Code、Codex 等支持 MCP 的工具调用的接口。
最后,还需要运行测试。测试不只是检查“程序有没有报错”,还要尽量比较输出结果、关键数值和论文中的参考结果或图表。
这一步尤其重要。
如果只完成了代码封装,没有经过参考结果验证,那么它可能只是一个看起来很完整的接口,并不一定真正实现了论文中的方法。
论文里的几个例子
Nature 这篇文章展示了几个不同方向的案例,包括 AlphaGenome、Scanpy 和 TISSUE。
以 AlphaGenome 为例,项目报告称,系统围绕它生成了 22 个 MCP 工具,并对这些工具进行了自动化验证。论文还报告了在教程任务和新查询上的测试结果。
这些数字可以说明自动封装和测试已经具备一定可行性,但不应该被理解为“任何论文都能在几十分钟内稳定完成转换”。它们是特定项目、特定代码环境和特定测试条件下的结果。
真正有价值的地方,在于它展示了一种新的使用方式:
研究者不一定要先学会整个代码库的目录结构,才可以开始尝试一个方法。经过封装之后,可以先用自然语言描述任务,再由 AI 调用相应工具;需要进一步确认时,还可以回到论文、代码和测试结果中检查依据。
对科研人员来说,最实际的变化是什么
我觉得,最值得关注的不是“以后不用读论文了”,而是论文和代码之间的距离可能会缩短。
过去,论文阅读和方法复现经常是两件事:
• 阅读论文,理解研究问题和方法逻辑; • 打开代码仓库,重新学习实现细节和运行方式。
以后更理想的状态,是把这两件事放在同一个研究对象里:
先问论文解决了什么问题,再询问方法适合什么数据;读懂之后,直接运行一个小规模示例;确认流程以后,再换成自己的数据;最后把运行结果、参数和引用一起保存下来。
这对方法类论文尤其有吸引力。
比如统计模型、单细胞分析、图像分析、网络分析和生物信息学流程,都比较适合被拆成一系列有明确输入和输出的工具。对于这些方向,论文不再只是“告诉你某种方法存在”,还可能成为一个可以继续操作的入口。
但不是每篇论文都能变成可调用的方法
这里需要把边界说清楚。
一篇论文能不能被可靠地转换,至少取决于几个条件。
有可运行的代码
只有文字、公式和实验结果,没有公开实现的论文,通常无法直接变成一个真正能执行的方法工具。
AI 可以根据论文描述生成一个近似实现,但“根据论文重写代码”和“调用论文作者的原始方法”是两回事。
依赖环境能够复现
代码即使公开,也可能依赖旧版本框架、特定硬件、私有数据、外部 API 或没有公开的配置文件。
如果环境无法稳定运行,工具封装得再漂亮,也很难用于实际研究。
输入输出足够明确
好的工具需要知道接受什么数据、数据格式是什么、哪些参数是必须的,以及输出应该如何解释。
很多论文的真实流程依赖实验经验和隐含判断,并没有完整写进论文或代码。这部分很难仅靠自动化转换补齐。
有可检查的参考结果
如果没有示例数据、教程输出或参考图表,就很难判断封装后的工具是否真的实现了论文方法。
能运行,不等于运行正确;能生成一张图,也不等于这张图可以用于科研结论。
最重要的限制:跑通不等于适合你的数据
图 3|使用前的检查清单。参数与环境示例不代表所有研究方法的必需配置。
即使一个论文代理成功复现了作者的示例结果,也只能证明它在相近的条件下完成了这套流程。
换成你的数据以后,仍然需要检查:
• 数据预处理是否一致; • 参数是否适合当前数据; • 版本和运行环境是否发生变化; • 输出是否符合方法的适用范围; • 结果是否有独立的统计或实验依据。
因此,论文代理更像一个可复用的研究助手或方法入口,而不是自动替你完成科研判断的黑盒。
它可以帮你减少寻找代码、配置环境和理解调用方式的成本,但不能替你决定一个结果是否足够可靠,更不能替你完成方法学上的审查。
论文会从“文件”变成“研究资产”吗
如果这种方式继续发展,论文在科研工作流中的角色可能会发生一点变化。
过去我们保存一篇论文,主要保存的是 PDF、笔记和引用信息。
以后,一篇论文还可能关联:
• 它使用的代码和运行环境; • 可调用的方法工具; • 示例数据和验证结果; • 适用范围与限制; • 基于它产生的新分析和图表。
这样,论文就不只是“读过的一份资料”,而是一个可以继续进入研究流程的节点。
这也是我觉得 Paper2Agent 值得关注的原因。它没有简单地把“AI 阅读论文”再包装一次,而是在尝试回答一个更具体的问题:
一篇论文里的方法,能不能被别人真正用起来?
对于科研工作者来说,未来最有价值的论文,可能不仅是结论清楚、影响力高,还包括方法是否可复现、代码是否可调用、工作流是否容易复用。
论文读完以后,如果还能直接试一遍方法,很多“看起来懂了”的内容,才有机会变成真正的研究能力。
你平时最希望哪一类论文可以直接调用?是单细胞分析、统计模型、图像处理,还是实验数据的自动分析?