ARTICLE · 1072985
先进封装——为什么AI芯片越来越“不是一颗芯片”,而是一座微型城市?
先进封装——为什么AI芯片越来越“不是一颗芯片”,而是一座微型城市?前面我们已经讲完了光刻、刻蚀、薄膜沉积、CMP、清洗、检测和测试。到了这里,一个很容易被忽略的问题出现了:芯片制造完成以后,为什么还需要如此复杂的封装? 答案是,AI芯片的竞争已经不只是“晶体管做得多不多”,而是逐渐变成了计算芯片、HBM、Chiplet、互连、供电和散热能不能高效地组织在一起。 过去,一颗芯片通常可以理解为一个相对完整的SoC:CPU、GPU、缓存、接口等功能尽可能集成在一块晶圆上。 但AI时代不一样。 AI GPU需要越来越大的计算能力,同时又需要大量HBM提供高速数据吞吐。如果简单地继续把所有功能都做在一颗超大型Die里面,会遇到掩膜尺寸、良率、成本和制程复杂度等问题。 于是产业开始走向另一条路线: 大芯片 → Chiplet拆分 → 多颗Die → 高密度互连 → HBM集成 → 先进封装 → 一个完整的AI计算系统。 这也是为什么今天的先进封装,已经越来越接近“芯片级系统工程”。 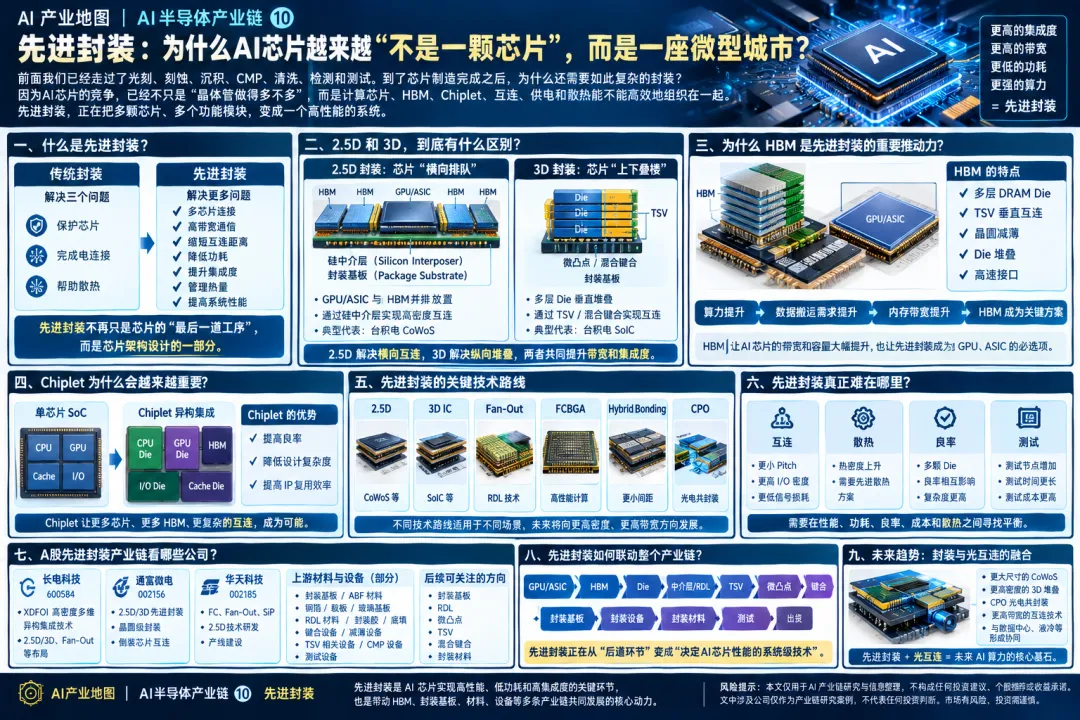
传统封装更多解决的是三个问题: 保护芯片 → 完成电连接 → 帮助散热。 而先进封装解决的问题更加复杂: 多芯片连接 → 高带宽通信 → 缩短互连距离 → 降低功耗 → 提升集成度 → 管理热量 → 提高系统性能。 因此,先进封装已经不再只是芯片制造完成后的“最后一道工序”,而逐渐成为芯片架构设计的一部分。 台积电目前将CoWoS、SoIC、InFO等技术统一纳入3DFabric平台,其中CoWoS主要面向2.5D异构集成,SoIC则面向3D芯片堆叠。台积电明确将这些技术用于AI和HPC,并持续扩大封装尺寸和HBM集成能力。(台积电) 简单理解: 传统封装:把一颗芯片装起来。 先进封装:把CPU/GPU/HBM/Chiplet等多个“功能模块”组织成一个完整系统。 ⸻ 这是理解AI先进封装最重要的两个概念。 典型结构可以理解为: GPU/ASIC + HBM + HBM + HBM → Silicon Interposer → Package Substrate 多个芯片并排放置,通过中间的**硅中介层(Silicon Interposer)**实现高密度互连。 因此它并不是真正意义上的“芯片上下堆叠”,但芯片之间的通信距离已经大幅缩短。 台积电的CoWoS就是典型代表,其核心价值之一就是把计算芯片和多个HBM堆栈放到同一个先进封装中。(3DFabric) 这也是为什么现在AI GPU和HBM经常被放在一起讨论。 因为: GPU算力越强 → 数据吞吐需求越高 → HBM需求越大 → GPU与HBM之间需要更高带宽 → 先进封装的重要性越高。 ⸻ 2.5D主要解决横向互连问题,而3D进一步走向纵向堆叠。 可以简单理解为: Die → Die → Die → Die 通过TSV、混合键合、微凸点等技术实现垂直方向的高密度连接。 台积电SoIC就是3D芯片堆叠平台,可以支持Chiplet的Chip-on-Wafer和Wafer-on-Wafer等方案,并与CoWoS等先进封装技术进一步组合。(台积电) 3D封装最大的优势是: 互连距离更短 → 带宽更高 → 延迟更低 → 功耗更低 → 单位面积集成度更高。 但与此同时,它也带来了新的问题: 散热更难、制造更复杂、良率控制更难、测试更复杂。 所以先进封装并不是简单地“堆得越多越好”,而是需要在性能、功耗、良率、成本和散热之间寻找平衡。 ⸻ 如果说GPU负责“算”,那么HBM可以理解为AI芯片的“高速数据仓库”。 AI模型训练和推理过程中,需要不断向计算单元提供大量数据。 因此: 算力提升 → 数据搬运需求提升 → 内存带宽提升 → HBM成为重要方案。 而HBM并不是普通的DRAM。 它本身就是一种3D堆叠内存: 多层DRAM Die → TSV垂直互连 → 底部逻辑Die → 高密度封装 → GPU/AI加速器 最终再通过先进封装,把HBM与GPU/ASIC连接起来。 所以AI产业链实际上形成了一个非常清晰的闭环: AI模型 → GPU/ASIC → HBM → 先进封装 → 高速互连 → 数据中心。 这也是为什么AI算力需求增长,不仅会带动GPU,也会同时拉动HBM、封装基板、硅中介层、RDL、微凸点、键合、测试等环节。 ASE也明确将2.5D/3D封装用于高端GPU、FPGA、数据中心网络芯片和AI加速器,并指出其核心价值之一就是实现GPU、CPU与HBM等不同芯片的高密度集成。(ASE Global) ⸻ Chiplet可以理解成: 把一颗“大芯片”拆成多个“小芯片”。 例如: CPU Die + GPU Die + I/O Die + Cache Die + HBM → 先进封装 → 完整计算系统 这样做有什么好处? 第一,提高良率。 如果一颗超大型Die出现一个缺陷,可能整颗芯片都报废;而拆成多个Chiplet后,可以降低单颗Die的面积和制造难度。 第二,降低设计复杂度。 不同功能可以使用不同制程。 例如: 计算Die采用先进制程 → I/O Die采用成熟制程 → 模拟/电源部分采用其他制程。 第三,提高IP复用效率。 不同Chiplet可以组合成不同产品。 因此Chiplet实际上正在推动半导体从: “SoC单芯片时代” → “系统级异构集成时代”。 长电科技的XDFOI平台就是国内先进封装领域值得跟踪的技术路线之一,公司披露其XDFOI芯粒高密度多维异构集成技术已经进入量产阶段,并应用于高性能计算、AI等领域。(巨潮资讯) ⸻ 很多人会认为先进封装只是“把芯片装在一起”,实际上真正难的是互连、热管理、可靠性和良率。 AI芯片内部的数据传输量越来越大。 因此需要: 更小Pitch → 更高I/O密度 → 更短互连距离 → 更低信号损耗。 微凸点、RDL、TSV、混合键合等技术的重要性都会因此提升。 GPU本身功耗已经很高,再加上HBM、Chiplet和高密度封装,单位面积热流密度进一步增加。 于是: 先进封装 → 高密度集成 → 热密度上升 → 散热技术必须同步升级。 这也是为什么AI服务器产业链中,液冷、热界面材料、封装散热结构等会与先进封装逐渐产生越来越紧密的联系。 先进封装往往涉及多颗Die。 假设: GPU良率 × HBM良率 × 中介层良率 × 封装良率 × 测试良率 任何一个环节出现明显问题,都可能影响最终产品。 因此先进封装实际上会把“芯片制造良率”进一步延伸到“系统级良率”。 这也与我们上一章讲的测试设备直接连接起来。 完整链条变成: 晶圆测试 → Die筛选 → HBM测试 → Chiplet测试 → 封装 → Final Test → SLT 芯片越复杂,测试节点就越多。 ⸻ 目前可以重点关注几条路线: 2.5D: GPU/ASIC + HBM + Silicon Interposer 3D IC: Die + Die垂直堆叠 Chiplet: 不同功能Die进行异构集成 Fan-Out: 通过RDL实现高密度封装 FCBGA: 面向高性能计算、大尺寸芯片的重要封装形式 Hybrid Bonding: 进一步降低互连间距,推动3D集成向更高密度发展 Co-Packaged Optics(CPO): 进一步把光学器件与计算/交换芯片进行更紧密的封装级集成。 未来随着AI集群内部数据交换量继续提升,先进封装与光互连之间的边界也会越来越模糊。 ⸻ 从A股产业链角度,可以重点关注三类企业。 第一类:封测龙头 长电科技(600584) 公司在先进封装领域布局较深,XDFOI高密度多维异构集成技术已经进入量产阶段,并覆盖2D、2.5D、3D Chiplet方向。2025年年报也明确将2.5D/3D、Fan-Out、微间距互连等列为先进封装重要发展方向。(巨潮资讯) 通富微电(002156) 公司布局2.5D/3D先进封装,官网披露其在晶圆级封装、倒装芯片互连等领域提供2.5D/3D集成方案;此前其2.5D/3D生产线也已进入设备安装、调试和工程验证阶段。(TFME) 华天科技(002185) 公司覆盖FC、Fan-Out、SiP、晶圆级封装等多种技术,并持续推进2.5D等先进封装技术研发和产线建设。公司2024年年报披露已完成2.5D产线建设和设备调试。(巨潮资讯) 这三家公司更适合放在**“先进封测制造能力”**这个维度研究,而不是简单理解成同一种技术路线。 ⸻ 真正值得研究的并不只是封测厂。 先进封装产业链可以继续拆解: GPU/ASIC → HBM → Die → Silicon Interposer/RDL → TSV → 微凸点 → 键合 → 封装基板 → 封装设备 → 封装材料 → 测试 因此后续可以继续往上游研究: 封装基板、ABF材料、铜箔、载板、玻璃基板、RDL材料、封装胶、底填材料、键合设备、减薄设备、TSV相关设备、CMP设备、测试设备。 尤其值得注意的是,随着AI芯片封装尺寸不断扩大,封装基板和互连技术的重要性也在提升。 台积电已经公布更大尺寸CoWoS路线,2026年相关技术规划继续向更大中介层尺寸和更多HBM集成发展;这说明未来AI芯片的“封装面积”本身可能成为影响算力扩展的重要工程变量。(台积电) ⸻ 现在把我们前面10篇内容串起来: AI模型需求 → GPU/ASIC → 先进制程 → 光刻 → 刻蚀 → 沉积 → CMP → 清洗 → 检测 → 测试 → HBM → Chiplet → 2.5D/3D先进封装 → 高速互连 → AI服务器 → 数据中心 这条链条里,先进封装正在发生一个非常重要的变化: 过去它更多是芯片制造的后端环节。 现在它越来越接近: 决定AI芯片最终性能的重要系统级技术。 所以研究AI半导体,不能只盯着GPU和先进制程。 未来真正值得持续跟踪的一个问题是: 当单颗芯片继续缩小越来越困难之后,AI算力还能怎么增长? 答案之一,就是: 把更多芯片、更多HBM、更多互连能力,放进一个更大的“封装系统”里。 这就是先进封装。 下一篇我们继续向上游拆: 《AI半导体产业链⑪:HBM——为什么AI芯片越来越离不开“高带宽内存”?》 风险提示:本文仅用于AI产业链研究与信息整理,不构成任何投资建议、个股推荐或收益承诺。文中涉及公司仅作为产业链研究案例,不代表任何投资判断。市场有风险,投资需谨慎。