ARTICLE · 1089940
技术分享:当复杂文档遇见智能解析
点击蓝字,关注我们
——文析,让数据自己说话
本地离线 OCR | 智能版面识别 | 复杂数据治理
01
引子:一份流水单,难倒了多少人
司法实践中,一份银行流水往往不是一张干净的表格。标题、户名、账号、表头、交易明细、小计、备注,全部混杂在同一个页面里;遇上司法协助查询场景,文件带公章、字段多达数十项、表格无框线、跨页续表更是常态。这样的材料,机器「看得见」,却「读不懂」。
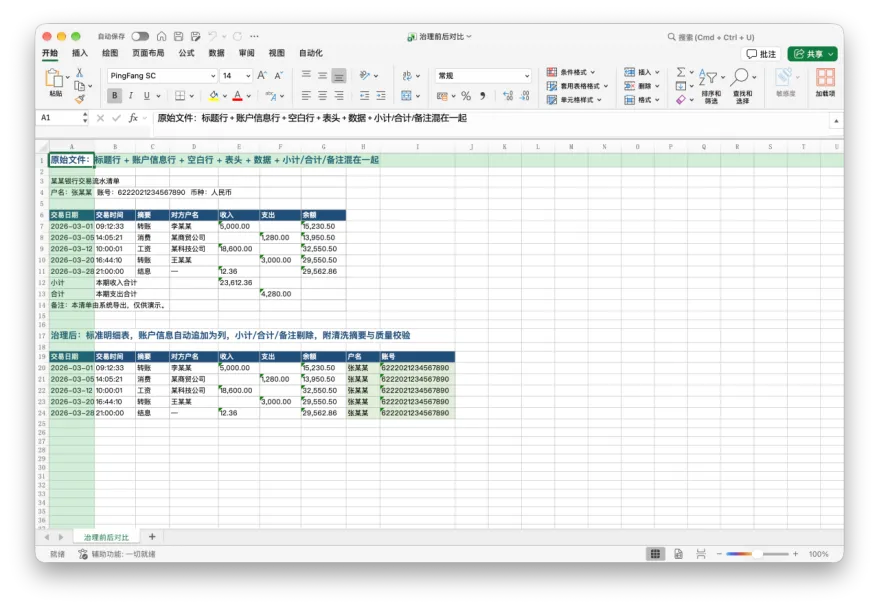
图1 银行系统导出的原始流水:标题、账户信息、表头、数据、小计、备注混杂呈现
数据并非以结构化的行列关系存在,而是以视觉排版的形式呈现。摆在办案人员面前的只有两条路:要么人工逐行整理,一份流水耗去半天;要么上传云端 OCR 服务,让敏感数据离开本机——前者低效,后者越线。
文析给出了第三条路:把 OCR、版面识别、结构还原、数据治理全部放进本地。材料不出本机,结果不经外网,复杂文档进,标准数据出。
一句话:让机器替你读懂表格,让数据自己开口说话——全程本地、离线、可控。
02
痛点:为什么传统方案行不通?
办案、审计、财务核对,凡是高强度处理数据的场景,都绕不开三类最难啃的材料:
混合表——标题、账户信息、表头、数据、小计、备注层层堆叠,人工整理动辄数十分钟;
扫描件与拍照件——有边框、无边框、多重表头、合并单元格,格式千差万别,没有统一模板可套;
无框线 PDF——流水单据、司法文书缺乏显式框线,传统工具连表格在哪都找不到,更谈不上还原结构。
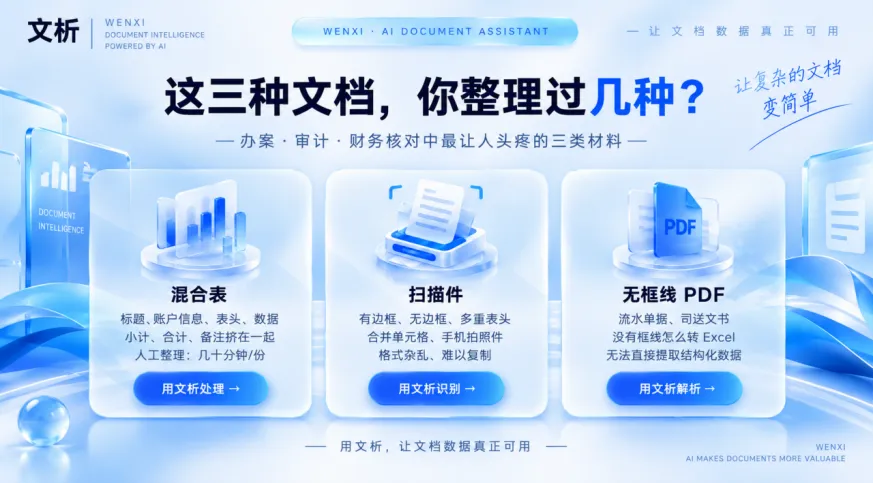
图2 三类最具挑战性的文档类型
三类材料看似不同,病根却是同一个:数据以视觉排版而非结构化形式存在。而司法协助查询文件往往还带公章、含数十项溯源字段(IP 地址、MAC 地址、商户编号等),数据敏感性极高,绝不允许离开本地半步。
传统方案为什么集体失效?云端 OCR 触碰合规红线,本地工具读不懂复杂版面,通用软件分不清哪行是数据、哪行是小计。三道坎叠加,构成了一个长期悬而未决的技术困局。
文析的破题思路只有一条:识别、理解、治理全部本地完成,从源头杜绝数据外泄的可能。
03
解法:四步链路,从「看得见」到「用得上」
文析把一份复杂文档变成标准数据,只需四步。每一步的输出都是下一步的输入,环环相扣:
第一步,识别文字——本地 OCR 引擎将图像转为文本,中英文混合印刷体通吃,断网也能跑。
第二步,理解版面——不只认字,更读懂结构:哪里是标题、哪里是正文、哪里是表格、阅读顺序如何,一一拆解。常规材料走快速模式,复杂版面走精细模式,按场景自适应。
第三步,还原表格——把表格区域重建为行列结构,有边框、无边框、多重表头、合并单元格,统统自适应。
第四步,治理数据——混合表变身标准明细表:标题说明提取为全局信息,表头映射为标准字段,数据行逐条保留,小计合计备注自动剔除,账户信息自动下填到每一行。
四步之中,真正的技术壁垒藏在后两步——版面识别与数据治理,这正是文析的两项核心能力。
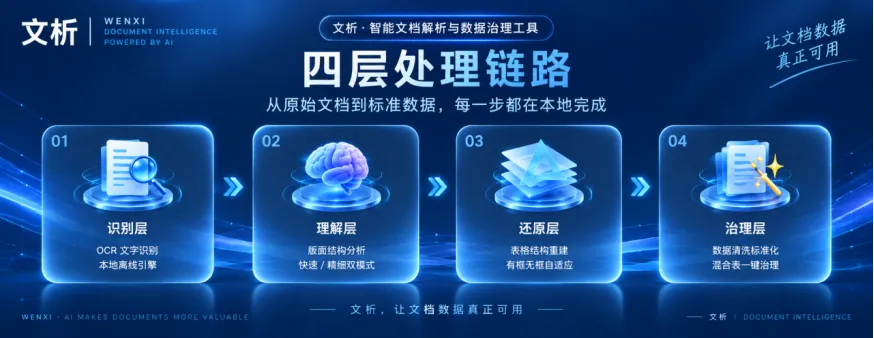
图3 四层处理链路:从原始文档到标准数据
04
核心能力:智能版面识别
版面识别是四步链路的「眼睛」:它决定机器能否看清文档的结构。文析采用快速 / 精细双模式——常规材料走快速模式,秒级出结果;复杂版面走精细模式,标题、正文、表格、阅读顺序逐一还原。按场景自适应,不为速度牺牲精度,也不为精度浪费等待。
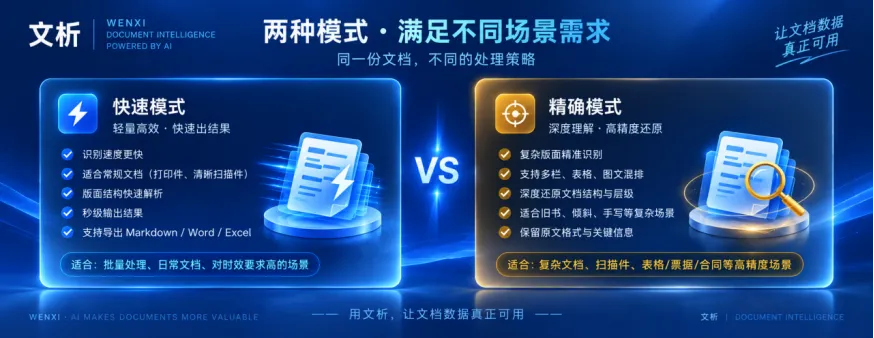
图4 快速 / 精细双模式对比
【识别前】上传待识别文件
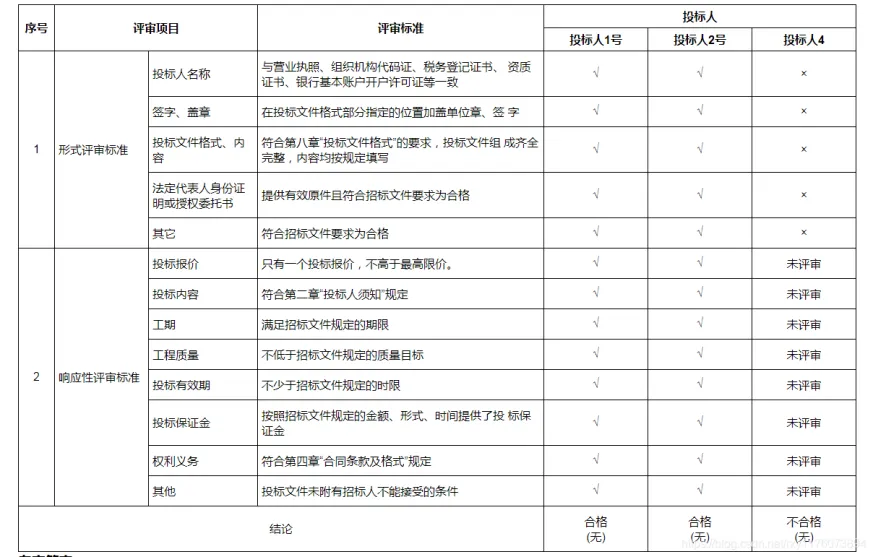
图5 识别前:上传待识别文件,支持批量导入
【识别后】识别结果:结构自动还原
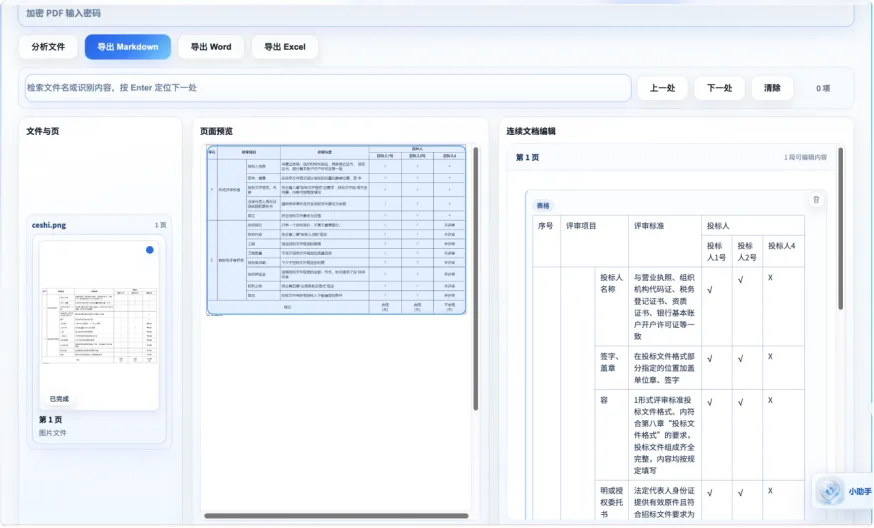
图6 识别后:标题、正文、表格结构自动还原,可导出 Markdown / Word / Excel
日常办公中,大家最熟悉的识别工具莫过于 WPS 的图片转文字——但它的 OCR 基于云端处理,图片和识别结果都要经过远端服务器。对普通文档这无可厚非,可一旦碰上银行流水、案件材料这类敏感文档,「上传」这个动作本身就越过了合规红线。文析走的是另一条路:本地离线 OCR,不调用任何公网云端服务,不上传文件,不上传识别内容——敏感数据从进到出,没有离开过你的电脑。
05
核心能力:复杂数据治理
这是文析最具技术深度的能力,也是区别于市面所有工具的核心壁垒。
治理引擎做的不是简单的格式转换,而是基于行角色识别的语义重构。系统自动判断每一行扮演什么角色——标题行、说明行、表头行、数据行、小计行、合计行、备注行、空白行,再按角色执行差异化策略:标题说明提取为全局信息,表头映射为标准字段,数据行保留,小计合计备注剔除,账户信息自动下填至每条明细。
难在哪?不同银行、不同系统导出的表格千差万别,没有统一模板可套。治理引擎必须在没有任何模板可以套用的情况下,自主推断表头位置、字段含义、数据边界——这正是它的算法价值所在。说得再直白一点:给它一张没见过的表,它也能像人一样读懂。
【案例 1· 银行流水混合表】标题 + 账户信息 + 小计备注混杂
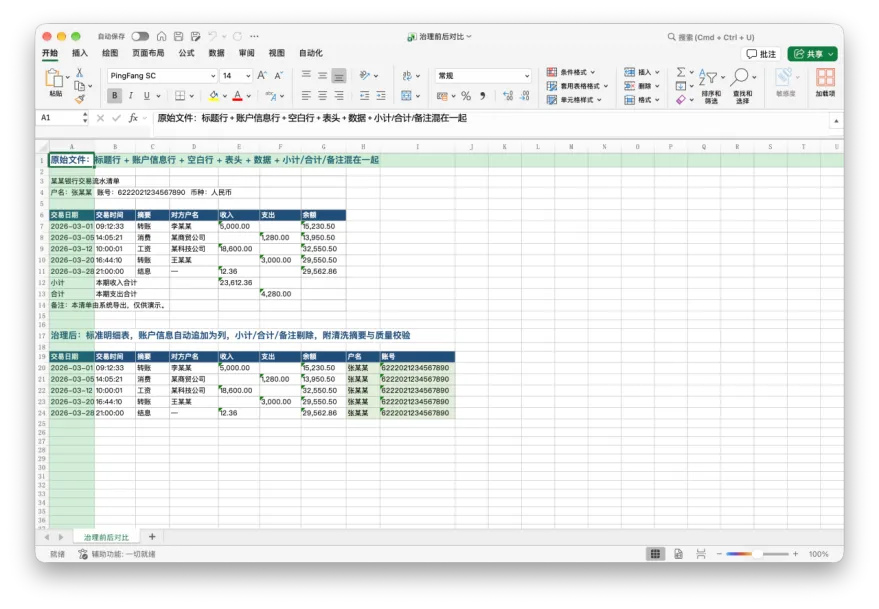
图7 银行流水治理前后对比:账户信息自动追加为列,小计/合计/备注剔除,数据完整保留
【案例2 · 分页续表流水】跨页重复表头 + 续页标注
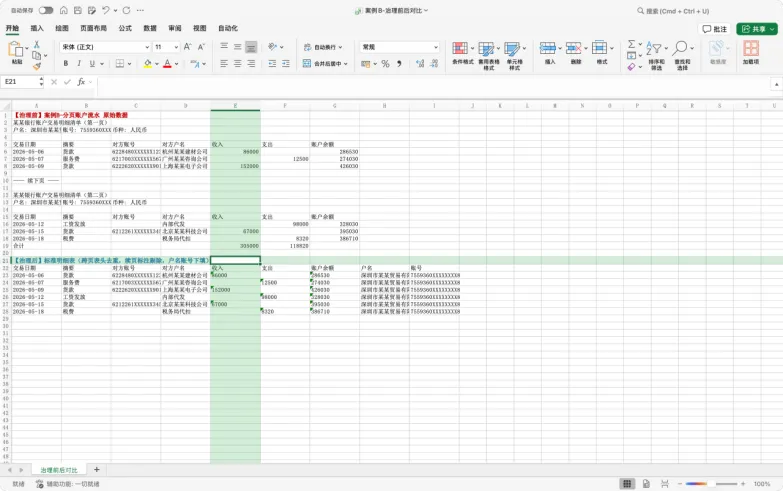
图8 分页流水治理前后对比:上半为原始数据(跨页重复表头、「续下页」标注、页首信息重复),下半为治理后标准明细表(表头去重、续页标注剔除、户名账号逐行下填)
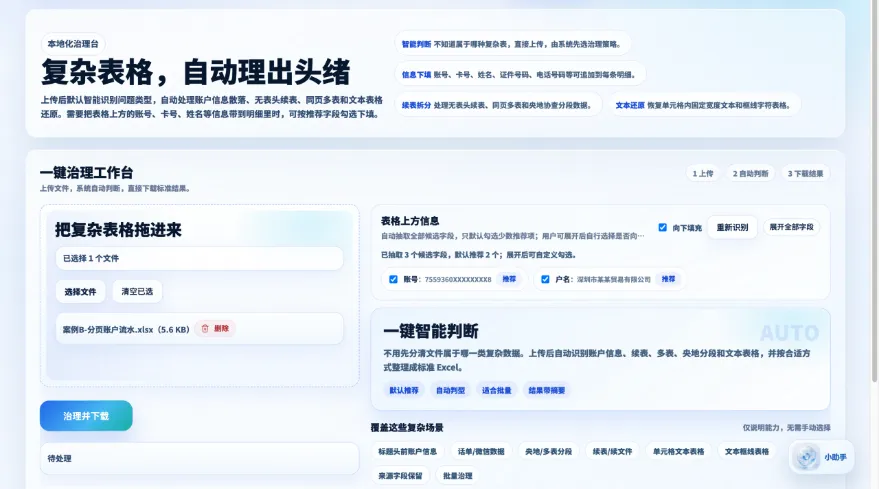
图9 治理工作台:账号、户名被自动识别为推荐字段(默认勾选),可一键向下填充
以分页流水为例:第一页是表头 + 数据 +「续下页」标注,第二页标题、户名、表头重复出现后再接数据。治理引擎自动识别重复表头与续页结构,把跨页数据合并成一张完整明细表,户名账号逐行下填到全部 6 条交易记录。实测结果:重复表头去重、续页标注剔除、账户信息下填率 100%。
混合表、多级表头、分页续表——三类最典型的复杂表,均在数秒内完成治理,全程本地运行,文件不出本机。
06
不止于算法:23项文档工具,一站式配齐
核心能力之外,文析还内置了 23 项文档工具,覆盖 PDF 处理、格式转换、Excel 工具、签章工具四大类——从拿到材料到产出成果,不用在多个软件之间来回切换。
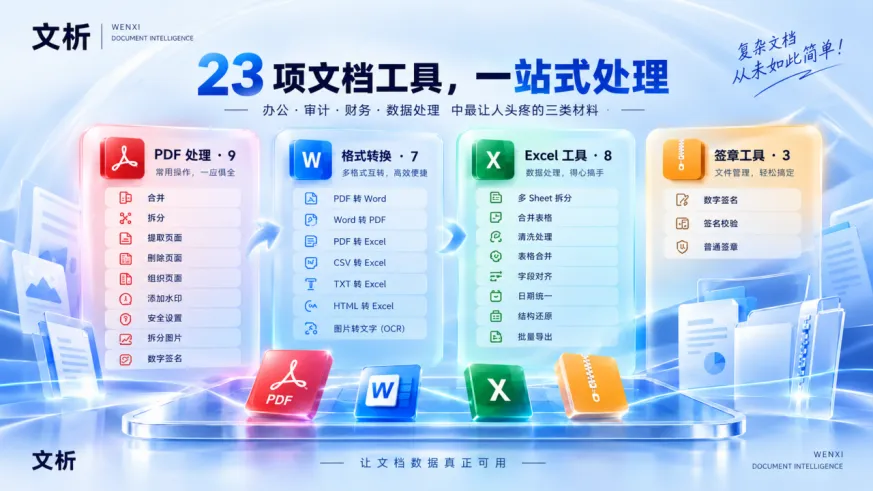
图10 23 项文档工具总览
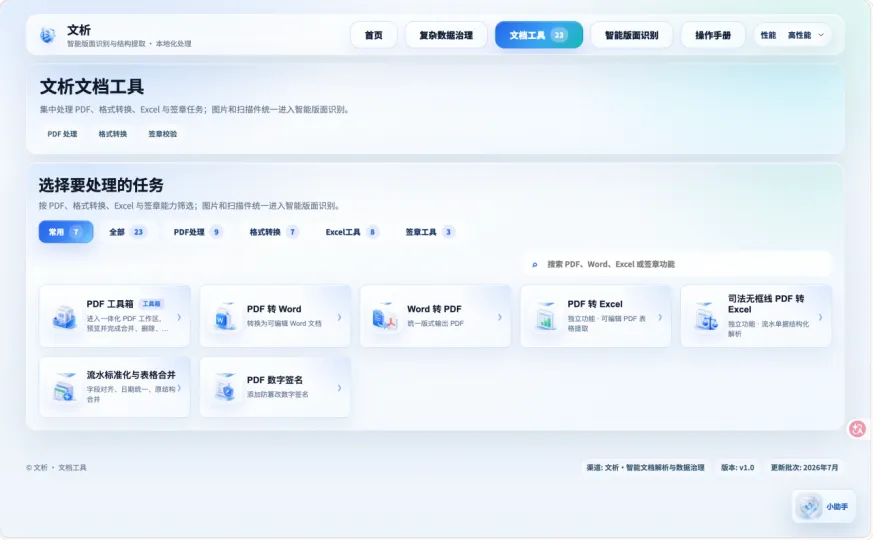
图11 文档工具集界面:PDF 处理 9 项、格式转换 7 项、Excel 工具 8 项、签章工具 3 项
07
核心要点
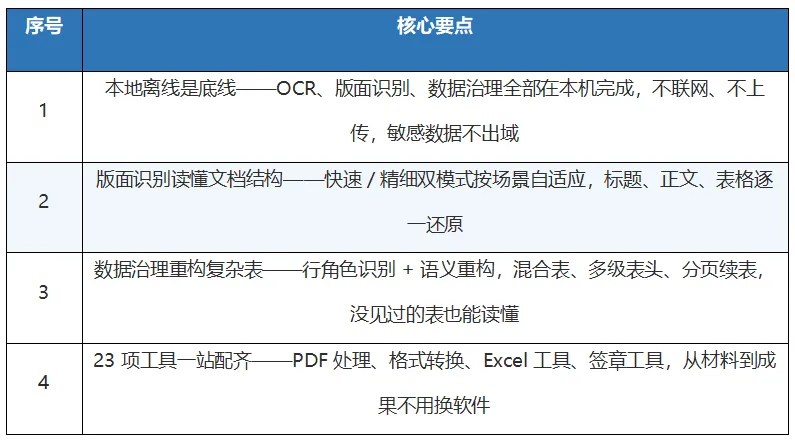
表1 四条核心要点
08
结语
文析解决的问题很朴素:让一线人员从「手工整理表格」中解放出来,把时间还给真正需要专业判断的环节。
多项核心能力——行角色识别驱动的数据治理、快速精细双模式的智能版面识别,加上本地离线 OCR 与 23 项文档工具,串起了从「获取材料」到「产出可用数据」的完整链路。
「数据不该是负担,而该是证据、是依据、是效率。」 文析,让每一页复杂文档都能被读懂。