ARTICLE · 1102781
AI刚上线是神,两周后成人工智障?1万美元实测揭开最大玄学:真相揭晓
你一定经历过这种让人抓狂的时刻
一款前沿大模型刚发布,全网吹上天,仿佛人类瞬间跨入了通用人工智能(AGI)的大门。第一天你用它写代码、解难题,流畅得如同外星科技。
然而,仅仅过了两三周,画风急转直下
它开始变得拖沓、敷衍、频繁道歉,甚至一遇到稍微复杂的长逻辑就中途罢工。社交媒体上瞬间炸锅:“官方肯定偷偷降配了!”“绝对是把权重蒸馏阉割了!”
面对漫天质疑,AI 实验室的回答永远只有冷冰冰的一句话:底层模型什么都没改。
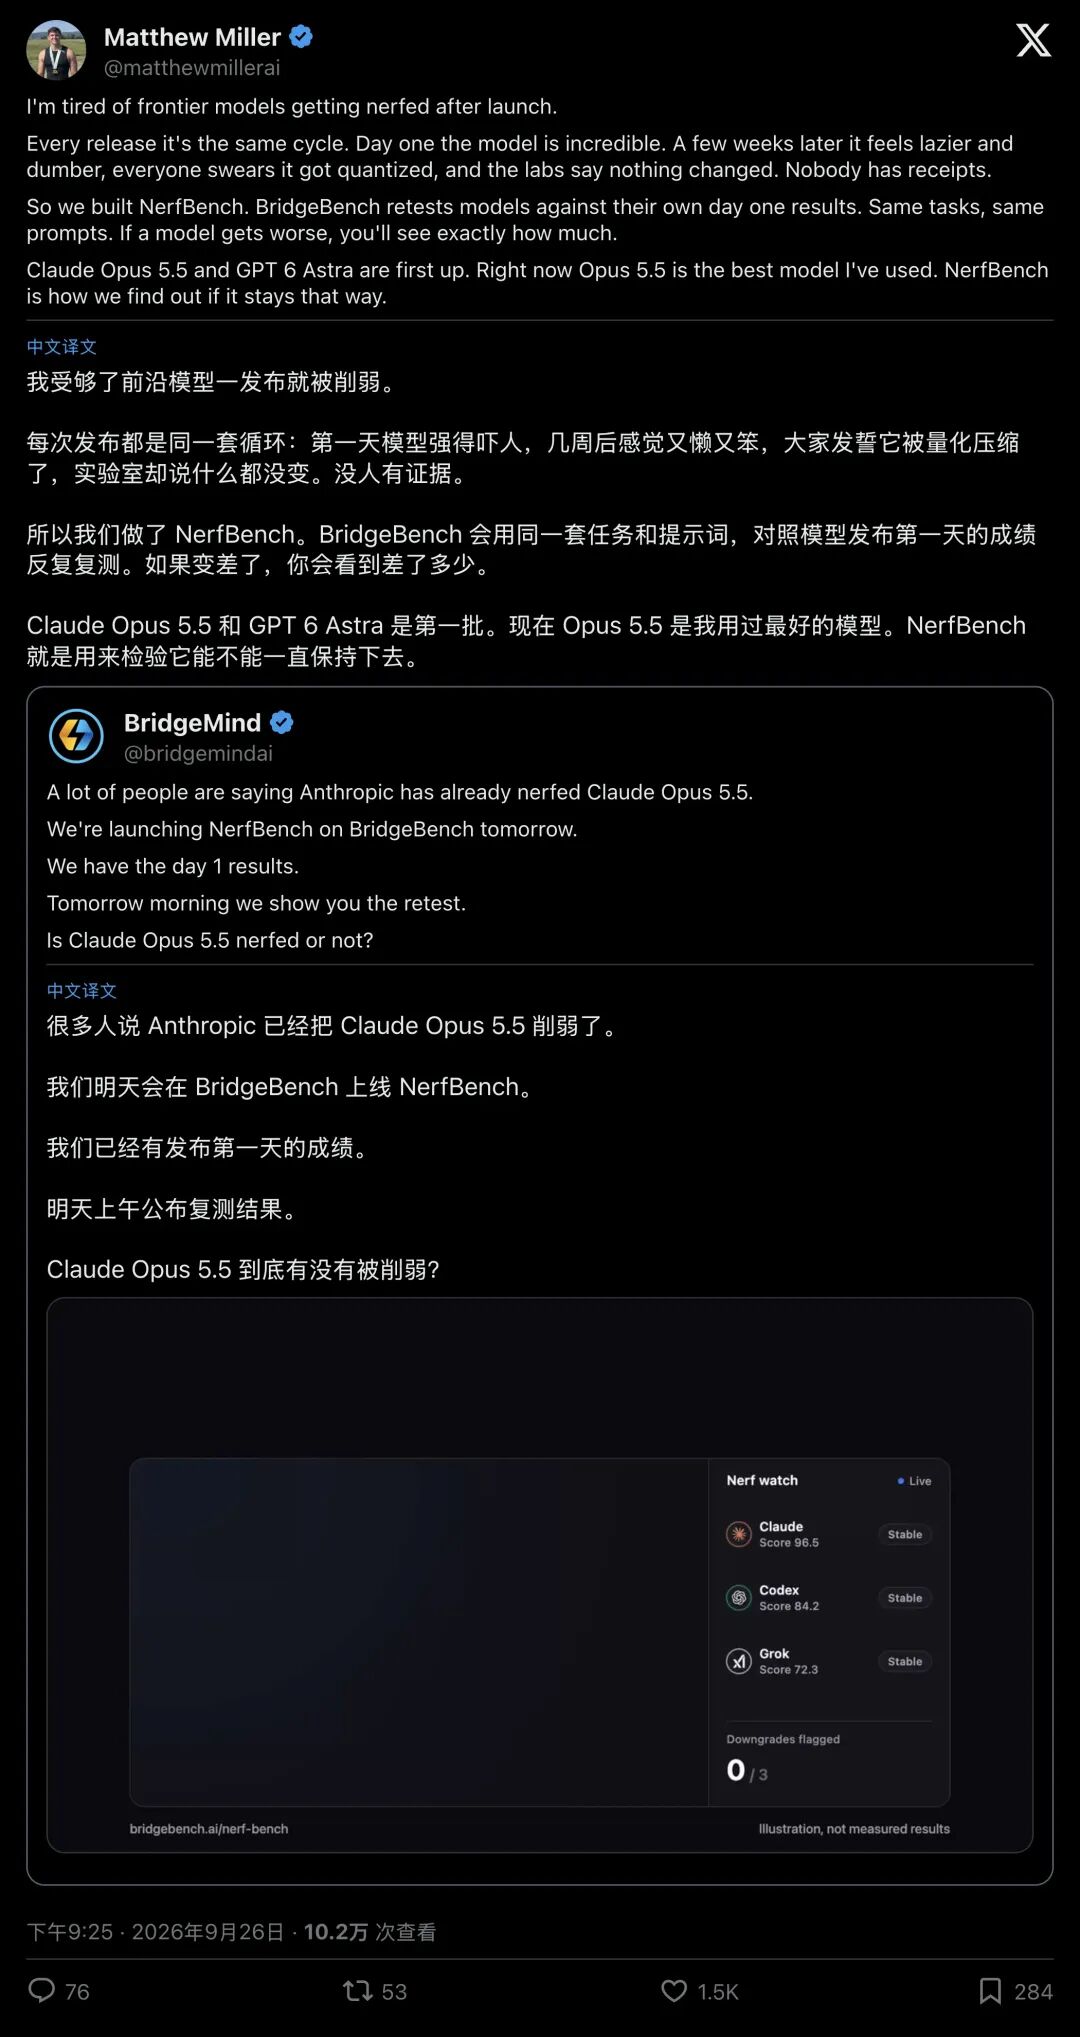
▲ 评测机构创始人直言:受够了“模型变笨、官方否认、谁都拿不出证据”的无限循环
用户骂厂商偷工减料,厂商坚称用户主观臆断。这场打了数年的“大模型玄学嘴仗”,终于有人看不下去了。
评测机构 BridgeMind 旗下的 BridgeBench 正式掏出 10,000 美元专项悬赏,搭建了行业首个专门抓模型退化的监控台,Nerf Bench。
他们把模型上线第一天的每一个提示词、每一个任务定为“100% 功率基准”,开始日夜不停地复测。
首批拉上刑场的,正是当红的两大旗舰:OpenAI 的 GPT-6 Astra 与 Anthropic 的 Claude Opus 5.5。
首轮实测成绩单刚刚出炉,全网争论瞬间迎来戏剧性逆转。
01揭榜时刻:没有被削弱,甚至还变强了?
所谓“Nerf”,原本是游戏圈黑话,意思是官方悄悄把某个强势角色削弱。而在 AI 圈,它代指厂商在后台偷偷降智、减配。
BridgeBench 的测法极其硬核。他们摒弃主观感觉,直接将“模型综合功率”拆解为三个冰冷的工程指标:
- 任务表现(Performance,权重 60%)
:同一道题,能不能做对; - Token 消耗(Tokens,权重 20%)
:做同一件事,废话有没有变多; - 调用成本(Cost,权重 20%)
:跑完同一个流程,花了多少美元。
就算模型给出的最终答案完全一样,只要它多绕了弯路、多耗了 Token、多收了钱,综合功率就会被判定为暴跌。
在 Nerf Bench 的标尺下,发布日得分为 100.0%,处于 90% 到 110% 之间属于正常工程波动,一旦跌破 90% 将直接触发“被削弱”警报。
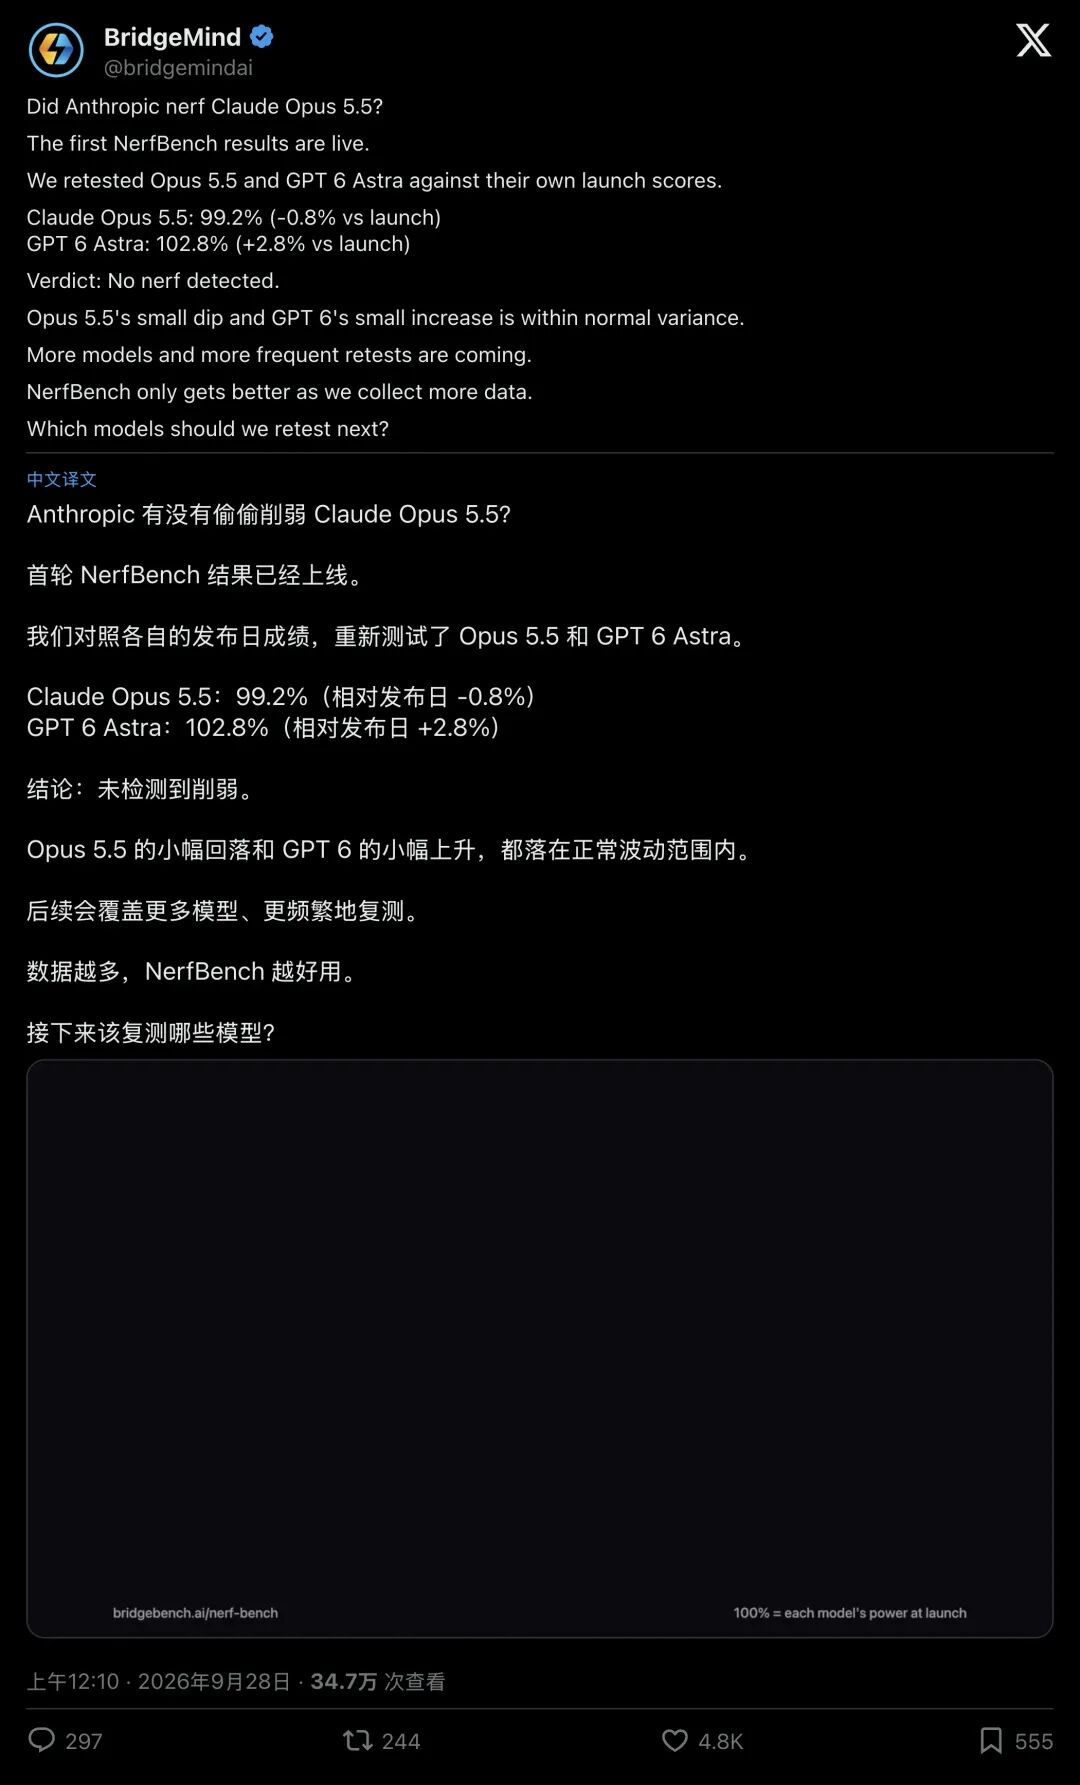
▲ BridgeMind 公布首轮复测结果:未检测到底层削弱
复测结果让所有人大跌眼镜:
- Claude Opus 5.5
:得分 99.2%(相对发布日仅微跌 0.8%); - GPT-6 Astra
:得分 102.8%(相对发布日甚至微涨 2.8%)。
结论极其明确:官方判定,未检测到任何削弱(No nerf detected)。
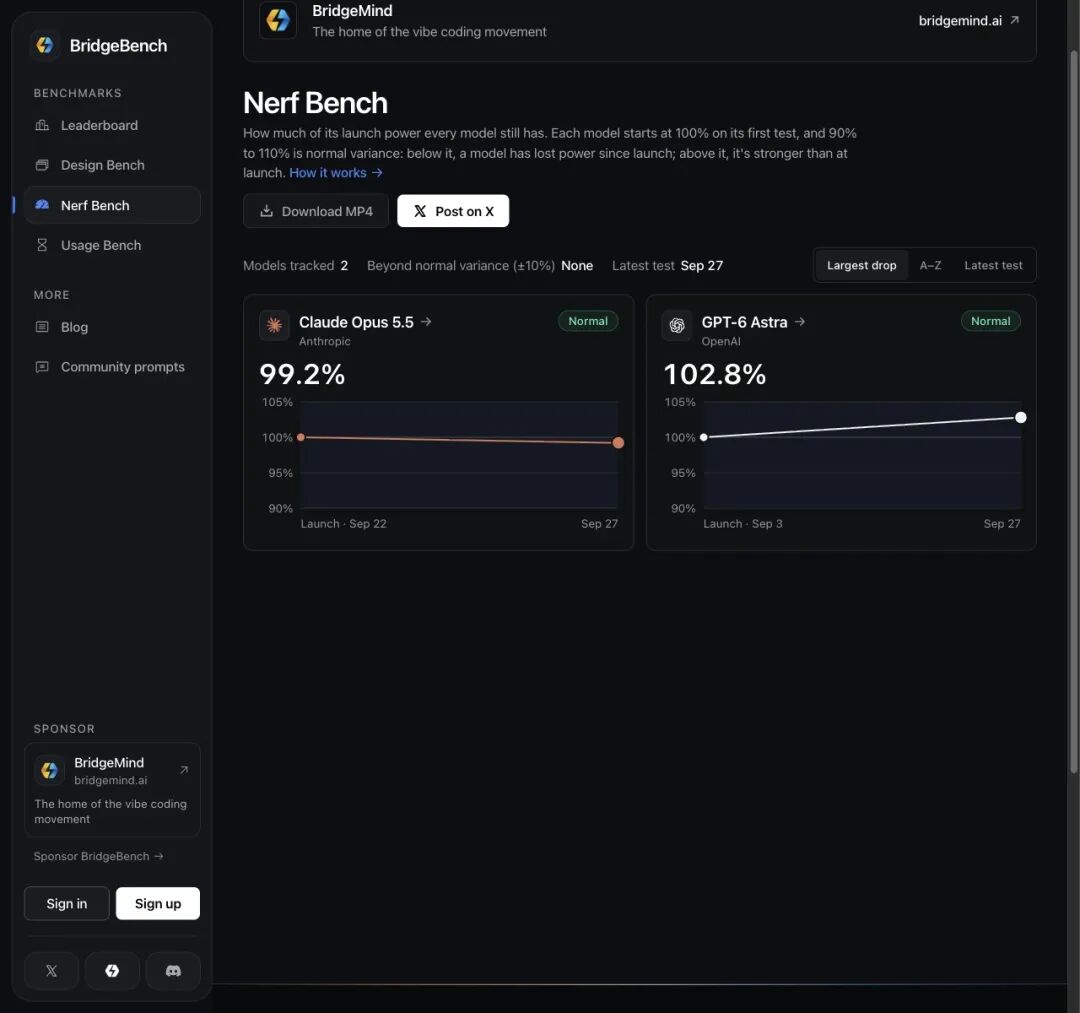
▲ 看板数据显示,两大旗舰模型均牢牢锁在 90%–110% 的安全波动带内
客观数据摆在眼前:从底层推理功率到 Token 效率,底座大模型根本没有被厂商“偷偷阉割”。
但这立刻引出了一个更深层、更诡异的矛盾:既然客观跑分稳如泰山,为什么成千上万的开发者,在日常使用中依然真真切切地觉得模型变笨了?
难道全世界的用户都在集体产生幻觉?
02真相一:AI 从未退化,只是你的“蜜月期”结束了
面对汹涌的社群反馈,BridgeMind 团队提出了一个极具穿透力的认知心理学假说,“蜜月期消退(Honeymoon Fade)”。
人类评估颠覆性工具的主观体验,极少遵循理性直线,往往呈现为一条被情绪剧烈扭曲的抛物线。
▲ 社区用户坦言:受够了毫无依据的引战,渴望客观工具给出的真相
第一阶段:惊艳首秀与光环放大新模型刚发布的前两三天,用户大多带着极高的好奇心在尝鲜。你随手给它一个脑筋急转弯、一段几十行的算法题,它秒速给出漂亮答案。此时,你的大脑会把这一两个“高光时刻”无限放大,误以为它在所有场景下都具备这种通天神力。哪怕模型偶尔出错,你也会觉得“毕竟是探索期,瑕不掩瑜”。
第二阶段:生产力深水区的现实碰撞两周之后,尝鲜期过去,它被推上真实工作的流水线。你扔给它的是数万行逻辑混乱的陈年老代码、需求变幻莫测的工业文档、边界模糊的复杂架构。大模型固有的逻辑短板、幻觉概率被瞬间暴露。
第三阶段:心理落差投射为“官方作恶”同样的生成错误,在第一天你觉得是“提示词没写好,我改一下就行”;而在第三周,你早就不耐烦了,本能的反应变成:“这破模型怎么越来越蠢了?肯定是官方偷偷搞了小动作!”
很多时候,底座模型还是那个模型,只是你和它的“蜜月期”彻底过完了。
03真相二:提示漂移!你的提示词正在悄悄“过期”
如果说心理落差解释了主观情绪,那么技术层面的“提示漂移(Prompt Drift)”,则是导致真实执行力下滑的客观罪魁祸首。
大模型绝非刻录在只读光盘上的静态软件。为了防止越狱、修补安全漏洞、校准输出格式,云端实验室几乎每周都在对后台参数、对齐策略和安全分类器进行微调。
这种微调不会破坏底座智商,但会改变模型对语言语法的“敏感度偏好”。
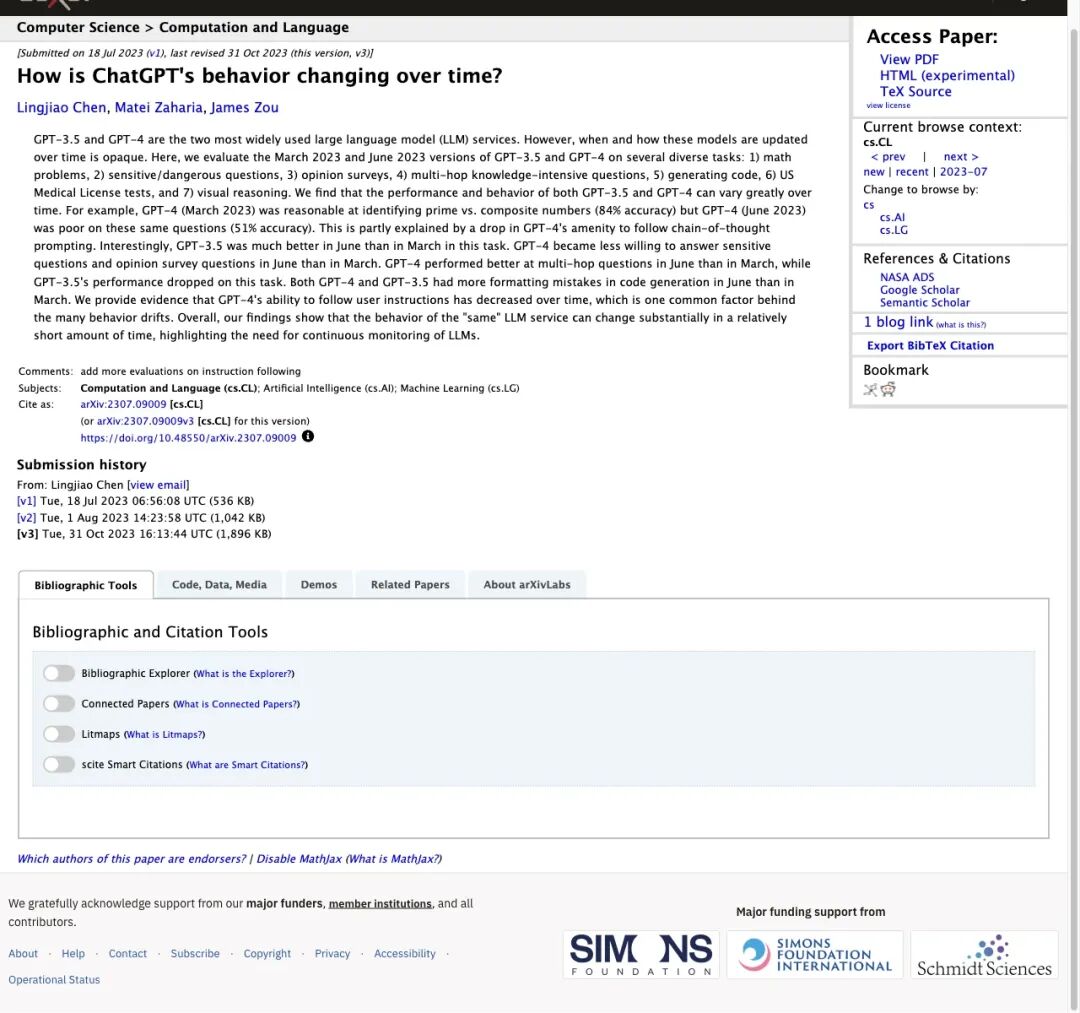
▲ 经典学术论文指出:模型行为演化中,对特定提示词(如思维链)的响应习惯会发生漂移
在经典学术论文《How is ChatGPT's behavior changing over time?》中,斯坦福与伯克利的研究人员就曾揭露过一个惊人事实:模型在更新后某些任务准确率骤降,核心原因并非智商退化,而是它对原有“思维链(Chain-of-Thought, CoT)”提示词的遵循习惯发生了漂移。
此时模型在云端调整了接话习惯,而本地保存的“黄金提示词模板”却没有同步进化。
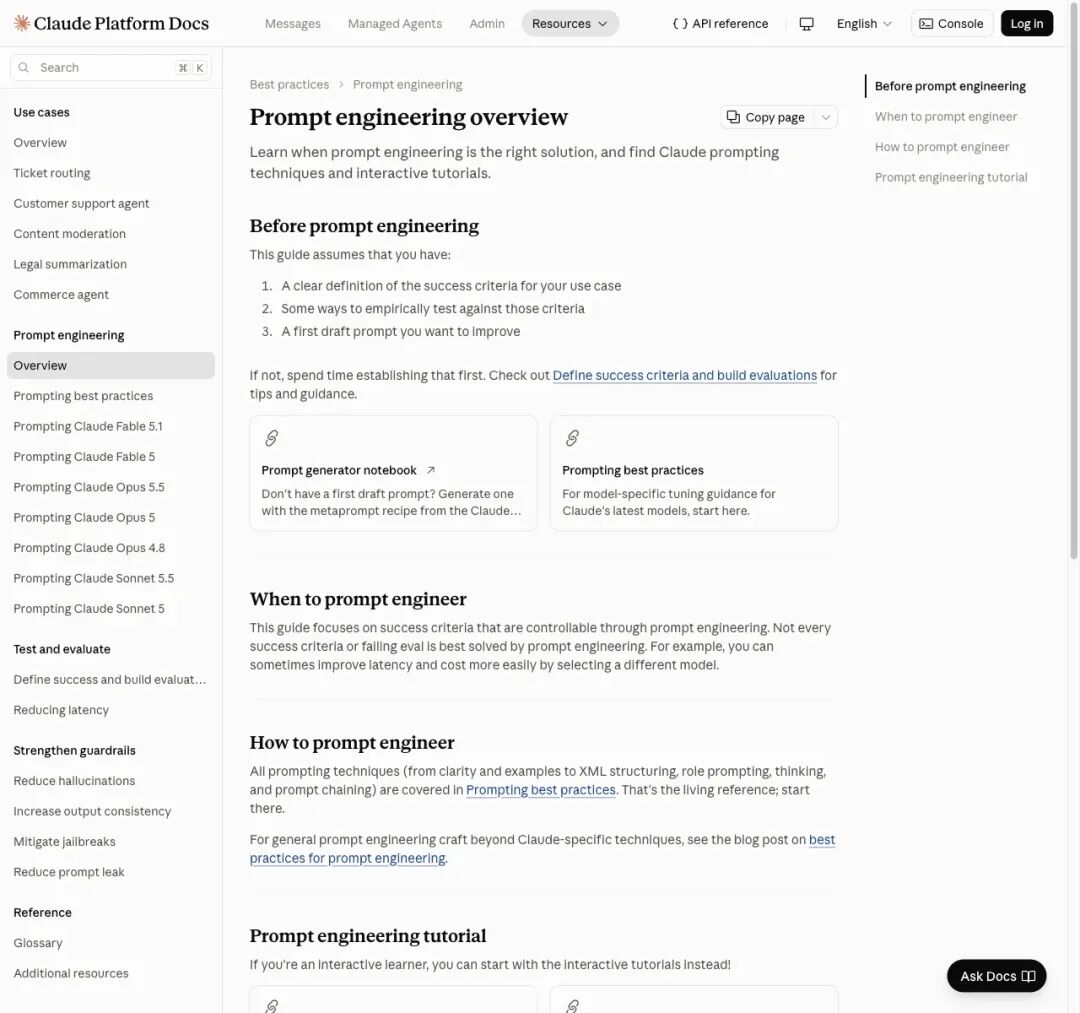
▲ Anthropic 开发者文档强调:提示工程极其脆弱,必须依赖经验测试集动态维护
Anthropic 在其最新的开发者指南中也明确警告:提示词工程具有极高的系统脆弱性。
针对 Claude Opus 5.5 这种级别的模型,系统角色的定义方式、XML 标签的层级嵌套、思维链的触发词,只要稍有偏差,输出质量就会大打折扣。
你在模型发布首日精心调试的一套 Prompt,两周后可能正好滑出了模型的“最佳响应区间”。底座能力依旧在线,只是提示词脱离了适配区间。
04真相三:底座智商没降,但“商业套路”收紧了
在 Nerf Bench 的评论区里,还有一类极为清醒的声音揭开了另一个盲区:
“别光测跑分了!跑分没降,但我每天的额度消耗速度快了一倍,这算不算变相削弱?”
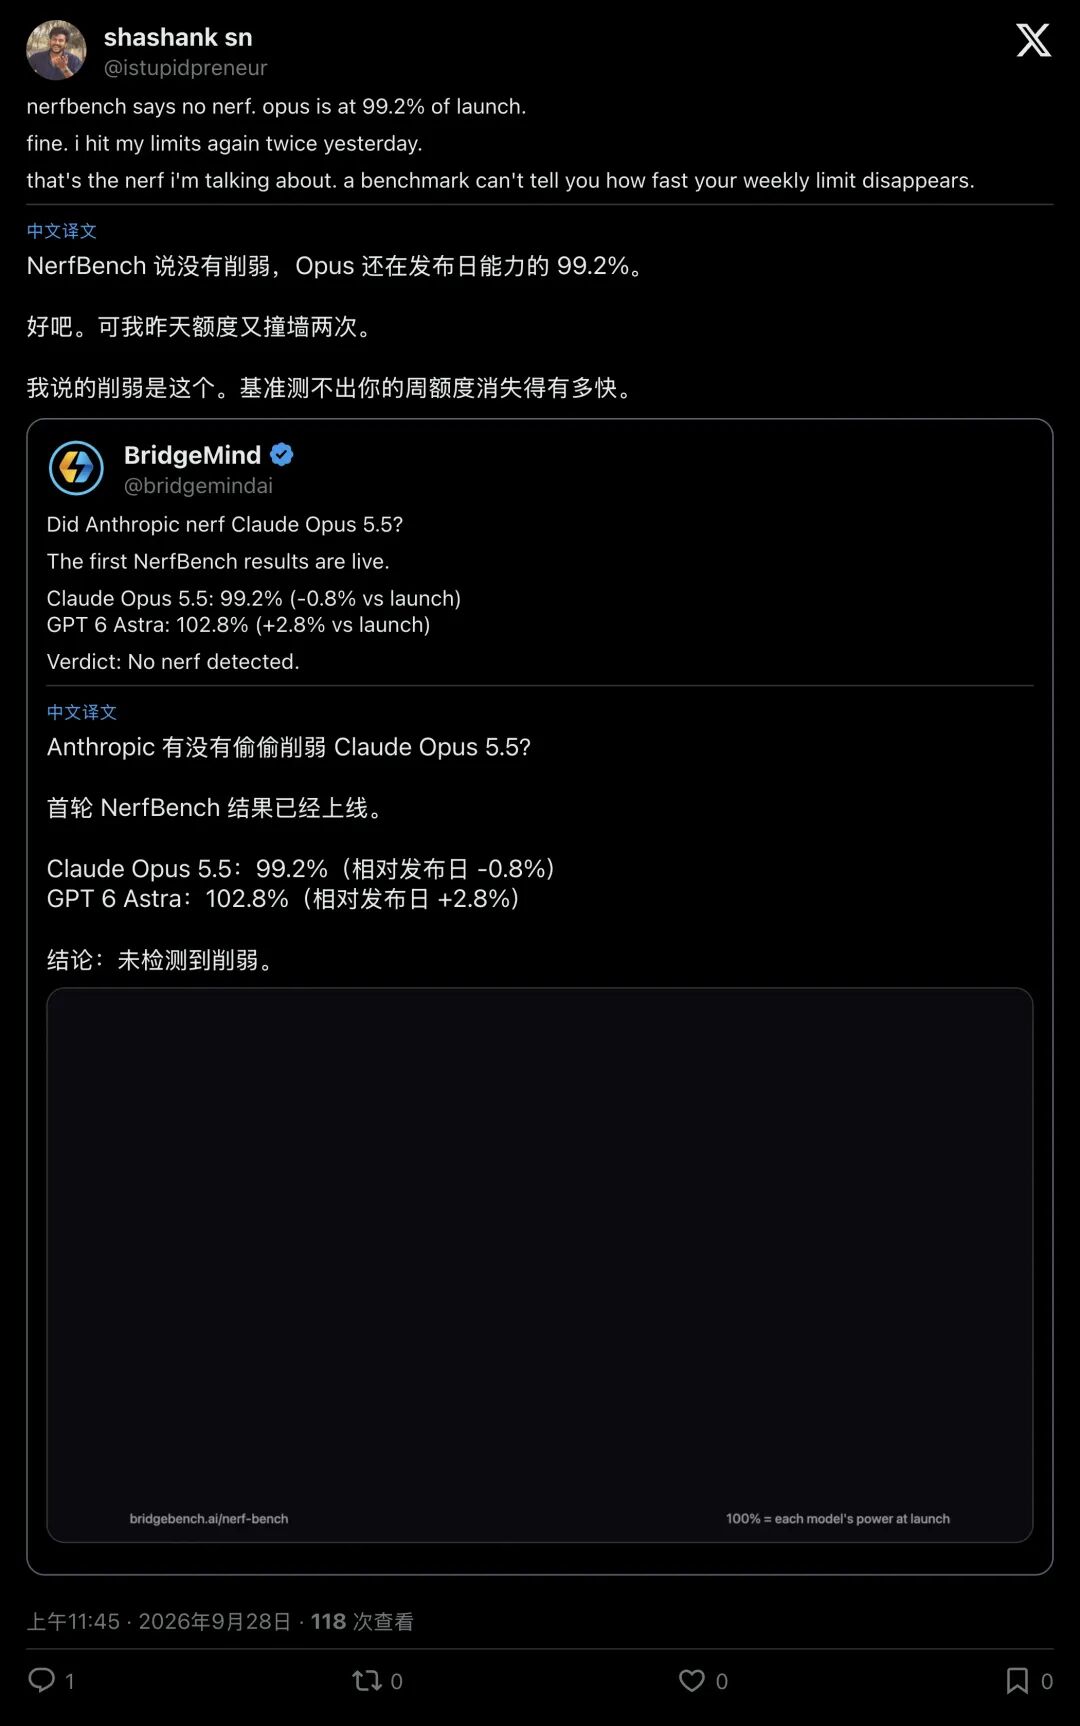
▲ 开发者一针见血:基准测试测不出我的周额度消失得有多快
这精准切中了商业大模型服务的另一层灰度地带。日常使用中大家感受到的“体验变差”,往往来自平台应用层的工程策略:
- 上下文静默截断
:长对话进行到多轮后,前端为了节省显存,悄悄把早期的上下文窗口进行了激进的滑动裁剪,导致模型开始“健忘”; - 高峰期服务降级与路由
:在工作日白天的算力高峰期,系统为了保证响应速度,可能将部分请求路由到更轻量的推理通道,或者压低了采样计算量; - 计费与限流收紧
:五小时用量限制、每周高级调用额度在后台被更严格地执行,用户频繁撞墙,体感极度恶化。
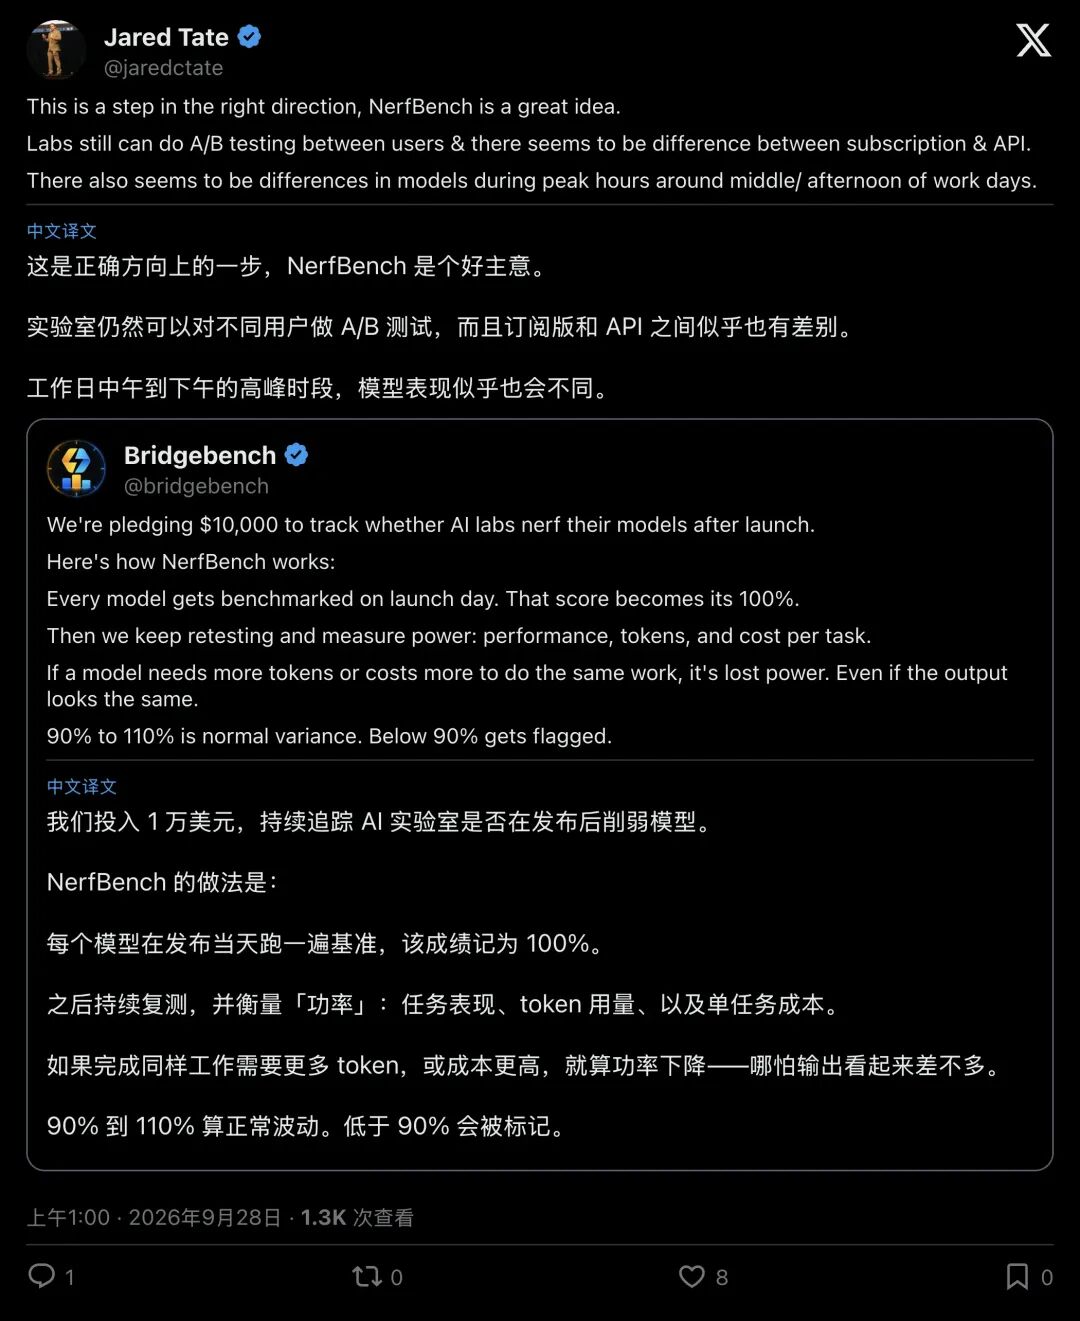
▲ 从业者分析:用户分组 A/B 测试、订阅版与 API 差异才是体感差异的真实来源
把“商业限流与前端策略”和“底层模型被降配”混为一谈,是过去几年社区最大的认知泥潭。
05告别体感玄学:大模型时代需要确凿的“收据”
BridgeBench 砸下的这 10,000 美元,意义远不止测出两个百分比数字。
它标志着整个 AI 行业正在从“情绪化的发帖互撕”走向“用数据拿收据说话”的量化时代。
当大模型越来越深入地嵌入工业软件、自动编程和复杂商业流,我们不能再依靠“我觉得它变懒了”、“我感觉它变笨了”这种主观体感来做技术决策。
对于每一个普通的开发者和使用者来说,Nerf Bench 的首轮结果带来了两点极其锋利的启示:
- 破除降配迷信,直面工程本质
:当你发现 AI 的输出变差时,不要第一时间甩锅给“厂商又削弱了”。先检查自己的提示词结构是否老化,任务边界是否超出了模型的注意力极限,上下文是否被无节制地污染。 - 督促透明机制,紧盯商业边界
:把监督的火力,从捕风捉影的“模型降智论”,转移到切实影响生产力的领域,要求厂商公开上下文裁剪规则、明确 A/B 测试范围、透明化额度消耗标准。
大模型的底层智商没有滑坡,GPT-6 Astra 与 Claude Opus 5.5 依然站在算力巅峰。
但在告别了盲目崇拜的“蜜月期”之后,如何驾驭这匹敏感、脆弱且随时在动态微调的算力巨兽,才是摆在每一个人类工程师面前最严峻的考验。