ARTICLE · 1110135
我让10款AI帮我剪了条Vlog,表现让我惊讶...
先看这张图。
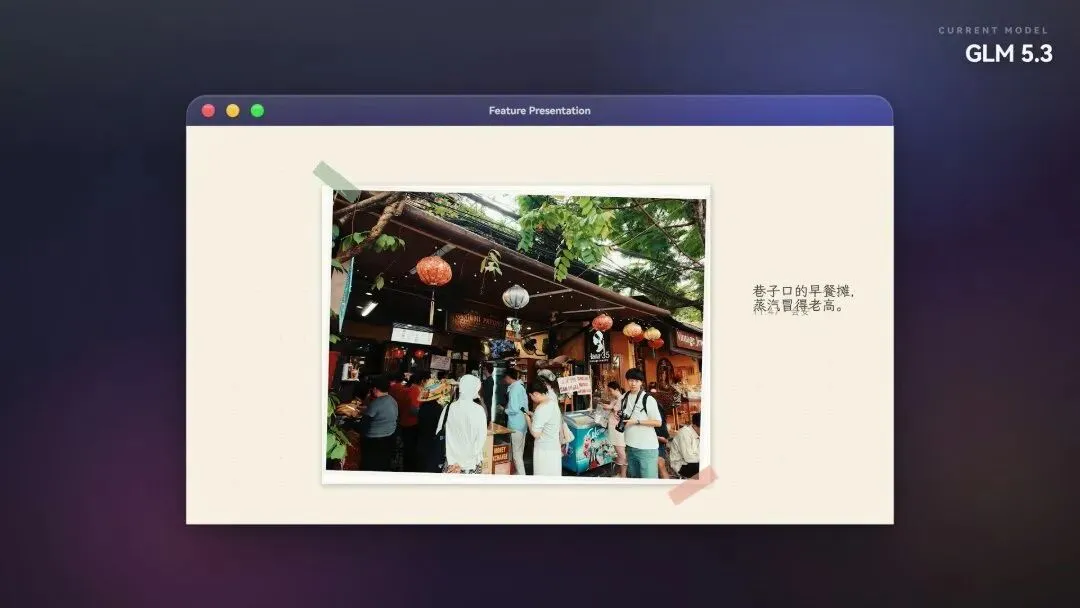
奶油色的点阵纸,白边照片,手写字体,邮票邮戳一样不少。这是我越南旅行 vlog 里的一页。它不是我剪的,是 AI 剪的。
而且剪出这一页的 AI ,只是这场比赛的参赛选手之一。
事情要从头说起。
上个月,我去越南加云南玩了八天:昆明出发,河口过关,老街进越南,河内、岘港、会安,一路玩到腿软。两个人的八天,我用影石 Luna Ultra 拍下了 620 多个文件,整整 26GB 。
回来打开文件夹的那一刻,我人傻了:全部预览一遍都要花半天,剪完?下辈子吧。
但我转念一想:现在 AI 都这么强了,凭什么不让它们替我剪?
说干就干。我把市面上主流的 10 款大模型全喊来了:腾讯混元 Hy4 、 Kimi K2.8 、 MiniMax M3 、豆包 2.1 Turbo 、 Kimi K3 、豆包 2.1 Pro 、 DeepSeek V4.1 Flash 、 ChatGPT-6 、 GLM 5.3 Flash 、 GLM 5.3 。
规则很简单,也很残忍:
同一场旅行,同一份 26GB 素材,同一份提示词:明亮、清透、轻微偏暖,要松弛感,先高光预览再出标题,夏日手帐风。全部使用各家的官方 Agent 工具,让它们开始剪辑。
那说到 AI 剪辑,是不是有很多小伙伴觉得就是使用咱们日常使用的 Pr 、剪映这类工具呢?
那其实 AI 剪视频跟人不一样:它们是写脚本,批量自动分析素材、生成字幕和手帐卡片,再一段一段渲染出来。
10 条片子看完,有惊艳,也有惊吓。
最终成绩单先放这儿:
| 排名 | 模型 | 得分 | 一句话点评 |
|---|---|---|---|
| 🥇 | 9.1 | ||
| 🥈 | 8.8 | ||
| 🥉 | 8.6 | ||
| 4 | 8.3 | ||
| 5 | 8.0 | ||
| 6 | 7.8 | ||
| 7 | 6.5 | ||
| 8 | 6.2 | ||
| 9 | 6.0 | ||
| 10 | 4.0 |
💀 第 10 名 腾讯混元 Hy4 | 4 分
四个字评价:「交付事故」
说实话,它的前半段没我想象的差:满屏电影感,平均 3 秒一个镜头,会安的灯笼、岘港的海岸线都知道放大展示,选片眼光在线。
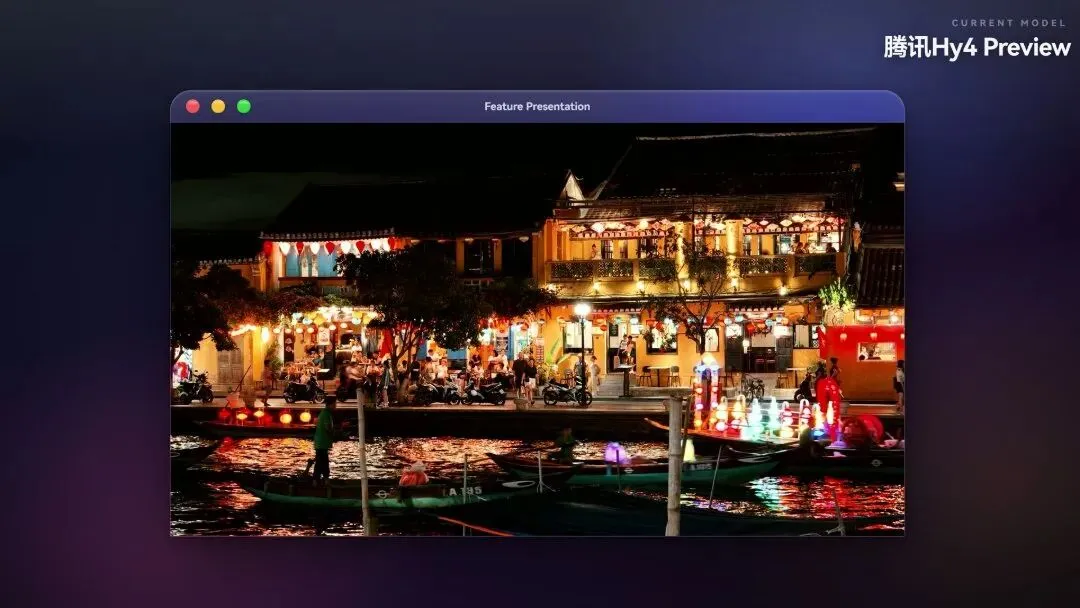
我一度以为它要逆袭。
然后,我瞥了一眼播放器。
画面,停在 4 分 27 秒。音频,一路跑到 6 分 23 秒。
也就是说:最后将近两分钟,全是黑屏,只有 BGM 在孤独地响。
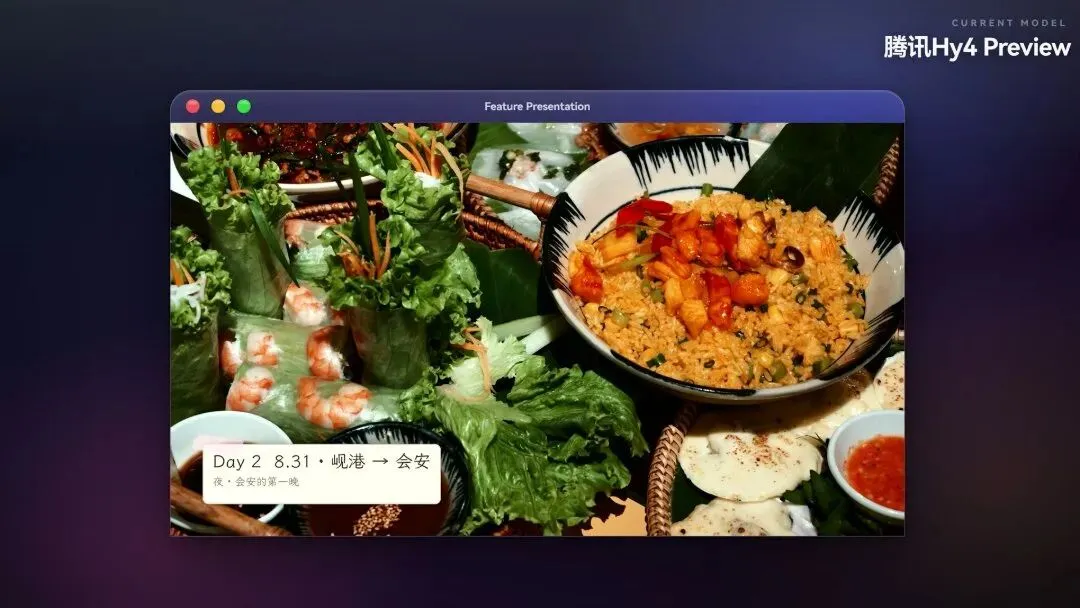
还没完。我翻了翻它的输出文件夹,一个 0 字节的导出失败文件,就那么大咧咧地躺着。
它翻车了,但它自己压根不知道——因为导出之后,它没有检查。
剪得好不好是一回事,文件能不能完整播放,是另一回事。
交付都没完成,神仙选片也救不了你。 4 分,垫底。
· · ·
🎨 第 9 名 Kimi K2.8 | 6 分
一个只管美、不管死活的艺术家
K2.8 的审美真没得黑:会安的黄墙、灯笼、夜市,被它做成一本英文旅行手帐。拍立得、胶带、撕纸边、小涂鸦全都有,还有英文注释,风格统一得像买来的。
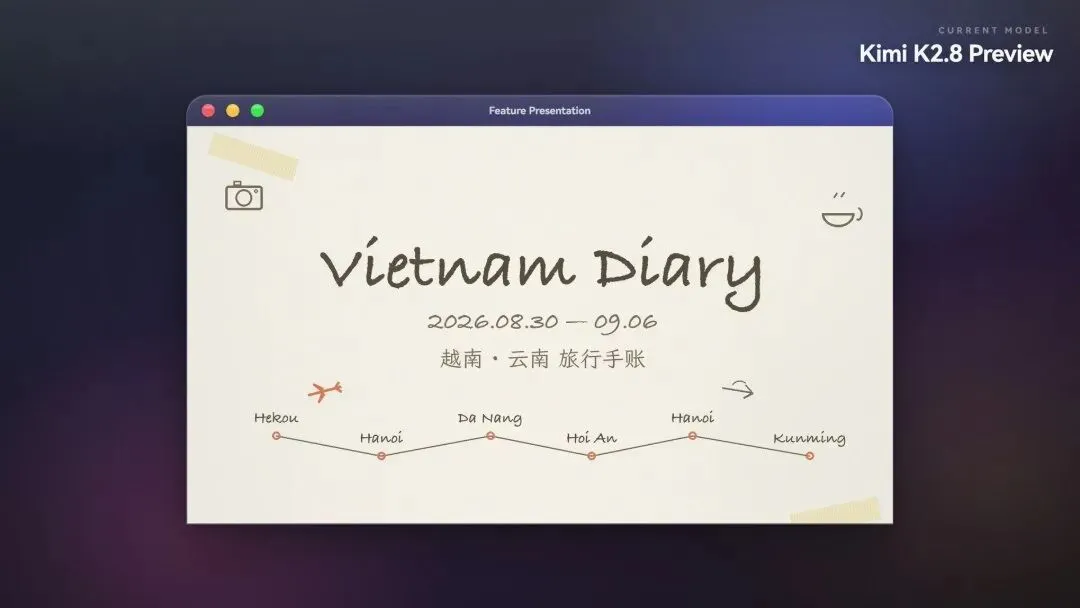
但它有三个毛病,个个致命:
一,转场全靠闪白。动不动冒出一帧接近全白的画面——不像翻手帐,像屏幕坏了。
二,节奏慢到离谱。镜头时长中位数 11 秒,最长一段接近 40 秒。我要的是松弛感,不是 PPT 轮播。
三,最离谱的:我的行程有 8 天,它剪到第 7 天,直接剧终。最后一天呢?被它吃了。
风格成立,执行粗糙。 6 分。
· · ·
🤫 第 8 名 MiniMax M3 | 6.2 分
闷声干活的老实人,声音也是真的闷
M3 走极简路线:不搞花哨排版,只留高光预览、标题、日期卡、结尾卡。
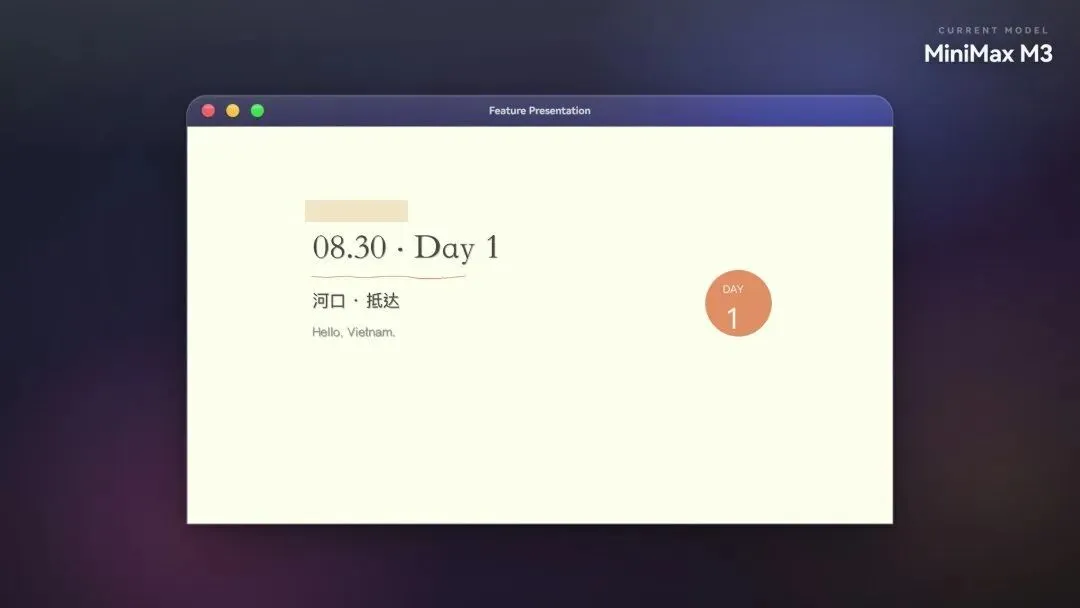
真实是真的,偷懒也是真的——大量素材没有重新设计,竖屏照片直接怼进 16:9 画布,两边黑边宽得能再放一部电影。
最要命的是声音:综合响度只有-26.9 LUFS ,全场最轻,跟最响的差了约 15dB 。看它的片子,我的手指就没离开过音量键。
结尾还特别仓促:先黑屏近 8 秒,最后一句「把夏天装进手帐里」只停留 2 秒——话都没说完就散场了。
6.2 分,可惜了这份克制。
· · ·
🎬 第 7 名 豆包 2.1 Turbo | 6.5 分
把力气全用错了地方的卷王
全场最卷,也最偏题。
青橙调、暗角、胶片颗粒,胶片感确实给你拉满了。可我的提示词白纸黑字写着:明亮、清透、轻微偏暖。
它交上来的,是一部偏暗偏冷的公路电影。
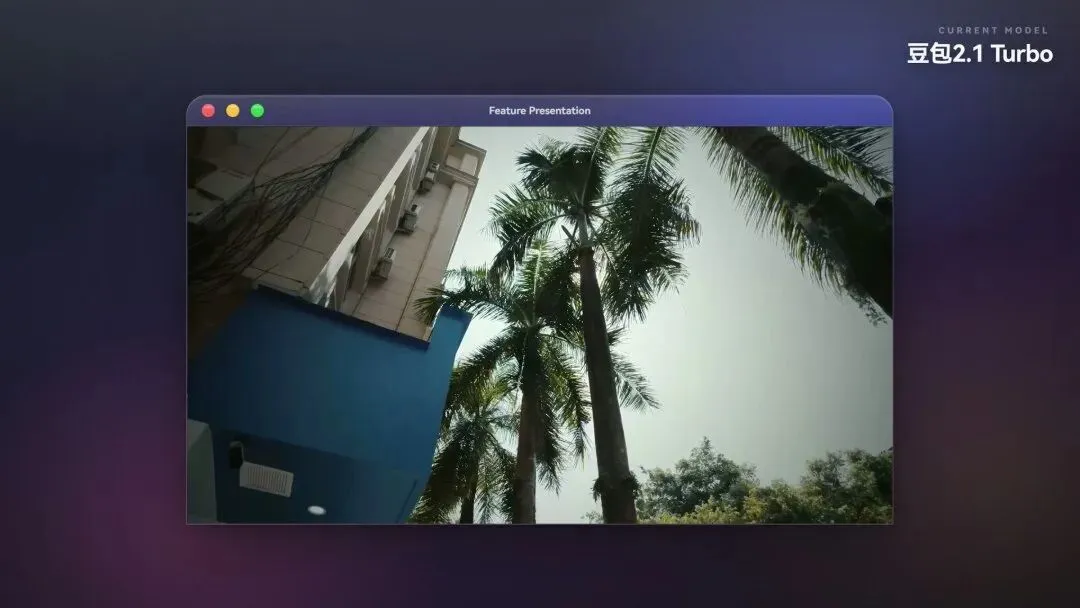
开场顺序也是反的:要求先预览再出标题,它上来就把标题怼你脸上。竖屏素材做了模糊背景填充,但两边有明显的涂抹感;响度-24.7 LUFS ,也偏轻。
但你真不能说它没本事, 72 个镜头,全部列成剪辑清单,一条不落;最后一天没素材,它还知道拿机舱照片和第一天的车站做首尾呼应。
能力有,方向偏。 6.5 分。
· · ·
✍️ 第 6 名 Kimi K3 | 7.8 分
文案封神,败给一个方块字
K3 的开场,是十款里最惊艳的:会安灯笼街、龙桥喷火、火车街,连续三个高光镜头甩完,标题卡压上来——「两个人的八天」,路线、纸飞机、邮戳、胶带,安排得明明白白。
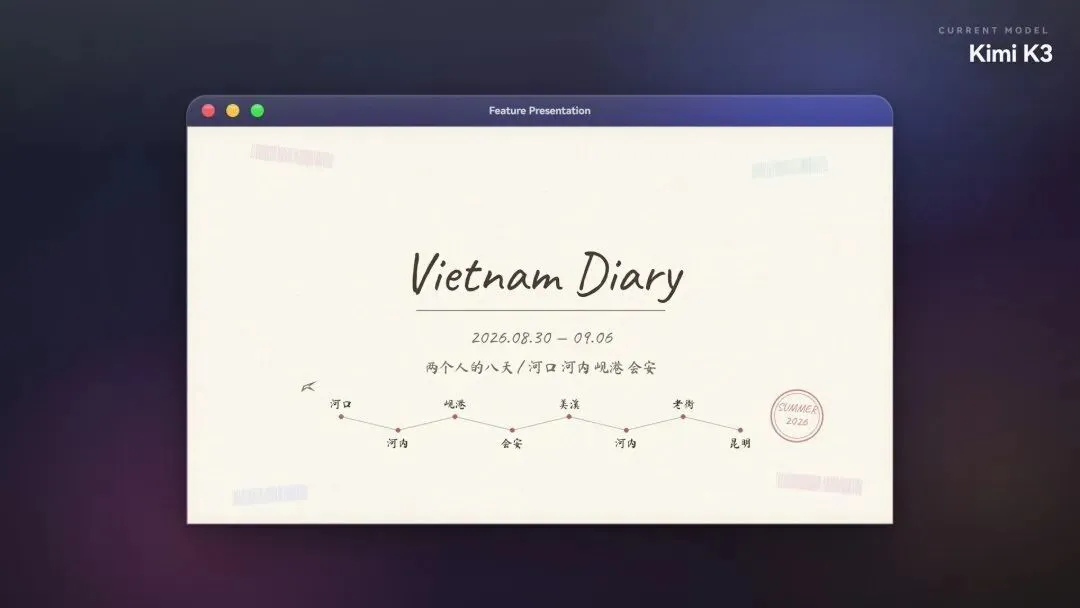
更绝的是文案:
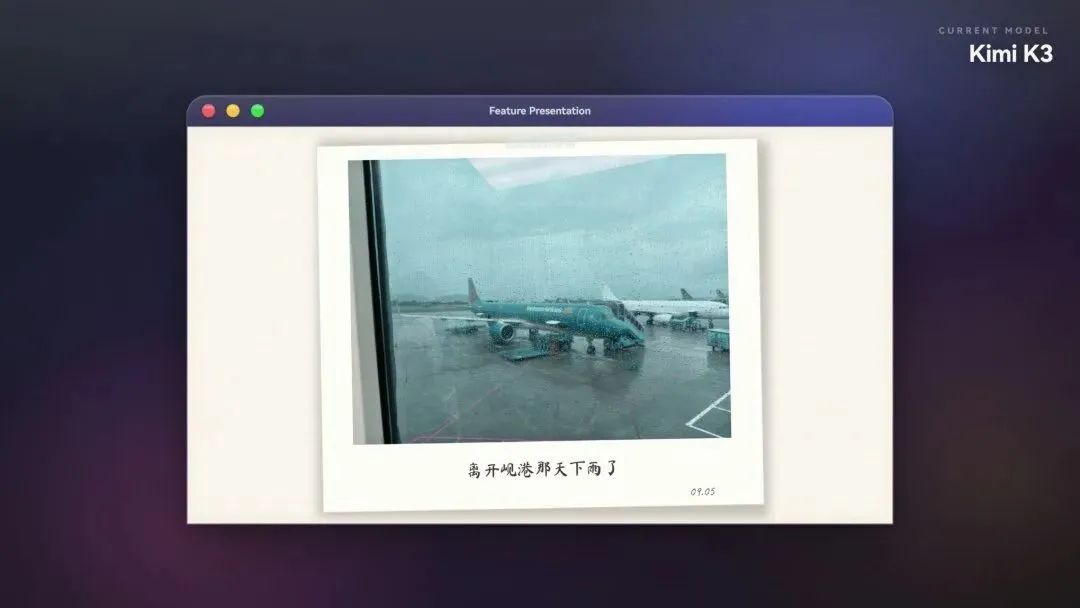
「离开岘港那天下雨了。」「夜市里的手作摊。」「有人在天上飞。」
这不像 AI 在介绍景点,这像一个刚旅行回来的朋友,在照片背后随手写的话。
我差点就宣布它提前毕业了。
直到我在第七天的路线图正中间,看到一个方框乱码。它想放个小飞机图标,字体不支持。就这一个方块,卡在片子最中间,想忽略都难。
离「可以直接发」就差最后一道质检,它没做。
7.8 分,一个方块字引发的败笔。
· · ·
🛡️ 第 5 名 豆包 2.1 Pro | 8 分
六边形战士,但没有记忆点
先说清楚: Pro 的能力明显强于 Turbo 。该有的全有:开场预览、标题卡、日期卡、结尾卡;画面明亮,风格清新。
竖屏素材的处理甚至称得上聪明:不硬裁横屏,而是做成一张足够大的拍立得纸卡,放在柔和的虚化背景上——构图保住了,黑边也消失了。
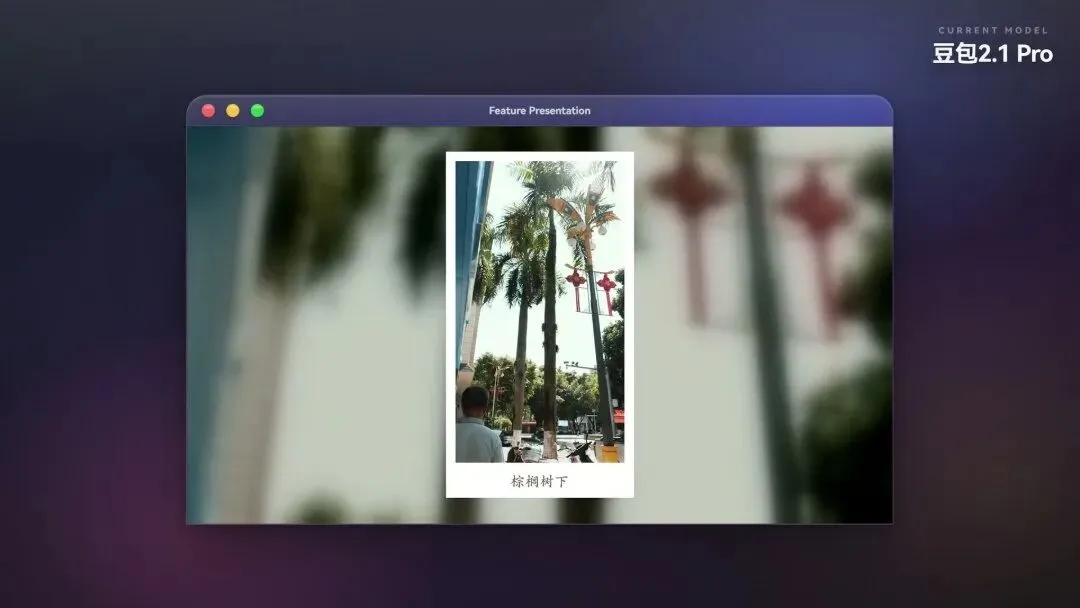
它还把 Live Photo 里的动态内容提取出来,自己生成了三段原创配乐。
但看完整个片子,我愣了三秒:**有哪个画面,是我能记住的?**一幕都没有。
每一项都合格,每一项都差一口气——完成度很高,个性约等于无,一份标准答案。
对了,别再说豆包模型不行了:它只是稳得让你挑不出毛病,也夸不出花。
8 分。
· · ·
🎵 第 4 名 DeepSeek V4.1 Flash | 8.3 分
选片鬼才,兼职程序员
DeepSeek 的选片,是这次最让我服的之一:铁路隧道里的剪影、暮色下的海边、深夜的教堂——每个镜头都精准踩在光线和构图最好的那一秒。
全片约 80 个镜头,平均 3.7 秒一个,快而不乱,全场看起来最爽快。
更离谱的是,它连 BGM 都是自己用代码合成的:木吉他、贝斯、沙锤,零外部采样,再把街市、海浪、火车的现场声混进去。响度-11.6 LUFS ,全场最响。
最后一天没素材,它没有拿别的日期糊弄,而是画了一张返程动车票——老街、河口、昆明南, C560 。
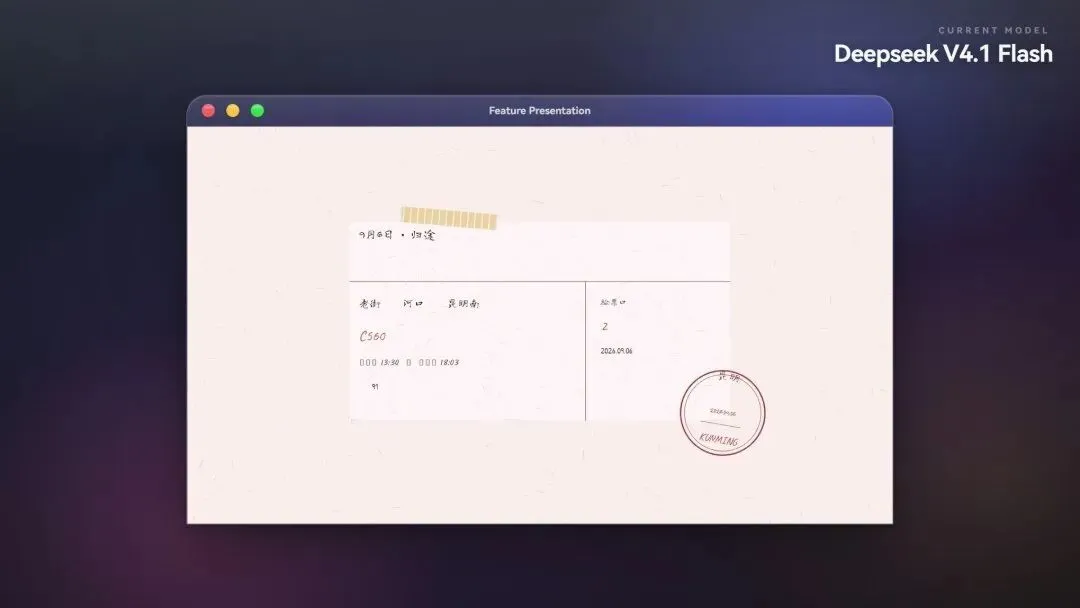
就这一张票:克制、聪明,还有点浪漫。
扣分项:手帐元素用得太少,很多细节要按暂停才看得见。
8.3 分。
· · ·
📖 第 3 名 ChatGPT-6 | 8.6 分
它把整本手帐「盘活」了
先交代: GPT-6 开的是弱思考档, Astra 的 Ultra 额度,实在烧不起。
即便如此,它依然是全场最懂素材结构的一个。这批照片里混着不少 Live Photo ,很多模型把它们当普通照片, GPT-6 把 12 张动态图全部提取出来,再加上 14 段视频。
接近 5 分钟的成片里,有 3 分 07 秒是真正在动的画面。
海浪在拍,锦鲤在游,街上的人和车一直在走。别的模型是让照片缓缓放大、假装在动;它是直接把整本手帐做活了。标题页也不是干巴巴的淡入,而是像翻开一本笔记本。
最后一天没素材,它做了一页「返程」,用时间轴标出老街、河口、昆明。
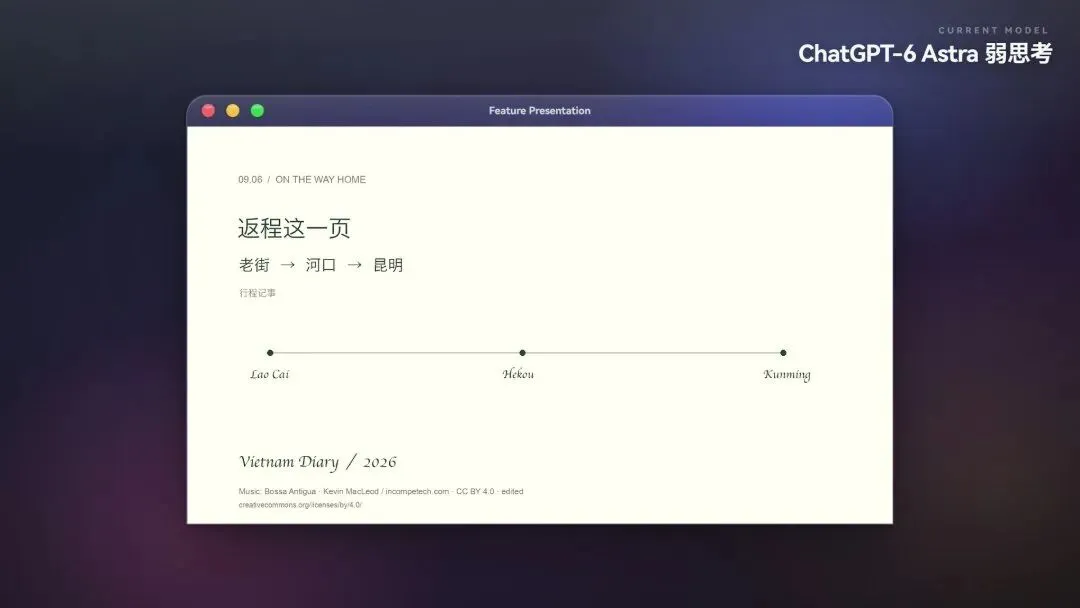
最离谱的是版权意识:音乐署名文案全给准备好了,直接复制进发布简介就能发。这觉悟,很多人类博主都没有。
扣分:声音偏轻,个别转场闪白。
8.6 分。
· · ·
📏 第 2 名 GLM 5.3 Flash | 8.8 分
如果只看「听话程度」,它是第一
GLM 5.3 Flash 对提示词的执行,精确得像用尺子量过:画面明亮、清透、偏暖,一个字都没跑偏。
开篇预览结束,一张贴在纸面上的日本桥拍立得标题卡;每天一张日期卡,日期、星期、地点、天气全齐。
最绝的是旁边那条行程进度线,旅行走到哪一天,线路就亮到哪一天。
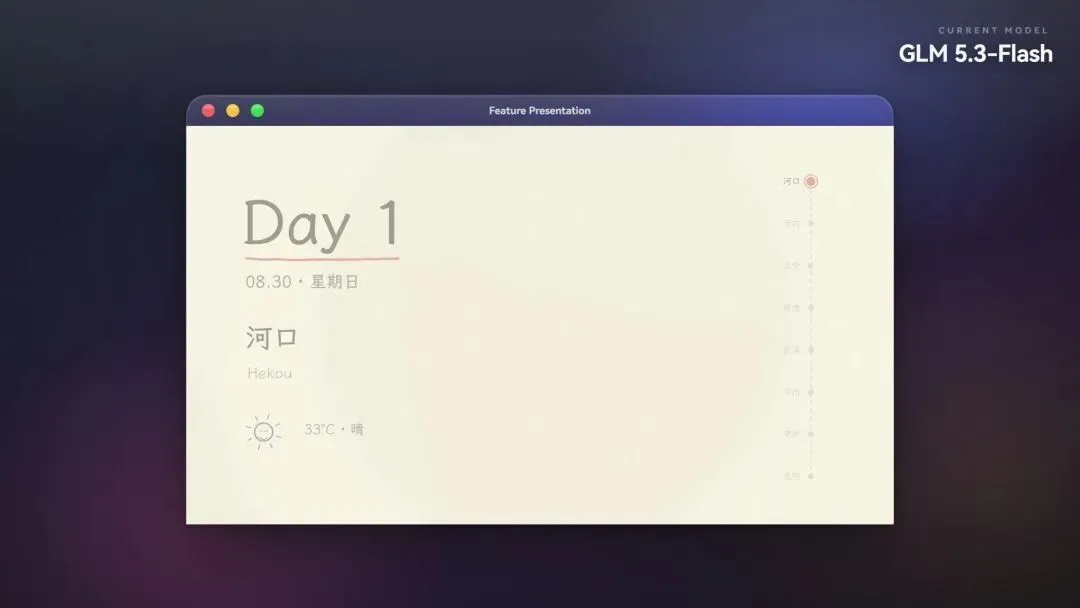
但它真正的杀手锏是声音:火车街那段,火车贴脸开过来的瞬间,背景音乐自动降到三成,让真实的火车呼啸当主角,现场声完整保留。从头到尾,用户不用碰一下音量键。
输在哪?版式太乖。全片基本都是单张拍立得,稳是稳,少了那种让人忍不住暂停截图的「哇」。
8.8 分,以微小差距屈居第二。
· · ·
🏆 第 1 名 GLM 5.3 | 9.1 分
它剪的不是 vlog ,是一本杂志
看它第一眼,我就知道这次冠军没了悬念。
它不像一条 vlog ,更像一本排版、印刷、装订完成的旅行杂志:奶油色点阵纸、白边照片、鼠尾草绿和珊瑚橘的胶带、邮票、邮戳、手写字体——所有元素都属于同一套视觉语言。
有的页面单张照片,有的两张错落拼贴;位置、倾斜角度、留白,全都设计过。每天的卡片,连星期、天气、温度都标了出来。
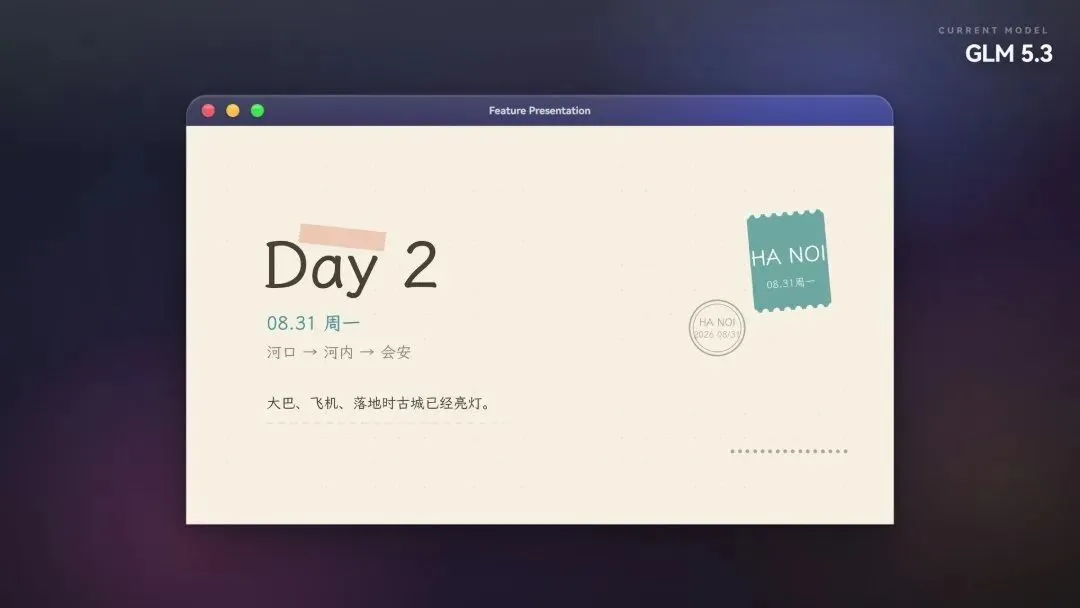
缺点也很直白:全片只用了约 30 张照片、 7 段视频,素材利用率全场倒数;个别竖排文字离边缘太近,差点被裁掉。
但综合视觉、声音、叙事、完成度来看——它就是最接近「专业作品」的那一条。 9.1 分,实至名归。
· · ·
💰 但是 冠军的账单 比你想象中烧钱
封神的代价,是钱包先阵亡
GLM 5.3 不具备视觉能力,分析素材时视觉接口频繁报错。它想了个狠招:自己写了个本地识别脚本。
聪明是真聪明,烧也是真烧——
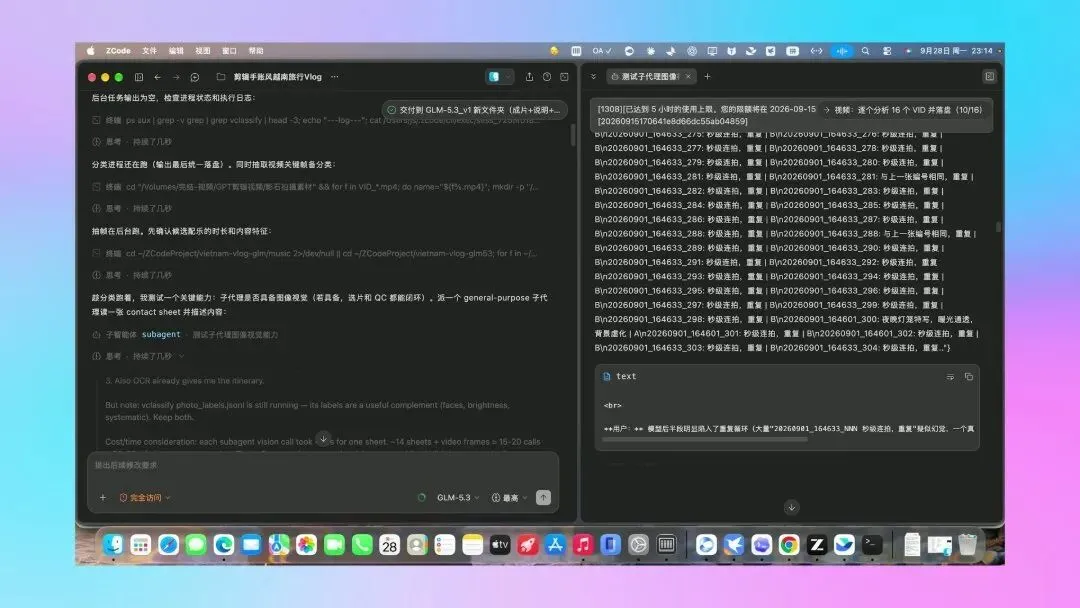
这条 9.1 分的片子,烧掉了整整两个 5 小时额度。
对比一下:第二名 GLM 5.3 Flash ,只用了一个额度的 20%; GPT-6 弱思考,用了 50%。
所以这份榜单还有个隐藏款:性价比之王, GLM 5.3 Flash 。
· · ·
写在最后: 10 条片子看完,三点暴论
第一,模型们已经会「看懂」素材了。 GPT-6 知道 Live Photo 里藏着会动的画面;所有模型都发现我给的行程单和实际景点对不上——并且都自己纠正了。
第二,缺素材的时候,才见真功夫。最后一天没有拍摄素材:有的一剪到第 7 天直接跑路,有的拿机舱照片首尾呼应,有的画了张动车票,有的做了整页返程。没素材可用的时候,才是 AI 能力真正分层的地方。
第三,交完作业会不会回头检查,是分水岭。混元 4 那个 0 字节文件,就静静躺在文件夹里。当然,这些未必全是模型的锅, Agent 工具( Harness )也得背一半。
回到最初的问题: AI 现在能独立剪 vlog 吗?
实测答案:能。前几名已经做到「不用大改,直接能发」。
但 AI 剪辑真正的差距,早就不是会不会切镜头了——是审美统不统一,是素材有没有被真正读懂,
以及,它能不能意识到自己哪里没做好。
最后这三条,恰好也是人做内容最贵的东西。