ARTICLE · 1110988
DeepSeek拆的不是芯片差距,是软件的墙
9月30日上午,DeepSeek在官方公众号发了条公告:一次性开源六件面向华为昇腾的基础组件,每一件都和英伟达组件一一对应。
消息当晚冲上微博热搜第8,10月1日还挂在B站热门第10,财联社这条新闻底下4136人吵了一夜,读法基本两种:国产算力又行了,DeepSeek真大方。
都对,但都没说到根上。
这不是技术新闻,是一步教科书级的商战棋。
一一对应,对应的到底是什么
大模型跑起来光有芯片不够,还要一整套底层工具:算子语言、矩阵库、通信库、注意力算子。
这套家当在英伟达平台全开源过,星标数不撒谎。
9月30日这次,是把家当在昇腾上补齐:两件新建仓库带Ascend后缀,四件加昇腾后端,接口对齐。
注意这个细节,官方原话:DeepSeek训练中用到的每一个TileLang算子,在昇腾上都有对应的高性能实现。TileLang已承载V4系列训练大部分算子。
翻译成人话:训练DeepSeek级模型,软件层面不再唯一依赖英伟达。
DeepSeek官方开源发布画面
全网都说差在芯片,其实卡的是软件
聊国产算力,口径基本一致:制程差几代,性能差一截。
有业内人士9月30日说了句大实话,中国AI芯片的瓶颈从来不在晶体管,而在软件——英伟达的壁垒不是芯片算力,是CUDA十八年攒下的生态:数百万开发者、无数调优过的算子、写一次到处能跑。
DeepSeek自己的开源生态,民间投票长这样:
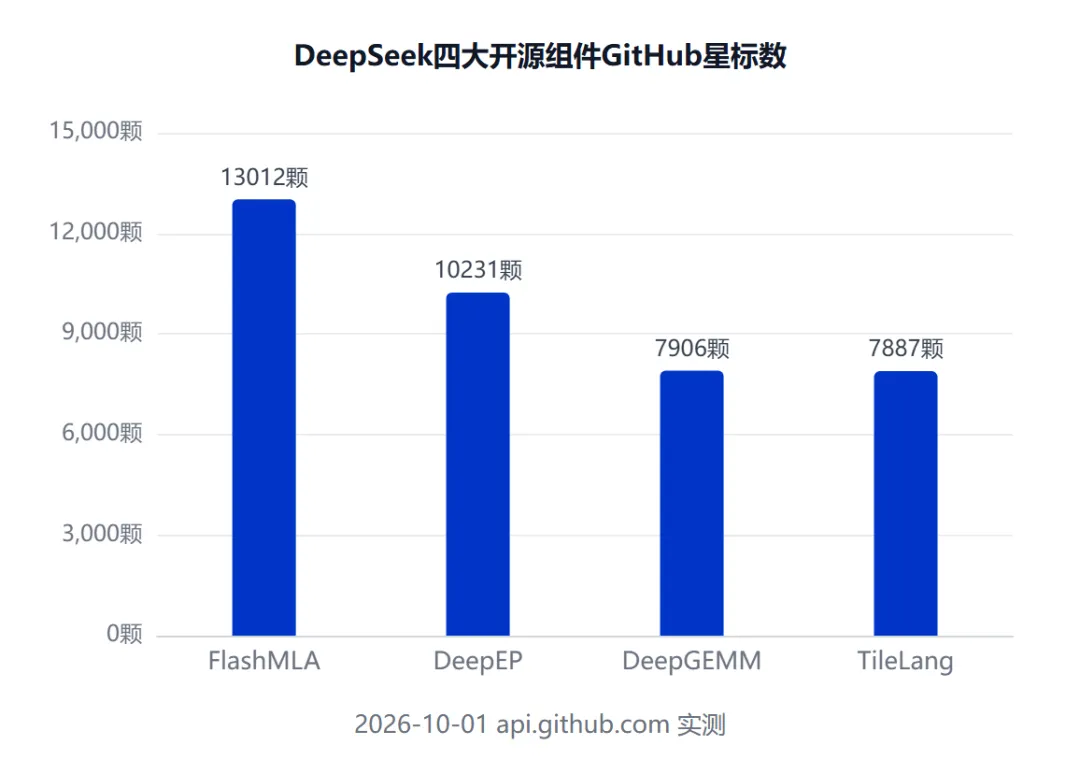
DeepSeek开源组件GitHub星标数,生态用脚投票
另一面是段辛酸旧事。2025年年中,DeepSeek用昇腾训练V4,中途大量崩溃、通信不达预期。最后V4在昇腾上的推理速度,比迁移初期提升了35倍。
差的就是那层软件。DeepSeek自己补完了,这次补的是行业公共品。
说句公道话:CUDA十八年的家底还在,短期没人能替代,英伟达基本盘稳得很。
但黄仁勋2026年4月15日在播客说过一句,当时听着远:如果DeepSeek先在华为平台上发布,对我们国家来说是一个可怕的结果。
9月30日,六件套落地,这个假设的前提正一块块拆掉,听着就近了。
英伟达收的从来不是芯片钱,是迁移税。
不是追上了,是站到对面去了
值得老板们研究的,是打法。
这些年,国产芯片怎么打英伟达?兼容CUDA,模拟生态,性能一项项对标。说白了,这是在英伟达的主场上做它的复读机。
凭什么?规则别人定,你追到95分,人家已经110分。
这打法在定位行当里有个名字:对立定位。《22条商规》说透了:做第二就得对着干,模仿领导者是错误决定,对立点必须是领导者强势中固有的弱点。
英伟达最强势的是什么?CUDA写一次到处能跑。但强势里藏着改不掉的弱点:只在自己的卡上跑。生态越强,绑定越深;绑定越深,客户换门成本越高。
DeepSeek这六件套换了方向:TileLang是硬件中立的算子语言,同一套代码,后端可指向英伟达、昇腾或任何接入的芯片。不在墙内掰手腕,跑到墙外修路。墙没倒,意义变了。
更有意思的是公告那句:TileLang昇腾版本,希望能对更多AI芯片建立高可用软件生态起到示范作用。翻译成人话:寒武纪、摩尔线程、沐曦们别再造轮子,接上中立层。
华为侧也值得看:大EP低延时推理、单卡单机部署同步在CANN社区开源;EP32实测昇腾950超节点支撑V4.1-Flash每卡每秒输出2469到5102个token。
《重新定位》:重新定位的最初定义是为竞争对手贴上负面标签,从而为自己建立正面定位——关键是在领导者的强势中找弱点并攻击。
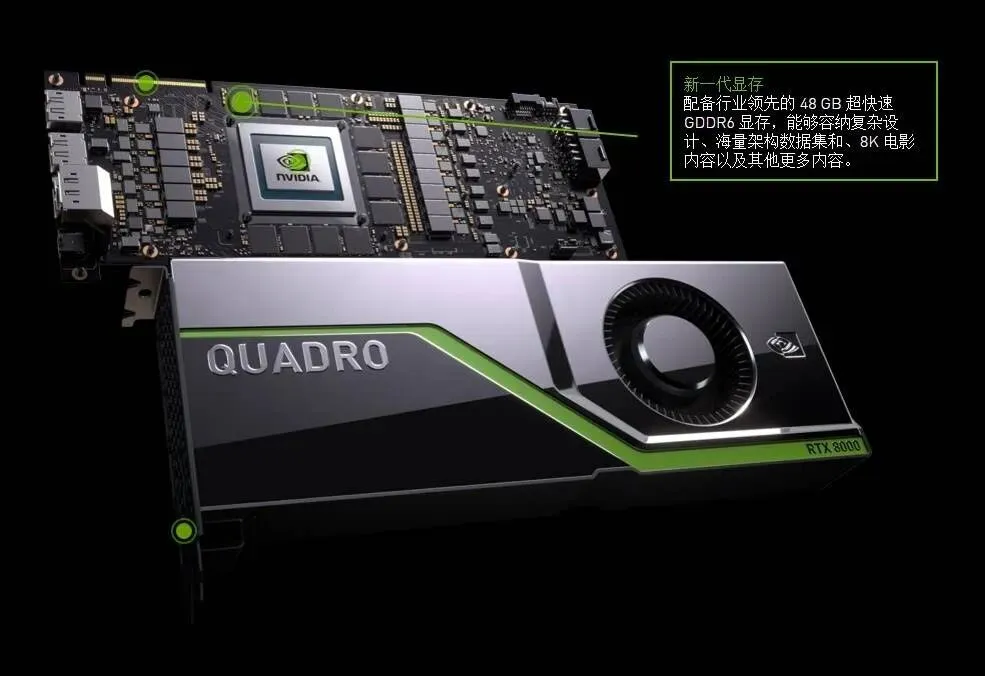
英伟达CUDA计算卡,十八年生态底座
给老板的三问
说回自己的生意。这盘棋与技术无关,是道老板们用得上的定位题。三问存下来,开战略会前过一遍。
第一问:行业老大最强的那件事,绑死了什么?英伟达最强的是生态,绑的是迁移成本。你对面的强者,藏着它改不掉的什么?
第二问:过去一年,你在做老大的复读机,还是站到了对面?对标是复读机,换轨立标准才是站位。
第三问:把你的差异化主张反着念一遍,是不是更适合你的对手?反着念也成立,就是在替对手打广告。
这三问,全从对立定位长出来。
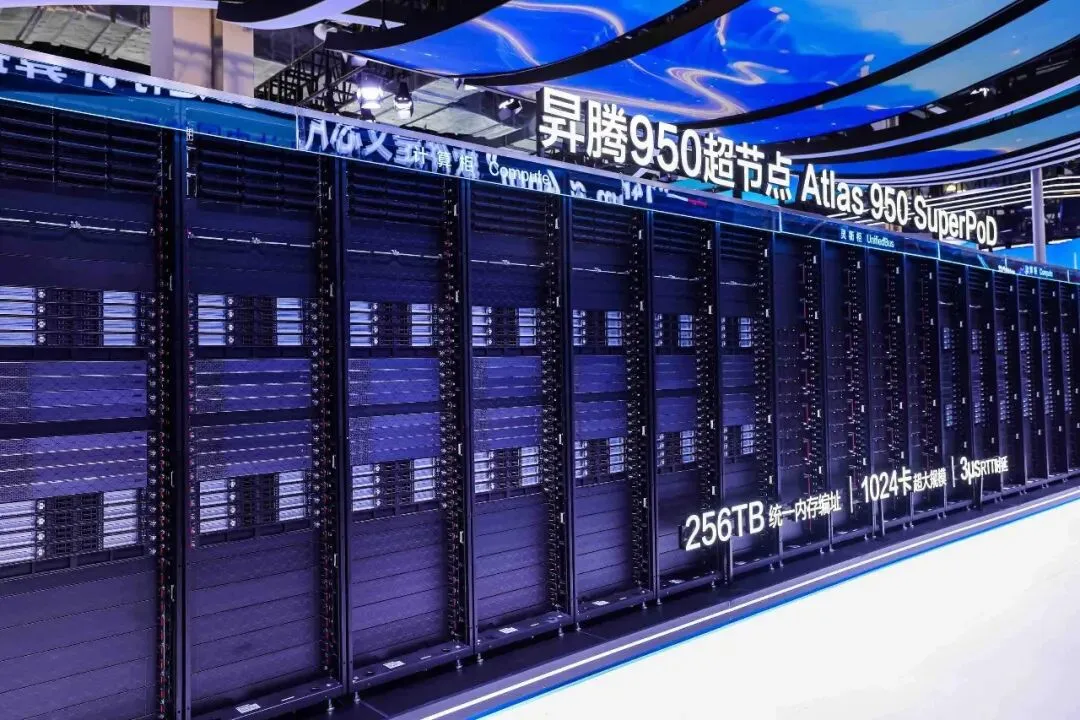
华为昇腾超节点,国产算力底座
昇腾从备胎到上桌,靠的不是发布会,是把生态一步步铺扎实的小动作。这盘棋刚开局,路能修多远没人敢说死。但商业史规律没变过:墙再高,挡不住墙外修路的人。
与其在别人的主场苦练成第二,不如在自己的主场把标准立起来。