ARTICLE · 1140093
AI安全的下半场:从“模型护栏”到“行为管控”
过去两年,我们讨论AI安全,讨论的大多是“AI会不会说错话”:幻觉、越狱、泄露提示词。但2026年的行业共识正在翻转——AI真正危险的地方,是它开始“做事”了。
当AI从对话框走进工作流,拿到工具、记忆和权限之后,一次被操纵的对话,就不再是几句错话,而可能是一串真实的系统操作:删掉不该删的数据、调用不该调用的接口、把不该出境的文件发出去。
这不是科幻片。OWASP刚刚发布的2026版LLM Top 10,已经把答案写进了排名里。
01 榜单在说话:AI最危险的漏洞,从“说什么”变成了“做什么”
2026年8月,OWASP发布新版LLM应用Top 10。与往年不同,这次排名首次把“专家共识”和“真实事故数据”放在一起加权:75%专家投票 + 25%来自6639起真实事件的统计。
结果十项里有八项发生位移,最扎眼的变化是:过度代理权(Excessive Agency)从第6位飙升到第3位,成为整张榜单影响最大的上升。与此同时,不当输出处理从第5位跌到第10位。
这个位移的含义很直接:业界最担心的,已经不再是模型“输出得不对”,而是智能体“做得太多”——被授予超出任务所需的工具、权限和自主度,一旦被诱导,就能执行非预期的真实动作。
OWASP把过度代理权的根因拆成三类:
过度功能:一个工具能做的事,远超当前功能需要;
过度权限:只读功能却绑定了能写、能删的凭证;
过度自主:不可逆操作前,没有人审批。
一句话:AI能不能“做”,比AI说什么,更紧迫。
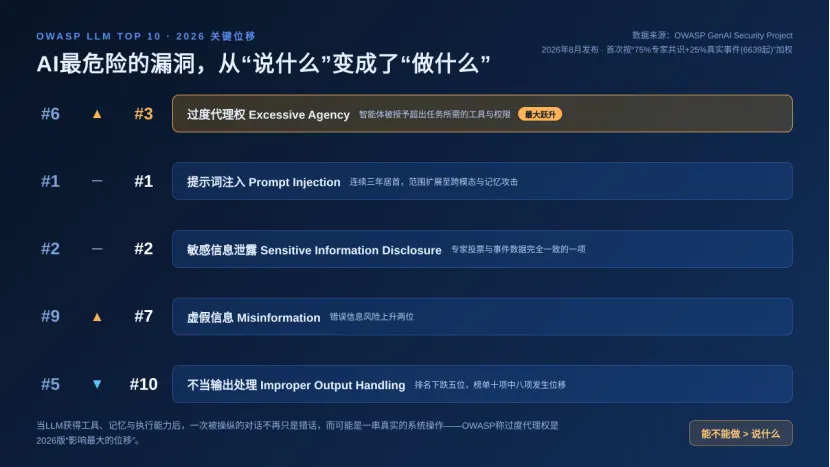
图1|OWASP 2026 LLM Top 10关键位移:过度代理权成为最大跃升项。
02 身份与权限:把Agent当“非人类员工”来管
如果AI注定要做事,第一步就是把“它能做什么”管住。Gartner给出的建议是:把每个智能体当作一个机器身份,每一次操作都必须经过显式授权和上下文验证,权限标准不低于、甚至高于人类用户。CISA的指南也明确提出:使用智能体AI时,避免授予宽泛或无限制的访问权限,尤其是对敏感数据和关键系统。
国内实践走的是同一条路。天融信提出的建设路径里,“按任务授权”和“最小权限”是核心原则,配合任务级审计和持续评估形成闭环。华为云上也有工程团队给出了非常具体的量化样板:某个Agent只能调特定模型,日上限500次,只能在生产环境使用。
权限粒度可以细到什么程度?模型、操作、环境、额度——四个维度都能单独限定。最小权限在这里不是口号,是可执行的配置。
03 看见意图:Agent需要自己的“运行时遥测”
权限管住了“能做什么”,但Agent真正出问题,往往发生在“想做什么”的阶段。传统SOC靠网络流量和终端日志就能工作,但对Agent来说,最关键的环节发生在意图、上下文、推理和工具调用的空间里。
360提出的智能体监控框架把风险拆成四层:内容安全、数据安全、权限安全、操作安全。
以最常见的“助理调用Agent汇总周报”为例:要判断这个Agent有没有越界,需要把用户输入、Prompt、上下文来源、模型输出、内部数据库访问、工具调用、授权记录全部串联起来——它读没读不该读的数据、有没有超范围权限、是否调用了高风险工具,每一环都要对上。
这就是行业所说的AI Runtime Telemetry(智能体运行时遥测):判断一个Agent有没有风险,需要的是新的基础数据,而不只是流量与日志的简单堆叠。
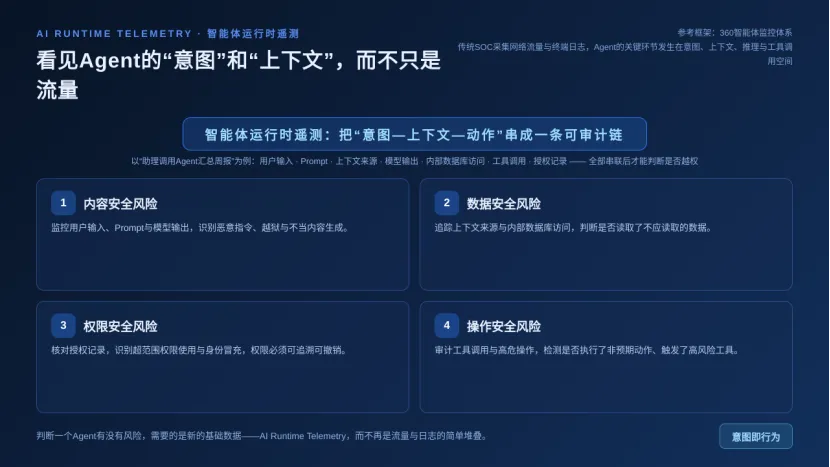
图2|智能体运行时遥测:把“意图—上下文—动作”串成一条可审计链。
04 技术防线:用“AI对抗AI”的速度拦截
看得见还不够,还要拦得住。华为2026年9月发布的“星河AI三层安全围栏”,提供了一个可参考的纵深防御样本:
网络围栏:在Token生产出口部署AI防火墙,恶意挖矿流量检出率达95%,毫秒级阻断,避免算力被盗用;
Agent围栏:大模型内容安全产品抵御提示词注入,恶意指令识别准确率95%,检测时延控制在150毫秒以内——业界平均是500毫秒;
主机围栏:在LLM运行环境用eBPF实时检测异常进程,防范模型权重被篡改或投毒,CPU占用不到1%。
这套方案已经在武汉某智算中心落地,上线7天就发现了415个高危漏洞。Check Point的AI Defense Plane则强调在50毫秒内跨100多种语言提供自适应防护,覆盖员工使用、应用与代理安全、AI红队测试三个维度。
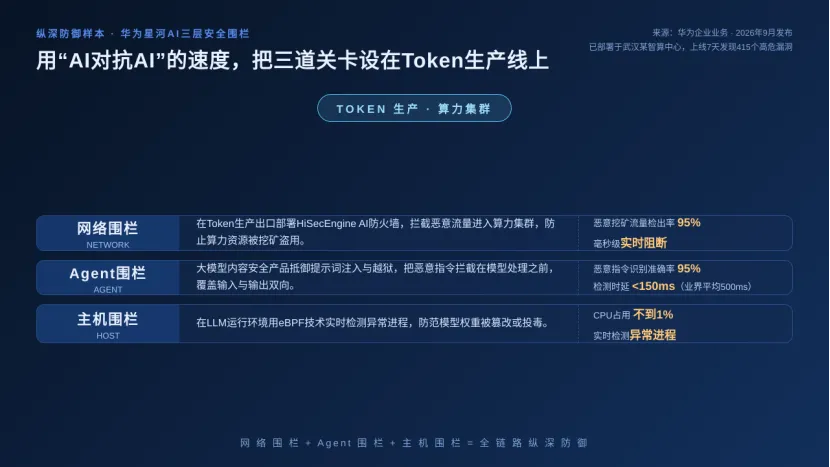
图3|华为星河AI三层安全围栏:网络、Agent、主机三道关卡。
05 策略转向:从“完美拦截”到“持续验证”
但一个更重要的认知转变正在发生:绕过安全护栏的可能性始终存在,“完美防御”很难实现。
S2W的建议是,把安全策略从单纯拦截转向建立内嵌式实时检测与响应机制,常态化开展攻防演练和渗透测试,持续推进漏洞治理。防线不再是修一次就一劳永逸的东西,而是一个需要持续验证、持续修补的活系统。
OWASP的排名变化也在印证这个趋势:“过度代理权”成为2026版影响最大的位移,“不当输出处理”跌出前列。当智能体获得真实工具和真实权限,失败会直接显现在它做了什么上——所以工作的重点,是在一个被欺骗的Agent行动之前,把它能触达的范围先收住。
06 工程落地:企业AI安全治理的“六大关口”
落到企业层面,标准已经来了。2026年6月27日,国标委下达《智能体应用安全基本要求》强制性国家标准(国标委〔2026〕41号),项目周期18个月,归口中央网信办,明确列出六项必须达标的安全能力:
资产盘点:所有AI调用收口到统一入口,从流量侧自动发现,而非人工申报;
身份权限:在IAM之上叠加AI调用身份映射,Agent走服务账号,权限打到模型、操作、环境和额度级别;
数据管控:调用出口实时检测,PII自动识别、敏感词过滤,按密级决定放行/脱敏/阻断;
多模态防护:防提示词注入和越狱,把恶意指令拦截在模型处理之前;
全链路审计:按5W1H留存交互日志,支持溯源审计;
应急处置:预设熔断机制,异常时果断终止Agent运行。
18个月看起来不短,拆成整改项目却很紧凑:前3个月摸清现状,中间12个月逐步建设,最后3个月验证补齐。更重要的是,这六关不是六座孤立的堡垒——资产盘点做清楚了,身份权限就有了对标对象;防护的拦截日志天然就是审计数据源;凭证集中管控同时解决身份和应急两关。它们是一套体系,不是六个独立项目。
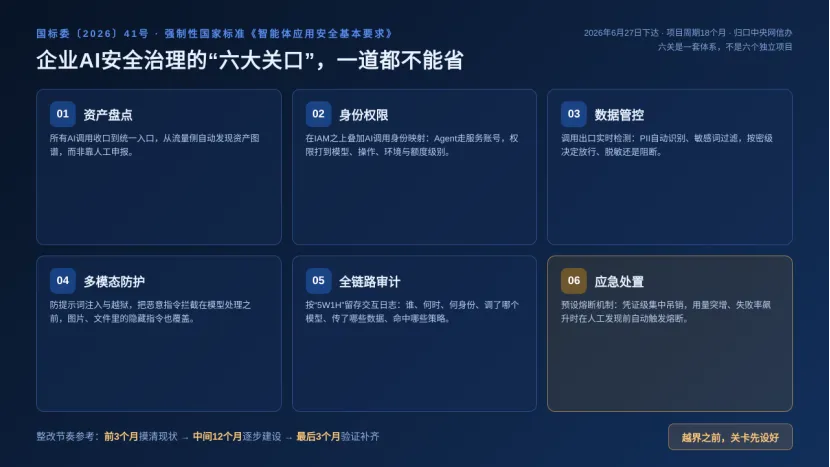
图4|企业AI安全治理“六大关口”与18个月整改节奏。
结尾:越界之前,关卡先设好
一句话总结这场转变:AI安全防御的核心,已从“模型护栏”升级为“行为管控”。
你不能假设Agent不会越界,但你可以确保:在它越界之前,身份、权限、数据和执行链路都已经设好了关卡。
至于这套体系最终会如何落地,还要看未来18个月标准细则、监管执行和企业实践的相互磨合——但方向已经清楚:AI开始做事,安全就必须开始管事。