ARTICLE · 1143316
AI 的胜负手已经不是模型了—— 从单体模型到复合 AI 系统
伯克利 BAIR 博客 · 全文中译
原文:The Shift from Models to Compound AI Systems作者:Matei Zaharia 等 11 人 | 首发:2024 年 2 月 18 日
编者按 · 为什么现在还要读这篇
2024 年 2 月 18 日,伯克利 BAIR 博客发了一篇不算长的文章。署名者有 11 位,排在最前面的是 Matei Zaharia——Apache Spark 的创造者、Databricks 的 CTO;第三位是 Omar Khattab,后来写出了 DSPy。
这篇文章只说了一件事:AI 的竞争优势,正在从「谁的模型更强」转移到「谁的系统组合得更好」。
当时这句话还只是个判断。两年后的 2026 年秋天,斯坦福新开了一门课 CS329Z《Engineering AI Agents》,第一讲的必读文献,就是这一篇。而文中点名的那些东西——DSPy、FrugalGPT、AI Gateway、LLMOps——今天已经成了 Agent 工程师工具箱里的常规件。
所以这篇译文值不值得读,取决于你想不想搞清楚一件事:为什么大家都在卷系统,而不是继续卷模型。
2023 年,AI 吸引了所有人的注意力——大语言模型(LLM)只要用提示词指挥一下,就能完成翻译、写代码这类通用任务。这自然导致所有人把目光死死盯在「模型」上,把它当成 AI 应用开发的头号原料,天天追问:下一代 LLM 会带来什么新能力?
但随着越来越多的开发者真的动手用 LLM 搭东西,我们相信这个焦点正在快速转移:最前沿的 AI 成果,越来越多地来自「由多个组件构成的复合系统」,而不是单一的整体式模型。
举个例子。Google 的 AlphaCode 2 在编程任务上拿下 SOTA,靠的是一个精心设计的系统:用 LLM 为一个题目生成多达 100 万个候选解,然后再层层过滤。AlphaGeometry 同理,它把 LLM 和传统的符号求解器组合在一起,去啃奥林匹克几何题。在企业侧,我们在 Databricks 的同事发现,60% 的 LLM 应用用了某种形式的检索增强生成(RAG),30% 用了多步链。
甚至连做传统语言模型任务的研究者也是如此——过去他们报告的是「单次调用 LLM」的结果,现在报告的是越来越复杂的推理策略:微软写过一种链式策略,在医学考试上比 GPT-4 的准确率高出 9%;Google 发布 Gemini 时,其 MMLU 成绩是用一种叫 CoT@32 的新推理策略测出来的——同一个模型调用 32 次——这也让人质疑它和「只调用一次 GPT-4」之间到底可不可比。
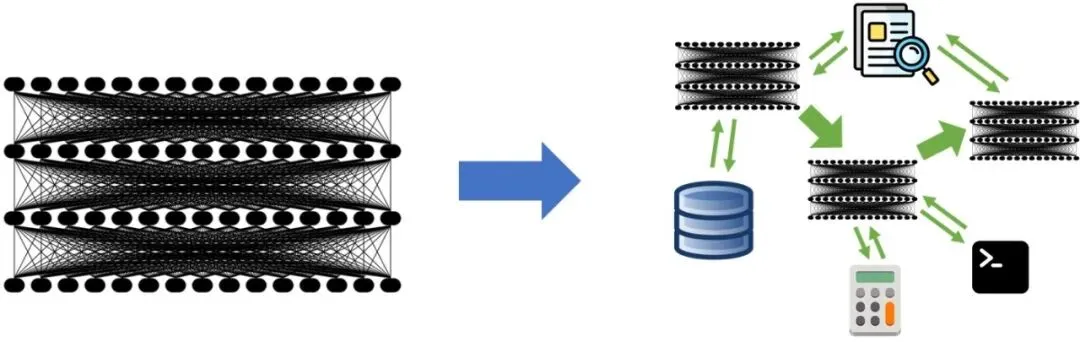
越来越多的新 AI 成果,来自复合系统
向复合系统的转向,打开了大量有意思的设计问题,但这也令人兴奋——因为它意味着,最顶尖的 AI 成果可以通过巧妙的工程实现,而不只是靠堆训练规模。
在这篇文章里,我们分析复合 AI 系统这一趋势,以及它对 AI 开发者意味着什么:开发者为什么要搭复合系统?随着模型变强,这个范式还会存在吗?以及——用来开发和优化这类系统的新兴工具有哪些(相比模型训练,这个方向的研究少得多)?
我们的论点是:复合 AI 系统很可能是未来最大化 AI 效果的最佳路径,并且可能是 2024 年最具影响力的 AI 趋势之一。
一、为什么要用复合 AI 系统?
先给出定义。复合 AI 系统,指的是用多个相互作用的组件来完成 AI 任务的系统,这些组件包括多次模型调用、检索器或外部工具。相对地,AI 模型只是一个统计模型,比如一个预测下一个 token 的 Transformer。
尽管模型在持续变强、规模化也看不到尽头,但有越来越多的 SOTA 成果是用复合系统拿到的。为什么?我们看到了几个彼此不同的原因。
1. 有些任务,改系统比改模型划算得多。
LLM 确实遵循着惊人的规模定律——算力越多,结果可预测地越好。但在很多应用里,规模化带来的「收益/成本」比,不如搭一个复合系统。假设当前最好的 LLM 解编程竞赛题的成功率是 30%,把训练预算翻三倍能提到 35%——可这仍然不足以赢下一场比赛!反过来,像 AlphaCode 那样设计一个系统:从模型里采样多次、逐个测试……用今天的模型就可能把表现推到 80%。更关键的是,迭代一个系统设计,通常比等一轮训练跑完快得多。我们相信,在任何高价值应用里,开发者都会想用上一切可用手段去最大化 AI 质量,所以他们会在规模之外叠加系统思路。我们在 LLM 用户身上反复看到这个模式:一个好模型能做出令人惊艳但「该死地不稳定」的第一版 demo,然后工程团队进场,系统性地把质量抬上去。
2. 系统可以是动态的。
机器学习模型有一个天生的局限:它们在静态数据集上训练,所以「知识」是写死的。因此开发者必须把模型和搜索、检索这类组件组合起来,才能纳入实时数据。此外,训练过程让模型「看见」了整个训练集,所以要构建带访问控制的应用(比如:只根据用户有权查看的文件来回答他的问题),就必须用更复杂的系统。
3. 可控性和可信度,做进系统里更容易。
单靠神经网络模型很难控制:训练固然能影响它,但几乎不可能保证模型一定不会做出某种行为。改用 AI 系统,开发者就能更紧地约束行为,比如对模型输出做过滤。同样地,即使是最好的 LLM 依然会幻觉;但一个把 LLM 与检索结合起来的系统,可以通过给出引用来源或自动核查事实来提升用户信任。
4. 性能目标差异极大。
每个 AI 模型的质量水平和成本都是固定的,但应用往往需要调节这两个参数。有些场景(比如行内代码补全)里最好的模型太贵了,于是 GitHub Copilot 这类工具改用精心调优的小模型加各种搜索启发式来出结果。而在另一些场景里,连 GPT-4 这种最大的模型都「太便宜了」——很多用户愿意为一份正确的法律意见付几美元,而不是花几分钱问一次 GPT-4,但开发者需要设计一个 AI 系统,才能把这个更大的预算用掉。
生成式 AI 向复合系统的转向,也和其他 AI 领域的产业趋势一致,比如自动驾驶:绝大多数最先进的落地实现,都是由多个专用组件构成的系统。基于这些原因,我们相信——即使模型持续进步,复合 AI 系统仍将是主流范式。
二、复合 AI 系统的设计空间
下面列出几个近期的复合 AI 系统,用来展示设计选择有多宽:
系统 | 组件 | 设计 | 结果 |
AlphaCode 2 | 用于采样和给程序打分的微调 LLM代码执行模块聚类模型 | 为一个编程题生成多达 100 万个解,然后过滤并打分 | 达到人类参赛者的第 85 百分位 |
AlphaGeometry | 微调 LLM符号数学引擎 | 用 LLM 迭代地提出几何题中的辅助构造,并由符号引擎检验推导出的新事实 | 在限时测试中,水平介于 IMO 银牌与金牌得主之间 |
Medprompt | GPT-4正确样例库上的最近邻搜索LLM 生成的思维链样例多次采样与集成 | 回答医学问题时,先检索相似样例构造 few-shot 提示,为每个样例补上模型生成的思维链,再生成并评判最多 11 个答案 | 超过 Med-PaLM 等用简单提示策略的专业医学模型 |
Gemini on MMLU | Gemini LLM自定义推理逻辑 | CoT@32:从模型采样 32 个思维链答案,若足够多答案一致则返回首选,否则退回不用思维链的生成方式 | MMLU 90.04%,对比 GPT-4 五样本的 86.4%、Gemini 五样本的 83.7% |
ChatGPT Plus | LLM网页浏览插件(检索实时内容)代码解释器插件(执行 Python)DALL·E 图像生成器 | 可调用网页浏览等工具来回答问题;由 LLM 自行决定在回应过程中何时、如何调用每个工具 | 拥有数百万付费订阅者的消费级 AI 产品 |
RAG、ORQA、Bing、Baleen 等 | LLM(有时被调用多次)检索系统 | 以多种方式把 LLM 与检索系统组合,例如让 LLM 生成检索式,或直接针对当前上下文做搜索 | 搜索引擎与企业应用中被广泛使用的技术 |
三、复合 AI 系统的三大挑战
相比单个 AI 模型,复合 AI 系统在设计、优化和运维三方面都带来了新难题。
挑战一:设计空间太大。
给定一个任务,可能的系统设计范围极其宽广。哪怕只看最简单的检索增强生成(RAG)——一个检索器加一个语言模型——也至少有:(i) 一大堆可选的检索模型和语言模型;(ii) 一堆提升检索质量的技术,比如查询扩展或重排序模型;(iii) 一堆改善 LLM 输出的技术,比如再跑一个 LLM 来检查输出是否与检索到的段落相关。开发者必须在这个巨大的空间里探索,才能找到一个好设计。
此外,开发者还要在延迟和成本预算这些有限资源上做分配。比如:如果你想在 100 毫秒内回答一个 RAG 问题,那么是给检索器 20 毫秒、给 LLM 80 毫秒,还是反过来?
挑战二:优化。
在机器学习里,要让复合系统的质量最大化,往往需要把各组件放在一起协同优化。设想一个简单的 RAG 应用:LLM 看到用户问题,生成一个检索式发给检索器,然后生成答案。理想情况下,LLM 应该被调成「能生成对那个检索器友好的查询」,而检索器也应该被调成「偏好对那个 LLM 友好的答案」。
在 PyTorch 那样的单模型开发里,用户可以很容易地端到端优化,因为整个模型是可微的。但复合 AI 系统里包含了搜索引擎、代码解释器这类不可微组件,因此需要全新的优化方法。优化复合 AI 系统至今仍是一个崭新的研究领域:比如 DSPy 提供了一个面向「预训练 LLM + 其他组件」流水线的通用优化器;而 LaMDA、Toolformer、AlphaGeometry 这类系统则选择在模型训练期间就引入工具调用,让模型适配那些工具。
挑战三:运维。
机器学习运维(MLOps)对复合 AI 系统来说变得更难。举例说:跟踪一个垃圾邮件分类器这类传统 ML 模型的成功率很容易,但如果换成完成同一任务的 LLM 智能体——它可能使用了数量不定的「反思」步骤或外部 API 调用来对一条消息分类——开发者该怎么跟踪和调试它的表现?我们相信,新一代 MLOps 工具会应运而生。其中有几个有意思的问题:
监控:开发者怎样才能高效地记录、分析和调试复杂 AI 系统产生的 trace?
DataOps:因为很多 AI 系统包含向量库这类数据服务组件,而系统的行为取决于所服务数据的质量,所以面向这些系统的运维工作必须额外覆盖数据管线。
安全:已有研究表明,复合 AI 系统(比如一个带内容过滤器的 LLM 聊天机器人)相比单个模型,可能产生意料之外的安全风险。保护这些系统将需要新工具。
四、正在成型的新范式
为应对构建复合 AI 系统的这些挑战,产业界和学术界涌现出多种新方法。下面挑几个使用最广的,以及我们自己在这些挑战上的研究成果。
设计 AI 系统:组合框架与策略。
很多开发者现在在用「语言模型编程」框架,让应用由多次 AI 模型调用和其他组件拼装而成。这包括供传统程序调用的组件库(LangChain、LlamaIndex),也包括让 LLM 来驱动应用的智能体框架(AutoGPT、BabyAGI),以及用于控制 LM 输出的工具(Guardrails、Outlines、LMQL、SGLang)。与此同时,研究者也在开发大量新的推理策略,用对模型和工具的调用来生成更好的输出,比如思维链、自一致性、WikiChat、RAG 等等。
自动优化质量:DSPy。
DSPy 来自学术界,是第一个旨在「优化一个由 LLM 调用和其他工具组成的系统,以最大化某个目标指标」的框架。用户用对 LLM 和其他工具的调用写出应用,给出一个目标指标(比如验证集上的准确率),然后 DSPy 会自动调优整条流水线——为每个模块生成提示指令、few-shot 样例和其他参数选择,以最大化端到端表现。这个效果类似于在 PyTorch 里对多层神经网络做端到端优化,只不过 DSPy 里的模块并不总是可微的层。为了做到这一点,DSPy 用了一种很干净的方式利用 LLM 的语言能力:指定每个模块时,用户写一个自然语言签名,比如 user_question -> search_query,其中输入输出字段的名字是有语义的;DSPy 会自动把它转成合适的提示——带上指令、few-shot 样例,甚至是对底层语言模型的权重更新。
优化成本:FrugalGPT 与 AI 网关。
可用的 AI 模型和服务范围太广,给一个应用挑对模型变得很难;而且不同模型在不同输入上表现可能各有优劣。FrugalGPT 是一个自动把输入路由到不同 AI 模型级联上的框架,目标是在给定预算下最大化质量。基于少量样例,它能学会一种路由策略:在同等成本下比最好的 LLM 服务高出最多 4%,或者在保持同等质量的前提下把成本降低最多 90%。FrugalGPT 是一个更大概念——AI 网关或路由器——的早期例子,这类思路已经在 Databricks AI Gateway、OpenRouter、Martian 等软件中落地,用来优化 AI 应用每个组件的表现。而当 AI 任务在复合系统中被拆成更小的模块化步骤、网关可以为每一步单独优化路由时,这些系统会工作得更好。
运维:LLMOps 与 DataOps。
AI 应用一直都需要同时仔细监控模型输出和数据管线,才能可靠运行。而有了复合 AI 系统,系统在每个输入上的行为可能复杂得多,因此跟踪应用走过的所有步骤和中间输出变得非常重要。LangSmith、Phoenix Traces、Databricks Inference Tables 这类软件可以细粒度地跟踪、可视化和评估这些输出,某些情况下还能把它们与数据管线质量和下游指标关联起来。在研究界,DSPy Assertions 试图直接把监控检查的反馈用在 AI 系统里以改善输出;而 MT-Bench、FAVA、ARES 这类基于 AI 的质量评估方法,则致力于把质量监控自动化。
五、结论
生成式 AI 让每一个开发者都兴奋不已,因为它用自然语言提示就解锁了大量能力。但随着开发者想要越过 demo 阶段、最大化自己 AI 应用的质量,他们正越来越多地转向复合 AI 系统——把它当作控制和增强 LLM 能力的自然方式。
开发复合 AI 系统的最佳实践是什么,至今仍是一个开放问题;但在设计、端到端优化和运维这三件事上,已经有了令人兴奋的可用方法。我们相信,复合 AI 系统仍将是未来最大化 AI 应用质量与可靠性的最佳路径,并可能是 2024 年最重要的 AI 趋势之一。
译者后记:两年后再读这篇
① 它说对了吗?说对了,而且比作者自己预计的更彻底。2024 年它说「可能是 2024 年最重要的趋势之一」;到 2026 年,复合系统已经不是趋势,而是默认形态——斯坦福专门开了一门课教它。
② 最值钱的一句话是「迭代系统设计比等训练快得多」。这条在今天依然成立,而且被概括成了一句行业共识:模型的迭代周期以月计,系统的迭代周期以天计。
③ 「有些模型太贵,有些模型太便宜」这个观察被低估了。前者催生了模型路由与 AI 网关,后者解释了为什么会出现「用几十次模型调用换一个高价值答案」的 Agent——这也是今天按结果付费的 Agent 产品的经济学基础。
④ 唯一没展开的是评估。这篇文章把「设计 / 优化 / 运维」列为三大挑战,但没单独谈「怎么知道系统做对了」。两年后,评估恰恰成了最重的一块——斯坦福 CS329Z 用整整两讲加一份作业来讲它。这大概是这篇预言唯一没算到的地方。
原文信息
The Shift from Models to Compound AI Systems
作者:Matei Zaharia、Omar Khattab、Lingjiao Chen、Jared Quincy Davis、Heather Miller、Chris Potts、James Zou、Michael Carbin、Jonathan Frankle、Naveen Rao、Ali Ghodsi
发布:BAIR Blog,2024 年 2 月 18 日
链接:bair.berkeley.edu/blog/2024/02/18/compound-ai-systems/
本文为中文翻译与解读,原文版权归原作者所有,译文仅供学习交流。文中数据均为原文发布时的原始数字。