ARTICLE · 1145341
为什么把长文档全塞进Prompt是灾难?顶级AI工程师都在用的上下文预算方法!
我是老九,一个一直在一线折腾技术和AI的人。我习惯留意一些看着很先进,但放到工作和生活里付出不小代价的事。欢迎关注我!
不要错过文章最后的总结图呦!
当前章节:第四章|上下文窗口与记忆机制:AI到底能记住多少?
当前小节:第七节|上下文不够长,工程上怎么办?
本篇知识点:context budgeting
前段时间做文档问答功能,测试拿了几份小文件,效果挺好。用户上传文档,后台读出来和问题拼在一起:
下面是文档内容:
……
请根据文档回答:
设备出现异常以后怎么处理?
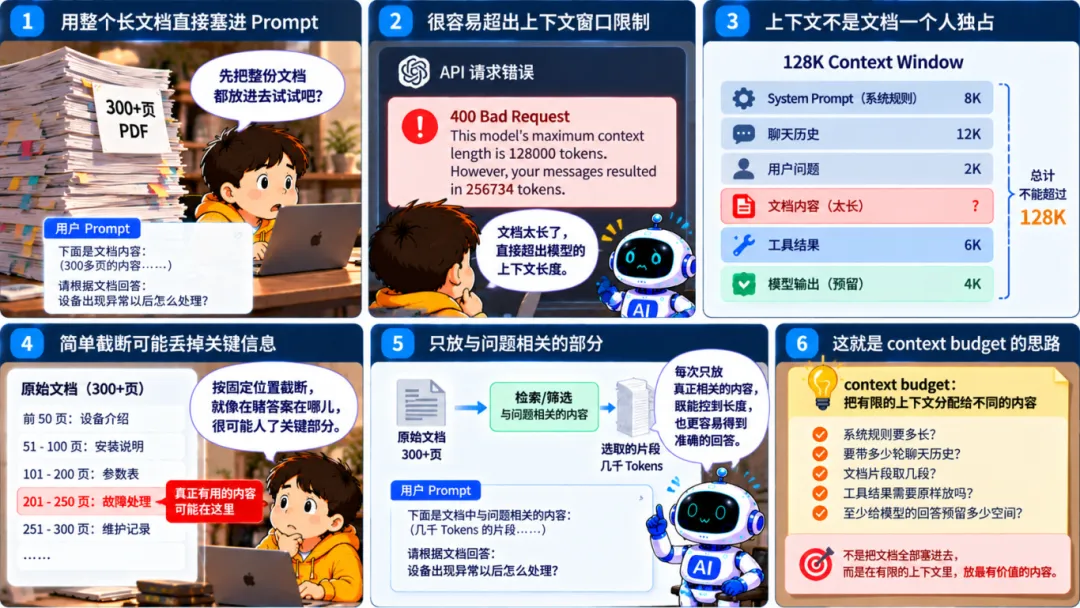
几页PDF没什么问题,换了份正式资料,三百多页。还按原来的办法处理,解析完往Prompt里放,结果不对劲了。
有时候请求超出上下文长度;换成更长上下文的模型,请求能发出去,但前面还放系统规则、用户的问题、之前的聊天记录。
文档不是独占上下文,不能只算模型支持多少Token?还得算这次请求,准备把多少Token留给谁?
工程里会碰到一个词context budget。
比如模型的上下文窗口能放128K Token,接接口时,不会把128K全留给上传的文档,还有别的东西。System Prompt占一部分,聊天历史占一部分,用户的问题在里面。工具调用返回了一些内容,同样可能继续往里占。还有个地方:模型还得回答。前面塞得太满,留给输出的空间就不够了。
128K Context Window
System Prompt
聊天历史
用户问题
文档内容
工具结果
模型输出预留
这些加起来不能超过这次请求承受的范围,麻烦从这里开始。三百多页,用户:“设备告警以后,现场人员第一步做什么?”答案在其中两三页,为了保险,把设备介绍、安装说明、参数表、维护记录、附录全部塞进去,相当于为了两三页内容,把三百多页搬到了模型面前。
能不能放进去,和该不该放进去,是两回事。
试过最直接的处理:文档太长从后面截掉。又碰到问题—答案刚好在被截掉的部分。
改成保留文档前后,中间少放点,也不行,有些有用的在中间。
按固定位置砍,基本是在赌答案在哪儿。
后来变了,用户问题先过来,从文档里找相关的部分,比如搜到“设备告警”“现场处置”“故障处理”附近的几段,把这些放进本次Prompt。
用户换成:“这个设备正常工作温度是多少?”
拿出来的是另外几段。
文档还是那份,每次进入上下文的内容不一样。这时候context budget才像个工程问题,预算不够总得有人让位置。
是少带几轮聊天记录?
System Prompt再短一点?
文档片段取 5 段还是 10 段?
工具结果是不是没必要原样全放?
回答至少留多少空间?
这些动一点,给文档留下来的位置都会变。
再看到“这个模型支持超长上下文”,先算下:这轮值得占上下文的是哪几块,比抱着整份文档往上下文里硬塞靠谱得多。
如果你读着还行,欢迎点赞收藏关注;如果有不同的观点,也欢迎大家留言讨论。