ARTICLE · 1149431
Nature|谷歌云AI研究Google Fellow Juraj Gottweis:智能体迭代改进科研假设
通讯作者
通讯作者Juraj Gottweis是Google Cloud AI Research的Google Fellow。Juraj Gottweis与Google DeepMind、Google Research及外部实验团队共同研究了Co-Scientist的假设生成、系统评测和生物医学体外验证。论文还列有Wei-Hung Weng、Pushmeet Kohli、Annalisa Pawlosky、Alan Karthikesalingam和Vivek Natarajan五位通讯作者。
研究团队构建的Co-Scientist使用多个基于Gemini 2.0的智能体生成、评审、排序和修订科研假设。系统在持续计算过程中提高了内部评估的假设评分;独立专家在一组生物医学问题上也更偏好其输出。研究团队随后对经专家筛选的部分假设开展细胞系和类器官实验,取得初步体外证据。论文中的“自我改进”指推理阶段的假设修订和反馈传递,不表示基础模型参数在运行中自行更新,也不等于临床疗效已经获得证实。
01Co-Scientist的假设质量随迭代评估提高
研究团队将203项不同科研目标下生成的假设按时间顺序分成十组,每组对应总生成时间的10%,分别计算每组最高Elo评分与前十项假设的平均Elo评分。这些目标主要来自生物医学,也包括数学和物理等领域。两项指标从早期组到后期组总体上升。这个结果反映同一套生成、评审、排序与修订流程在增加推理计算后产生了评分更高的候选假设。Elo评分来自系统内部的成对比较,不能单独证明每项假设在真实世界中正确。
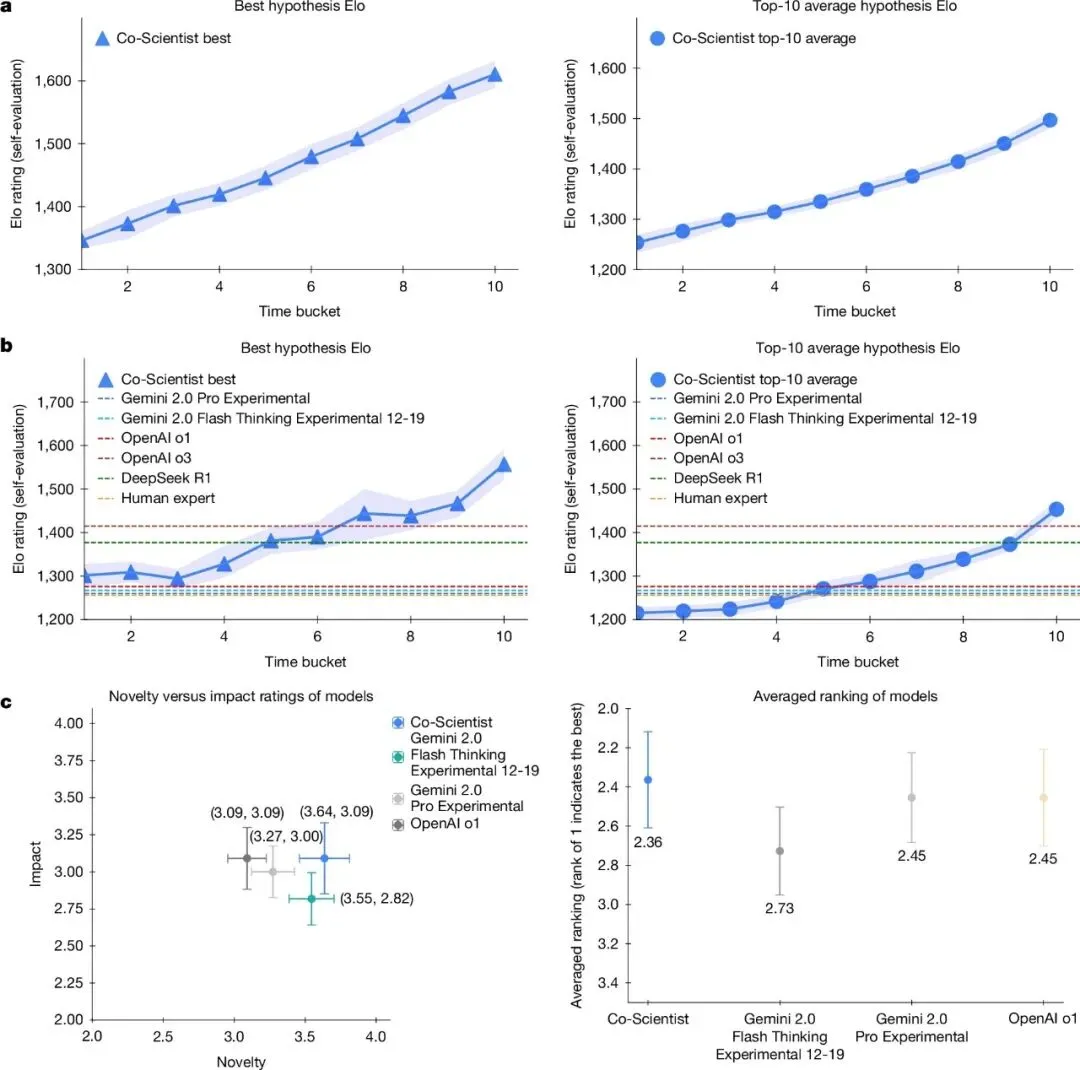
图2|图2展示203项科研目标的假设评分随推理过程变化,以及模型对照和专家评估结果。图源为Nature论文原图。
研究团队又选取15项由七名生物医学专家提出的复杂目标。每项目标都写明研究问题、偏好、预期属性及实验约束;专家还提供自己的初始设想。研究团队将这些设想、Co-Scientist输出与当时多个语言模型的输出放入同一评比流程。Co-Scientist的内部Elo评分随迭代增加,并在该评比中超过多个对照输出。系统也能以专家的初始设想为起点继续修订,修订结果的Elo评分在后期超过系统从零生成的结果。论文将这一观察界定为需要进一步核验的初步发现。上述对照仍由系统自身的评分机制参与,因此论文另安排专家检查假设的新颖性与影响力。
在其中11项供专家盲评的开放生物医学问题上,评价者分别对四套系统的输出给出偏好名次,并在五分制下评价新颖性和潜在影响力。Co-Scientist输出的平均偏好名次为2.36,新颖性和影响力均分分别为3.64和3.09。研究团队说明,这些数值是专家的主观判断,样本量也有限。补充材料进一步用GPQA Diamond基准检验Elo评分与答案正确率的关系;按每道题最高Elo候选取答案时,系统取得78.4%的top-1准确率。该基准为评分提供了另一种检查,未替代对新科研假设的实验验证。
这个评测体系包含三个证据层次。203项目标的Elo轨迹衡量系统内部的迭代趋势;15项专家设定目标将系统输出与专家初始设想及当时的语言模型输出放在同一内部锦标赛中比较;11项目标的专家盲评则加入系统外部的人类判断。三者测量的对象和样本不同,不能将内部Elo分数直接换算成实验成功率。研究团队选择少量候选进入体外验证,正是为了检验高排名假设能否获得独立的生物学支持。
02经专家筛选的候选在急性髓系白血病细胞中显示活性
研究团队先限定系统从约2300种已获批药物与34类癌症的组合中提出药物再利用假设,再由肿瘤专家审阅排名靠前的30项候选。实验人员选择部分药物,在MOLM-13、KG-1a、HL-60和NOMO-1四种急性髓系白血病细胞系及非白血病TK6细胞系中测量剂量反应。该设计把计算筛选、专家判断与细胞实验连接起来;论文将这些实验界定为早期生物学验证。
首批五种药物为binimetinib、pacritinib、cerivastatin、pravastatin和dimethyl fumarate。其中前三种药物抑制了受测细胞的活力;binimetinib在NOMO-1之外的受测急性髓系白血病细胞系中,半数抑制浓度低至2 nM,而TK6细胞的对应浓度高得多。研究团队还要求系统在缺少人类专家反馈和额外外部评分的条件下提出此前没有该适应证临床前证据的候选。专家从前三名中选出nanvuranlat、KIRA6和leflunomide,实验显示KIRA6抑制了多个白血病细胞系的活力,另外两种药物在MOLM-13细胞中的作用有限。
KIRA6是IRE1α抑制剂。系统的文献核查指出,AML中的IRE1α靶点已有研究,而KIRA6这一具体药物用于该适应证的假设仍具有一定新颖性。KIRA6在KG-1a细胞中的半数抑制浓度为10 nM,在非白血病TK6细胞中为180 nM,相差18倍;NOMO-1、MOLM-13和HL-60细胞的对应数值分别为144 nM、1750 nM和870 nM。图3中的剂量反应数据来自三次生物学独立实验,研究团队使用非线性回归估计半数抑制浓度及其95%置信区间。不同细胞系的敏感性存在差异,细胞实验不支持将这一结果直接推广为普遍的治疗效果。
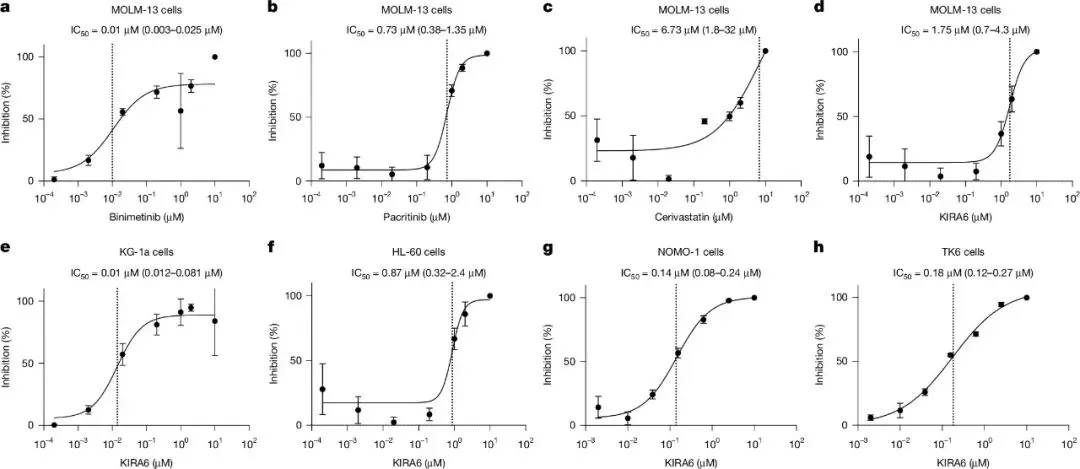
图3|图3展示药物候选及KIRA6在多种细胞系中的完整剂量反应结果。图源为Nature论文原图。
研究团队还在MOLM-13和KG-1a细胞中检验了七种系统建议的药物组合。JNJ-64619178与selinexor的双药组合,以及JQ1、olaparib与MSA2的三药组合,在MOLM-13细胞中呈现协同作用。研究团队用Chou–Talalay组合指数评价双药组合;该指标低于1表示协同,高于1表示拮抗。三药组合的不同浓度矩阵由最高单药效应和Bliss独立性模型评价。KG-1a细胞对相同组合呈现依赖具体组合和剂量的不同反应,部分条件出现拮抗;论文没有将一种细胞系中的协同结果视作所有细胞系的共同结论。协同分析采用三次生物学独立重复。
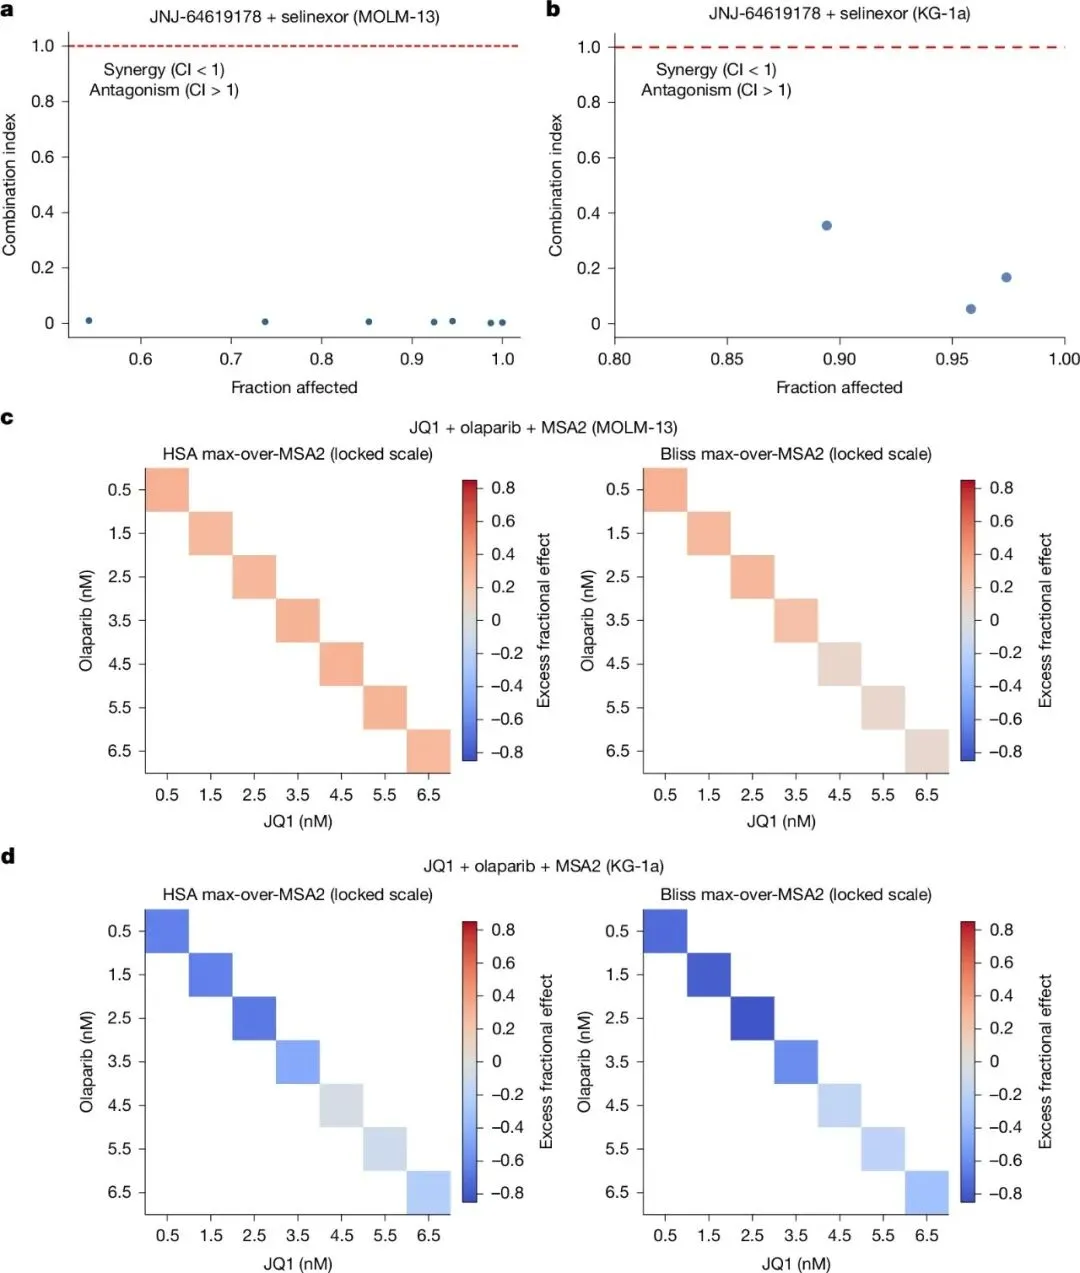
图4|图4展示两种白血病细胞系中双药组合的组合指数,以及三药组合相对加和效应的变化。图源为Nature论文原图。
03另外两类体外实验检验了系统提出的研究假设
在肝纤维化问题上,系统提出表观遗传调节因子及相应药物,专家从排名靠前的假设中选出三个方向。研究团队使用人肝类器官和活细胞成像开展验证,其中两种药物降低了纤维化相关表型且未产生所报告的细胞毒性。一种有效药物为已在其他癌症适应证获批的vorinostat。这里的计算任务涵盖了靶点与药物的联合筛选,实验则对专家挑选的少数方向提供类器官证据。论文将这项结果限定在人肝类器官实验中,未据此声称已经获得临床治疗方案。
在抗菌药物耐药相关的问题上,研究人员只向系统提供有限背景信息,要求解释携带耐药相关基因的cf-PICI可在多种细菌间传播的机制。系统排名最高的假设指出,cf-PICI能够与不同噬菌体尾部相互作用,从而扩大宿主范围。另一研究团队同期开展的实验研究随后报告了相符机制。这个案例检验的是系统在不知道尚未发表结果时能否提出可解释既有现象的机制假设;实验发现来自独立团队。
04多智能体反馈机制支撑假设迭代
研究人员用自然语言输入研究目标,并可补充实验条件、方案偏好和限制。Co-Scientist的监督智能体将目标解析为研究计划配置,分配异步任务,并根据已生成、待评审和已排序假设的状态调整后续任务。生成智能体检索文献并提出候选,评审智能体检查合理性、新颖性和可检验性,排序智能体通过成对辩论组织Elo评比,演化智能体修订高排名假设。邻近性智能体识别相似提案,元评审智能体汇总评审与辩论中的共性问题,并将反馈加入下一轮智能体提示词。系统还保存任务状态与上下文,以便继续较长的推理流程。
生成智能体既可从文献中提出新假设,也可围绕已有假设补充可检验的中间前提。评审智能体先进行快速检查,再对通过初审的候选调用外部检索,核对假设依据和既有研究。排序智能体组织两两比较;邻近性智能体把相似提案归为相关群组,减少重复探索。演化智能体结合评审意见、文献和相近思路生成修订版。监督智能体根据锦标赛状态决定下一轮更适合增加新候选,还是继续审查和改进已有候选。这些操作共同构成论文所称的假设层面自我改进。
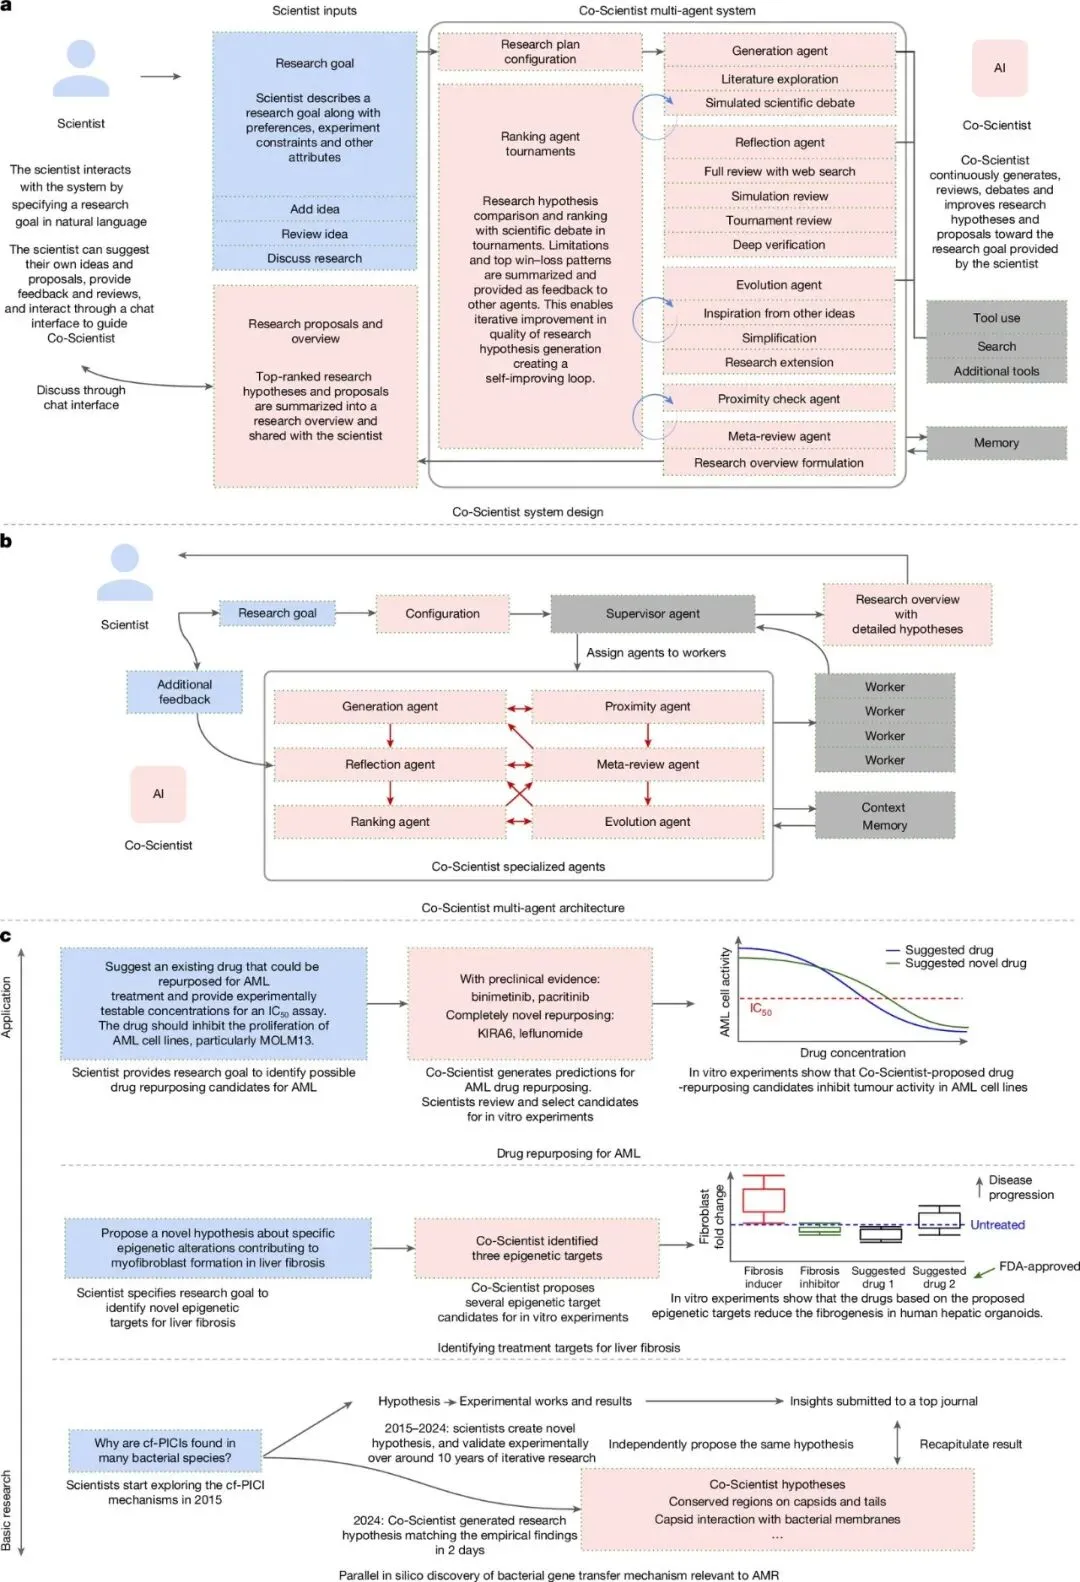
图1|图1展示研究人员输入、六类专业智能体、异步任务分配和三个生物医学验证案例。图源为Nature论文原图。
研究团队在消融分析中分别移除部分智能体或工具,以检查它们对假设质量的影响。检索工具帮助评审智能体识别表面新颖但缺乏依据的提案;辩论提示改善排序并减少位置偏差;演化智能体的修订提高候选质量。补充材料给出了智能体逻辑的伪代码和提示词,论文Methods说明元评审的反馈被附加到下一轮智能体提示词。这个机制没有在运行中对Gemini 2.0执行反向传播、微调或强化学习。系统的迭代改进发生于候选假设、评审意见和计算资源分配层面。
论文的体外研究由专家共同确定实验方向。药物的体内有效性、药代动力学与临床受益仍不由这些细胞和类器官结果决定。Co-Scientist在本文中展示的是科研假设生成流程与选定问题的初步实验核验。
论文原文
论文原文|Nature,2026年5月19日在线发表。DOI:10.1038/s41586-026-10644-y。