ARTICLE · 1151146
AI 一夜交了 372 份数学答卷,里面藏着几枚菲尔兹奖?
2026-10-08
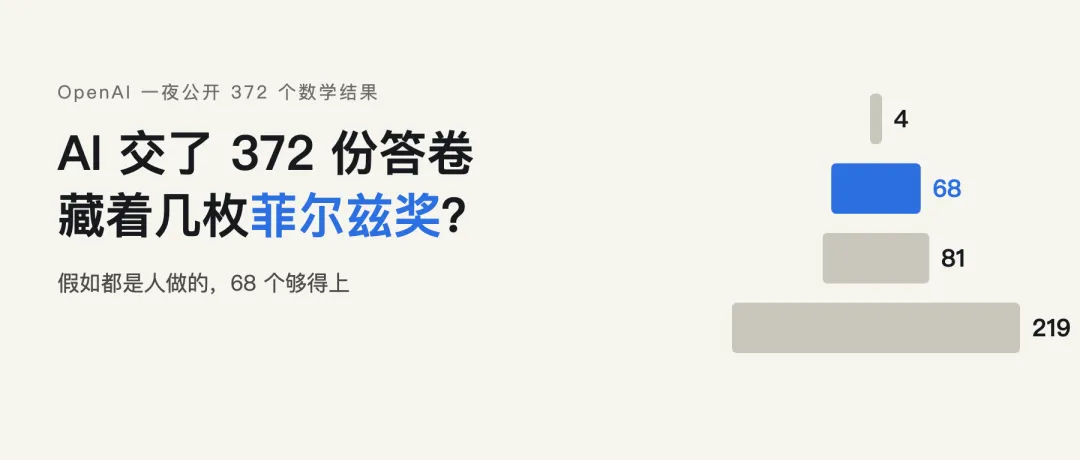
菲尔兹奖从 1936 年颁到现在,一共也就六十多枚。每四年一次,一次最多四个人,还得不满 40 岁。
10 月 6 日晚上,OpenAI 把一个还没公开的 AI 写的数学论文,一口气传到了网上。700 多篇,归成 372 个结果。
有位博主做了个很有意思的思想实验:假设这些结果全部是对的,而且是人做的,每一个够拿什么奖?
他数出来,够得上菲尔兹奖分量的,有 68 个。
跟菲尔兹奖九十年来颁出去的总数,差不多一样多。
当然,这个「假设全部是对的」是个很大的假设,后面会说。但先感受一下这个量级:人类最聪明的一群头脑花了九十年才放进奖杯里的事,一个 AI 可能在几周里做了一遍。平均每个结果,大概只想了三个小时。
如果这些都是人做的
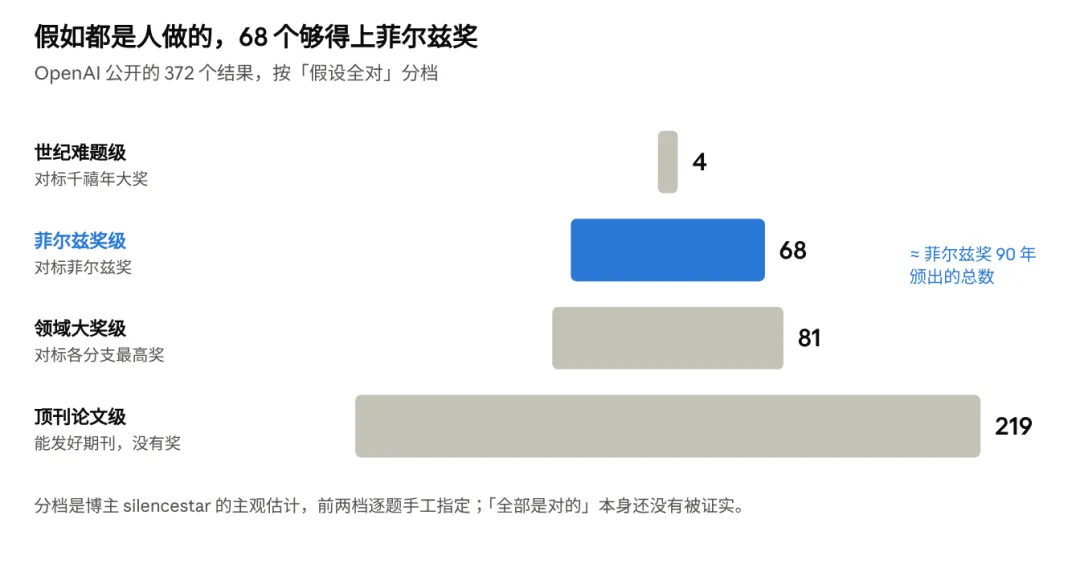
分档:blog.silencestar.com,据 openai/math 仓库 2026 年 10 月 7 日内容
金字塔最顶上那 4 个,是和千禧年大奖那七道题沾边的。最底下 219 个,放在人类数学家身上,也是能发好期刊、拿教职的水平。
中间那档最吓人。68 个菲尔兹奖级别的结果,意思是:这些如果由一个年轻人独立做出来,这个人大概率会被提名。送到奖托盘上的不是一个,是一整届一整届的。
最厉害的三个,说人话版
数学论文标题几乎没人看得懂。但这批里有三个,其实可以讲给初中生听。
一、祖冲之的密率,是不是「太好了」
小学就学过,π 约等于 22/7。祖冲之更厉害,给出了密率 355/113,小数点后六位都对。分母才三位数,就准到百万分之一,这好得有点不正常。
数学家一直想知道:π 是不是一个特别「好逼近」的数?会不会有无穷多个像 355/113 这样好得离谱的分数?
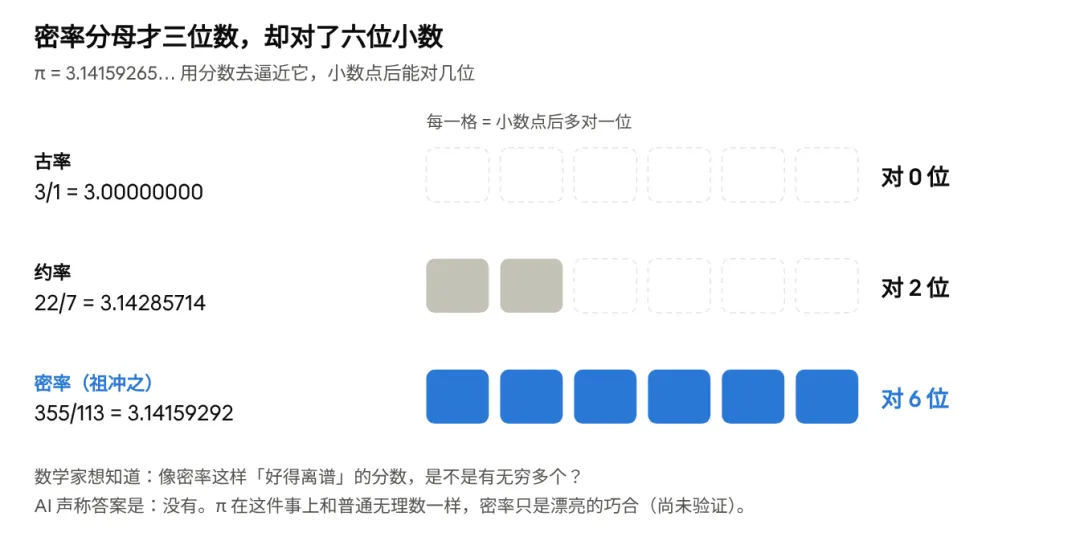
π 的三个经典分数近似
衡量这件事的数叫「无理性指数」。一个「普通」的无理数,这个数是 2。对 π,人类最好的结果是「不超过约 7.1」,也就是说我们一直没法排除 π 藏着什么奇怪的规律。
OpenAI 的 017 号结果说:就是 2。π 在这件事上完全普通,355/113 只是一次漂亮的巧合。
一个缠着祖冲之密率的老问题,答案可能是一个 AI 给的。不过这一个还没有经过机器验证。
二、一条长街,右边八分之一是空的
素数(2、3、5、7、11……)看起来乱七八糟。但数学家发现,素数「乱」得有多厉害,由一个叫 ζ 函数的东西的「零点」决定。
你可以把这些零点想象成散落在一条无限长的大街上。早就知道它们都在这条街里,不会跑到街外面去。1859 年,黎曼猜:它们全部站在大街正中间那条线上。这就是黎曼猜想,千禧年大奖的七道题之一,悬赏 100 万美元。
这个猜想太难了。难到什么程度?退一万步,不问中线,只问「右边靠路边 1% 的车道里,整条都是空的吗」,人类一百多年都证不出来。我们只能证明紧贴路边、越往远处越窄的一条缝里没有人。
OpenAI 的 003 号结果说:右边八分之一的车道,整条都是空的。而且这一个过了机器验证。
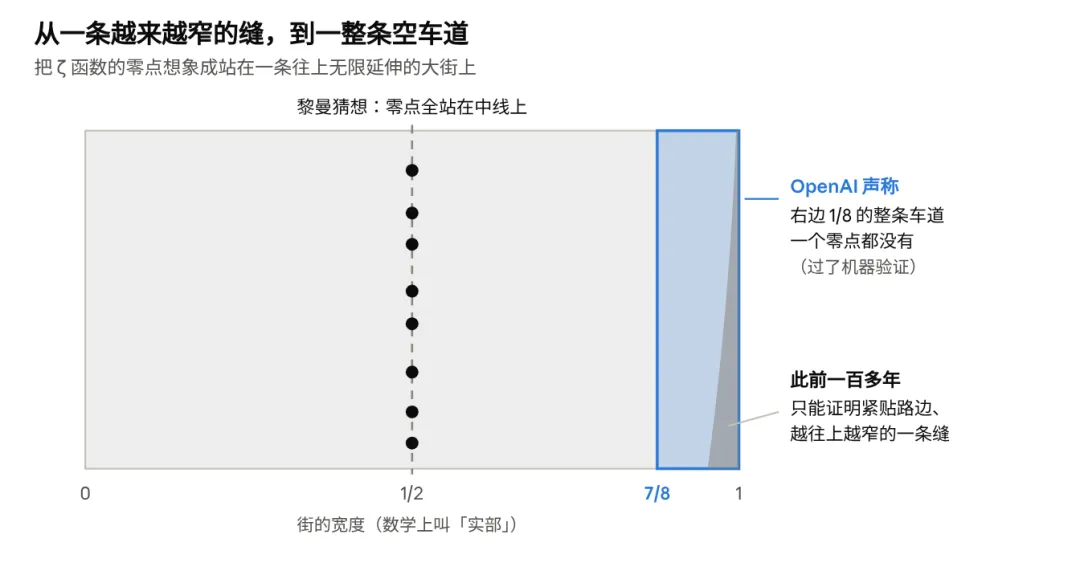
示意图,不按比例;中线上的黑点只是示意
离「全部站在中线上」还很远,所以它被叫作「准黎曼猜想」。但从一条缝到八分之一条街,是一百多年来第一次。
三、ab = 1,那 ba 呢?
小学生都知道,如果 a × b = 1,那 b × a 也等于 1。交换一下顺序而已。
但数学家会发明各种「乘法不能随便交换」的奇怪世界。上世纪中叶,数学家 Kaplansky 问:在某一类这样的世界里,ab = 1 是不是一定推出 ba = 1?半个多世纪里,大家证明了很多「是」的情形,却始终说不清全部。
AI 给出了一个「不是」的例子,一只黑天鹅。
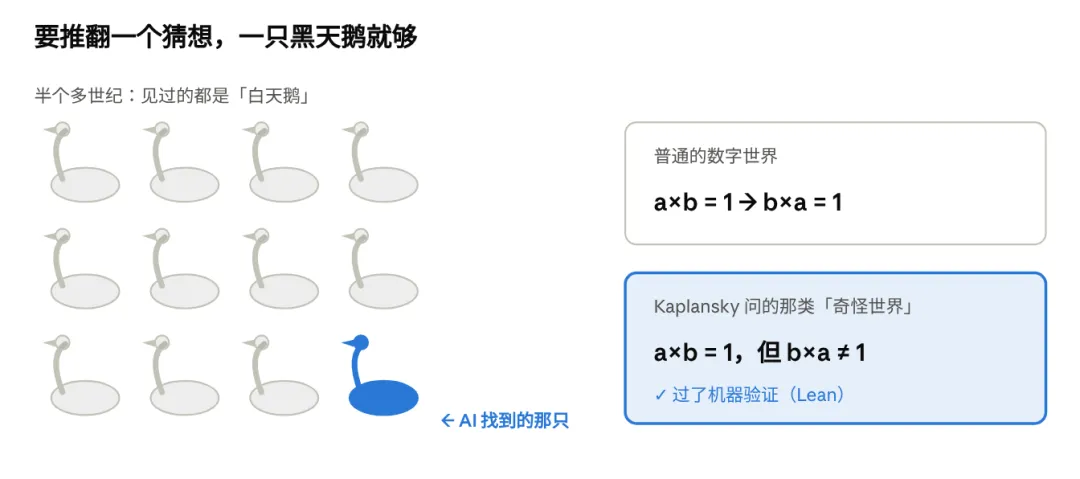
示意图:蓝色那只就是「黑天鹅」
这是整批里最可信的一类。要证明「所有天鹅都是白的」,你得看遍天下的天鹅;要推翻它,只要拎出一只黑的,谁都能亲眼看。这只黑天鹅还过了机器验证。同一批里,AI 还推翻了 Kaplansky 的另一个猜想。上一次有人推翻这一系列里的猜想,是 2021 年,在数学界上了新闻。
但一分奖金也领不到
那位博主顺手算了笔账:按奖金面值加起来,这批结果值大约 500 万美元;如果把菲尔兹级的换成奖金 300 万美元的「科学突破奖」,是 2 亿多美元。
实际能领到的:几乎是 0。
原因很简单。这些奖只发给人;千禧年大奖只认原题,而且要求正式发表后再等两年、学界公认才发;那个「准黎曼」是「准」,不是黎曼本人。
但重要的不是钱,是最后那一条:学界公认。 这一步,一个都还没走完。
这里要说一下前面反复提到的「机器验证」。它用的是一个叫 Lean 的软件,你可以把它想象成一个极其轴的阅卷老师:证明里任何一步跳步、任何一句「显然」,它都不认,全部要写清楚才给分。
但这个老师只管「解题过程对不对」,不管「题目抄对了没有」。如果交上去的题目和论文里说的不是同一道,它也看不出来。而且这批结果里,只有大约四成交给了这位老师,剩下的只是 AI 用文字写的证明。OpenAI 自己在说明里也写了:没做机器验证的,可能有问题。
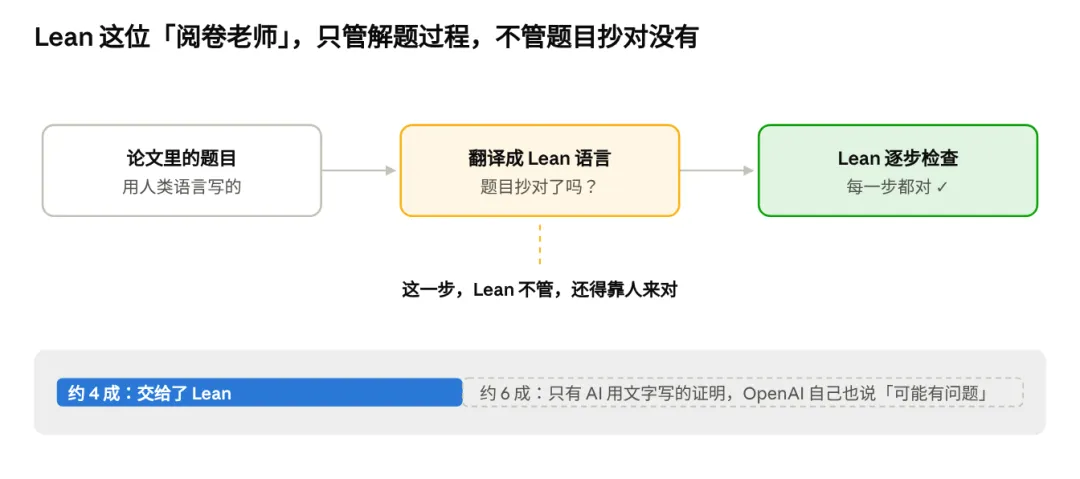
示意图;覆盖比例据 openai/math 仓库 README(约 42% 主结果有 Lean 证明)
有个前车之鉴。九月 OpenAI 宣布在纳维-斯托克斯方程上取得突破,这也是千禧年七题之一,当时用了约 1 万个 AI 智能体、跑了 88 小时。一个月过去,千禧年奖的主办方至今仍把这道题标为「未解决」。仔细看,AI 证明的其实是一个改过条件的版本。
还有个小细节:发布当天各家报道都写 722 篇,我两天后再去看,仓库里写的是 719 篇。少了哪三篇、为什么少,没有说。
最顶尖的数学家,反而不太高兴
你可能以为数学家会开香槟。实际上,九月份 25 位菲尔兹奖得主联名发了一份声明,标题叫《AI 在数学中的严重错位》。陶哲轩也在里面。
他们不是怕被 AI 抢饭碗。陶哲轩打过一个比方,大意是:好的数学问题就像矿,现在挖矿的速度,已经超过了找新矿的速度。
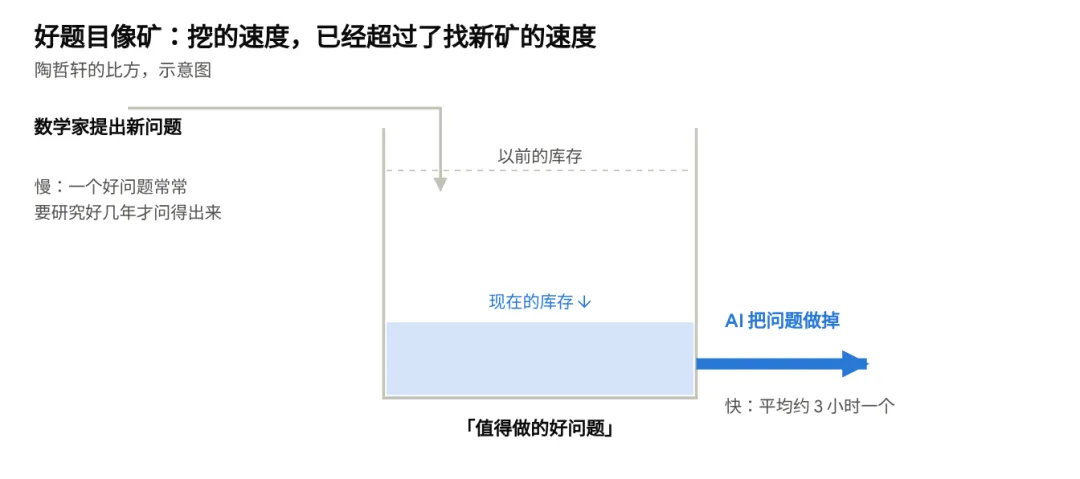
示意图,按陶哲轩的比方绘制
这会带来很具体的麻烦。以前一个博士生,导师会给他一道「不太难也不太简单」的题,他磨三年,在磨的过程里成为数学家。现在这种题可能被 AI 三个小时做掉了。陶哲轩还说,哪怕只是传出「有人在做某个问题」的风声,都可能引来一大波 AI 把它碾平。结果是有人开始不敢公开自己在做什么。
更深一层的担心是:解题从来不是数学的目的。一个难题被攻克,真正值钱的是攻克过程中长出来的新思想、新工具,以及一代人对这个领域的理解。AI 直接给出答案,就像一本推理小说只给你看了最后一页:你知道凶手是谁,但不知道是怎么推出来的。报道里提到,连 OpenAI 自己的数学家,都还没看懂其中很多结果。
AI 直接给出答案,就像一本推理小说只给你看了最后一页。
当然也有乐观派。多伦多大学的 Daniel Litt 说这对数学是好事,人写的论文本来也很难读,从里面提炼理解,一直就是数学家的活。
两派其实都同意一件事:数学的「游戏规则」要变了。陶哲轩的说法是,靠攻克难题推动学科的「数学 1.0」时代结束了。接下来值得奖励的,可能是谁把答案讲明白、谁问出了新的好问题。
这和你有什么关系
你可能会想:我又不做数学,π 的指数是 2 还是 7,跟我有什么关系?
关系在于:数学只是第一个。
AI 公司拿数学开刀,是因为数学是最好判卷的科目。对就是对,错就是错,还有 Lean 这种不讲情面的阅卷老师。一个 AI 能不能连续想几个小时不跑偏、自己发现错误、自己改,在数学上看得最清楚。
看看速度。五月,OpenAI 的模型推翻了一个 80 年的猜想,只是一道题;九月,攻一道题要上万个 AI、花几百万美元;十月,变成了同一套流程批量生产,每个结果大概是 ChatGPT Pro(就是每月 200 美元那档)想三个小时的量。五个月。
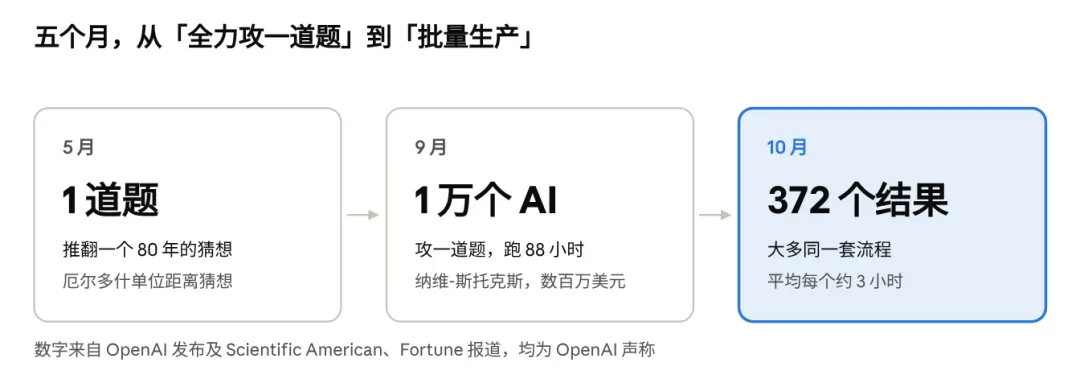
OpenAI 在数学上的三次发布
排在数学后面的,是写代码。我自己天天用 AI 写代码,已经明显感觉到同样的变化:写代码本身不再是最花时间的部分,看懂它、验证它、决定要不要用,才是。
再往后呢?Keras 的作者 Chollet 问了一个谁也答不上的问题:在有标准答案的领域变强,能不能推广到写合同、做商业决策这些没有标准答案的事上?
我的猜测是:你工作里「有标准答案、答案容易检查」的那部分,会最先被改变;「决定做什么、判断值不值、把事情讲明白」的那部分,会变得更值钱。数学家们现在吵的,其实就是这件事。
最后留个问题:一个没有人看得懂、但机器说它对的证明,你觉得算不算数?
来源
奖项分档与奖金估算:silencestar 博客,据 openai/math 仓库 2026 年 10 月 7 日内容,分档为作者主观估计 openai/math 仓库 README(2026 年 10 月 8 日查看:719 篇、372 个结果家族、约 4000 道题、约 42% 主结果有 Lean 验证) cellcog.ai、kingy.ai:逐条结果与验证状态 Scientific American,OpenAI unleashes hundreds more math results upon a field already in shock Fortune,OpenAI publishes solutions to more than 370 outstanding math challenges 25 位菲尔兹奖得主,A Severe Misalignment of AI in Mathematics;Decrypt,陶哲轩谈好题目被用光