ARTICLE · 1156073
我是怎么把 PDF 变成微信读书 EPUB 的
墨池有雨
读完需要
10
分钟
速读 4 分钟
我是怎么把 PDF 变成微信读书 EPUB 的
01缘起
我个人的体系构建有书籍、文档、音频、视频等几种素材类型
对于书籍,我习惯把下载的 EPUB 格式电子书导入到微信读书阅读、划线和做笔记
这种格式兼容和体验最好
但是有个问题,
有些书只能找到 PDF 格式的资源,直接导入就不是很适合阅读和划线
于是乎,我找到了一个 PDF 处理的 Skill。
它的原版项目是 pdf2weread,作者是 Shellylh123。后来,我在实际使用原版项目的基础上,针对自己的阅读习惯和微信读书 EPUB 的导入需求,整理出了现在这个改良版本。
这里先把原版项目地址附上:
https://github.com/Shellylh123/pdf2weread
本项目在原版项目基础上,针对 PDF 转 EPUB、目录导航、OCR 清理和微信读书阅读体验做进一步改良。
02原版 pdf2weread 怎么工作
原版的核心思路,其实很清楚。
它自己不负责训练一个新的 OCR 模型,而是在 MinerU 文档解析能力之上,封装了一层方便 AI Agent 调用的工具。用户把 PDF、Word、PPT、Excel 或图片交给 Skill,Skill 调用 MinerU 的解析接口,再把返回的 Markdown、图片和结构化结果保存到本地,或者继续发送到其他知识管理工具。
MinerU 是什么MinerU 是 OpenDataLab 开源的文档解析工具,也提供在线解析服务和官方命令行工具。
普通的 PDF 转文字工具,往往只负责把页面上的字符拿出来。MinerU 更像一个文档结构解析器,它会尝试判断页面上的内容分别是什么。 - 标题、正文和段落 - 多栏排版和阅读顺序 - 图片和图片说明 - 表格及单元格结构 - 数学公式 - 扫描页面中的文字 - Markdown、HTML、JSON 等结构化输出
这也是它适合放在这套流程前面的原因。MinerU 负责理解原始页面,Skill 负责把结果清理成适合阅读的 Markdown,再打包成 EPUB。 官方项目和文档可以从这里查看: - MinerU 官网,https://mineru.net/ - MinerU 项目主页,https://github.com/opendatalab/MinerU - MinerU 官方文档,https://opendatalab.github.io/MinerU/ - MinerU Open API CLI 中文说明,https://github.com/opendatalab/MinerU-Ecosystem/blob/main/cli/mineru-open-api/README.zh-CN.md 如果你只是想快速试一下,官方 CLI 还有不需要 Token 的 flash-extract模式。需要更完整的解析、批量处理、网页解析或更高的处理能力时,再申请 Token 使用extract。
原版 pdf2weread 的大致流程是这样:
输入 PDF、Office 或图片
↓
pdf2weread 接收文件
↓
选择 MinerU 的解析接口
↓
MinerU 完成 OCR、版面、表格和公式识别
↓
返回 Markdown、图片和解析结果
↓
保存到本地,或交给其他工具继续处理
解决的是「把文档解析出来」这件事。
它可以识别标题、正文、图片、表格和数学公式,也可以处理扫描版 PDF。解析结果一般是一个 Markdown 文件,加上一个保存图片的 images 文件夹。对于知识库、AI 检索、Obsidian 或 Notion 这类用途,这套输出已经很有价值。
原版也支持批量处理和断点续传。文件比较小的时候,可以使用不需要 Token 的快速接口。文件比较大,或者需要更完整的解析和导出能力时,再使用需要 Token 的接口。
原版项目解决了从 PDF 到结构化 Markdown 的关键一步,这也是我后来继续往下做的基础。
03我在实际使用中遇到的问题
但当我真的拿几本书去处理,问题就开始出现了。
有的 PDF 能复制文字,但复制出来的中文重复、缺字,甚至出现看起来像部首的字符。有的 PDF 完全是扫描图片,只能 OCR。有些表格看起来像表格,转出来却是一串错位的文字。还有公式,OCR 识别成一堆符号,放进 EPUB 之后基本没法读。
原版输出 Markdown,并不等于它已经适合直接导入微信读书。Markdown 里面可能有重复页眉、页码、乱码标题,原书目录也可能被混进正文。图片和图片说明有时会分离,复杂表格会被当成普通文字,公式即使识别出来,也未必适合在手机阅读器里展示。
我处理《微观原生英语习得法》时,PDF 其实有可用文字层,但部分中文字体编码有问题。如果直接 OCR,反而会损失原有结构。处理《大唐西域记校注》时,PDF 是一千多页的纯扫描文件,页级 OCR、页眉页码清理和低文本量页截图回退就更合适。处理《NLP 模仿卓越的艺术》时,乱码标题、复杂图表和公式截图又是另一套问题。
在原版 pdf2weread 的思路和 MinerU 解析结果的基础上,经过调整和尝试,我做了一个更适合自己处理书籍的改良版本。
04pdf2weread 的改良版
我的版本重点解决三件事。
•先判断 PDF 来源,避免对本来有文字层的 PDF 重复 OCR
•把 OCR 结果整理成有目录、有段落、有图片位置的中间 Markdown
•把不可靠的表格和公式替换成原 PDF 截图,同时对 EPUB 做结构 QA
仓库地址:https://gitee.com/HarZor/pdf-to-epub
在此感谢原作者 Shellylh123 的开源工作,也感谢 MinerU 项目提供文档解析能力。原版项目的许可证、版权声明和使用限制,请以原仓库中的 LICENSE 和官方说明为准。
05改良版具体解决什么问题
目标:把一本经过授权的 PDF 资料,整理成适合微信读书阅读的 EPUB。
处理完成后,正文可以连续阅读和划线,原书目录可以进入微信读书的侧边目录,图片和表格尽量保持在原来的位置,复杂公式和表格在 OCR 不可靠时可以退回原 PDF 页面截图。
它不会一上来就把所有 PDF 都扔给 OCR,而是先做一次来源检查。
如果 PDF 本身有比较好的文字层,就优先提取文字,避免再次 OCR 把内容变得更差。
如果是坐标型页级 OCR,就根据每行文字的位置重新组织段落。
如果是纯扫描 PDF,再调用 MinerU 解析。
这个判断很重要。
我处理《微观原生英语习得法》时,PDF 其实有可用文字层,但部分中文字体编码有问题。如果直接 OCR,反而会损失原有结构。处理《大唐西域记校注》时,PDF 是一千多页的纯扫描文件,页级 OCR、页眉页码清理和低文本页截图回退就更合适。处理《NLP 模仿卓越的艺术》时,乱码标题、复杂图表和公式截图又是另一套问题。
这些经验最后被抽成了通用规则,写进了 skill 规范里。
06具体使用
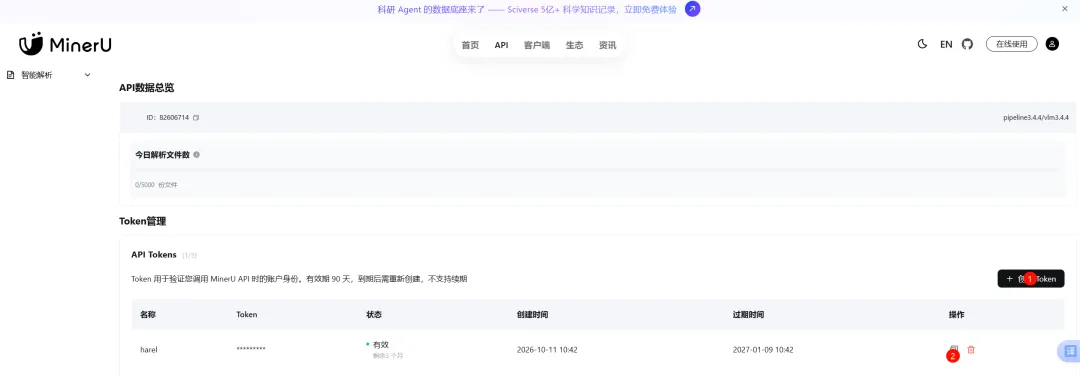
获取 MinerU API Token
先打开官方 Token 管理页面:
https://mineru.net/apiManage/token
登录或注册账号后,按照页面提示创建 Token,然后复制保存。
安装 skill 包
不需要自己复制文件,也不需要手动执行一长串命令。
把分享包,或者里面的 pdf2weread 文件夹,直接发给 WorkBuddy、Codex 等 Agent,再把你刚获取的 MinerU Token 一起通过私聊或安全输入框发给它,然后告诉它安装并调用这个 Skill。
可以直接复制下面这段话:
请安装并调用我发给你的 pdf2weread skill。
MinerU Token 是:<你的 MinerU Token>
请用这个 Token 配置 MINERU_API_TOKEN,然后处理我发给你的 PDF。
请自动完成 PDF 来源判断、MinerU 解析、OCR 清理、表格和公式截图回退、EPUB 打包与 QA。
处理完成后,把 EPUB 文件和 QA 报告返回给我。
这里的 <你的 MinerU Token> 替换成真实 Token,Agent 会负责安装 Skill、配置环境变量、选择处理流程并调用脚本,你只需要把 PDF 和这段指令发过去。
如果第一次处理的书比较长,可以先让 Agent 处理几十页做测试。确认目录、正文、表格和公式都正常后,再让它继续处理整本书。
后续如果发现某个表格错位,或者公式不适合阅读,直接告诉 Agent 具体页码,让它重新检查并改用原 PDF 页面截图,不需要重新从头配置。
07写在最后
如果你准备处理自己的书,可以先从一本 50 页左右的 PDF 开始,跑通来源预检、OCR、清理、打包和 QA,再处理整本长书。遇到问题时,优先查看 source-qa.json、qa_report.json 和 ocr_repair_report.json,通常比盯着最终 EPUB 猜原因快得多。
请只处理自己拥有合法处理权的 PDF 文件。
项目地址:
https://gitee.com/HarZor/pdf-to-epub
作者:墨池有雨