ARTICLE · 1156999
生信图表解读 | 9类经典图表怎么看,说明什么:读懂坐标、图例与科学结论
别只会认图:每类图表都要回答“怎么看、能说明什么、不能证明什么”
一篇组学论文可能同时出现PCA、热图、箱式图、火山图、功能富集图和模型评价曲线。初学者常常能看见分组颜色、显著性星号或一条漂亮的曲线,却不容易判断:这些图究竟提供了什么证据,研究者又是如何从图走向结论的?
实际上,九类图表分别服务于样本质量评估、差异分析、候选集合整理、功能解释,以及相关性或预测性能评价。它们不是每篇论文都必须依次完成的“九步流程”,更不是画得越多,证据就越强。
本期采用“一张典型图+分项讲解”的方式,带你看清每种图的坐标、颜色、核心指标和常见误读;最后通过三张总结图,把这些信息连接成可复核的科学证据链。文中的点、曲线、通路名及示例数值均属于教学示意,并非任何原始研究数据。
一页看清:九种图表承担什么任务?
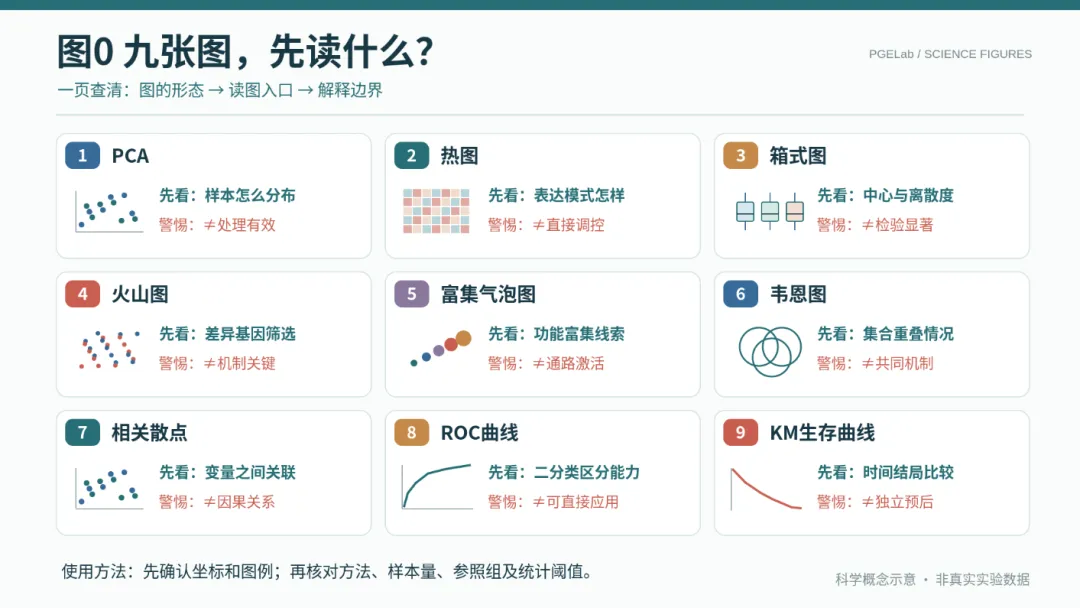
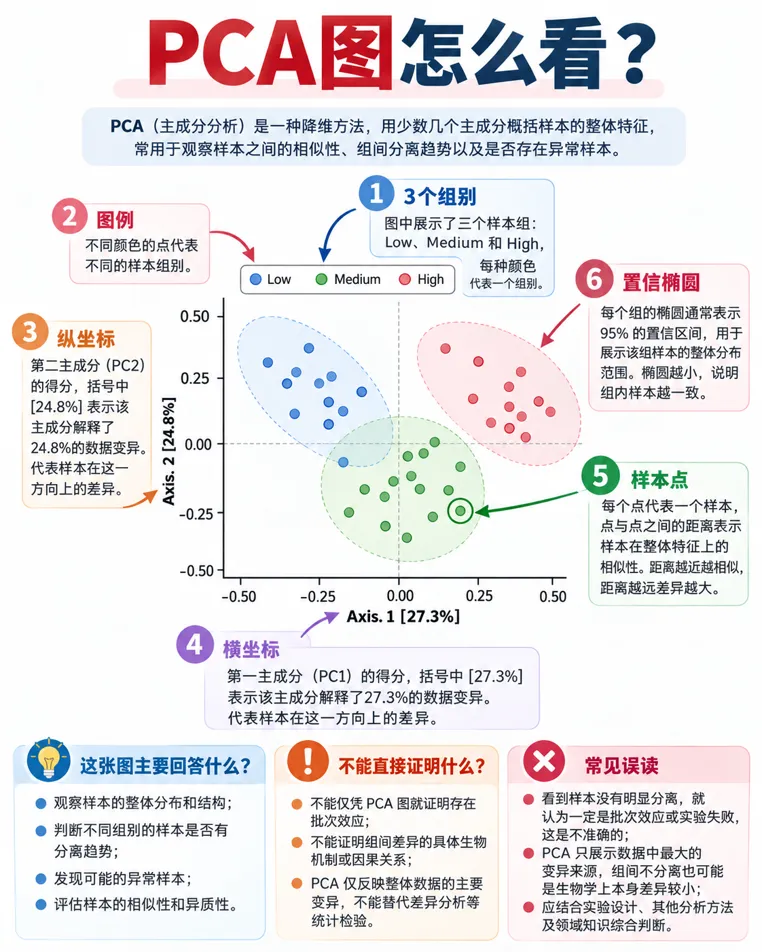
01|PCA图:看清样本是否呈现整体分离
先看图形。PCA通常是一张二维散点图。每个点代表一个样本,颜色或形状代表处理、基因型、批次等分组变量。横轴PC1和纵轴PC2是样本差异最大的前两个正交方向;轴后的百分比表示相应主成分解释的总体变异比例,而不是某组样本的“解释率”。
如何判读。先检查每个点究竟是生物学重复还是技术重复,以及PCA使用的是哪些基因、经过什么标准化或方差稳定化处理。接着比较组内离散、组间距离和是否存在离群点。若分组呈现可见分离,说明主要变异与分组有一定对应关系;若混杂,仍需检查其他主成分、重复质量与实验因素。
植物组学场景。比较水稻对照与盐胁迫处理的转录组时,PCA可以辅助查看处理组与对照组的表达结构是否存在明显差异;若品种效应远大于处理效应,样本可能首先沿品种分开。这种结果不是实验失败,而是提醒研究者重新考虑设计矩阵和变量解释。
证据边界。PCA是探索性可视化,不能证明某个差异基因显著,也不能把“未分开”直接归因于批次效应。图中的95%椭圆既可能是均值置信区域,也可能是覆盖某类数据分布的区域,必须以绘图方法为准。
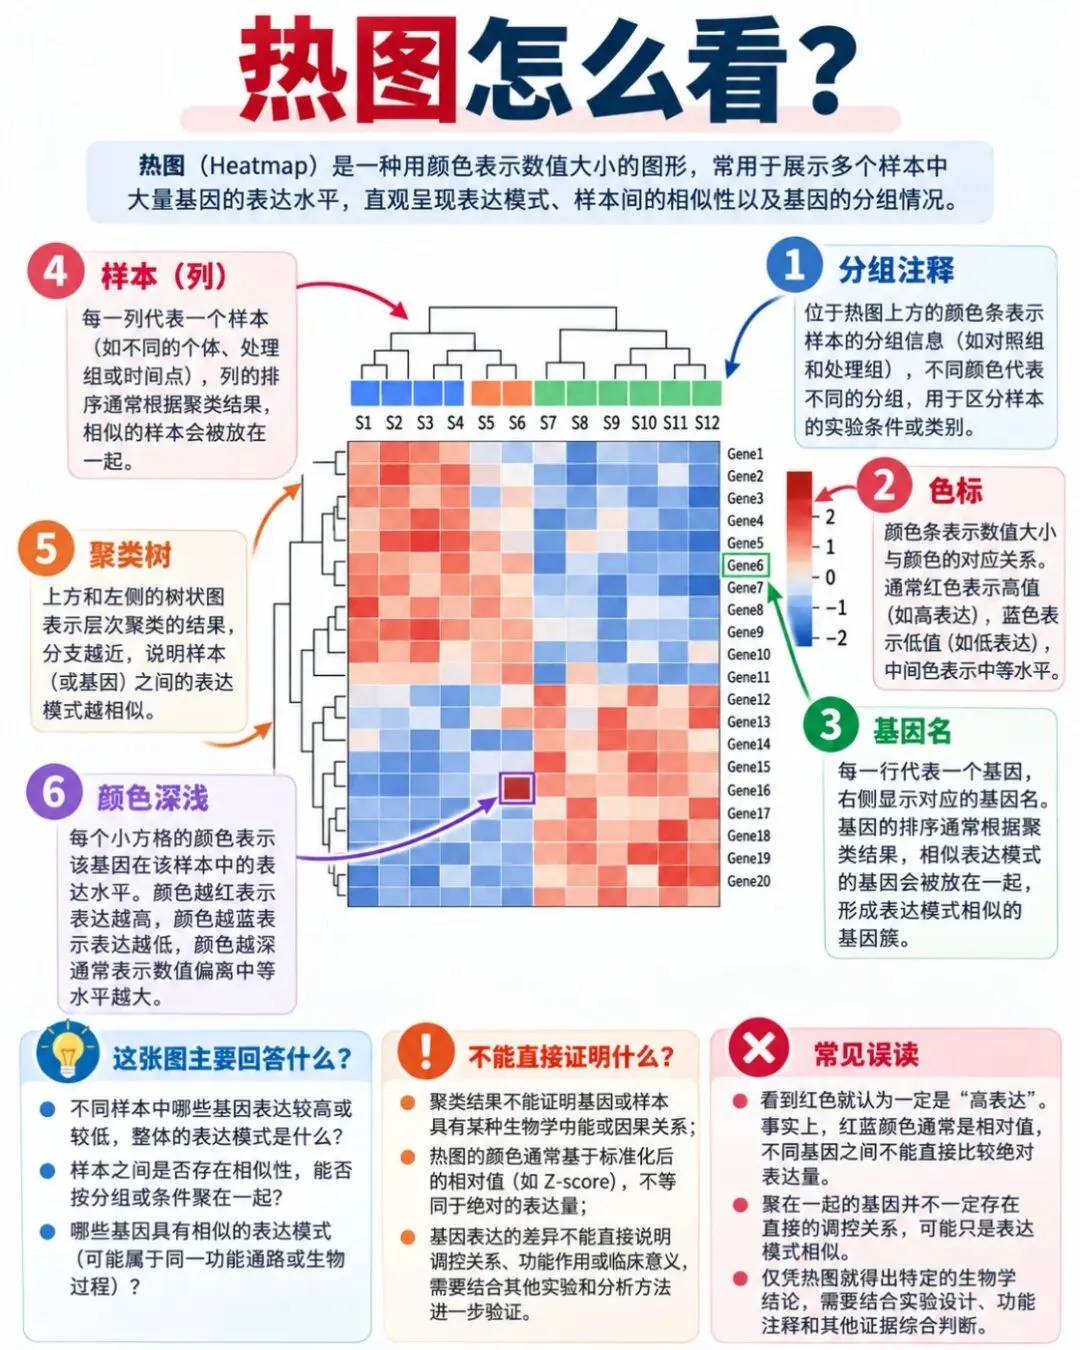
02|热图:颜色是表达水平,还是相对标准化分数
先看图形。热图由行列矩阵和色标组成:常见情形是行代表基因、列代表样本,树状图显示基于距离和聚类算法得到的层级关系。色彩编码可使用原始计数、log变换后的值、归一化表达量或逐基因Z-score;红高蓝低只是常见配色,不是所有热图的固定规则。
如何判读。应优先识别色标单位、行列对象、是否做行标准化或列标准化,然后才看处理组是否聚在一起、某些基因是否出现共同的高低变化模块。两种基因若都出现红色方格,只说明它们在所用色标上的值对应红色;若逐行Z-score,红色不能用于判断哪一个基因的绝对表达量更高。
植物组学场景。展示一组胁迫响应转录因子在根、叶以及不同时点的表达变化时,热图适合对时空模式进行比较。如果先筛选差异表达基因再绘图,聚类分离可能部分来自预先选基因的步骤,不能把漂亮的两组分离当成完全独立的验证。
证据边界。聚在同一簇代表在给定距离指标和数据预处理下较相似,不能单凭聚类树认定基因处于同一调控路径。聚类结果还会受到所选基因集、样本集、缺失值处理和尺度变换的影响。
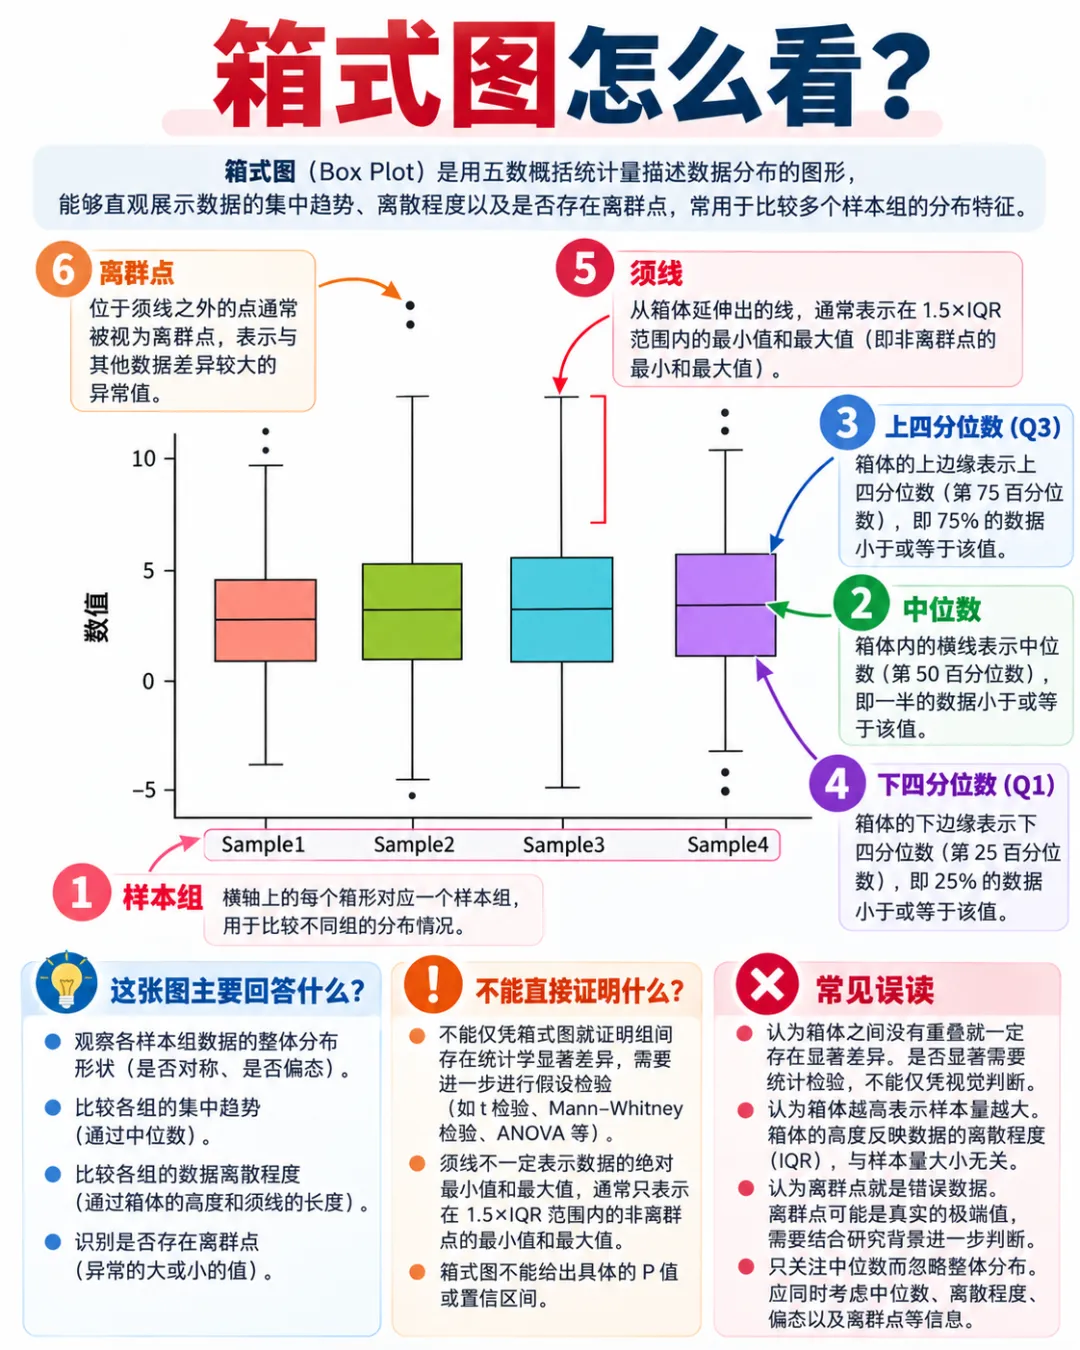
03|箱式图:用一个“箱子”读懂中心、离散和异常点
先看图形。箱体通常从下四分位数Q1延伸到上四分位数Q3,中线表示中位数,箱高为四分位距IQR。箱体越高说明中间50%的观测值越分散,但并不必然意味着样本量更大。离散小点一般表示根据绘图规则识别的潜在离群观测。
如何判读。判断四个要素:各组中位数差距、箱体高度、须线与离群值、每组实际样本量。须线的定义要看软件:常见Tukey方式延伸至1.5×IQR围栏之内的最远观测值,也可能在其他实现中使用最小至最大值。箱体重叠和分离都不是统计显著性的正式判据。
植物组学场景。同一基因在多个品种中的表达、不同处理条件下的表型值、不同批次测序样本的整体表达分布,都可以使用箱式图概括。但RNA-seq原始计数不宜在未经适当归一化时简单作跨样本直接比较。
证据边界。箱式图通常不展示所有数据分布的形状,例如多峰结构可能被压缩;样本量很小时,叠加原始散点或小提琴图更有帮助。若要写“显著增加”,还必须报告合适的检验方法、效应量与不确定性。
04|火山图:变化幅度与统计证据,必须一起读
先看图形。火山图的每个点通常对应一个基因。横轴常为log₂ Fold Change(log₂FC),纵轴常为−log₁₀(p值)或−log₁₀校正后p值。点越靠左右两端变化幅度通常越大;越靠上,所绘p值通常越小。但点色、阈值、纵轴实际用的是哪一类p值必须看图注。
如何判读。若比较定义为“处理组/对照组”,log₂FC=1表示处理组约为对照组的2倍,log₂FC=−1表示约为一半;反转分子和分母,符号也随之反转。左右阈值线常用于限定最小效应量,横向阈值线与显著性标准有关。高通量分析要重点关注多重比较调整后的FDR。
植物组学场景。在拟南芥或小麦胁迫转录组分析中,火山图可快速定位满足预设阈值的候选差异表达基因。若某基因表达变化很大但个体间方差也大,它不一定具有强统计证据;相反,样本很多时变化较小也可能获得较小p值。
证据边界。红点多不表示研究“更好”,显著差异也不意味着功能关键。不能直接从火山图推导基因调控关系、通路激活或表型因果机制;这些需要功能验证和其他证据。
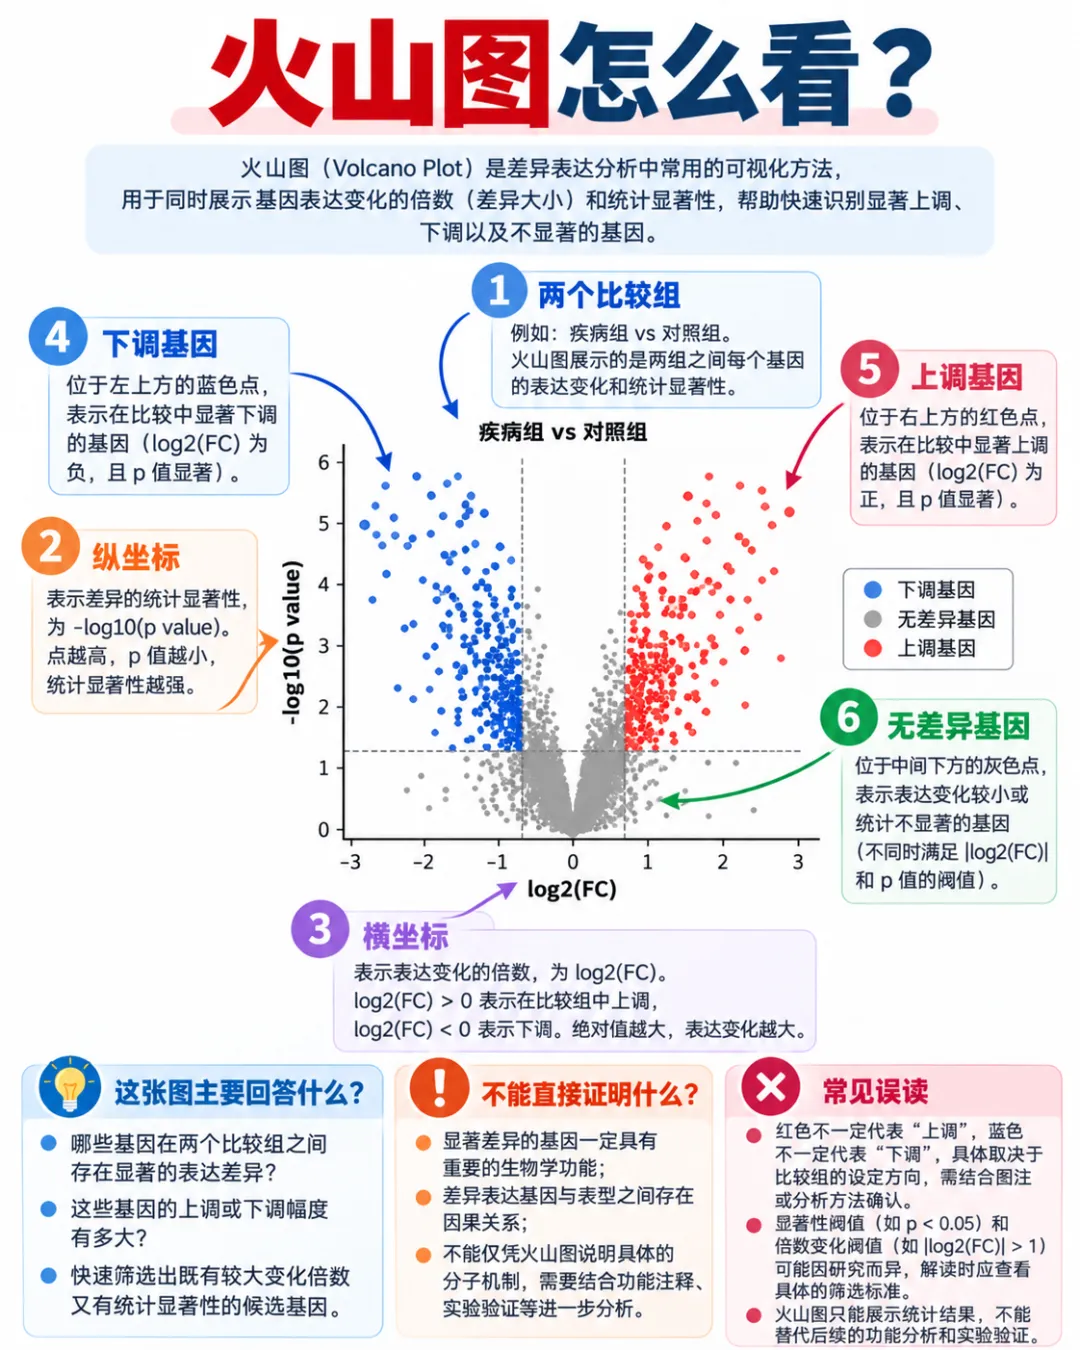
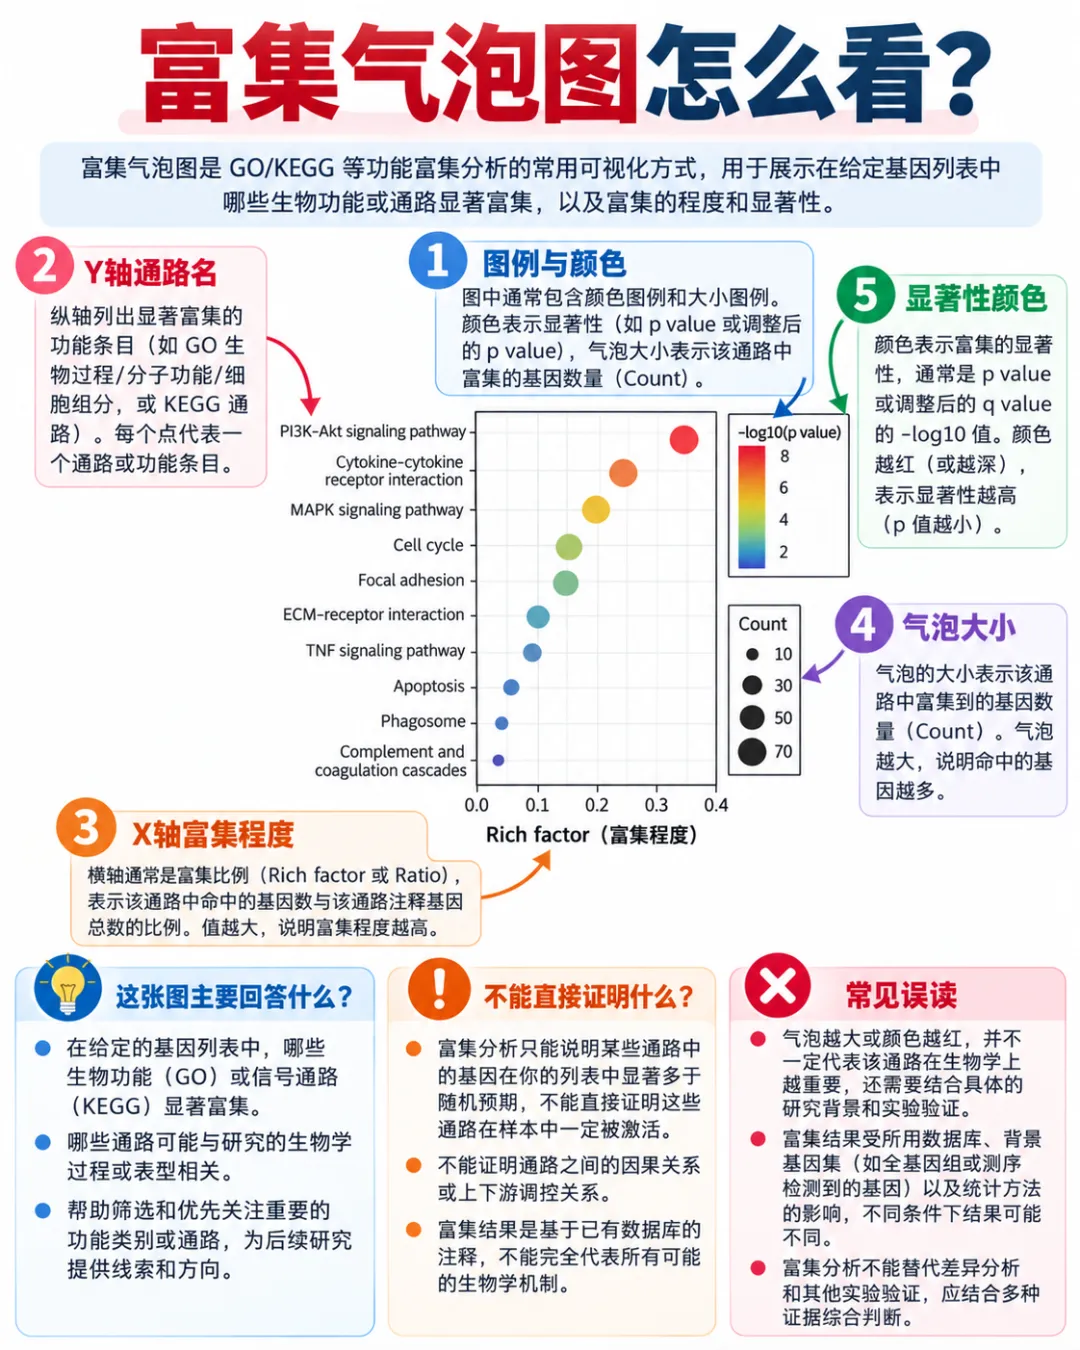
05|富集气泡图:让候选基因变成功能线索,而不是机制结论
先看图形。GO/KEGG富集气泡图的纵轴通常列功能术语或通路名称,横轴可能是GeneRatio、Rich factor或其他指标。气泡大小一般编码命中基因数(Count),颜色常编码p值、校正后p值或其负对数,颜色方向没有通用约定。读取一张气泡图最重要的是把三个图例一起看。
如何判读。先检查输入的是全部差异基因还是上调/下调各自的基因,再明确参考背景。背景应尽量是实验中有机会被检测或入选的基因集合,而不是不加区分地使用整个物种基因组。查看注释数据库版本、基因ID映射比例、富集统计方法以及FDR调整。
植物组学场景。例如植物根系胁迫研究可能观察到与细胞壁、生长素反应或离子转运有关的术语富集。此时合理的写法是“候选基因在这些功能类别中呈过度代表”,而不是“该通路已经被证实激活”。GO术语具有层级结构,不同条目之间常共享基因。
证据边界。一个大气泡可能只是命中基因数量较多;较低的FDR也不直接代表更强的因果作用。非模式作物注释不完整时,富集结果还会受到同源功能预测偏差的限制,需结合表达、遗传材料与表型进行验证。
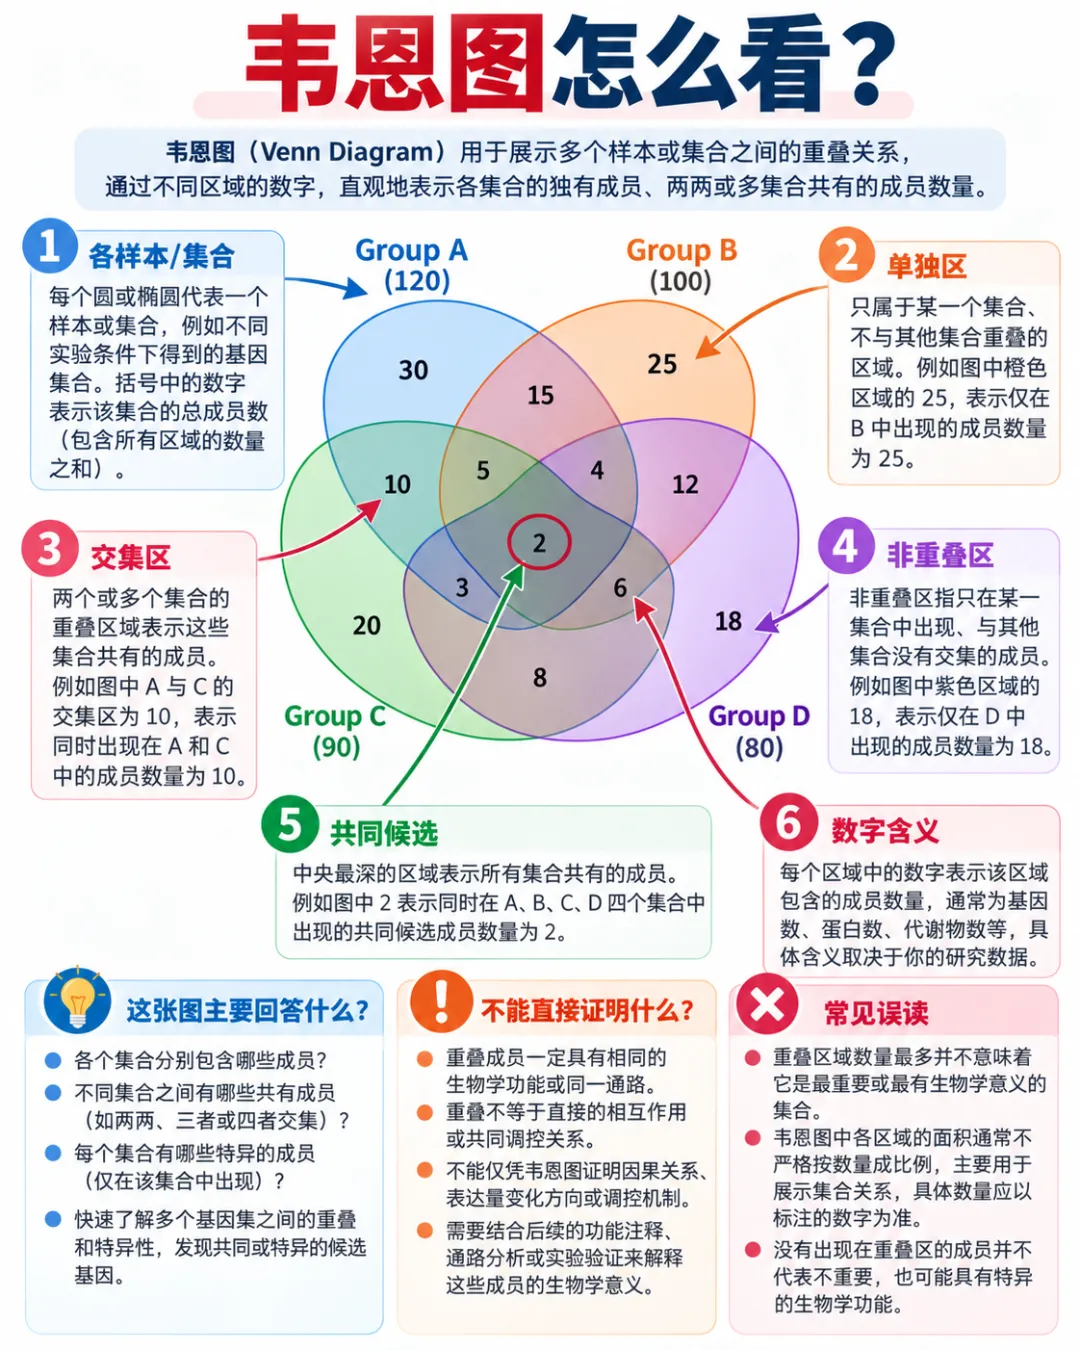
06|韦恩图:交集是什么,先确认集合定义和数字是否自洽
先看图形。韦恩图中每个闭合区域表示一个集合,重叠部分表示共有元素,独立部分表示该集合独有元素。本文使用三个基因集合的教学示意:A组50个、B组53个、C组43个成员,其中三组共同成员为5个;所有不重叠区域均经过重新计数核对。
如何判读。读图前必须确定每一组来自什么比较、基因ID是否统一、阈值是否相同。数值指的是集合成员数,而不是统计检验的显著性或表达水平。比较多个处理的差异基因时,即便一个基因同时入选,也应继续检查其在各比较中的log₂FC正负方向。
植物组学场景。例如高温、干旱和盐胁迫分别获得一批差异表达基因,三集合韦恩图有助于挑选交叉胁迫响应候选,但重叠基因未必都参与“共用胁迫调控机制”。有时不同处理的阈值设置会改变交集数量,因而需要谨慎解释“共有比例”。
证据边界。普通韦恩图并不保证各区域面积严格与成员数量成比例;集合超过三四组时,图形容易拥挤,可考虑UpSet图。共同入选 ≠ 同向变化 ≠ 共同调控,这三层含义不能混用。
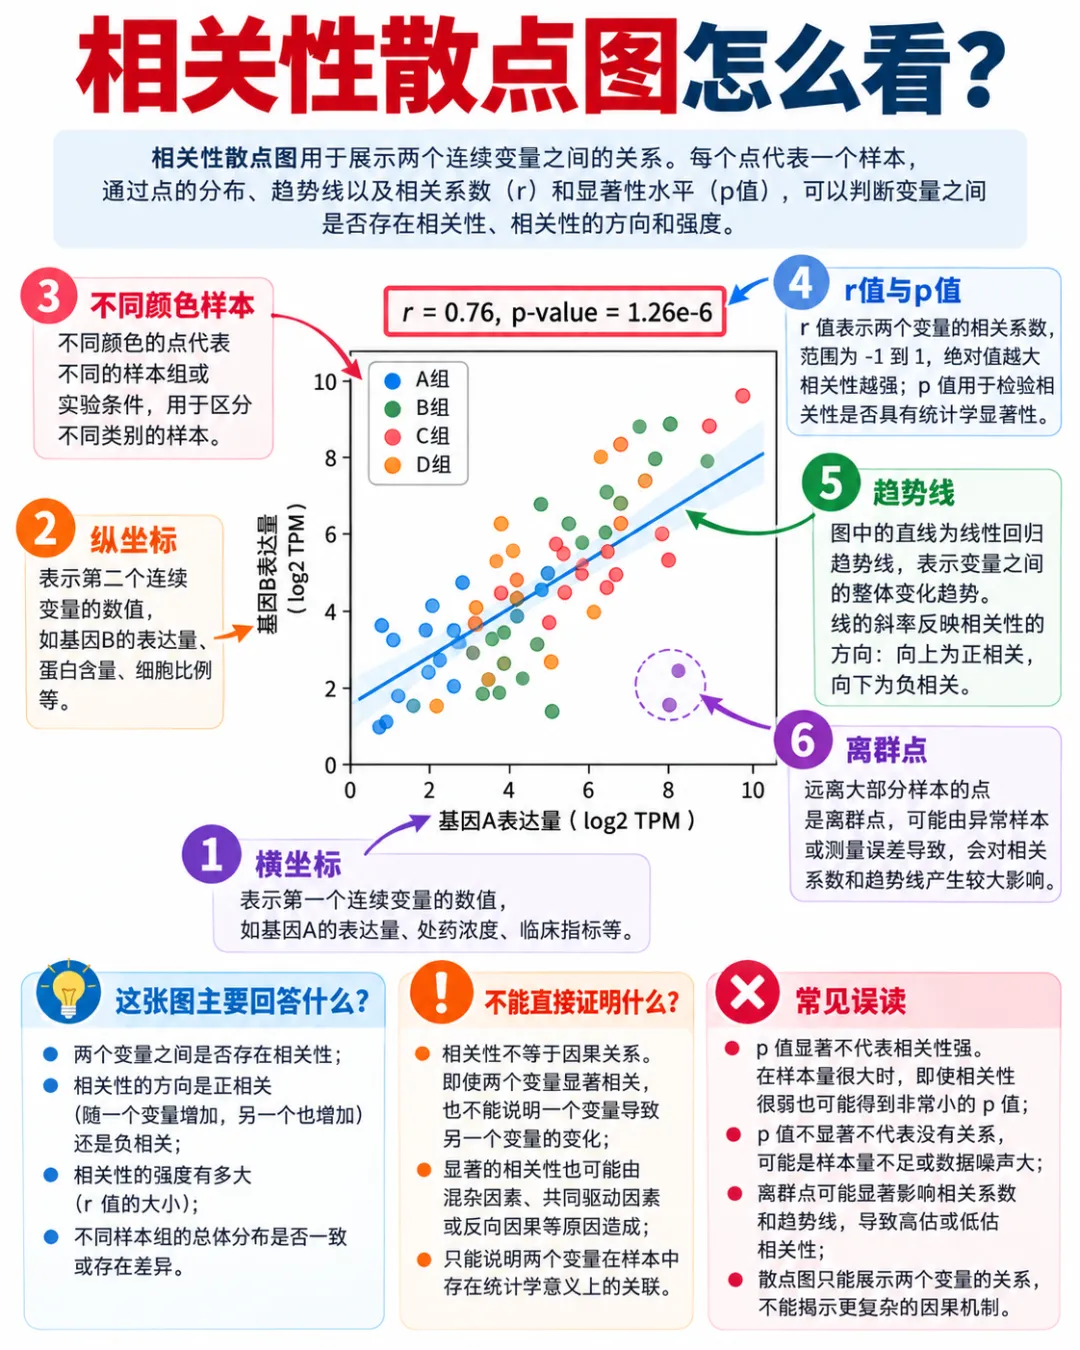
07|相关性散点图:两个指标一起变化,不等于一个调控另一个
先看图形。横纵轴通常分别是两个连续变量,一点代表一组配对观测。Pearson r适合描述线性关系,Spearman相关系数适合评价基于秩次的单调关联。图上可能附有回归线、置信带、r值与p值,但必须分清相关系数和回归斜率并不是同一个量。
如何判读。先观察点云是否具有线性趋势、有无明显离群点和分组聚集,再核对样本量、数据范围、相关方法及p值。正的r提示同向线性变化,负的r提示反向线性变化;r接近0只说明线性相关较弱,并不排除非线性关系。p值也不能单独替代效应大小。
植物组学场景。基因A和基因B在不同植物样本中的表达量可能高度相关,但这也可能由组织类型、发育时期或共同上游信号引起;若要论证直接调控,还需启动子结合、基因扰动或报告基因等适当实验。
证据边界。相关不等于因果,群体中的共同分层还可能造成伪相关。对多组混合样本,可以考虑分组后复核、加入协变量或控制潜在混杂因素。
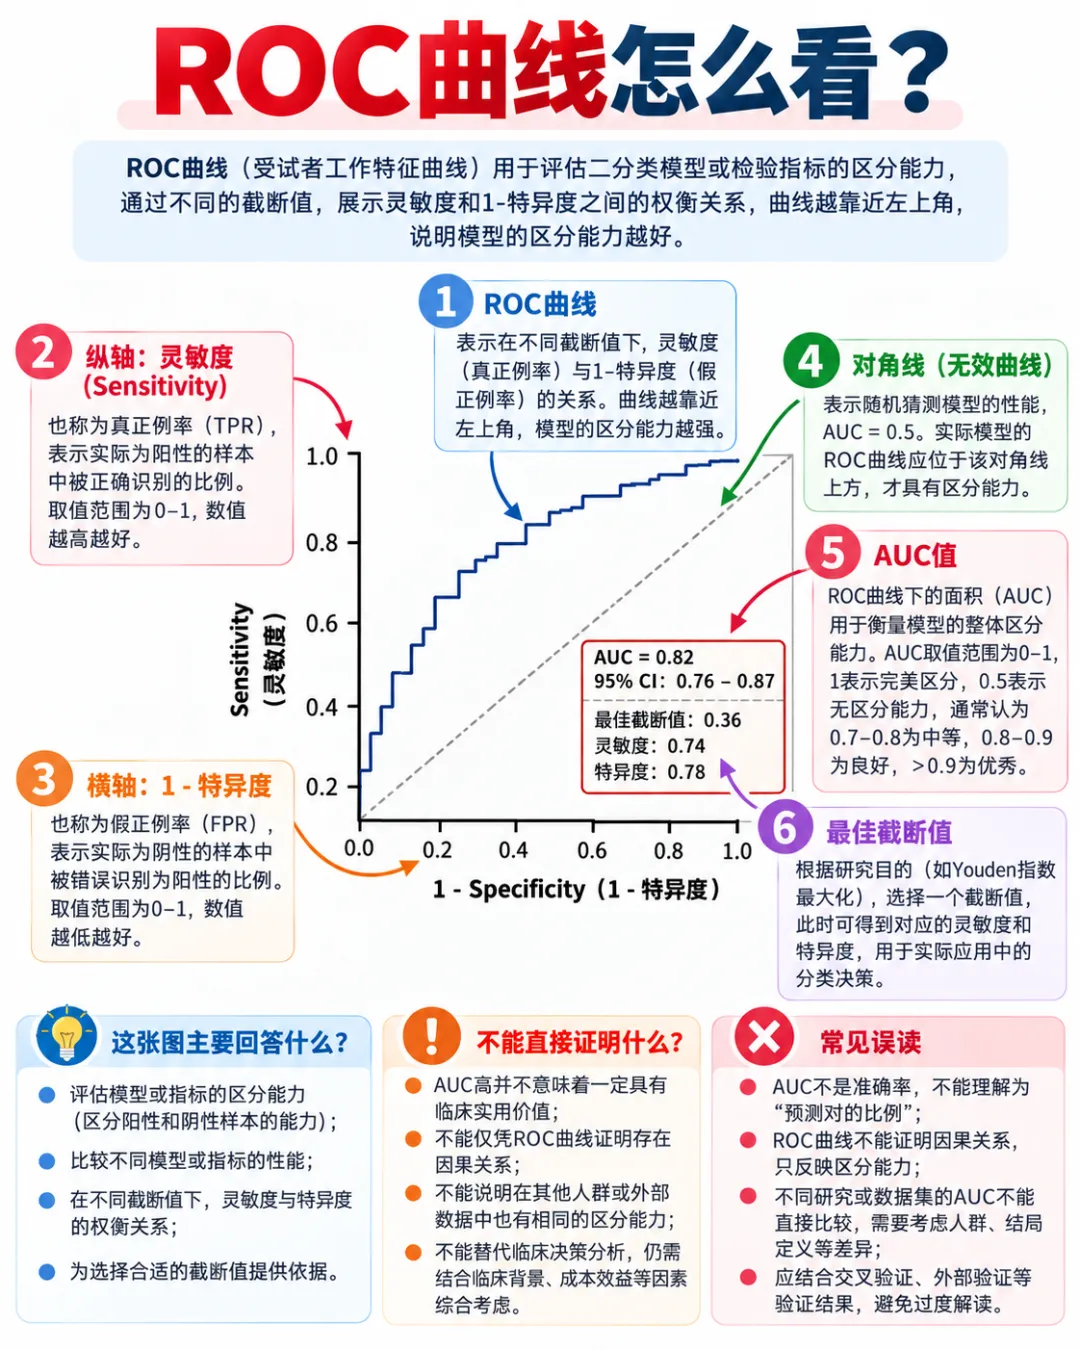
08|ROC曲线:AUC高代表什么,又还缺少什么
先看图形。ROC曲线横轴是假阳性率FPR(1−特异度),纵轴是真阳性率TPR(敏感度)。曲线对应不同判别阈值,左上角通常表示较高敏感度和较低假阳性率,45°对角线表示随机排序基线。AUC是曲线下面积,用一个数值概括模型对两类对象的区分能力。
如何判读。AUC接近1表示排序区分能力较强,接近0.5说明接近随机基线,但它不是“预测正确率”。读图还应确认正类如何定义、评估数据是否独立于训练集、是否给出置信区间及模型外部验证;若类别极不平衡,还可结合Precision–Recall曲线。
植物组学场景。例如用基因表达或基因型特征区分两种抗病表型时,训练集AUC很高并不意味着能推广到其他品种、地点或年份。需要分层抽样、独立群体验证,并考虑模型校准和误判代价。
证据边界。高AUC不直接代表实际应用价值,更不能证明某个特征具有因果作用。普通ROC也不等于随访资料的时间依赖评价,事件发生时间模型必须使用相应方法。
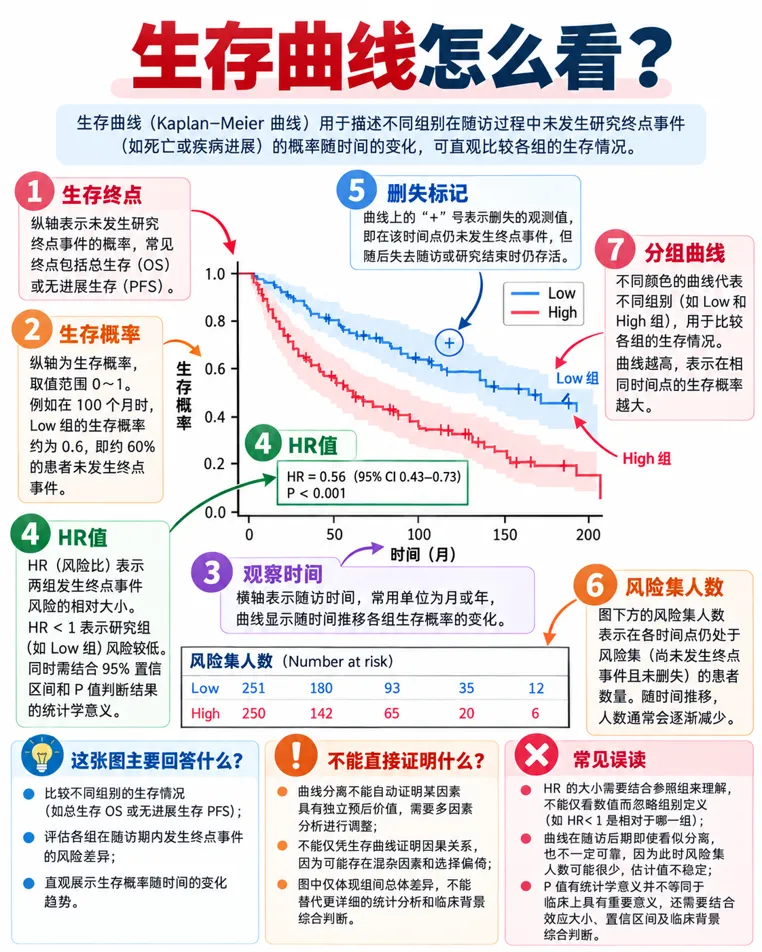
09|生存曲线:读懂时间、删失、风险集与HR
先看图形。Kaplan–Meier(KM)曲线用于估计随时间仍未发生指定事件的概率。横轴是随访或观察时间,纵轴是生存或无事件概率;阶梯下降反映事件发生,短线等标记通常表示删失。曲线下方的风险集表(number at risk)说明各时间点仍处于风险集的人数。
如何判读。先确认“事件”是什么、时间从什么时候开始、组如何划分,再观察曲线分离、删失分布、随访后期风险人数与置信区间。log-rank检验可用于比较组间生存分布;Cox模型给出的HR需要说明参照组、比较方向和比例风险假设。HR不是某时点死亡概率之比。
植物研究如何用。这一类时间至事件方法不限于临床研究:在定义清楚终点和删失机制的前提下,也可用于种子萌发时间、植物存活或某种发育事件发生时间的比较。是否适用取决于数据结构,并非所有植物性状都应画KM曲线。
证据边界。曲线分离不能自动证明因果作用或独立预测价值,随访后期样本数稀少时估计可能不稳定。生存曲线上的示例HR与p值仅用于认识图表部件,绝不代表真实研究结果。
把九类图表放回科研证据链
从九张图回到科研推理:可以把常见科研分析理解为四类不同的证据工作:①描述数据与样本:PCA、热图、箱式图;②发现变化和比较集合:火山图、韦恩图;③解释候选功能:富集气泡图;④评价关联、分类或时间结局:相关散点、ROC、KM曲线。需要强调,这只是帮助读者定位图表用途的概念地图,具体研究不必也不应机械照这个顺序出图。
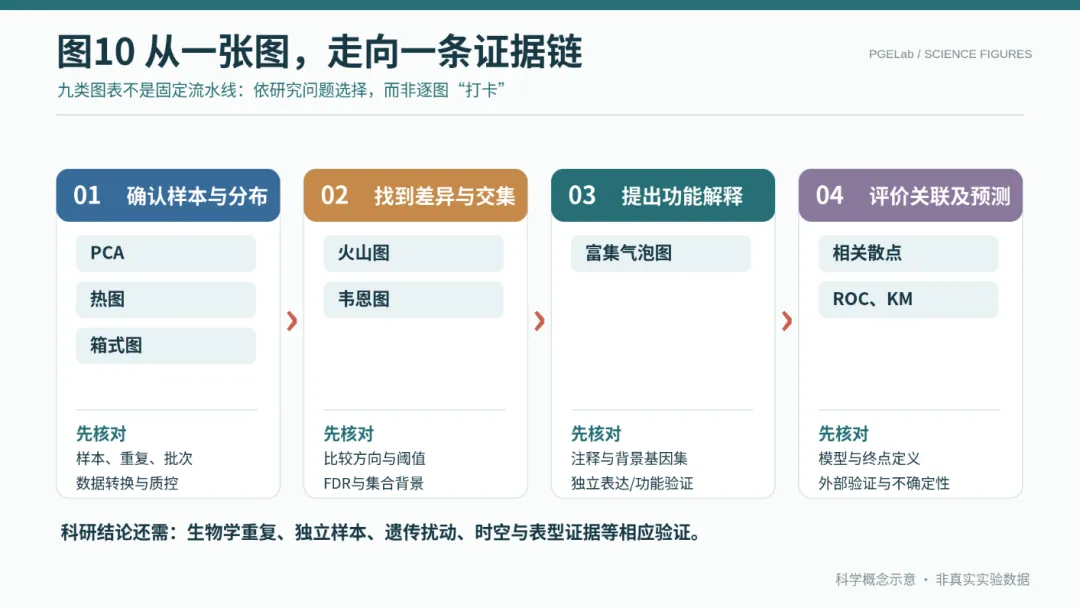
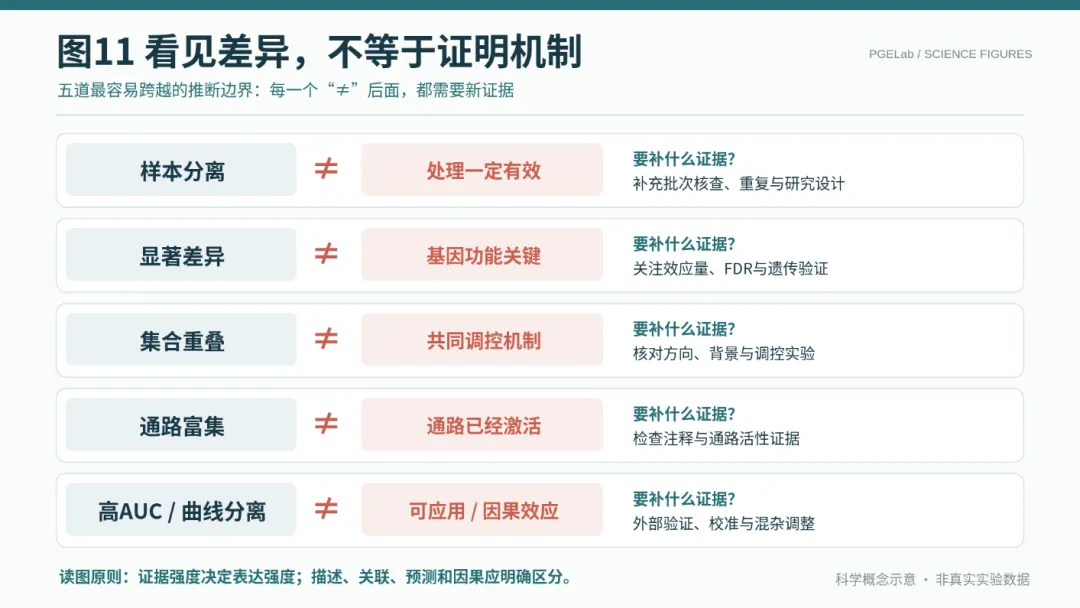
六个问题,比记住九种配色更有用:第一,看每个点、颜色和曲线究竟代表什么;第二,看单位、数据转换与标准化;第三,看比较方向和参照组;第四,看样本量、统计方法及多重校正;第五,看效应量与不确定性;第六,看是否存在独立验证或机制证据。这六项能够把视觉印象转化成可复核的科学论断。
把分析线索和机制证据分开:在植物基因组设计与基因编辑研究中,“差异表达—富集—候选筛选”是建立功能假设的一条常见线索,但真实机制证据通常还需要变异等位基因、靶向编辑、互补实验、时空表达、蛋白结合或稳定遗传表型等适合具体问题的验证。图表让发现过程透明;实验和独立验证决定结论能够走多远。
写在最后
好图不只是色彩丰富,更应让读者知道数据从哪里来、采用什么比较、得出了什么证据,以及还有哪些事情尚未被证明。会看图,是认清图形语言;真正读懂论文,是能够把结果和推断的边界分开。
参考资料与方法学来源
1. DESeq2官方教程(PCA、差异分析与FDR)
2. Bioconductor RNA-seq工作流(PCA与样本距离)
3. NIST|箱式图与箱须定义
4. Gene Ontology|GO富集与背景基因列表
5. scikit-learn|ROC curve
6. scikit-learn|ROC AUC score
7. Bioconductor|enrichplot相关可视化
8. UpSet|集合交集可视化论文与项目
9. NCBI Bookshelf|Kaplan–Meier与Cox模型介绍
图片来源及AI辅助说明
九幅教学海报主要用于认识各类图表的常见外观、坐标和术语,其中示例数据为教学模拟,不能作为真实研究证据;AI辅助用于部分初始示意图制作与文本整理,编辑阶段对方法学表述进行核查。