ARTICLE · 1160513
备料:让电脑认得一块土地——《一种地质灾害风险评估方法》系列·前置篇2:数据准备
模型不会比数据更聪明。前置篇 1 里那个"在电脑里流淌的河",开闸之前得先备料:土地的高低起伏、地表盖着什么、地下的土什么性格、天上七年的阴晴雨雪。本篇讲 ① 数据准备——四件套怎么备齐,以及每个环节我们真正踩过的坑。
一、先看全景:四件套清单
前置系列共 7 篇,与 SWAT 建模面板的页签一一对应:篇 1 讲了引擎与工程,本篇是第 2 篇——数据准备,之后依次是划界与 HRU、气象数据、输入与运行、结果与制图、率定。
SWAT+ 建模的原料可以压缩成一句话:一张 DEM、一幅土地利用、一套土壤参数、一组逐日气象。四件套各管一摊:
| 四件套 | 回答的问题 | 本方法的数据源 | | --- | --- | --- | | DEM 高程 | 水往哪儿流?流域边界在哪? | Copernicus GLO-30 全球 30m | | 土地利用 | 雨落在什么地面上? | ESA WorldCover 10m(2021,v200) | | 土壤 | 水渗得快不快、存得住吗? | HWSD2(联合国粮农组织全球土壤数据库 v2.0) | | 气象 | 天上的输入是什么? | 气象台站逐日观测(7 年,2012–2018) |
听起来都是"下载即可"的公开数据,实际处处是暗礁:瓦片命名规则、类别编码、缺测哨兵……每一个都能让模拟悄悄失真。本篇把四件套逐一过手,坑写在每节的最后。
二、DEM:流域的骨架
水文模型的第一问是"水往哪儿流",答案全在高程里。我们用 Copernicus GLO-30(欧空局全球 30m DEM)作底,把研究区范围内的瓦片拼合、投影统一、重采样到 58.4 米统一格网——最终一张 6606 × 4901 像元的高程图,海拔 63~2343 米:西北部中低山,沿河河谷深切,整个研究区是典型的构造切割山地。
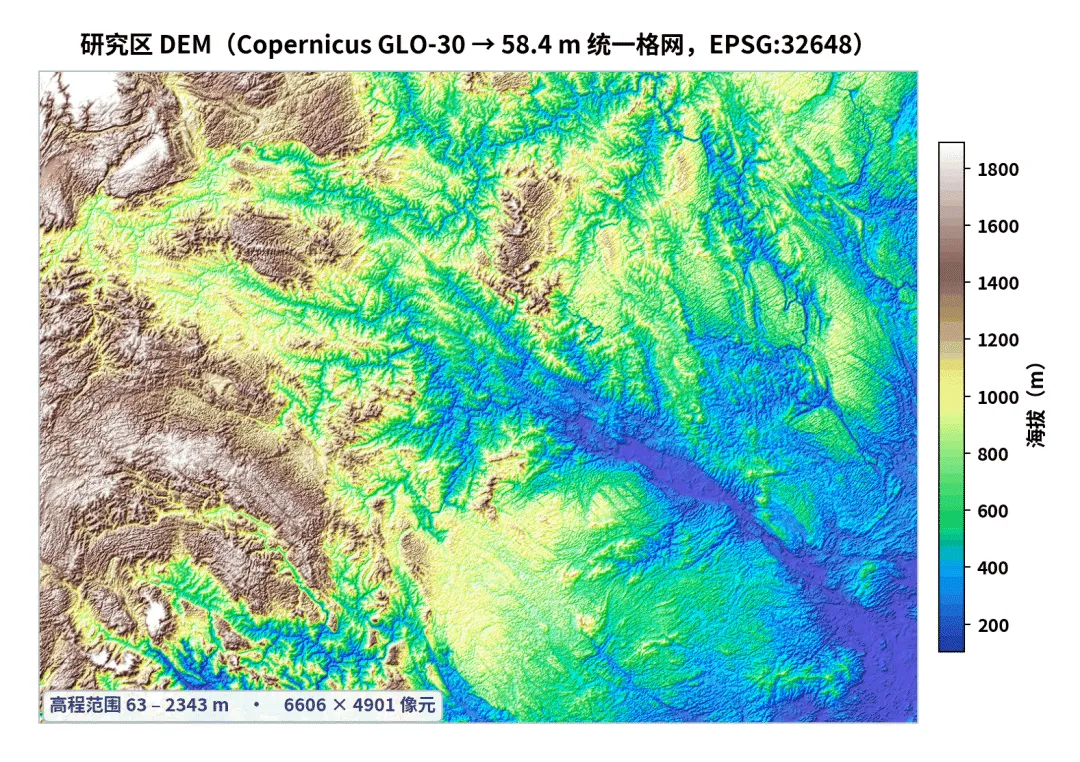
统一格网后的研究区 DEM(58.4m,EPSG:32648):高差逾 2200 米,河谷走向清晰可辨。划界、坡度、汇流累积全从这张图生长出来。
DEM 的分辨率是一次物理权衡:越细,划出的河网与子流域越贴合真实地形,但像元数按平方增长——60m 全流域约 3200 万像元,30m 就是它的四倍,后续 HRU 划分与逐日模拟的计算量、内存全部翻着跟头涨。58.4m 是"够表达沟谷、又不至于算不动"的折中。
坑 1 · 坐标系差一个号:研究区位于 UTM 47N(EPSG:32648),而软件默认值常是 32650(相邻带)。差 2 度的投影带,坐标整体偏移上百公里,划界会静默产出一条"漂移的河"。我们把它做成了面板必填项并在预处理报告里写死 EPSG,谁也糊弄不了谁。
三、土地利用:地表的皮肤
雨落在林地上,会被冠层截留、被枯落物吸储;落在耕地里,顺着犁沟就汇成坡面流。土地利用决定 SWAT+ 给每个计算单元配哪套"径流性格"(SCS 曲线数)。
我们用 ESA WorldCover 10m(2021 年,v200 版):全球 11 类地表覆盖,按查表法一对一映射到 SWAT+ 的土地利用代码——常绿阔叶林(FOEB)、灌丛(SHRB)、草地(GRAS)、耕地(CRDY)、水体(WATR)、建设用地(URMD)、裸地(BSVG)共 7 类进入模型。
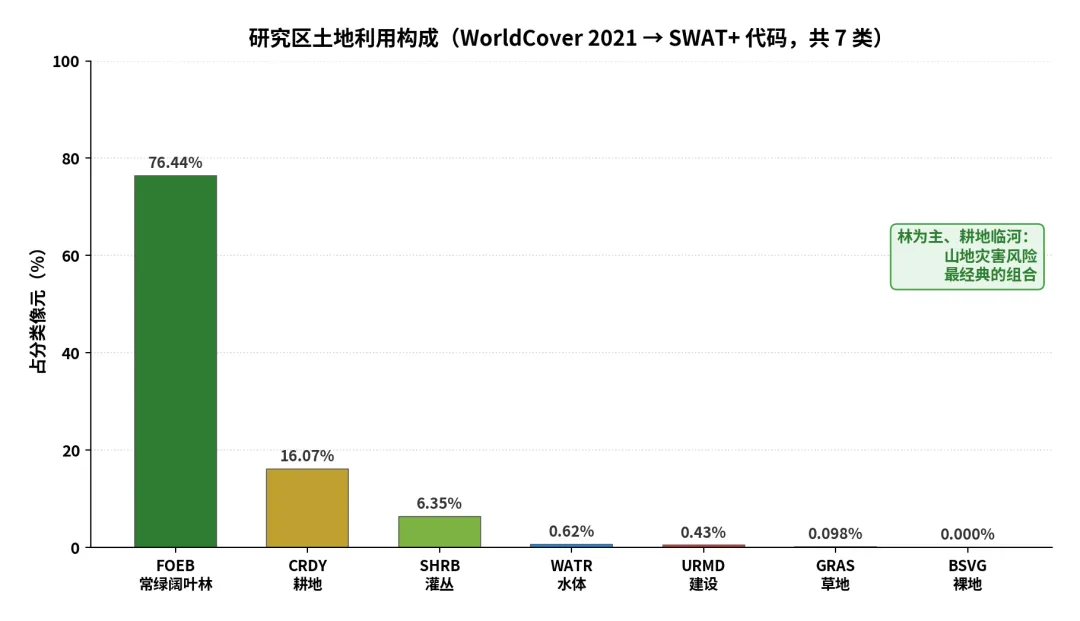
研究区范围的土地利用构成:常绿阔叶林占绝对主导,耕地沿河谷条带状铺开——" forest 为主、耕地临河"正是山地灾害风险最经典的组合。
坑 2 · 瓦片不是按 1° 切的:WorldCover 官方下载脚本按 1° 网格拼 S3 键名,实际数据按 3° 瓦片发布、以西南角命名(N21E102、N24E105……)。按官方脚本下载只会收获一串 NoSuchKey。正确姿势:算准研究区压到哪几张 3° 瓦片(我们恰好 6 张),逐张下载后用 VRT 虚拟拼接,再统一重采样到 DEM 格网——类别栅格必须用最近邻重采样,双线性插值会把"林地"和"耕地"平均出一块不存在的地。
四、土壤:地下的性格
同一场雨,落在砂土里渗走了,落在黏土里存成了土壤水。SWAT+ 需要每种土壤的一整套物理参数:分层厚度、颗粒组成、有机碳、饱和导水率……
数据源是 HWSD v2.0:全球土壤按"土壤制图单元(SMU)"划分,每个单元由若干亚层土壤类型按比例构成。我们的流水线把 SMU 栅格与研究区相交,沉淀出 37 套土壤参数,为每套自动完成三级跳:
- 质地 → 水力参数
:USDA 质地查 Rawls et al. (1982) 得饱和导水率 Ksat; - Ksat → 水文分组
:映射到 SCS 曲线数的 A/B/C/D 四组; - 有机碳 + 颗粒级配 → USLE K 值
:侵蚀因子一并备齐。
产出是一个自带的土壤库(SQLite),每个建模工程复制一份快照——知识库随工程走,不怕公共库被改。
坑 3 ·"完整"的原始包并不完整:网上流传的某土壤转换包自带一张土壤栅格,看上去拿来即用——放大看只有一个有效值,40.2% 的像元是 nodata,用它建出的流域有四成土地"没有性格"。老老实实回到 HWSD2 原始数据重建,才是正路。
五、气象:给流域装上天气
前两件套是"土地的先天禀赋",第四件套是"天上的驱动"。我们接入了研究区 6 个台站 2012–2018 共 7 年的逐日观测:降水、气温(最高/最低)、日照时数、相对湿度、风速——日照按纬度换算成太阳辐射,缺观测的统计气候特征(月亮温度、降水概率)由天气发生器(wgn)补齐。每个台站生成一套标准站文件,再建"站—计算单元"的分配表。
数据看着规整,其实埋着本系列到目前为止最阴险的坑:
坑 4 · 9999 不是暴雨,是"我不知道":原始处理链把缺测写成哨兵值 9999,但 SWAT+ 的日值文件没有缺测约定——9999 mm 的日降水被当成真实极端暴雨参与模拟。逐站审计结果触目惊心:6 个站 7.3%~15.2% 的天数带哨兵,其中一个站干脆整站损坏(非哨兵日的"降水"均值高达 182 mm/天,而真实台站上限不过 999.9)。
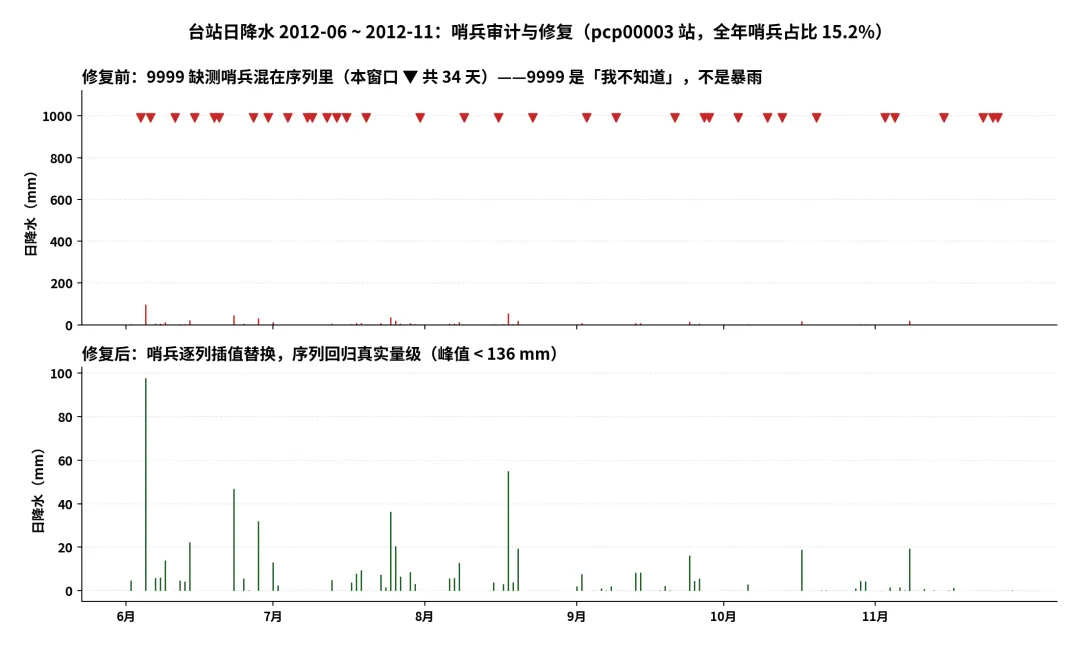
同一台站修复前后:原始序列里 9999 的"暴雨尖峰"其实是缺测占位符;修复后哨兵被逐列插值替换、损坏整站剔除。修复前的所有模拟,都是伪暴雨撑出来的。
修复脚本做了三件事:哨兵日逐列线性插值(降水置 0——没记录就当没下);按"非哨兵日均值 > 50 mm/天"剔除整站损坏者并同步全部站点索引文件;原始目录备份留档。这条审计后来成了数据准备流水线的标准步骤——任何时序数据进模型前,先查值域。
六、预处理流水线:一切对齐到一张格网
四件套来自四个年代、四种分辨率、四个坐标系,直接叠就是灾难。预处理一键完成"空间基准统一":
以 DEM 为参考,全区统一到目标 EPSG(32648)的 58.4m 公共格网; 地形量用聚合重采样,类别量(土地、土壤)一律最近邻——绝不把两类土地平均出第三类; 土地利用经查表映射为 SWAT+ 代码;土壤挂接 37 套参数库; 由出口点(经度,纬度)生成出口文件——它决定整个流域"往哪儿汇"; 全程产出诊断报告 JSON:格网尺寸、分辨率、DEM 高差、土地利用类别构成、土壤套数,一项项落盘可查。
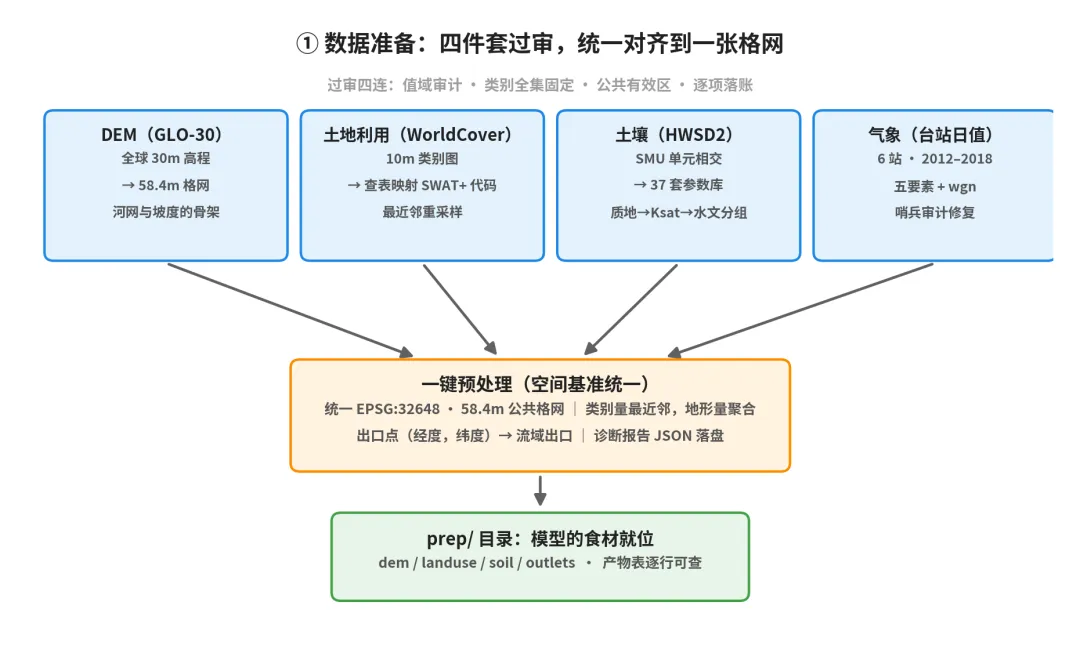
① 数据准备:四件套各自过审,统一对齐到 58.4m 公共格网,出口点钉住流域出口,诊断报告逐项落账。
七、怎么用:在 QGIS 里点几下
以上全部逻辑封装为插件「地质灾害风险智能分析」SWAT 建模面板的「① 数据准备」页签:
四个输入框:DEM、土地利用栅格(值 = SWAT+ 代码)、土壤栅格(值 = 土壤 id)、可选的河网矢量(Burn-In 用); - 目标 EPSG 必填
(本例 32648)——还记得坑 1 吗,这里不设默认值; 出口点填"经度,纬度"(本例钉在出口水文站),点「数据预处理」; 完成后底部横幅给出格网与分辨率,产物表列出 prep 后的四件套与出口文件,诊断报告 JSON 落在数据目录。
跑完这一步,四件套就从"原始素材"变成了"模型的食材"——下一步,交给划界。
写在最后
数据备齐,格网对齐,流域还只是一张"平面的地图"。下一篇,前置篇 3:划界与 HRU——TauDEM 怎么顺着 DEM 把流域切成子流域,又怎么按土地组合切出成千上万个计算单元,给河流搭起真正的骨架。
(本系列基于「地质灾害风险智能分析」系统的实际工程实现撰写,文中数字均为真实运行结果,欢迎同行交流指正。)
前置系列目录(与 SWAT 建模面板 7 个页签对应) 前置篇 1 · 引擎与工程:把水文实验室装进一个文件夹 前置篇 2 · 数据准备:备料——让电脑认得这块土地(本篇) 前置篇 3 · 划界与 HRU:给流域搭骨架、切细胞 前置篇 4 · 气象数据:给流域装上"天气发生器" 前置篇 5 · 输入与运行:驾驶舱 file.cio 与一次模拟的内部循环 前置篇 6 · 结果与制图:从 300 个输出文件到一张图 前置篇 7 · 率定:让模型与实测河流对上暗号