ARTICLE · 1184215
AI存储论文解读:ReadKV:KV 存得更细、每步少读,为什么还没跑赢未压缩缓存?
ReadKV 把 KV 的保存精度与每步读取精度分开。它减少了所测单层内核的物理读量,但仍慢于 Dense,测速配置还存在检索退化。存储团队应同时核算容量、搬运与质量。[S1]
1. 论文信息
2. 一句话总结
ReadKV 把每个K/V标量保存为可逐层细化的编码;当前Query先决定Key各通道读多深,再由重建的注意力决定Value各token读多深,让未读的精度保留给后续Query。
这是一种有损注意力读取机制。它没有承诺每次重建都等于原始浮点KV,也没有实现SSD、CXL或远端KV池。
3. 研究背景:容量和每步读量是两种约束
对形状一致的注意力层,KV载荷可以粗略写成:
容量 = 2 × 层数 × batch × token数 × KV heads × head维度 × 保存位宽 / 8
系数2对应K和V。这个估算不含权重、临时工作区、校准数据、分页取整与分配器预留。GQA共享的物理KV head只计一次,不能按Query head重复计算。[S1,§3与附录A]
固定4位缓存通常把“保留4位”和“每次读4位”绑定。ReadKV引入两个参数:W为保存深度,R为平均载荷读取深度。(W=8,R=4)保留8位码,每步平均读4位;(8,2)仍存8位,但每步平均读2位。平均不等于每个通道或token都读相同位数。
影响判断: 只证明第二本账下降,不能直接宣布带宽、并发或服务器成本下降。本文以设备DRAM统称实测显存流量,不把A10G结果写成HBM设备实测。
4. 核心问题:少读的收益能否覆盖选择与解码成本
可证伪问题是:在同一缓存、Query、硬件与质量门槛下,Query相关的精度分配,能否减少实际读取并降低完整attention调用的时间?如果选择、排序、重建和中间结果读写吃掉收益,逻辑层面的优化就不能转化为时延优势。
另一条检验线是容量。与完整读取4位码相比,(8,4)多保存一倍载荷,却不减少相同预算下的历史载荷读取;它争取的是相同读预算下的质量。多存的部分即使写入成本被多次读取摊薄,仍持续占用显存。
因此,理想条件应同时包括:KV访问在解码成本中占比较高、当前Query的需求存在差异、额外持久容量可接受、内核能以较少开销执行部分读取。这些条件需要测量,不是对所有长上下文服务都成立的事实。
5. 系统与方法设计
5.1 写入:保存一条可逐位细化的路径
编码器先用固定的正交Hadamard–sign变换混合坐标,再用校准均值与尺度标准化。K与Query使用相同变换以保持内积,V采用另一组变换,输出端做逆变换。符号、变换和校准参数在Query变化时保持固定。
标准化标量被编码为Gaussian Lloyd二叉量化树上的W位路径。前两位已经对应一个粗略重建值;增加第三位会在子区间中细化。读取0位时采用校准均值。它不是简单截断FP16尾数,也不是先读完整8位再扔掉其中6位。
5.2 第一阶段:Query决定Key通道深度
对一个物理KV head,Key通道的重要性由共享它的所有Query heads贡献累加,可概括为:
Key重要性 = Σ(变换后的Query分量 × 对应校准尺度)²
分配器为每个head–channel选择深度,同一通道的深度覆盖全部历史token。该阶段的地址在读取Key之前就已确定,不借用未读取的全精度Key。随后用重建Key计算logits与softmax,得到近似注意力。
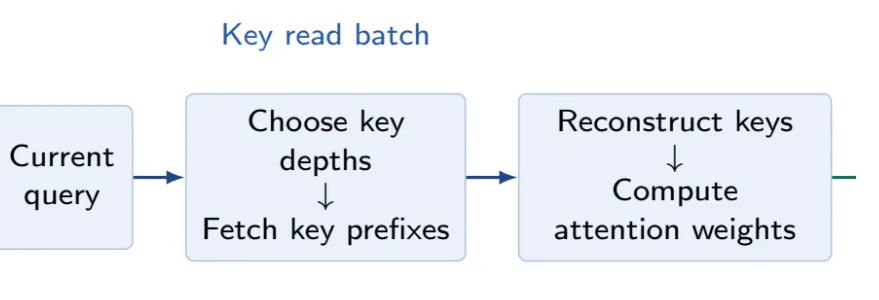
图1a|原论文2610.11245v1,2026-10-08,PDF第4页Figure 2左侧局部放大,[S1]。先读取Key前缀、重建注意力,再进入图1b的Value阶段。prefix指编码位前缀,不是跨请求共享的prompt prefix。
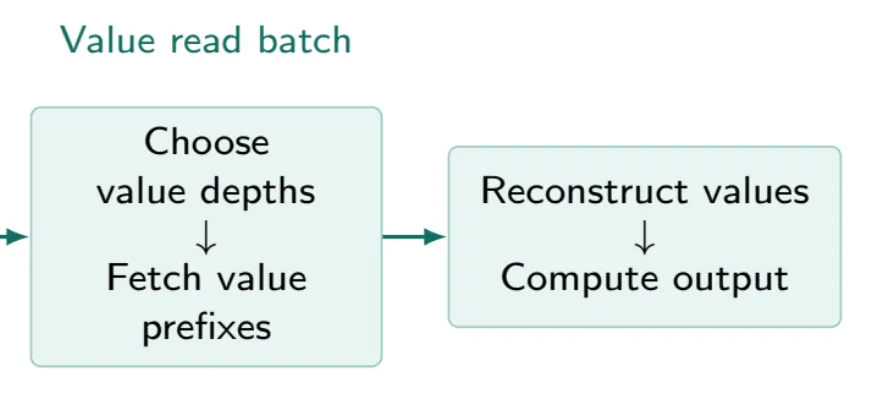
图1b|同一Figure 2右侧局部放大,[S1]。输入是前一步重建的注意力;选择Value深度、读取并重建后形成输出。两段拆图只为手机阅读,未改动原始内容。
5.3 第二阶段:近似注意力决定Value token深度
Value端按token分配精度,每个token的所有通道共享深度。其权重来自共享Query heads的注意力概率平方和;论文主要实验在标准化单位中使用head尺度系数1。
这里存在一次明确的阶段依赖:第一批返回的Key bits改变注意力,注意力再改变第二批Value地址。每一批内部的地址在返回该批数据之前固定。最终重建Value、做加权和,再逆变换得到输出。
5.4 分配器优化什么,不能保证什么
分配器最小化校准代理目标Σ aᵢD(tᵢ):aᵢ是本次重要性,D(tᵢ)是该深度的预测重建误差。每次将下一位分给预计误差下降最大的合法对象,直至预算耗尽或无正收益。
Key通道多一位要读取T个bits,Value token多一位要读取head维度个bits。K和V分别获得整数增量预算B_K与B_V,总载荷不超过T×B_K + d_head×B_V。R是二者折算的平均,K/V预算如何拆分是外部输入,不由阶段内分配器自动全局优化。
理论在细化收益非负且递减的条件下证明阶段内代理目标最优;没有证明全局真实attention误差最优。误差证书还依赖实际残差相关性和校准偏差,是重建后的离线检验,不是在线质量担保。相对Query无关读取的严格优势也限定在论文构造的输入族上。
6. 存储、缓存与数据路径机制
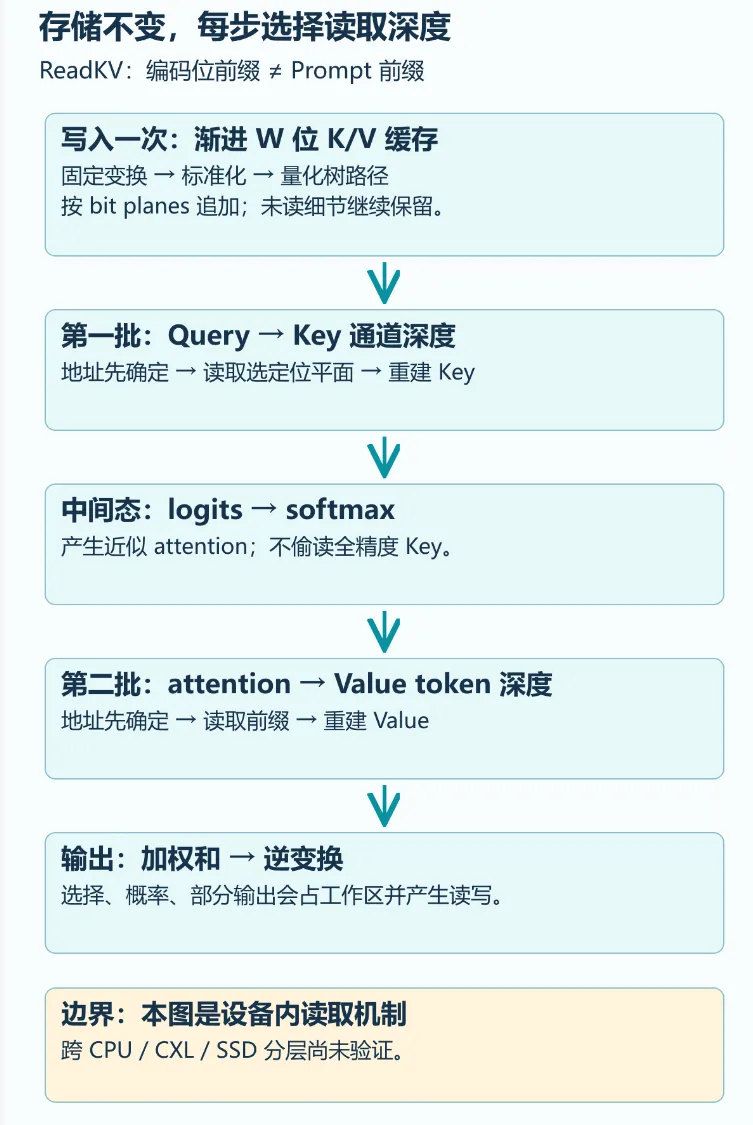
图2|本号原创解释图,依据v1 §3、附录G,[S1]。持久位平面保持不变;两次地址选择和临时attention状态属于运行路径。图中不包含跨介质卸载。
6.1 对象布局与生命周期
新token的K/V变换、标准化后,按渐进码bit planes追加到缓存。后续Query对同一存储对象读取不同前缀;未读的细化位不被删除,也不重新编码。模型版本、变换、校准和码本需要与该缓存保持一致。
这里没有传统共享缓存的“命中后从SSD取回”流程。深度0用均值近似,较低深度用码本重建,都不是从慢层等待缺失数据。论文未实现跨进程恢复、持久存储故障处理、共享对象引用计数或远端淘汰机制。
6.2 临时工作区会反向增加物理写量
实际GPU读取器需要scores、probabilities、调度深度及部分输出。8K、batch=1的单层设置中,ReadKV工作区为3.87 MiB,TurboQuant为0.45 MiB;它们不在“KV载荷8.00/4.19 MiB”之内。
不能将某一时点的KV载荷当作整模型峰值显存。应测同时存活的KV、工作区、权重、激活及分配器状态。论文资源表中的逻辑读量排除权重、缓存写入和临时工作区;物理流量表则计入完整attention的中间读写。
6.3 多存细节的写成本,靠复用次数摊销
论文给出仅载荷模型:N个prompt token、L次解码,历史读取次数为S=LN+L(L−1)/2。从4位全读切换到存8位、读4位,多写4(N+L) bits,而历史读取预算仍为4S。
N=8192、L=128时,额外写量约为共同累计读量的0.78735%,即论文的0.79%。这不代表总流量下降0.79%,也不是实测写放大;两者历史读量相同,8位方案还多写。 更不意味着8位缓存的容量会随复用次数减少。
7. 实验设置:质量与速度分成两条证据线
质量读取器允许跨head汇总预算、深度0,并在开发集选择K/V拆分后冻结。主要质量运行使用L4,Mistral指令模型和后续控制实验使用A10G;部分Qwen补充行跨硬件与校准批次拼接,不能按严格单变量消融解读。
论文质量实验的bootstrap按配对文档或问题重采样,通常至少10000次;NLL置信区间不能直接解释为平均PPL的置信区间。系统中位时延也不等于线上P99。
8. 关键结果:每个数字都要带上读取器和基线
8.1 结果1:存8读4的质量较稳,但容量约为4位全读的两倍
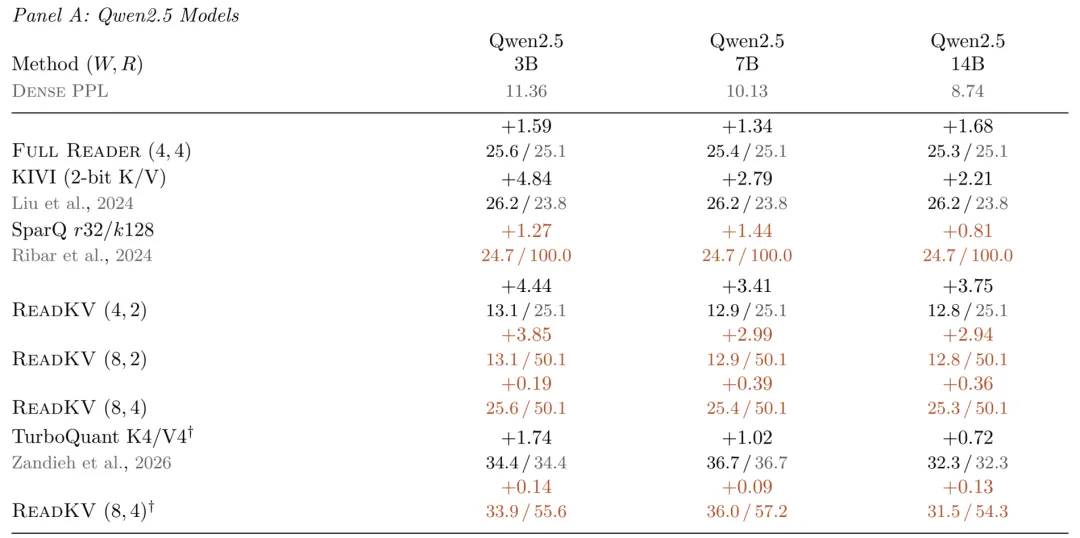
图3a|v1,PDF第11页Table 2 Panel A,[S1],2026-10-08。单元格上行为相对Dense的PPL增加百分比,下行为逻辑读量/持久KV容量占Dense的百分比;三者越低越好,但不能互相替代。
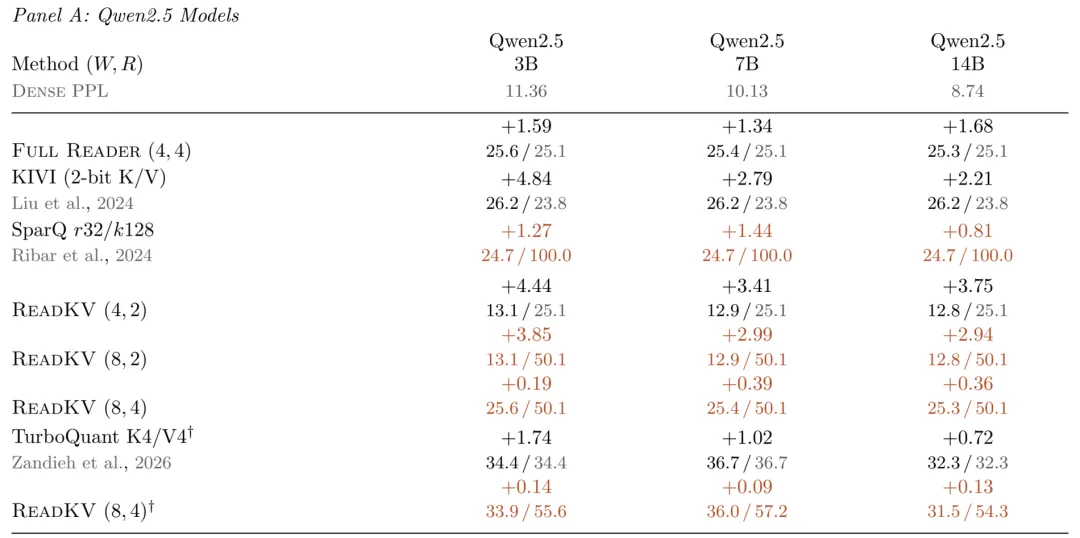
图3b|同页Table 2 Panel B,[S1]。†表示首两层和末两层保持Dense;不可把带†的读量与全层压缩的读量混用。颜色为作者在质量—读量二维上的观察前沿,没有把容量纳入排名。
条件为v1表2的32篇2048-token C4测试、灵活读取器、全层压缩,日期2026-10-08。ReadKV(8,4)逻辑读取占Dense约25.2%—25.6%,容量约50.1%;Full Reader容量约25.1%。这是更多保留信息换更好的同预算读取质量,不是比4位全读再省一半容量。
R降到2后,ReadKV(8,2)在Yi、DeepSeek、Mistral上的PPL增幅为10.16%、6.27%、11.24%。存得更细并不能保证很低的读取预算仍有稳定质量。
8.2 结果2:问答质量不能与prefill或测速收益合并
v1表3的7500-token prompt上限、每条件100题、两个指令模型×三个任务中,灵活ReadKV(8,2)的F1损失范围为−0.66到1.46分;负值代表这个样本上的分数略升,不是稳定提升的保证。逻辑读量约为Dense的12.5%—12.6%,KV容量约50.0%。
同表KIVI两位配置的容量约19.9%,逻辑读取约20.0%—20.4%。所以ReadKV少读的同时保存了更多数据。与SparQ比较也不是质量全面更优:六个条件中只有两个分数更高,其余最多低0.41 F1分。
这些任务由Dense prefill决定第一个答案token。因此不能据此声称TTFT下降;不同方法的停止长度也可能不同,归一化每次attention的信息读取占比不等于相同业务总工作量的累计字节节省。
8.3 结果3:单层比所测压缩基线快,仍慢于Dense
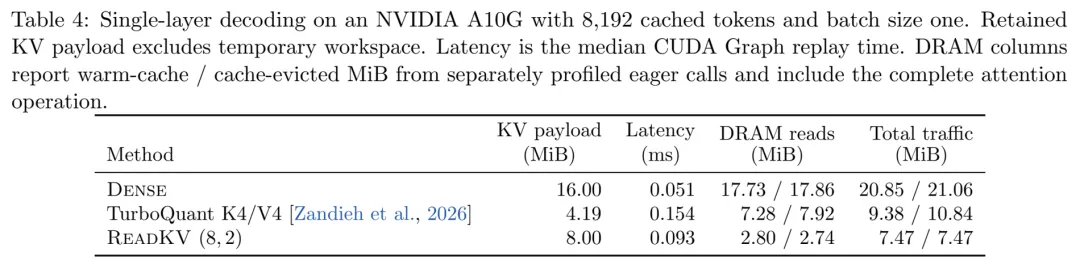
图4|v1,PDF第14页Table 4,[S1],2026-10-08。A10G、8192历史token、batch=1;时延是Graph回放中位数,流量是另外采集的eager调用数据。MiB不是MB。
计算推导: 相对所测TurboQuant,ReadKV时延下降1−0.093/0.154≈39.6%;论文概括为39%。相对Dense,ReadKV用时却增加约82.4%。反过来说Dense比ReadKV用时低约45.2%,百分比的分母不同。
附录表11在2K、batch=1时还给出TurboQuant 0.055 ms、ReadKV(8,2) 0.066 ms,ReadKV没有胜出。整个六点网格中Dense均最快。32K结果使用合成K/V,不能当作完整32K真实文本质量与服务速度联测。
8.4 结果4:物理读量降低约六成,总流量只降低约两至三成
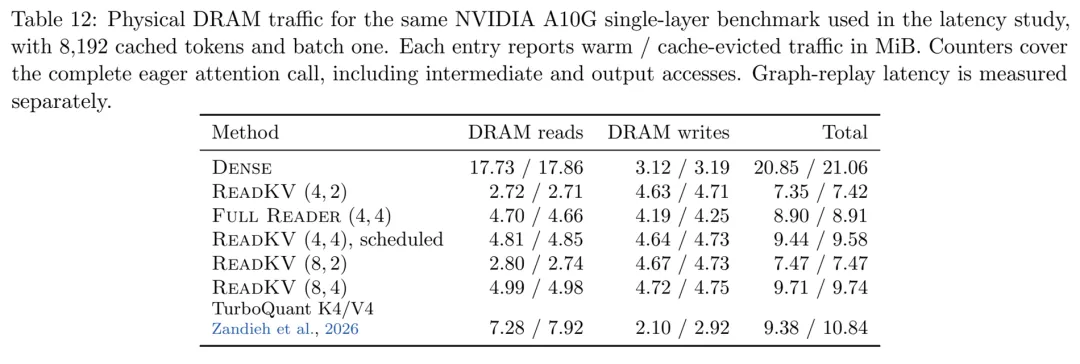
图5|v1,PDF第50页Table 12,[S1],2026-10-08。与图4相同8K、batch=1单层;warm/cache-evicted分别为温缓存/先驱逐GPU缓存,计入完整eager调用的中间结果与输出。
以上百分比由原表显示值复算。ReadKV温缓存写入4.67 MiB,高于TurboQuant的2.10 MiB;省下的读流量有一部分被中间写量抵消。R提高到4时,ReadKV总流量为9.71 MiB,还略高于TurboQuant的9.38 MiB。
NVIDIA Nsight Compute官方说明区分内存工作负载、缓存层级、回放方式及采集开销。[S3,核验2026-10-13] 影响判断: POC应把低干扰计时与计数器采集分开记录,并固定缓存准备方法。工具文档支持测量方法,不构成对ReadKV数字的独立复现。
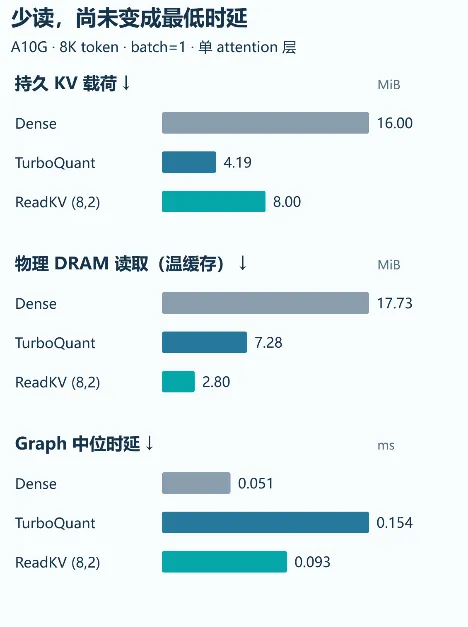
图6|本号原创数据重绘;依据v1表4/12的温缓存条件,[S1]。三个面板各用自己的单位,均越低越好。容量、物理读取和时延出现不同排序,不能用其中一项替代其他两项。
8.5 结果5:测速读取器的限制会显著改变检索质量
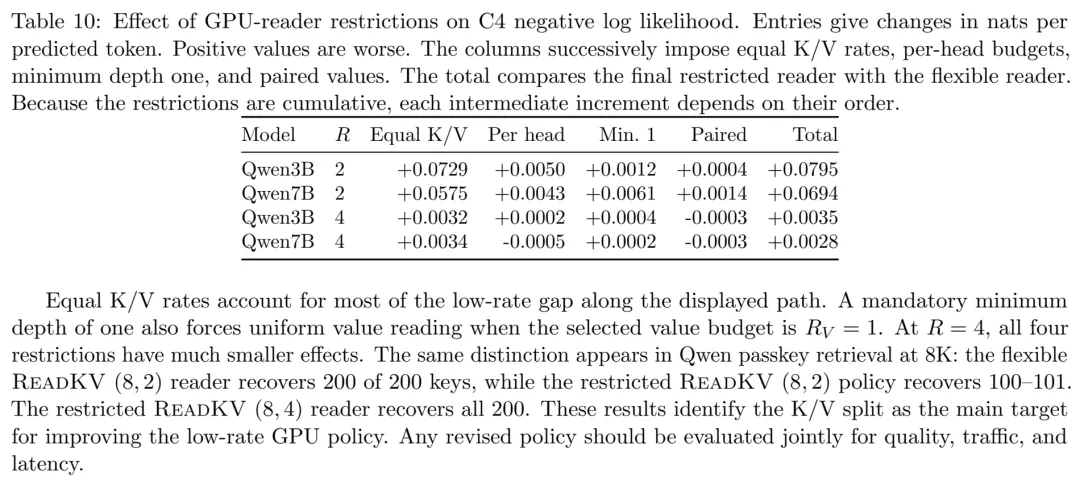
图7|v1,PDF第48页Table 10及邻近说明,[S1],2026-10-08。各列是逐步叠加限制后的NLL变化,单位nats/token,正值更差;增量依赖叠加顺序,不是独立因果贡献。
受限版本要求K/V等分、每head预算、最小深度1和两个Value成包。沿表10所示路径,K/V等分是低读预算质量损失的主要来源。Qwen3B与Qwen7B在R=2时,相比灵活读取器累计NLL分别增加0.0795和0.0694 nats/token。
更直观的边界是8K Qwen passkey:灵活ReadKV(8,2)找回200/200;受限(8,2)只找回100—101/200;受限(8,4)恢复到200/200。用于宣传的低损失质量、约39%内核时延下降,不能拼成“同一配置兼得”。
9. 创新点:把精度变成访问时的选择
第一,保存格式为未来Query保留不同读取深度。优化对象从“删掉多少KV”转向“本次读取哪些细化信息”,未读部分还在。
第二,K通道和V token采用不同分配维度,以可执行的两批读取建立因果顺序。共享Query heads对同一物理KV数据的需求统一计入权重,避免按逻辑head重复计算容量。
第三,论文把质量、持久容量、逻辑读取、物理流量和单层时延分别列出,并给出读取器限制的负面结果。其贡献并不是首创所有渐进编码或边际收益分配原则;原文也承认已有选择性bit-plane获取的系统先例。
10. 局限性:尚缺一个同配置的完整服务闭环
另一个值得保留的问题来自附录F.7:在理论上应保持分配不变的固定head预算控制中,重复整模型执行仍出现约0.0024 nats/token的差异,来源未解决。这不推翻全部结果,但意味着很小的增益不能脱离测试框架波动解读。
TTFT、整模型TBT/TPOT、E2E、P99、生产吞吐、SLO goodput、功耗与TCO均没有被本文单层数据验证。论文附录的容量—带宽吞吐倍率是模型输出,不是服务器实测。
11. 对AI存储工程实践的启发
11.1 缓存接口应记录保存格式,也应记录读取策略
论文事实: 同一个8位持久码可以按2位或4位平均预算读取。影响判断: 如果工程实现支持这种语义,缓存对象身份应包含模型/层/head几何、位置处理、变换、校准、码本及保存深度;请求策略再记录K/V拆分、最小深度与packet大小。仅用“INT8 KV”描述会丢失读取器差异。
11.2 必须加入成熟后端作为实际对照
vLLM官方量化KV文档描述FP8的per-tensor和per-attention-head校准,也提供敏感层跳过配置;特定Flash Attention 3路径在FP8域执行attention。这些机制提示,精度与内核的组合决定结果,低位宽并不只有一种实现。
影响判断: 除论文原基线外,POC应加入目标硬件支持的现有生产后端,固定校准与跳过层规则。这是对照设计建议;该文档没有证明vLLM已集成ReadKV,更不能把FP8开关当作ReadKV开关。
11.3 跨介质分层是研究方向,不能写成已经落地
论文讨论把较少访问的细化层放到慢而大的内存,但没有完成端到端验证。影响判断: 如尝试CPU/CXL/SSD层,位平面应以足够大的块打包;收益取决于传输粒度、请求合并、取回期限与解码重叠。随机少量bits并不会自动变成有效的NVMe读请求。
先证明GPU内的同质量收益,再研究卸载,可以降低同时修改表示、内核和I/O调度导致的归因困难。
12. 最小POC与验收门槛
下表均为本号工程建议,未执行,不是论文实验结果。先锁定同一模型、相同问题、相同输出规则及校准集;代码入口和版本未能锁定时,不进入性能承诺阶段。
建议先设三条同步验收线:关键passkey集合200/200、QA各关键子集F1下降不超过1分;相对目标生产基线P99不恶化超过5%;相同SLO下goodput提高至少10%,且多次独立运行的差异区间不跨零。这些是起始门槛,具体业务可更严格,不能由平均值替代关键样本验收。
同时记录保存字节、实际可用显存、临时峰值、每token读写与编码构建成本。如果只有逻辑读取下降,或依靠降低质量获得吞吐,则判定尚未通过。模型升级、码本错配、预算变化和中断恢复应单列失败测试。
13. 数据化判断:证据支持到哪一层
这是证据矩阵,不与95分的选题评分混用。选题高分意味着值得读、值得验证,不意味着已经具备生产成熟度。
14. 结论与引用
super判断: ReadKV最有价值的启发,是把“保存多少”和“本次搬运多少”拆开设计。当前可以支持表示层和内核POC;还不能支持生产服务加速或存储采购降配。下一步应让同一个读取器同时通过质量、物理流量和SLO测试。
如果目标服务已经被KV读带宽限制、又有容量余量,可以优先探索;如果主要瓶颈是权重读取、低batch启动开销,或关键事实召回不容退化,现有证据不足以推荐直接替换。
专业讨论:你们的服务更受限于KV驻留容量,还是每步真正跨设备内存边界搬运的字节?如果只能先补一项观测,能否把这两者与P99放到同一次回放中测量?