ARTICLE · 1212733
每天新增30万下载,Muse离“人人一个Agent”还有多远?
每天新增30万下载,Muse离“人人一个Agent”还有多远?
阅读目录
一个应用每天在美国新增约30万次下载,看起来已经走出了小众圈子。但如果两周后的留存只有约两成,接下来的问题就变了:怎样让人每天回来,又怎样负担这些人每天让AI干活的成本?
摩根士丹利最新一份Meta报告,把这两件事放在一起分析。它引用的应用数据表明,Muse仍在吸引新用户;它的算力模型则提醒,真正走向数亿日活以后,GPU容量可能成为另一项约束。获得下载、形成习惯、用可承受的成本完成任务,需要分别过关。
这篇文章选取报告中的用户采用与算力部分,继续追踪Muse上线后的变化,不重复介绍它的产品沿革。
研报来源
Morgan Stanley|Meta Platforms Inc: How Much Capacity Will Muse Need and 5 Agentic Reads from the Answer
公开资料: Meta于9月8日发布的Muse产品说明,用于核对产品形态;本文访问于10月19日。
下载还在增长,为什么留存更值得看?
按大摩报告采用的Sensor Tower数据,Muse在美国仍有约30万次日下载,所附用户图中的日活规模已到约250万。两条曲线一起看,说明产品仍在扩张,也已经拥有一批活跃用户;它们没有证明下载正在以同样的速度变成持续使用。
下载是一次进入,日活是某一天回来使用,留存则追问同一批人过了一段时间还剩下多少。这几个数的统计对象不同,不能拿日活除以某一天的下载量,算出一个所谓转化率。
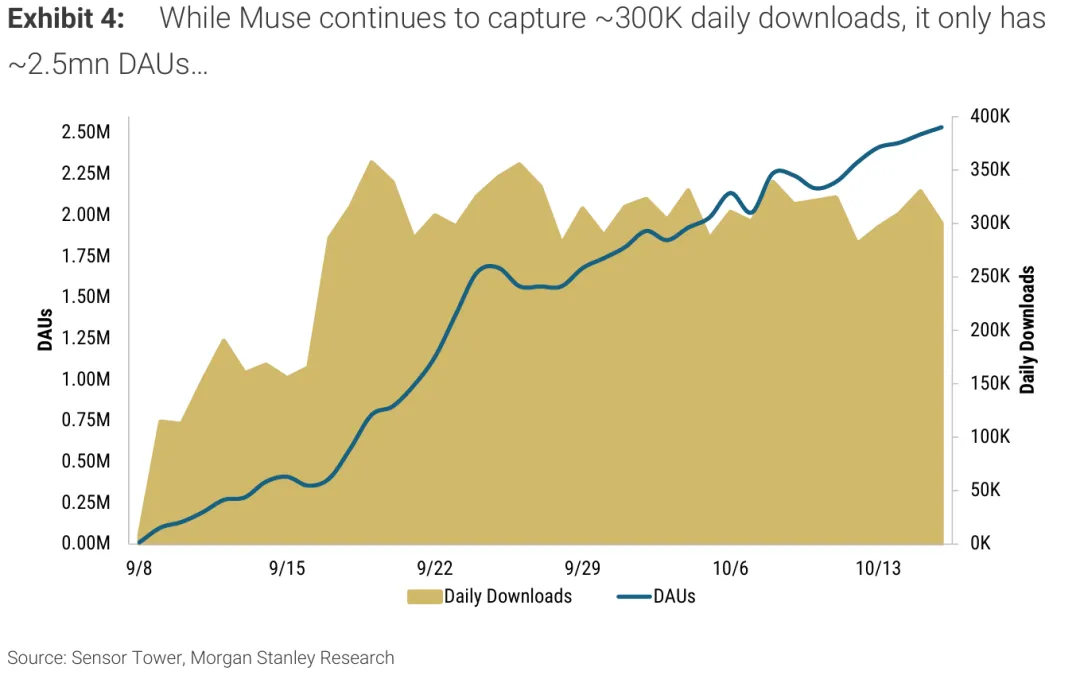
图 1Muse日下载与日活变化
留存图更能把问题说清。报告正文把14日留存概括为约20%,所附曲线在第14天标注23%;我们保留这个读数差异,将它概括为约两成。同图的Google、Instagram和Facebook曲线都更高,但这些产品已有成熟的使用习惯,比较的意义在于看差距,不能据此直接宣判一个新产品成败。
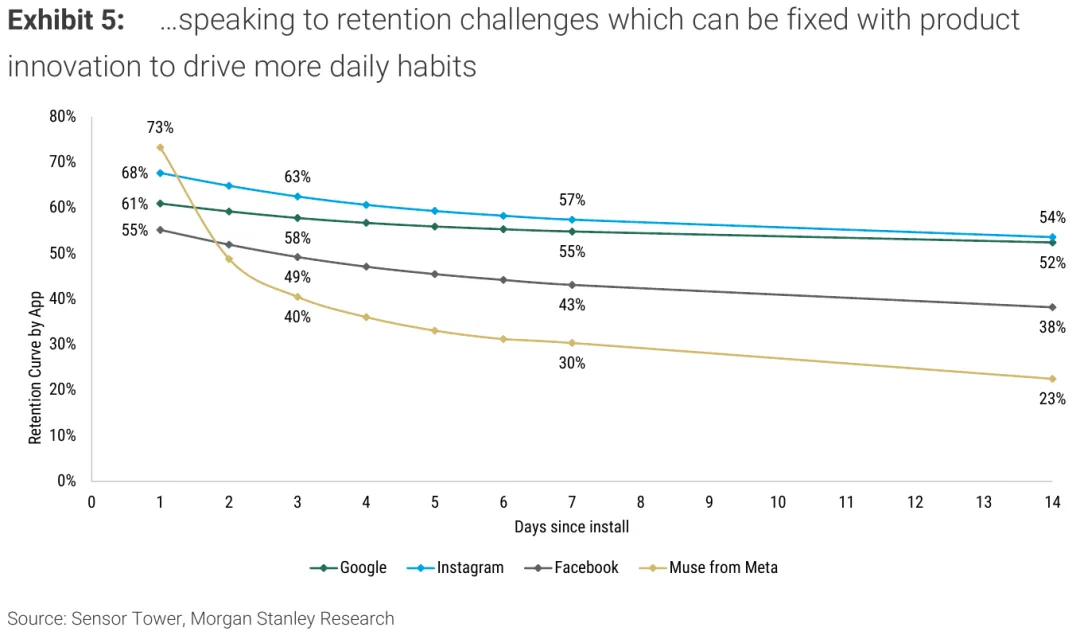
图 2Muse与成熟应用的留存曲线
大摩希望看到的,是更多日常场景和商业功能。它提出了很具体的问题:用户会不会通过Muse安排感恩节餐食、节日购物,或者下一次旅行?这些场景能否成为可反复交付的服务,决定了下载之后还有没有下一次使用。
在我们看来,下载曲线回答了产品能否让人愿意试一试;留存曲线开始检验,用户是否已经找到足够频繁、值得委托的事。有用一次,与值得每天打开,之间还有一段产品工作。
AI替你办事,为什么还要算GPU?
Muse的产品形态,解释了为什么这份报告没有只盯着应用排名。
Meta的官方说明将它定义为个人智能体:运行在专属云端虚拟机上,可以打开浏览器、使用连接的应用,并在用户关闭应用后继续处理任务。发送邮件或购买等敏感动作仍需要用户批准。这是公司的产品说明,不是本文对所有任务成功率的独立测试。
云端虚拟机让人很自然地关注CPU:浏览器、工具和任务执行,都需要运行环境。但大摩此次把注意力拉回GPU。它认为,智能体使用规模扩大时,负责模型推理的GPU消耗了更大部分的功率容量,也因此更值得放进扩张模型。
一个任务是否耗费算力,不能只按用户在屏幕上输入了几句话来衡量。报告关注的是模型规模、交互强度、token吞吐和额度使用率;不同任务也可能被分配给不同模型。用户说一句“替我安排好”,并没有替平台确定后台需要多少计算。
CPU执行环境和GPU推理能力都要建设,不能用其中一项的进展,代替对整项服务成本的判断。这里讨论的是大摩此次模型中的主要约束,不意味着每一种智能体工作负载都有完全相同的资源结构。
每一亿日活,需要多大的算力?
大摩给出的醒目结论是:在其假设下,每1亿Muse日活可能需要约1—4GW的GPU容量。
这个数字依赖两项重要假设。报告取用户平均消耗每周免费token额度的25%,并在每块GPU每秒3500至17500 tokens的吞吐区间内做敏感性分析。固定这1亿日活和额度使用率,所需容量随吞吐效率而变化;它不是对Muse后台的实际测量。
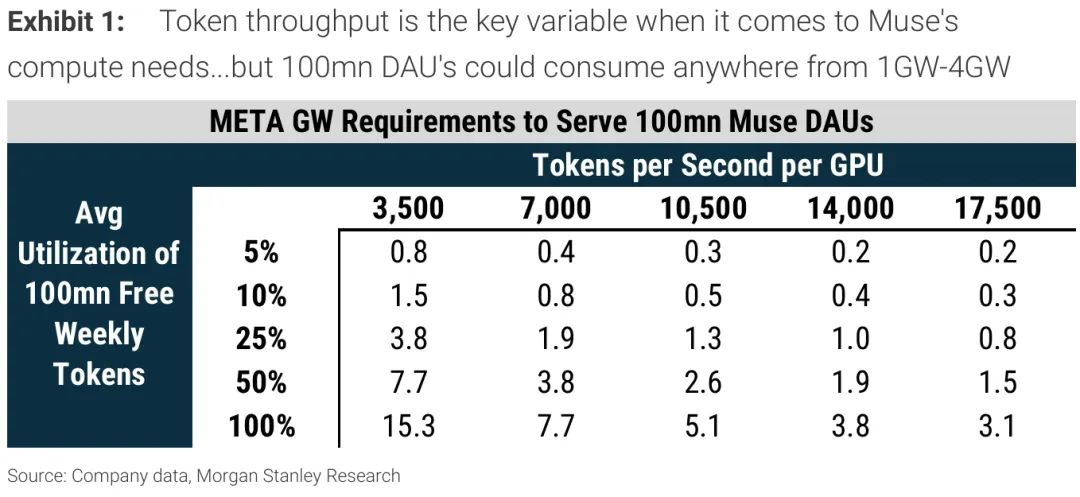
图 3一亿Muse日活的GPU容量敏感性测算
原表25%这一行,从低吞吐到高吞吐,容量约为3.8、1.9、1.3、1.0和0.8GW。报告正文将其概括为约1—4GW。这个区间很宽,恰好说明结论对效率假设敏感;拿其中一个数当成每亿用户固定配额,会丢掉这张表最有用的信息。
GW是功率单位,这里表示模型测算所需的容量,不是每年耗电量,也不是已经采购或投入运行的机房规模。要换算电量,还需要运行时间和实际负载等条件;要推算投资额,还需要硬件配置、建设成本和资源利用情况。本文不继续叠加这些未经确定的假设。
大摩也承认,它不知道Muse Spark/Wonder的完整实际特征,包括参数规模、交互情况及token吞吐。因而,这张表适合回答“哪些变量会改变扩张难度”,不适合回答“Meta已经为每个用户花了多少钱”。
它最直接的启发是:同样多的活跃用户,更高的模型服务效率,可以显著改变所需容量。相反,如果用户从偶尔尝试变成频繁委托,实际额度消耗提高,留存改善也会带来更大的服务负荷。
用户留下来以后,扩张就容易了吗?
对消费应用来说,留存改善通常是好消息;对需要持续计算的智能体,还要问留下来的人会用多少。
大摩在另一组情景里假设,5亿日活、每人每周使用5000万tokens,以及每块GPU每秒约1万tokens的吞吐,可能需要约13GW容量。在其同一套模型中,Meta于2027—2028年为各类AI产品和服务新增的总容量也约为13GW,包含自有及第三方容量。
把两者并列,是为了展示资源分配的压力。前一个是特定用户规模和用量下的需求情景,后一个是机构对公司两年总扩张的预测。它不代表Meta已经把这些资源全部分配给Muse,也不代表5亿日活已经实现。
这就形成了一道经营选择题:更多用户、更高用量和更强模型,都可能提升产品价值,也可能争用有限容量。效率改善会缓解压力,但如果节省下来的资源很快被新增任务用掉,总投入未必同步下降。后面这一步是我们的机制推导,实际结果仍取决于用户需求和公司如何配置资源。
因此,大摩一方面看好智能体,另一方面提醒采用曲线可能比市场期待的更长、有时也更平缓。它拿电商和移动电商早期渗透作对照,强调用户行为改变需要时间;这是一种历史参照,不能照搬为Muse的增长时间表。
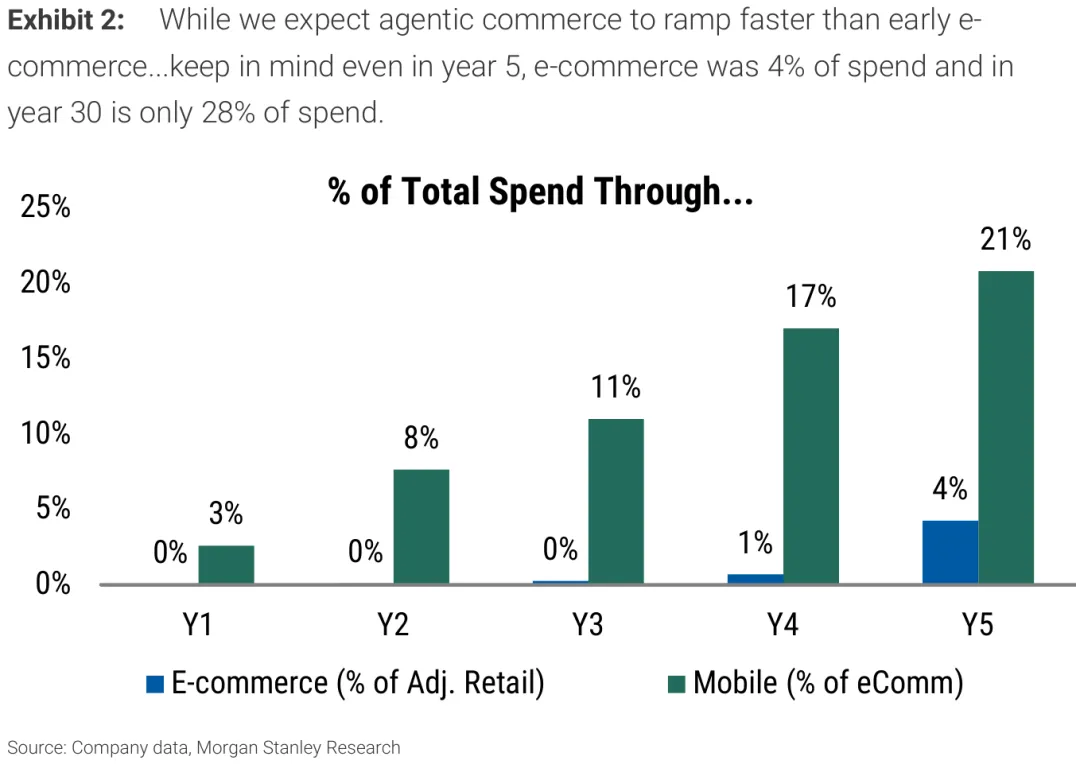
图 4电商与移动电商早期渗透的历史对照
计算容量要逐步建成,模型需要提高效率,用户也要发现值得持续交给它的任务。这几项进展不必同时发生。一个产品可以先获得很大关注,再慢慢磨出日常价值;也可能需求已经清楚,服务成本却仍限制免费开放的范围。
机会很大,为什么不能直接写成收入?
大摩仍认为,智能体可能触及约30万亿美元的消费支出,其中电商与旅行占约55%。这里衡量的是可能被数字化服务触达的消费支出,不等于Meta能获得的收入,更不等于Muse已经产生的交易额。
用户买一张机票,机票全价并不会因此变成智能体公司的收入。平台最终能获得订阅、佣金或其他收入,取决于产品能力、商业合作和交易安排;还要扣除服务这些任务的成本。大市场说明值得尝试,具体收费方式和可持续利润仍需分别验证。
报告还指出,企业需要调整现有网络和业务架构,建设能让外部智能体安全发现服务、进行交互的接口层,并配套可观测工具。商家和用户两边的采用都需要时间。模型能够理解目标,并不代表所有服务已能稳定接入和完成。
这也是为什么,我们没有把留存约两成简单写成悲观结论。若更多连接和高频场景让用户形成习惯,留存可以改善;若模型和服务效率提高,规模化的成本也可能下降。两边都有推进空间,目前的数据只是早期观察。
但反过来也成立:如果新增用户主要来自尝鲜,使用没有形成连续价值,或者更多任务带来的成本始终难以覆盖,庞大的潜在市场就不能单独支撑商业判断。
接下来,什么变化最值得追踪?
我们更想看到的,是三组指标能否一起改善。
一是同一批用户的持续使用。在接近的统计口径下,后续批次的留存是否提高,高频用途是否逐渐明确?下载量仍有价值,但不能替用户习惯作答。
二是完成任务的效率。相同或更好的任务体验,是否需要更少的模型计算、更少的等待和人工接手?只公布模型吞吐提升,还要看这些改善能否进入实际产品。
三是使用与付费的关系。更多使用能否转成用户愿意持续支付的价值,收入又能否覆盖相应的服务成本?报告预测中的订阅机会,需要真实经营进展接上。
Muse提供了一个很具体的观察窗口:消费级AI已经走到“愿不愿意把事情交给它”的阶段,但从尝鲜走向日常,仍取决于稳定交付与成本。留住用户之后,平台还需要有能力、也有经济理由长期服务这些用户。
文中原图来自相应PDF页面渲染裁切,图表版权归原权利人,文章不暴露报告原文,仅作信息总结。本文用于产业与市场信息整理,不构成证券投资建议。
参考链接
[1] Meta官方Muse发布说明:https://about.fb.com/news/2026/09/introducing-muse-personal-ai-agent/