ARTICLE · 1222489
初高中数学建模·第17期|熵权法:把数据差异算成权重
启思数模 · 数学建模36期 · 17/36
上一期用AHP整理重要性判断。这一期,我们从数据差异出发,完整建立并检验一个熵权评价模型。
一、把评价目标写成可计算的问题
同一月份,四个社区的雨水收集点都在为绿地供水。谁运行得更好?D回用水最多,A的供水成功率最高,B维护最省时。三张单项榜单给不出一个共同的答案。
我们把目标限定为:在基本安全与水质要求已经满足的条件下,比较四个收集点当月的回用成效、供水可靠性和维护投入,得到一张综合排序表。先写清评价范围,才能判断最后的名次回答了什么。
下表全部为教学模拟数据。假设各点集水面积与灌溉需求相近,观测月份、供水任务与记录口径一致;每点模拟100次供水请求,按计划完成的次数除以100,得到成功率。真实项目需要先核对这些条件,不能把不同服务规模的点直接混在一起。
三项数据还要有清楚的定义:回用量记录真正用于灌溉的雨水,不把收集后又排走的水算进去;成功率按请求次数统计,并非回用量占总需求量的比例,各次请求的水量可以不同;维护工时记录完成同类巡检、清洗与检修任务所需的人时,不能把少做必要维护当作节约。
原始矩阵 X:行是收集点,列是指标
用X表示这张4行3列的数据表,xᵢⱼ表示第i个点在第j项指标上的原始数值。前两列越大越好,第三列越小越好。我们暂用加权和作为综合模型,接下来要解决两个问题:怎样得到可相加的得分,怎样确定权重。
数据表可以让我们讨论本月四点的相对表现,却不能直接决定下一处设施该建在哪里。后一个问题还需要位置、造价与覆盖范围等新信息。把问题收窄,正是为了让模型的输入与要回答的问题对应起来。
本期计算路线
X → Z → P → e → d → w → S
字母依次表示:X是原始值,Z是同向得分,P是列比例,e是熵,d是差异系数,w是权重,S是综合分。
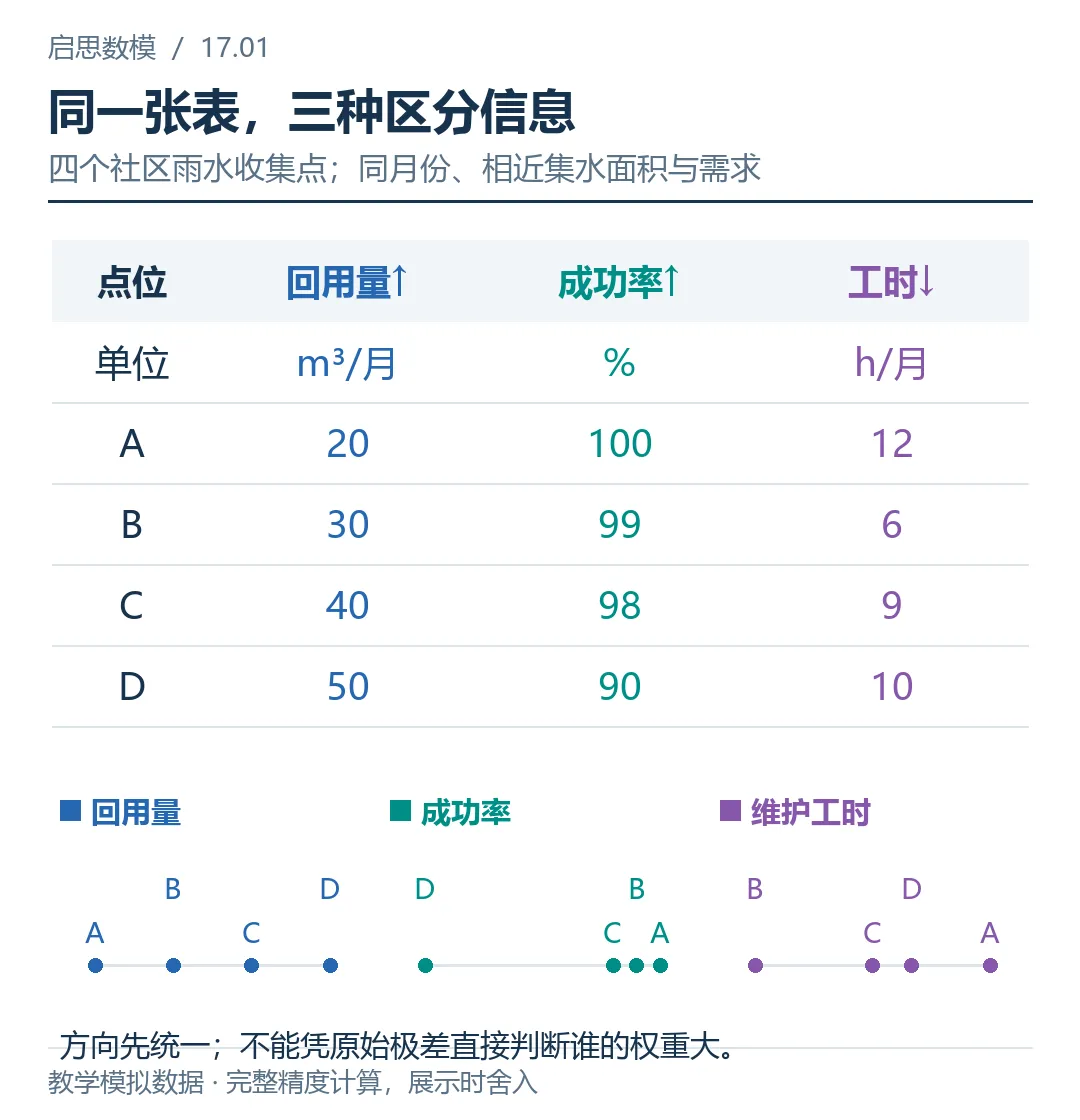
图1|同月、相近规模的四个雨水收集点。全部数值为教学模拟;箭头表示评价方向。
二、X→Z:先统一方向和尺度
20立方米、100%和12小时不能直接相加。本期采用同向极差标准化,把每列的最弱表现映射为0、最优表现映射为1,中间值按在两端之间的位置换算。这样三列都变成“越大越好”的无量纲得分。
越大越好的指标
zᵢⱼ=(xᵢⱼ-本列最小值) ÷ (本列最大值-本列最小值)
越小越好的指标
zᵢⱼ=(本列最大值-xᵢⱼ) ÷ (本列最大值-本列最小值)
以回用量为例,最小20、最大50,极差为30。A、B、C、D依次换算为(20-20)/30、(30-20)/30、(40-20)/30、(50-20)/30,即0、1/3、2/3、1。维护工时方向相反,B用时6小时最少,所以得到(12-6)/(12-6)=1。
同向极差矩阵 Z
这里的0只表示处在本组这一列的低端。A仍回用了20立方米雨水,D仍完成了90%的供水请求;它们并没有“毫无价值”。标准化也隐含了一项假设:在本次比较的范围内,得分随原指标线性变化。
这里还做了一项建模选择:每列都用本组最小值与最大值作参照,给满0到1的区间。若真实任务有明确的达标线或饱和点,例如超过某个水平后收益增长很慢,就应另建有实际含义的评分函数。本期先固定这条线性规则,再研究数据怎样生成权重。
当某列最大值等于最小值时,分母为0,这一列无法按此式转换。我们将在练习中处理这种情形,不用随意添加小数来掩盖问题。
三、Z→P→e:把一列差异写成熵
下一步逐列计算比例。每个z除以自己所在列的总和,得到p。回用量列的和为2,成功率列为2.7,维护列为11/6。得到的P每列合计为1,表示计算用的份额,并不是各收集点获胜的概率。
可以先做一道小检查:B的维护比例是1÷(11/6)=6/11,C是(1/2)÷(11/6)=3/11,D是(1/3)÷(11/6)=2/11,加上A的0,恰好合计为1。不同列各算各的比例,不能把整张表的所有数加在一起当分母。
列比例
pᵢⱼ=zᵢⱼ ÷ (z₁ⱼ+z₂ⱼ+…+zₙⱼ)
列比例矩阵 P
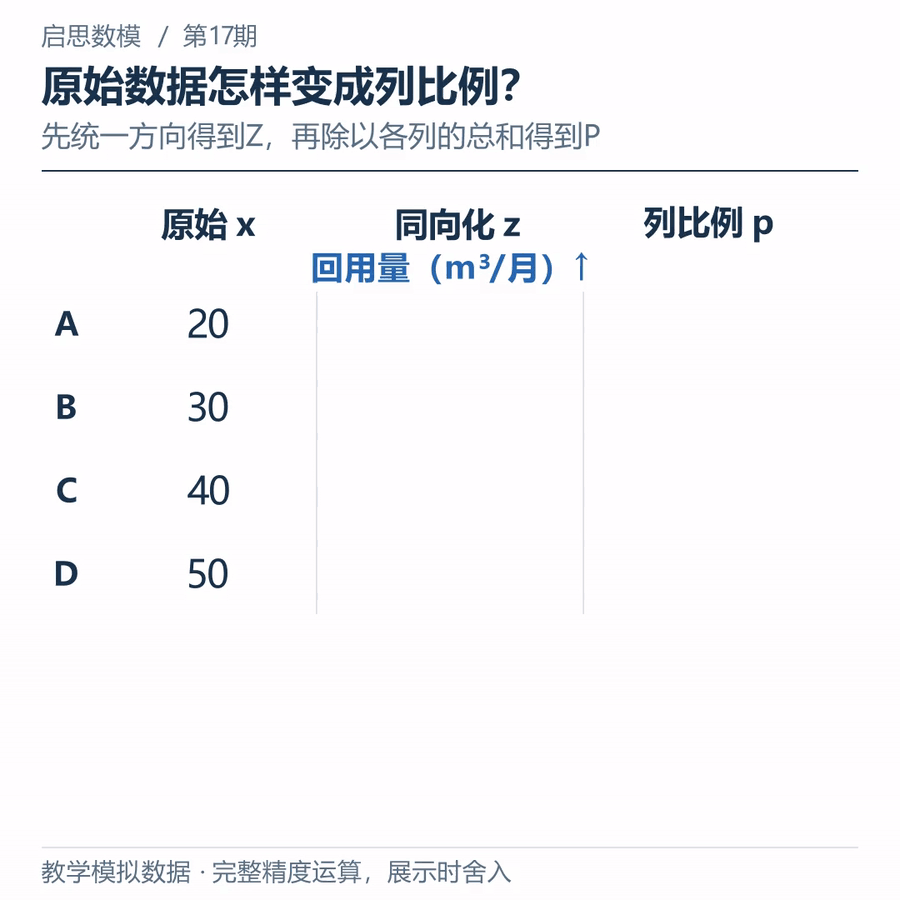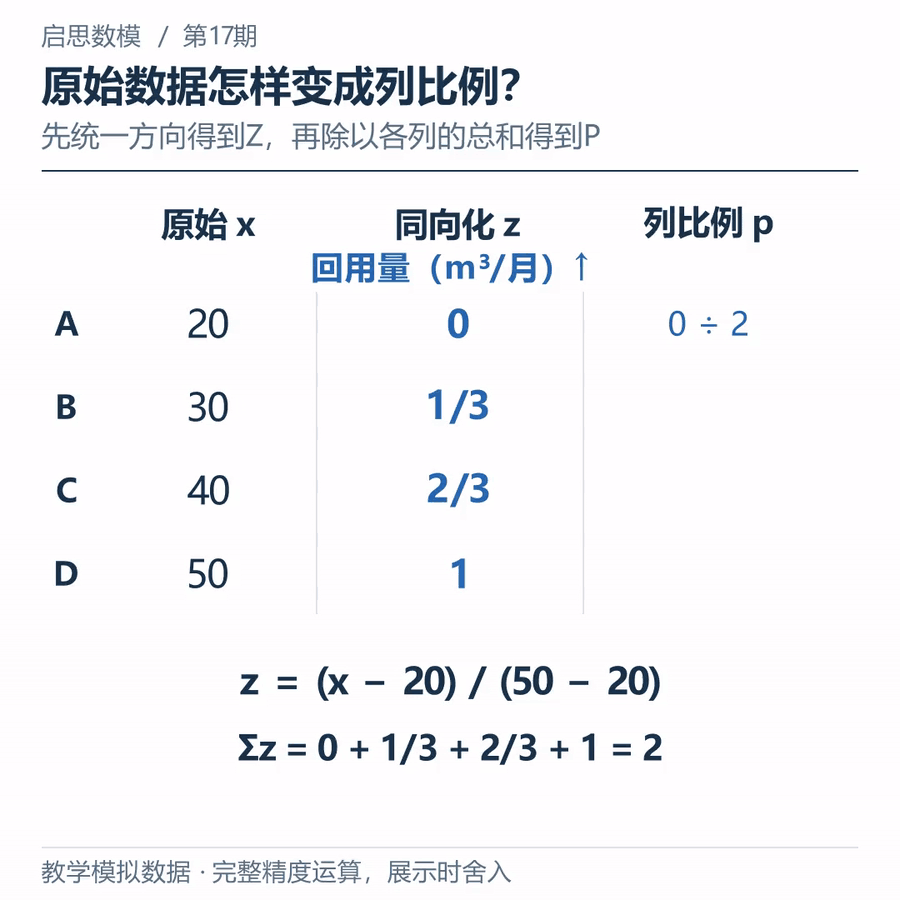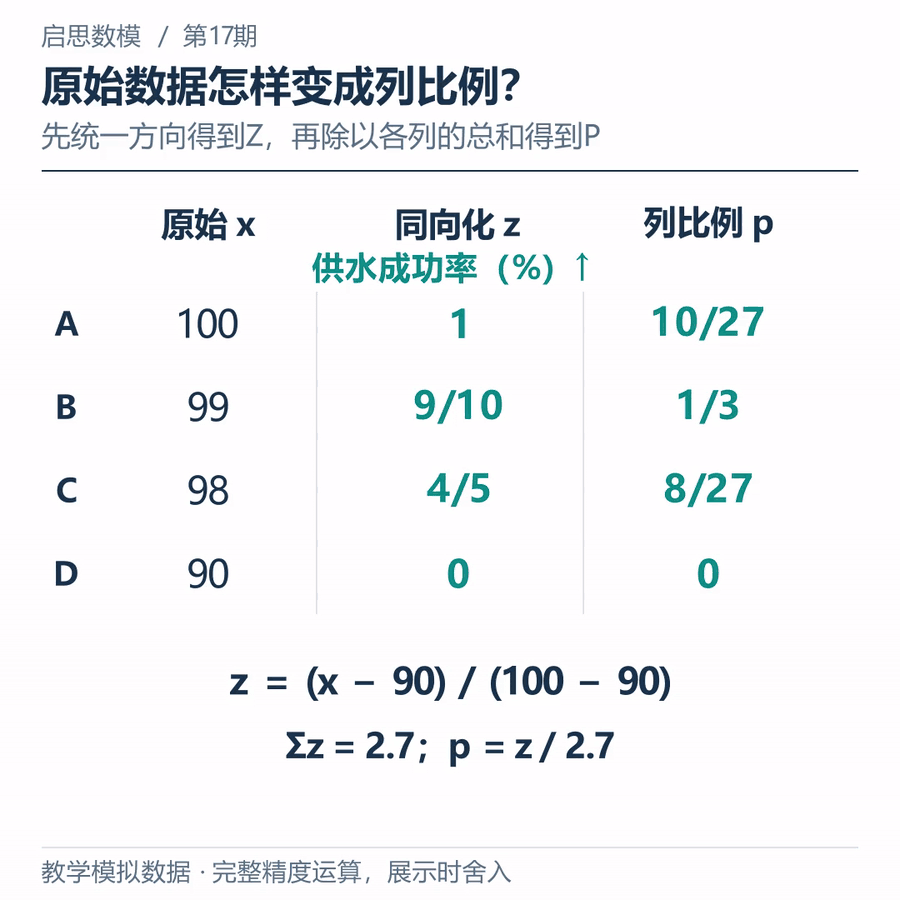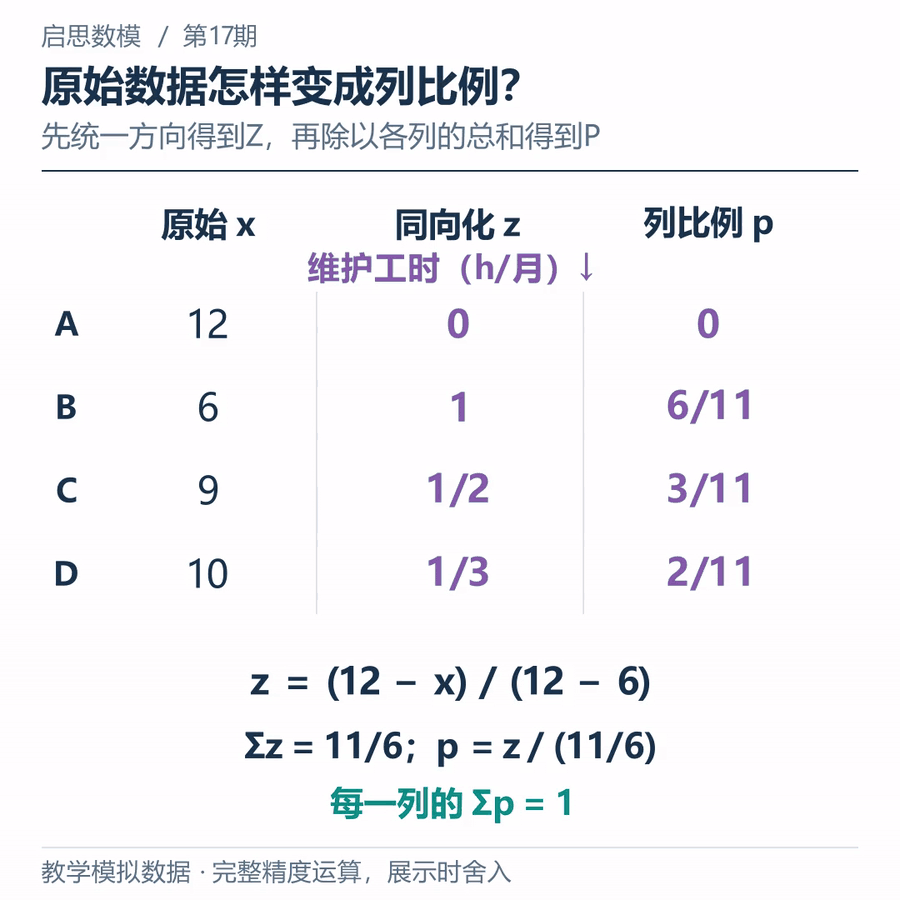
图2(动画)|三项指标逐列完成x→z→p:回用量示范先减20、除30;维护工时先反向处理,再按各列总和求比例。
如果一列比例全是1/4,四个对象分到的份额相同,这列就不能区分它们;比例集中在少数对象上时,区分就更明显。信息熵能刻画这种均匀程度:分布越均匀,熵越高。[1]
标准化熵值
eⱼ=-[p₁ⱼln(p₁ⱼ)+…+pₙⱼln(pₙⱼ)] ÷ ln(n),本例n=4
ln是自然对数,可以使用科学计算器的ln键。它在这里把各个比例转化成可相加的量;除以ln(n),使标准化熵处在0到1之间。对任意四项比例,完全均匀时e=1,全部集中在一项时e=0。
遇到p=0,按极限约定把整个p×ln(p)项记作0,计算时跳过这一项。注意,这不表示ln(0)有定义。回用量的四个比例已知,可以完整展开:
用计算器时,可以先求1/6的对数,再乘回1/6,记录一个完整的乘积;三项算完再相加,最后取负并除以ln(4)。不要只把对数相加,也不要把每项过早截成两位小数,后者会让最后的权重和得分出现不必要的误差。
回用量列完整代入
e₁=-[0+(1/6)ln(1/6)+(1/3)ln(1/3)+(1/2)ln(1/2)] ÷ ln(4)
每项算完再求和
e₁≈-[0-0.2986266-0.3662041-0.3465736] ÷ 1.3862944 ≈ 0.729574
同样计算成功率与维护两列,熵值分别约为0.789507、0.717686。本例成功率列的三个非零份额比较接近,因此熵略高。这里比的是处理后的比例分布,不能拿“相差30立方米”和“相差10个百分点”直接比较大小。
上面“全为1/4”用来说明熵的一般性质。采用本期极差标准化时,每个非常数列至少有一个0,所以实际比例不会恰好全为1/4。我们仍用同一熵公式比较三列,不把某个熵值解释为设备故障概率或服务达标率。
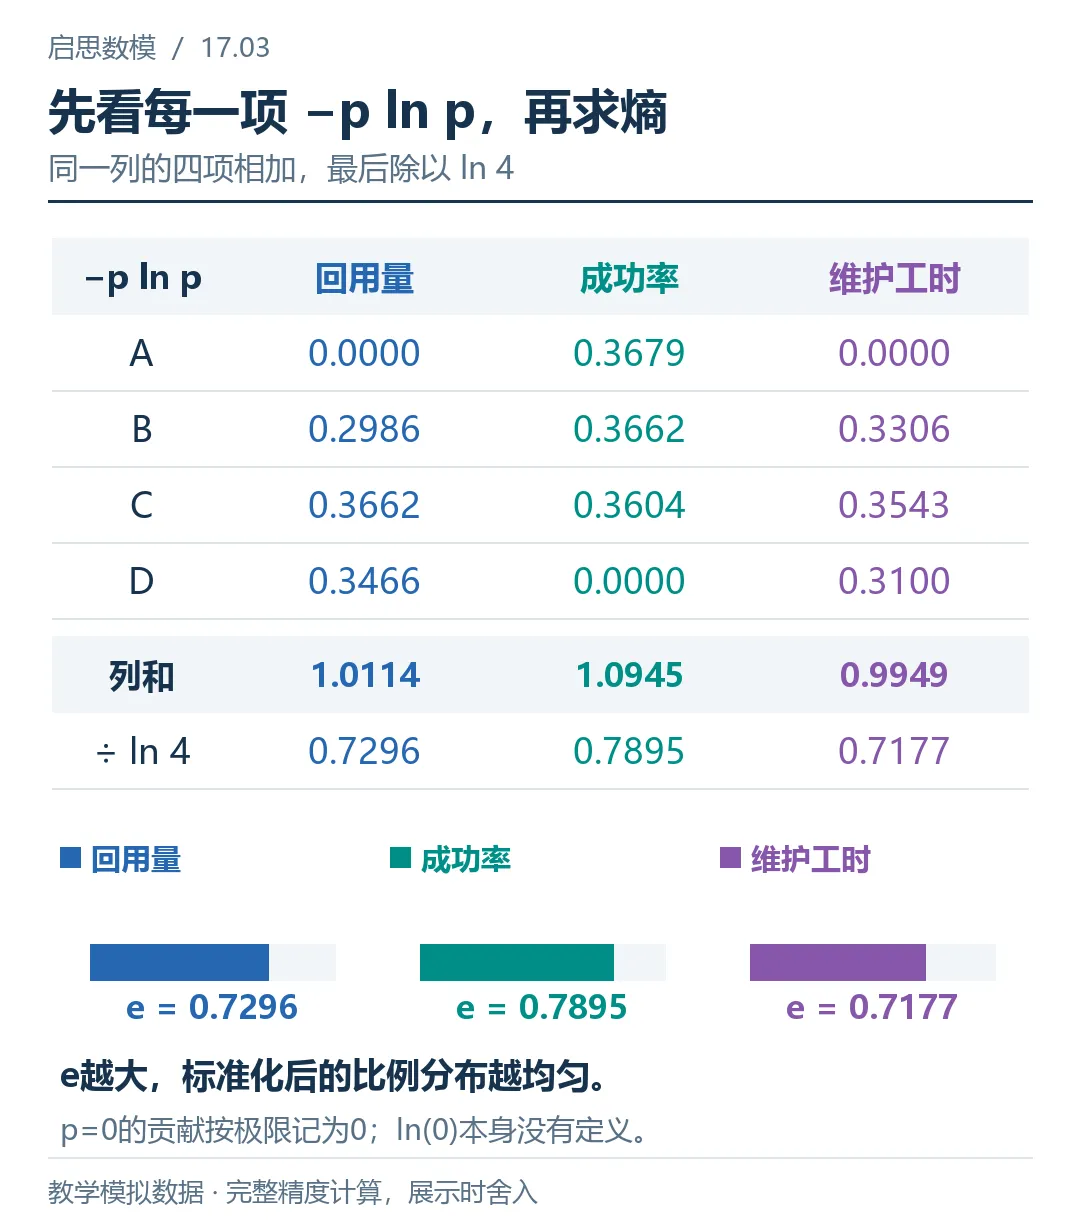
图3|实际三列比例及熵值:看分布如何进入计算,不把原始单位的差直接当作信息量。
四、e→d→w→S:算出权重和综合分
熵权法把“越均匀、越不容易区分”的方向转过来,定义差异系数d=1-e,再把三项d归一化为权重。权重越大,表示该列在当前处理方式下提供的区分信息越多。[2]
差异系数与权重
dⱼ=1-eⱼ;wⱼ=dⱼ ÷ (d₁+d₂+d₃)
从熵值到权重
三个d的和约为0.763234。例如回用量权重为0.270426÷0.763234≈0.354316。三项权重之和为1;再将每个点的标准化得分Z乘上对应权重并相加,得到综合分S。注意:P用于计算熵,最终评分使用Z,两张表不能混用。
综合评分模型
Sᵢ=w₁zᵢ₁+w₂zᵢ₂+w₃zᵢ₃
B的完整得分
Sᴮ≈0.354316×(1/3)+0.275792×0.9+0.369892×1
分项贡献相加
Sᴮ≈0.118105+0.248212+0.369892≈0.736210
综合分与排序
因此排序为B>C>D>A。B的回用量居中,但成功率较高、维护最省时,后两项共同拉高了总分。A只在成功率占优,另两项落在本组低端,所以综合分较低。计算全程保留精度,表格最后才四舍五入。显示值相加可能有末位舍入差。
评分时还可检查两件事:三项权重都不为负且合计为1,因此每个综合分应落在0到1之间;图中各点的未舍入分项相加,应等于该点未舍入的总分。若不符合,就优先检查指标方向、列分母,以及是否误把P拿去评分。
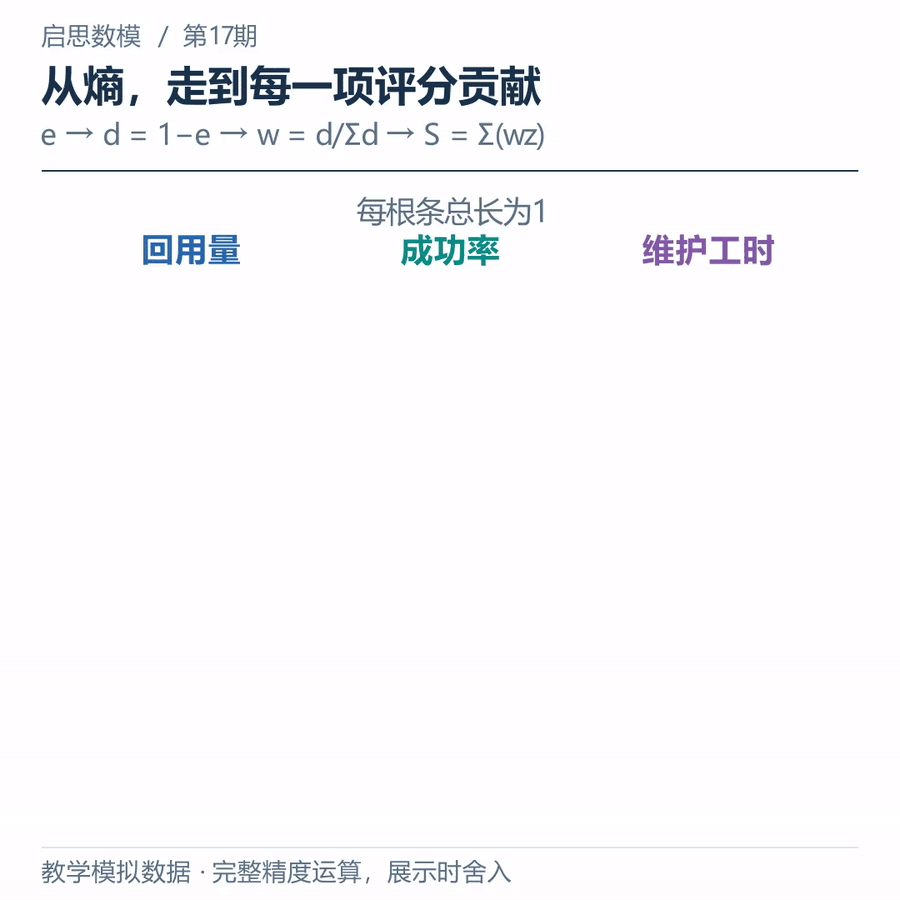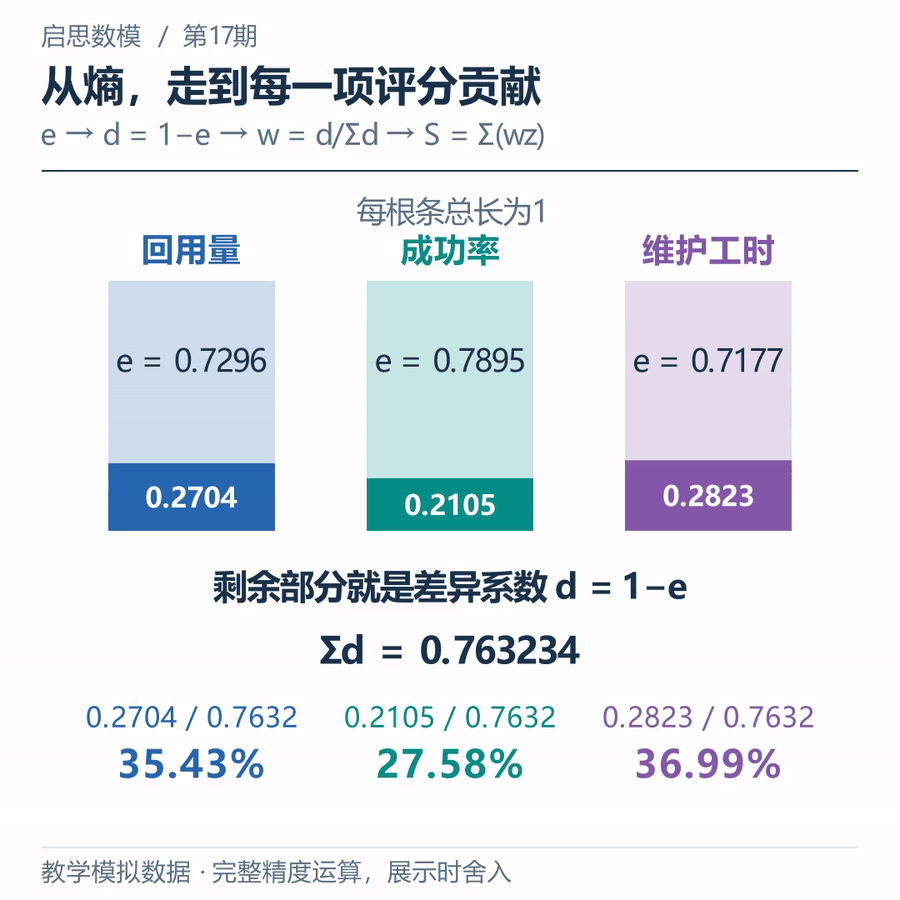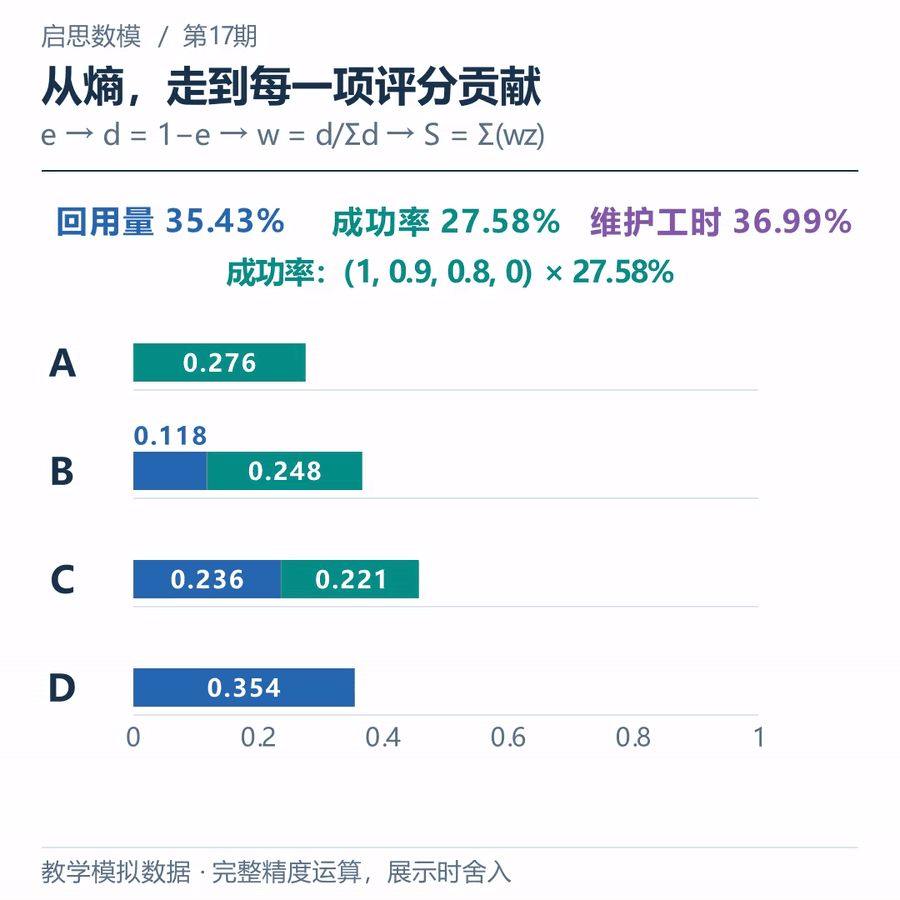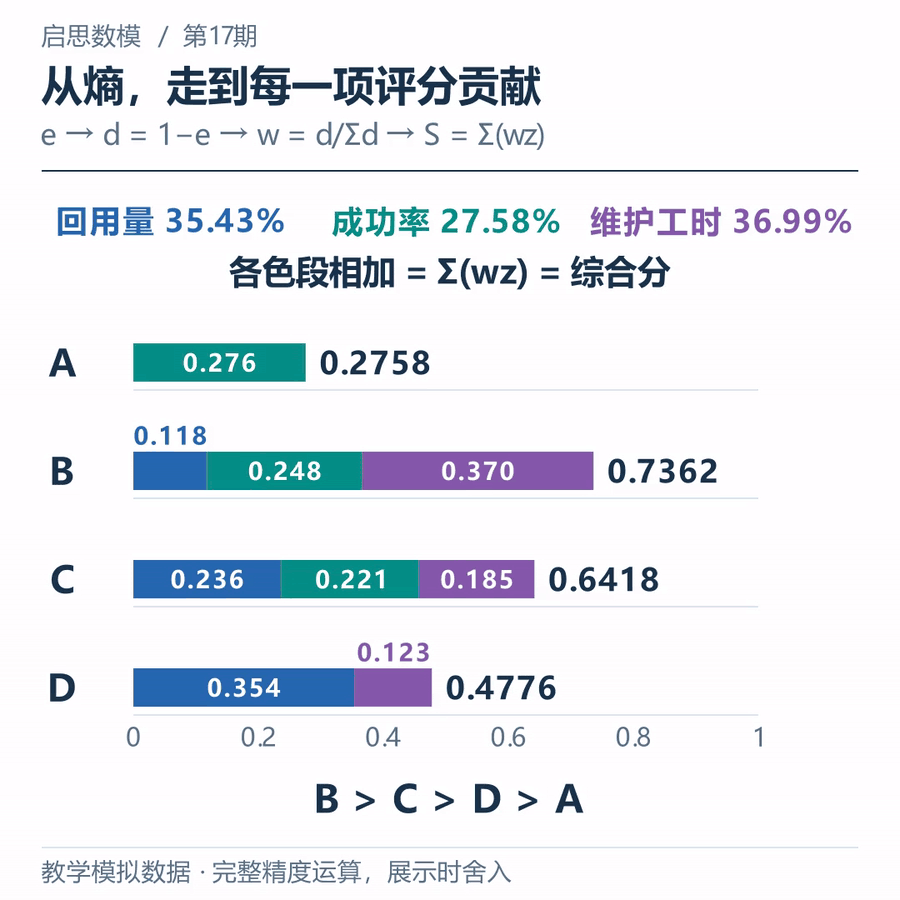
图4(动画)|同一组数据的e→d→w,再将权重分配到四个点的三项贡献,最后合成综合分。
五、用等权模型做一次对照
得到一张榜单还不够。把三项权重都设为1/3,其他数据和标准化规则保持不变,就得到最简单的对照模型。我们要检查:换一种合理的赋权方式,结论究竟变了多少?
等权评分
Sᵢ(等权)=(zᵢ₁+zᵢ₂+zᵢ₃) ÷ 3
两种权重,同一矩阵 Z
两种方法都排出B>C>D>A。B领先C的分差,等权时约为0.088889,熵权时约为0.094420。因为维护权重从1/3增至约0.369892,B在维护上的优势得到稍多支持;同时回用量与成功率的权重也一起改变。
这项对照支持一个有限判断:在等权与本例熵权这两种设置下,冠军与完整排序相同。它没有证明熵权一定更准确,也没有证明任何权重下B都会第一。若管理者已有明确的服务优先级,应把那项要求写进模型,而不是仅凭这次排序一致就忽略它。
指标之间的关系也值得检查。例如,把回用量与由它乘固定水价得到的节水金额同时纳入,会把同一类信息重复计入。熵权计算能给出两列的权重,却不会自动提醒你它们其实来自同一份记录;指标选取仍然需要对现实问题的理解。
还可以从代数上看清B为什么领先C:B的回用量得分比C少1/3,成功率多0.1,维护多0.5。因此二者分差可以写成下面的式子。右边为正就由B领先,为负就由C领先。
权重怎样影响B与C的比较
Sᴮ-Sᶜ=-w₁/3+0.1w₂+0.5w₃
代入本例熵权,三项贡献差约为-0.118105、+0.027579、+0.184946,总和为+0.094420。公式把“哪个优势补偿了哪个劣势”写清楚,也说明增加回用量的权重会压缩B的领先优势。
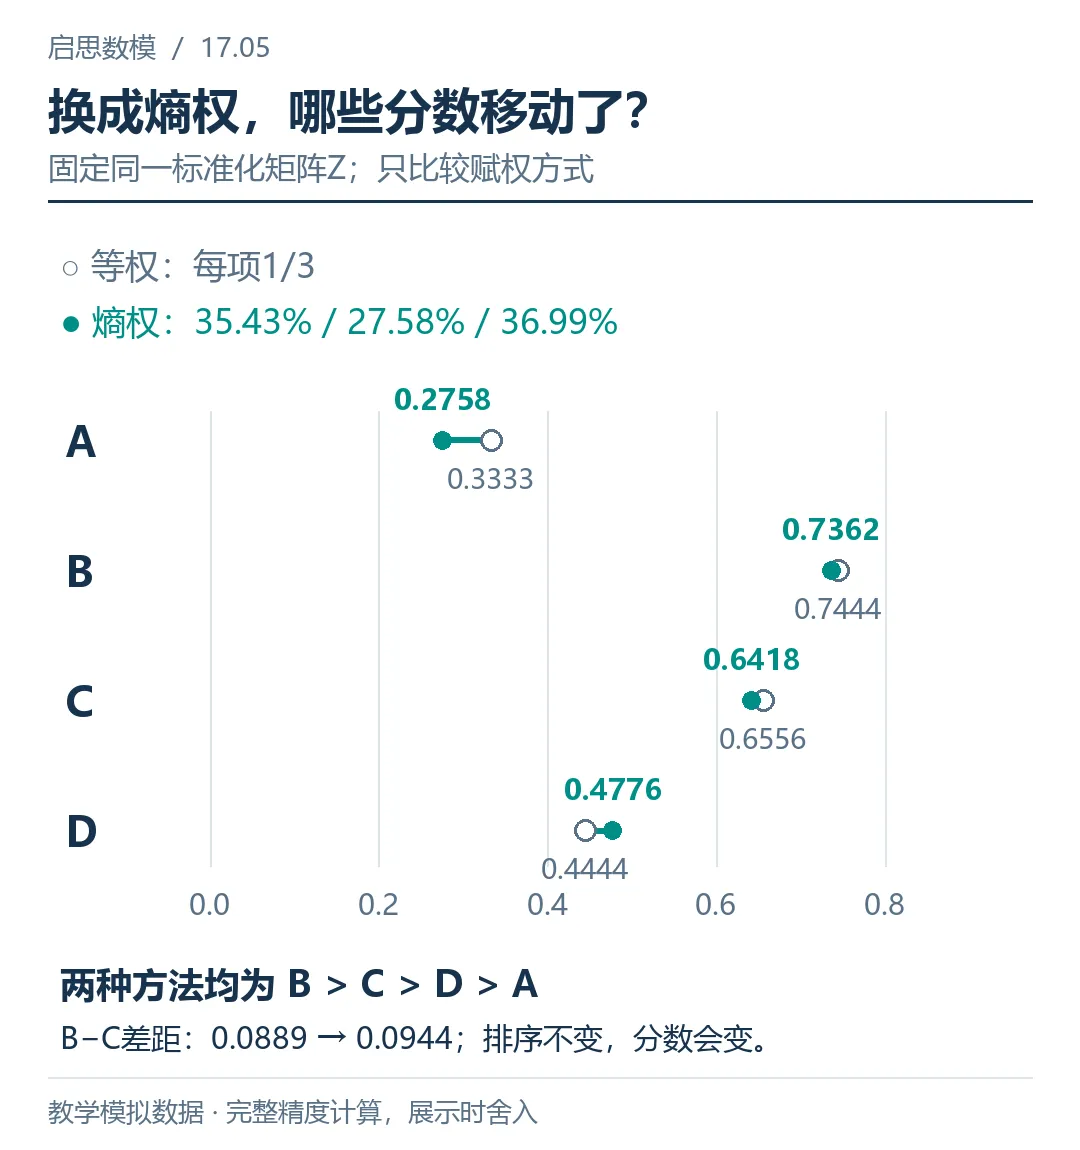
图5|等权与熵权的分数并列比较,标出B与C的分差;两套结果使用同一标准化矩阵。
六、删去D,模型还会给出同样的判断吗
再做一次样本扰动检验:暂时只比较A、B、C。这里不是认定D应该删除,而是追问,评价对象集合改变后,结论有多大变化。为避免偷换计算口径,必须从极差开始全部重算,不能沿用四点模型的标准化得分或权重。
现在回用量范围变为20—40,成功率变为98%—100%,维护工时仍是6—12小时。于是B的回用量得分从1/3变为1/2,成功率得分从0.9变为1/2;C的回用量成为新最大值,成功率成为新最小值。
删D后的 Z′
三列的得分和恰好都为3/2。逐列除以它,得到下面的比例;你会发现,三列都是0、1/3、2/3的不同排列。顺序改变不影响各项求和,所以三列熵值相同。
删D后的 P′
对象数改为3,熵的分母也要变
e′=-[(1/3)ln(1/3)+(2/3)ln(2/3)] ÷ ln(3) ≈ 0.579380
三项差异相同,因此等权
d′₁=d′₂=d′₃≈0.420620;w′₁=w′₂=w′₃=1/3
逐点重新评分
S′ᴬ=1/3;S′ᴮ=(1/2+1/2+1)/3=2/3;S′ᶜ=(1+0+1/2)/3=1/2
新排序是B>C>A,与原榜单中这三个点的相对顺序一致;B与C的新分差为1/6。结果说明,本次“删去D”的扰动保留了三点的名次,但权重、得分和分差都发生了变化。只能把它作为一次具体检验的证据,不能推广成“随便增删样本都不会影响排名”。
这类检验需要保留完整记录:删了哪个对象、重新计算了哪些量、比较了哪些结果。若在真实资料中发现某点的口径不同,应先依据资料决定能否纳入,再重新估计模型;不能为了获得喜欢的名次,反过来挑选样本。
A的分数从约0.2758变成1/3,也不表示它突然运行得更好了:原始记录一条没变,改变的是参照范围与计分尺。跨月份或跨地区比较时,如果每次都重新标准化,就必须留意这种尺度变化。
这次检验还没有涉及测量误差与月份变化。若要据此安排真实运维资金,下一步可以保留同样的指标定义,用其他月份的数据重复计算,观察结果是否持续;也可以对可能录错的数据作有依据的范围检验。单月教学数据能够展示方法,但不能替真实设施作长期结论。
七、差距缩小十倍,权重为何不变
另设一个情景,每点有1000次请求,成功次数为1000、999、998、990,成功率就是100%、99.9%、99.8%、99%。它不是对原表100次请求记录的改写。新极差只有1个百分点,原来则是10个百分点。
观察新旧数据:新成功率=0.1×原成功率+90。一般地,对正向指标作x′=ax+b且a>0的变换,最小值和最大值也按同一规则改变,代入极差公式可得:
缩放和平移在分子、分母中抵消
z′=[ax+b-(a·最小值+b)] ÷ [(a·最大值+b)-(a·最小值+b)]
约去a后
z′=(x-最小值) ÷ (最大值-最小值)=z
因此成功率列仍是1、0.9、0.8、0。对象集合、其余两列和处理方法不变时,后续P、e、d、w与综合分也全部不变。极差标准化保留了相对位置,却消去了这次绝对差距的压缩。
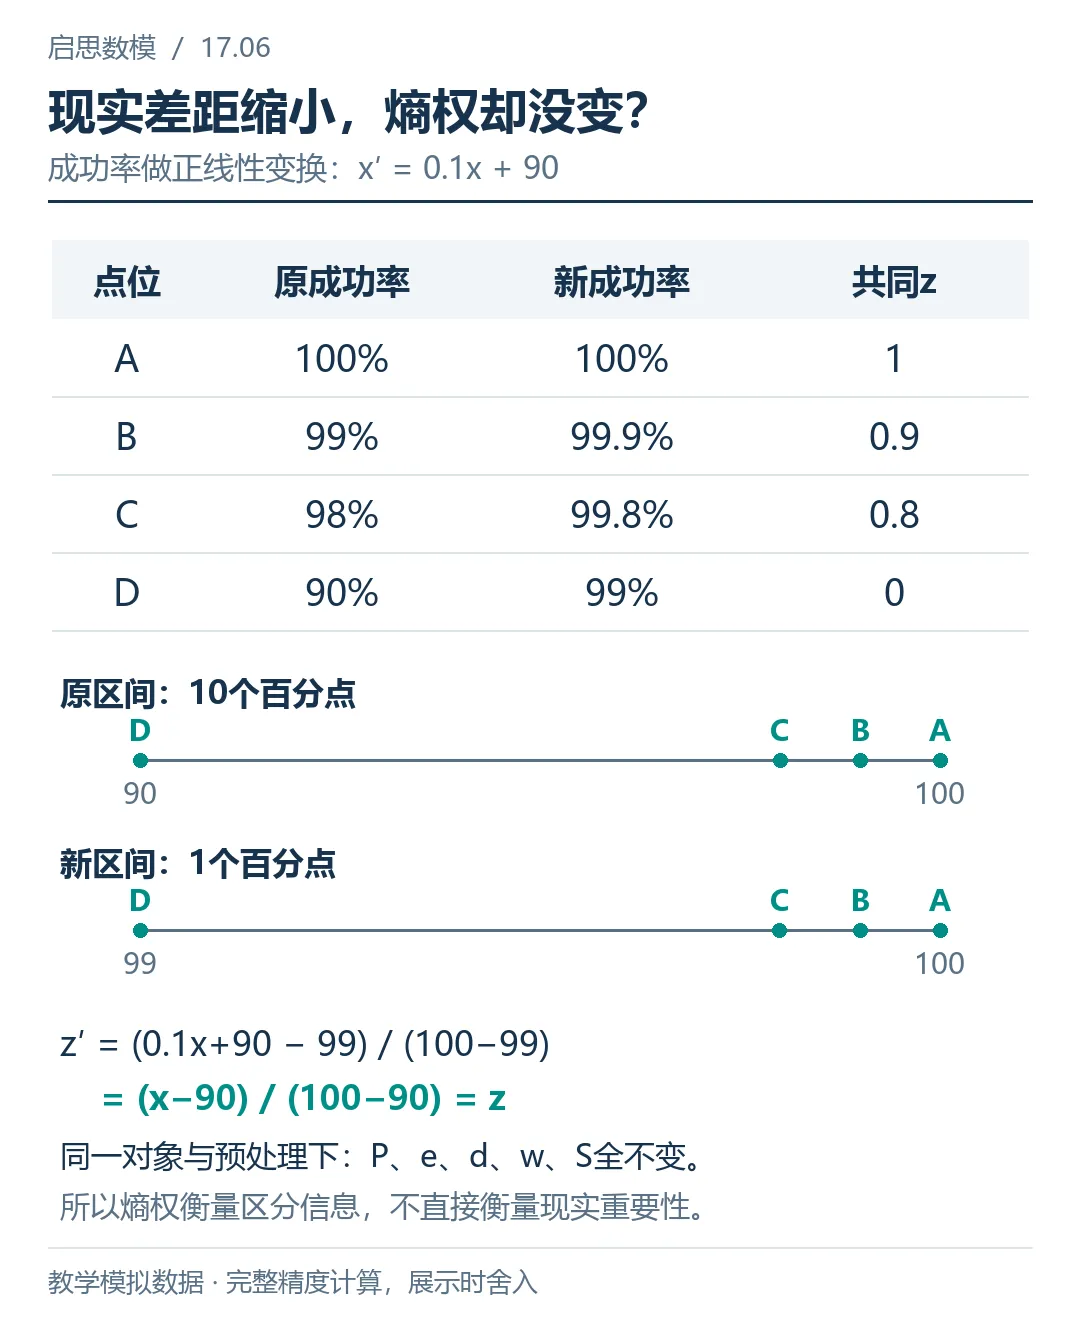
图6|10个百分点压缩到1个百分点,同向极差得分仍相同;图中同时保留两套真实刻度。
这正是“数据差异”与“价值重要”需要分开的原因。即使各点水质同样合格,水质仍可是一条必须满足的底线;它没能拉开名次,并不代表可以不重视。熵权回答的是选定样本和规则下如何利用差异,服务底线则应先作为约束,不能靠其他高分抵消。
八、留给你一道能算完的练习
保持原来的四个收集点,只把维护工时都改成每月8小时,另外两列不变。请先判断第三列怎样处理,再用前文的差异系数算出新权重、B和C的综合分,并给出四点排序。可以先遮住下面的答案试一遍。
参考答案:维护列极差为0,无法套用标准化公式;本题把它从区分性赋权中剔除。回用量与成功率的Z、P、e不变,只需将两项d重新归一。并不是给维护分配一个很小的假差异。
做题时尤其容易出现一个错误:把第三项权重直接删掉,却保留前两项原权重。这样两项之和只有约0.630108,已经不是约定的单位权重和。重新归一既保持两项之间的比例,又让新的综合分回到同一0到1区间。
新的两项权重
w₁=0.270426/(0.270426+0.210493)≈0.562310;w₂≈0.437690
B与C的得分
Sᴮ≈0.562310/3+0.437690×0.9≈0.581357
Sᶜ≈0.562310×(2/3)+0.437690×0.8≈0.725025
A约为0.437690,D约为0.562310,所以新排序为C>B>D>A。B原先在维护上的优势消失了,C的回用优势变得更有影响。若所有列都相同,这些数据本来就不能区分名次,不必强行让熵权法给出冠军。
一份能解释的建模结果,既要留下原数据与假设,也要交代标准化、权重、得分和检验。读者可以沿着X→Z→P→e→d→w→S复算,才能看出结论依赖哪些选择,以及条件改变后该从哪一步重来。
启思数模|把现实问题,一步步做成数学模型。
参考资料
[1] Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27(3), 379–423.DOI:10.1002/j.1538-7305.1948.tb01338.x
[2] Chen, P. (2019). On the Diversity-Based Weighting Method for Risk Assessment and Decision-Making about Natural Hazards. Entropy, 21(3), 269.DOI:10.3390/e21030269