ARTICLE · 1223309
MOSS-Image 源码精读:排版与布局共用一条文本通路,开源文生图怎么补上长文本渲染
往一张图里塞 1300 字的说明文字,还要求每块内容落在指定位置——这两件事,开源文生图模型长期做不好。OpenMOSS 10 月 16 日开源的 MOSS-Image,在自建长文本渲染基准 LLTB 上把平均覆盖率做到 96.3%,同一张表里 FLUX.2 只有 11.8。仓库五天攒下 1166 个星标,我把技术报告和代码读了一遍。
01 先看结论
MOSS-Image 是 MOSI Intelligence 联合复旦、上海交大团队从零预训练的 5B 文生图模型,技术报告与代码同日放出,权重开在 HuggingFace。它瞄准的是信息密集图形:海报、信息卡、带成段文字的插图。
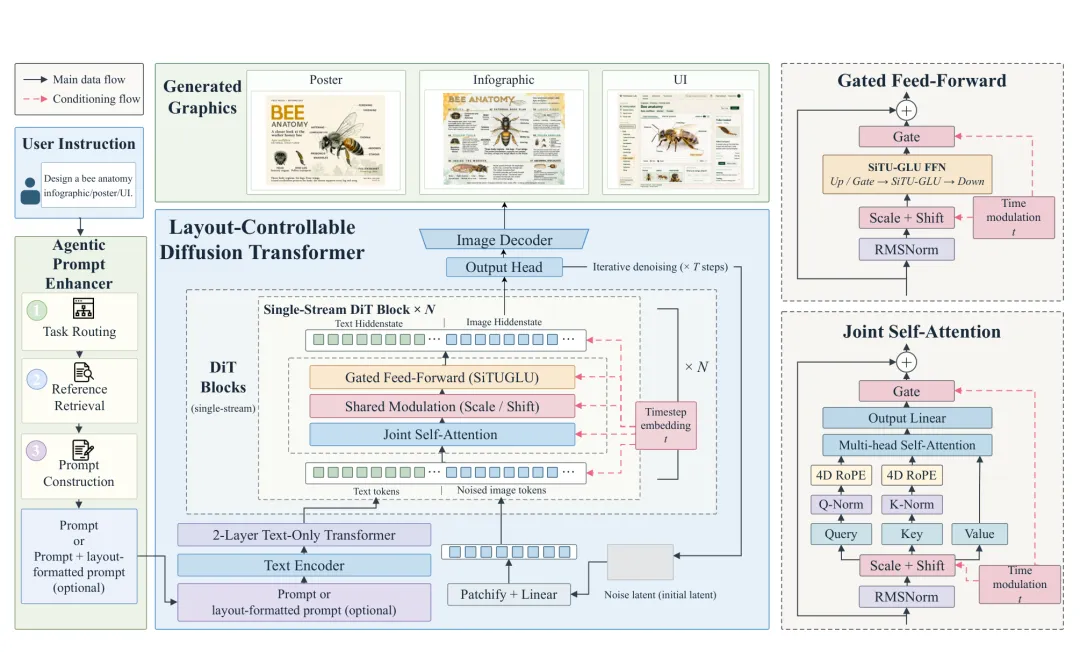
模型改了两处。骨干侧,5B 单流 DiT 让自然语言描述和结构化 layout JSON 走同一条文本条件通路,不另设控制接口;推理侧,配了一个提示增强模块,把「帮我做张海报」这类短请求补成内容加布局的完整规格。
数字按论文口径:LLTB 长文本渲染平均覆盖率 96.3,开源第一,比 Qwen Image 2512 高 31.4 个百分点;7Bench 布局控制 mIoU_det 0.88、AUC 0.70,闭源的 GPT Image 2、Nano Banana Pro 都停在 0.3 上下;真实设计请求盲测 RLA 拿 1698.7 Elo 排第二,前面只有 GPT Image 2。
停在什么条件:骨干只做文生图,不支持参考图条件输入,也不支持图像编辑,作者把这两项列为未来工作;提示增强依赖外部的 GPT-6,它的错误会顺着规格传进画面。想快速上手,只看一个文件就够:HF 权重仓里的 pipeline_moss_image.py,模型定义、调度、采样默认全在这一个文件里。
02 问题背景
信息密集图是文生图模型的照妖镜。论文第 1 节把短板拆成两个词。渲染:长文本一多就乱码、缺笔画,空间约束也听不懂;规格化:一句「画张极简风格的活动海报」,内容、信息层级、空间组织全靠模型自己猜,猜出来的常常不是你要的。
闭源系统已经把这两件事做了:GPT Image 2、Seedream 5.0 Pro、Qwen Image 3.0 Pro、Nano Banana Pro 都能稳定出带排版的图。开源这边,能力停在「画得好看」这一层,一到成段文字就露怯。
现有基准还测不出这个缺口。LongTextBench 每个渲染目标平均只有 120.3 个字符,各家模型挤在 96–99 分之间看不出差距。团队为此建了 LLTB:中英各 120 个任务、三档长度、平均每个目标 1339.8 个字符,量级是前者的 11 倍。布局控制是另一条短板,后面 7Bench 的数字会看到更夸张的差距。
03 方法拆解
整个系统是二件套:会画画的骨干,加会做规划的 agent。骨干从零预训练,文本条件通路的设计是贯穿项——layout JSON 直接以文本形式拼进条件序列,预训练数据里同时混着自然语言 caption 和带边界框的结构化描述,推理时两种写法随意混用。
第一个设计是门控前馈 SiTU-GLU。论文第 3 节公式 1 给出:门控值域无界时训练不稳,于是对 gate 路径和 up 路径各套一顶平滑帽 c_β(v)=β·tanh(v/β)——帽内近似线性,帽外软截断。发布权重里 β_g 取 4.0、β_u 取 25.0,这个组件沿自 Kimi K3。
第二个设计是 4D 旋转位置编码,坐标轴是 (r, t, w, h)。t 是序列位置,w、h 是图像宽高;r 是参考索引,专门给将来的参考图条件生成预留的轴——当前没有参考输入,所有 token 的 r 恒为 0,该子空间不旋转。附录 D 用 1B 实验模型对四种坐标分配做了消融,互有胜负,团队仍保留专用 r 轴,赌的是将来扩展到参考图生图时不用改坐标系。
公式看附录 A.2 的流匹配损失(公式 3):网络 v_θ 在加噪 latent 上预测速度场,目标是噪声与干净 latent 之差 ε−z_0,时间步输入为 1000σ。损失按图像 token 数做归一化,文本 token 不计入,也没有额外的信噪比加权;Stage 2 起从逐样本归一化过渡到逐 token 归一化,多分辨率图像按有效 token 数加权。
04 源码对照
先说调用链。GitHub 仓库是推理侧:gradio_app.py 是演示入口,默认 1024×1024、shift 5.0、负分支跳层 22;ComfyUI 的原生实现在 comfyui/moss-image/ 目录;模型定义本体随权重放在 HF 仓,经 trust_remote_code 加载。
第一处对读:公式 1 的 SiTU-GLU,对应 pipeline_moss_image.py 里的 _situ:
def _situ(hidden, gate):return (4.0 * torch.tanh(gate / 4.0) * torch.sigmoid(gate)) * (25.0 * torch.tanh(hidden / 25.0))
两个 β 以字面常数写死在函数里,就是论文的 β_g 与 β_u。块内先经一个 ffn_up_gate 线性层输出双倍宽度,再 chunk 成 hidden 与 gate 两半——对应论文里 W_u x 与 W_g x 两条投影的合并实现;输出最后乘的 gate_f 来自 shared modulation 产生的六参数之一。这两个 β 是发布权重的固定结构常数,不是可调超参,ComfyUI 版 model.py 里的同款函数逐字一致。
第二处对读:公式 2 与附录 A.1 的 4D 坐标,对应 _RoPE.forward:
h, w = torch.meshgrid(torch.arange(height), torch.arange(width), indexing='ij')image = torch.stack((torch.zeros_like(h), torch.full_like(h, text_length), h, w), -1).flatten(0, 1).float()image[:, 2] -= (height - 1) / 2image[:, 3] -= (width - 1) / 2
四个分量依次是 r、t、w、h:r 全零,对应「无参考输入」;图像 token 的序列位填成 text_length,即图像排在文本之后;后两行减去尺寸一半,空间坐标以画布中心为零点。文本 token 那边只填 t 轴,其余轴不动。
顺带把发布默认也读了:调度器配置里 shift 5.0、训练时间步 1000;CFG 合并强制在 fp32 里做,哪怕 DiT 跑的是 bf16;负提示分支跳过第 22 块(zero-based,全 42 块)是默认开启的跳层引导。附录 D 的坐标消融、G.3 各基准的评测协议属于实验侧配置,与发布默认要分开读。
05 实验配置
数据:16 个公开图文源,5.5B 条记录筛到 3.2B。筛法是 SSCD 查重加自研 AI 图检测器;不做质量过滤——口号是「广泛保留,然后如实描述」,瑕疵图不删,把问题写进 caption。附录 B.2 专门验证过:加上过滤反而降分(DPG-Bench 82.420 到 82.411,OneIG 0.4363 到 0.3482)。
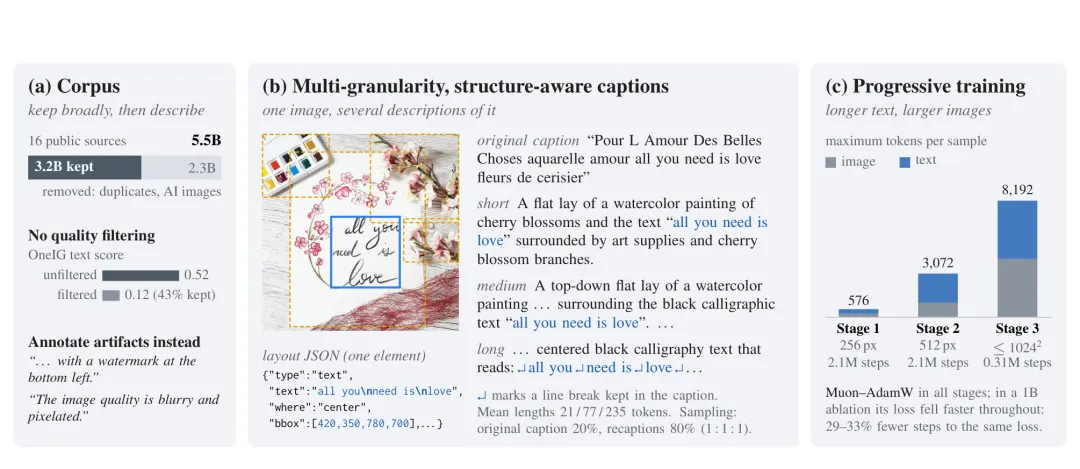
标注:每图短中长三档 recaption,token 均值分别为 20.9、76.6、235.1;生成 caption 与原 caption 按 20:80 采,三档各占三分之一;子集另标 layout JSON。
优化器:Muon 与 AdamW 混用——2D 矩阵走 Muon,embedding 与输出头走 AdamW。学习率统一 5e-5(RMS 对齐),AdamW 的 β 取 0.9/0.95,Muon 动量 0.95、迭代 5 步 Newton–Schulz;权重衰减 0.01,梯度裁剪 1.0,EMA 0.9999,warmup 2000 步。
调度:三阶段递进分辨率与文本长度,Stage 3 跑到 310,000 步取 EMA 权重收官;噪声采样按四段换挡——140K 步前 shift 3,之后 shift 1,207K 起加 cutoff 0.95,最后一段再混入 1% 均匀采样。
规模:512 设备、2 梯度累积,每次更新名义打包 878 万 token,单设备 microbatch 上限 8576 token。硬件型号论文没写,只说 512 台设备,README 徽章称异构 GPU 训练。冻结件:Qwen3.5-9B 文本编码器与 FLUX.2 VAE 全程不动。
最影响可比性的三条:Muon 混合优化(附录 E:到同一损失比纯 AdamW 少 28.6%–33.2% 更新步数)、无质量过滤的广保留数据策略、4096 token 文本上限。训练代码没有开源,GitHub 仓库只有推理侧,复训者能拿到的是 USERGUIDE 里的 recaption 提示词与标注 JSON 模板。
06 结果怎么看
LLTB(Table 4,覆盖率):MOSS-Image 六列 98.0、97.1、97.1、96.3、96.7、92.4,Mean-6 是 96.3。闭源组 GPT Image 2 99.0、Nano Banana Pro 96.6、Qwen Image 3.0 Pro 94.3、Seedream 5.0 Pro 55.3;开源组 Ideogram 4.0 63.5(中文长文本列只有 31.8,还受拒答拖累)、Qwen Image 2512 64.9、FLUX.2 11.8。
7Bench 布局控制(Table 14/15):MOSS-Image mIoU_det 0.88、Layout AUC 0.70;对照组包括全部闭源模型在内,mIoU_det 集中在 0.30–0.44,AUC 只有 0.16–0.20——这一项拉开了代差。
RLA 端到端(Figure 4c):61 个真实设计请求的盲测 Arena,MOSS-Image 1698.7 Elo 排第二;GPT Image 2 1844.4 第一,Seedream 5.0 Pro 1661.2、Qwen Image 3.0 Pro 加提示增强 1614.8 在后。
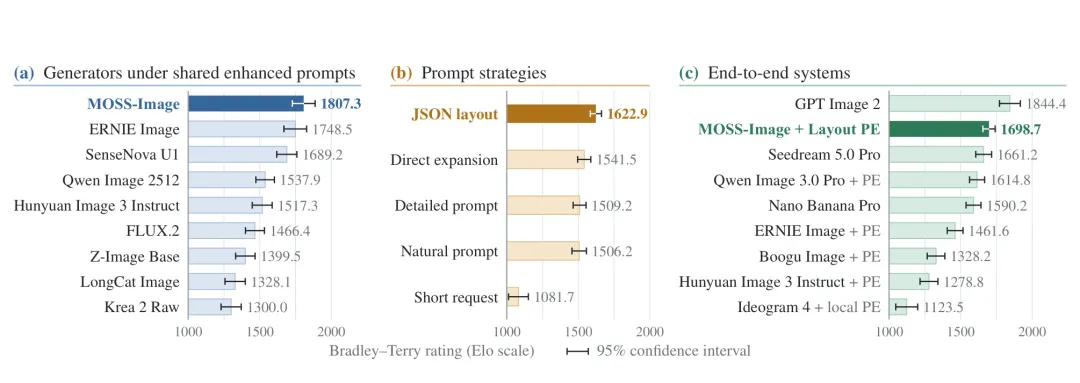
把提示增强拉平、只比骨干(Figure 4a):共享同一套增强 prompt,MOSS-Image 1807.3 Elo 第一,ERNIE Image 1748.5 第二。prompt 策略消融(Figure 4b):JSON layout 1622.9 高于直接扩写 1541.5、详细描述 1509.2、自然语言 1506.2,短请求只有 1081.7——规格给足与不给,差 500 多 Elo。
LongTextBench 上 MOSS-Image 97.63,与一众模型挤在 96–99,作者自己的判断是该基准接近饱和,这正是他们建 LLTB 的理由。以上全部是论文口径的数字,我没有跑。
07 论文与代码
已对应的部分:42 层主干、hidden 3072、24 头、FFN 8192、text adapter 的结构(4096 到 3072 线性投影加两个 text-only 块),在 HF 的 transformer/config.json 里一比一;SiTU-GLU、4D RoPE、跳层引导、移位调度,都能在代码里找到与论文逐字对得上的实现。
实现补充的部分:模型定义不放 GitHub 仓库而随权重走 trust_remote_code;ComfyUI 是仓库自带的第二套原生实现;README 的 News 区记着 SGLang、vLLM-Omni、ComfyUI 三个框架在开源当天跟进支持。
只是配置选择的部分:负分支跳层写 22、24、26 都有效,USERGUIDE 写明关掉它画面更写实但细节可能崩;CFG 在 3–6 区间都算推荐;评测协议(7Bench 用 shift 3 的 31 点网格)与发布默认(shift 5)是两套设置,读数字时别拿混。
08 复现路线
环境很轻:requirements.txt 里只有一个词 diffusers,配上 torch 与 transformers 就能跑。最小样例在 README 的 Python 一节,17 行代码出图,trust_remote_code 打开,DiT 跑 bf16、VAE 保持 fp32;想点按钮就起 gradio_app.py;ComfyUI 升到 master 原生可用,不用装插件。
成功标志:官方示例是一块玻璃板加三行中文手写的技术路线——中文长句不糊、笔画不缺,就算跑通了。
容易看错的三处。分辨率必须能被 16 整除(VAE 8 倍下采样乘 2×2 patch,每 token 摊 16 像素),差一个像素直接报错;layout 坐标是零点在画布中心的绝对像素(1024 画布范围 ±512),不是常见的 0–1000 相对坐标——附录 K 有对照实验,零中心绝对坐标对没见过的分辨率泛化更好;文本走 Qwen 的 chat 模板、带 think 起始符、超 4096 token 截断。社区侧已有 KohakuMossTrainer(最低 6GB 显存可训 LoRA)和 8 步蒸馏 LoRA,动手门槛比想象低。
09 判断
有证据的价值:把 layout 塞进文本通路,意味着控制能力不需要第二套接口,预训练数据里混着结构化描述就自然长出来了——7Bench 上 0.88 对 0.3 一档的差距,说明这条路对「控制」本身有效;长文本渲染 31.4 个百分点的差距是真实缺口,LLTB 把它量了出来;共享增强 prompt 下骨干单独比 1807 Elo 第一,底子经得起检验。
限制也摆在明处:不支持参考图与编辑,能力面比闭源四家窄一截;提示增强拴在 GPT-6 上,规格层的错误模型自己兜不住;训练代码与数据管线未开源,「开源」目前是推理与权重意义上的;LLTB 和 RLA 都是自建基准,自评自测的成分需要外部复验。
生态倒是不愁:五天 1166 星,三个推理框架当天适配,训练器与蒸馏插件两天内齐活,连玩家论坛都有实测帖在传。这个热度本身,就是技术报告数字之外最硬的一个信号。