ARTICLE · 1245008
AI 时代做产品交付,我想清楚了要给用户哪几样东西
本篇是「筱天的碎碎念和一些奇妙的思考」专题的第一篇。未来我会在这里持续更新自己在工作和学习中使用 AI 的思考与想法,主要是分享个人思考,也希望和大家交流讨论;后续也会针对这些思考,尝试做一些对应的解决方案与实际产出。
本次为什么会有这样的思考?
是我在开发一个律师个人工作台项目时遇到的一些问题,引发了本次的思考。作为一个开发者,我通过 AI vibe coding 可以快速产出一些功能,初衷本是为了提高律师的工作效率,但实际上却给律师带来了一定的学习成本(学习系统使用),而这与我的初衷背道而驰。
对于系统交付,如果按传统做法,通常只是提供一份单纯的用户手册。但在 AI 时代,我认为仅靠手册显然不够,而是应该引入一个答疑 Agent,以降低用户对系统的学习成本。
很多操作的前提,是用户必须清楚系统的各个板块分别在什么位置,才能快速点击定位并完成操作。比如导入当事人和案件信息,律师需要分别去“主体”板块和“案件”板块导入。
如果律师压根不了解系统原本的结构和设计,就很可能找不到功能在哪,甚至根本不知道系统还能做这件事。
因此,我开始思考:到底可以交付一个什么样的产品,才能让用户真正快速上手?
毕竟,在当前这个快节奏的时代,所有人都想用最短的时间掌握最有用的技能。但对我们系统交付来说,如果一个新的系统反而引发了巨大的学习成本,用户需要先付出较多成本才能真正投入使用,那我们的交付就必然不是一次好的交付!
Tian的奇妙小设想前置
交付的目标只有一个:降低用户了解我们系统的成本,不管他读不读用户手册,都要尽可能做到用户友好。围绕这个目标,交付时要给用户两样东西:
除此之外,开发者自己也需要同样的支持。同一个 Agent 分成两个人格,背后是两套做好权限隔离的知识库,用户的反馈也能通过它回到开发者手里。
一、学习成本:我们面对的是“我们产品的小白”
用户哪怕不是纯小白,但面对一个新系统时,他一定是个小白。我们所说的“小白”,应该是“针对我们产品的小白”。
所以我们的服务重点,就在于降低用户了解我们系统的成本,即使他读不读用户手册!
交付物一定需要一个用户手册,但经常只是一个用户手册又不够。第一,用户不一定会读;第二,就算读了,也有可能看不懂、不会用。
二、用户手册:必须带截图,按真实使用流程写
用户手册要带有截图,必须有截图才行,还要写清楚具体的系统功能。这样用户可以对照系统的实际情况看截图,在前端快速找到对应的位置。
同时,交付格式上应该用 HTML + PDF 两份:前者 HTML 可以作为知识库的材料,后者 PDF 方便直接交付给用户。
内容上,章节要从用户的真实使用流程来梳理,贴合实际使用场景。拿律师工作台来说,写用户手册时,就要按律师真实会走的顺序来写:
三、答疑 Agent:补手册没写全的地方
用户手册不可能做到面面俱到。手册里文字或图片写得不够详细、不够完善的地方,就用另外一份详尽描述各功能的文档作为知识库,搭一个可以随时和用户沟通的 Agent。用户使用某个功能时觉得莫名其妙、不理解,随时可以向它提问。
入口上,我目前的设计是两个:用户入口嵌在系统前端的对话窗口里,开发者入口是一个只有我能用的独立 bot。
我期望的效果是,用户问:
“我在这个用户手册里看到了第二章的第一节,里面提到了这个功能,但我没有找到它在哪里,也不太明白这个功能是什么意思?”
对于这类问题 Agent 可以快速、精准地回答。
但其实,答疑 Agent 也还存在问题:有时返回的内容过于专业(可能是从技术角度讲的专业)。比如我用 Work Buddy 配合 DeepSeek 模型时,经常返回一堆非常专业的术语,对不熟悉的人来说根本看不懂,对用户非常不友好。
什么是“说人话”
很多时候 Agent 的表达容易脱离实际操作场景。比如用户问怎么登录,或者登录后怎么找当事人页面:
这种细节差异,直接决定了律师会不会迷失在界面里,对用户体验影响极大。
如何让答疑 Agent 对用户真正友好,目前是一个卡点,我还没有具体的考量和设计实现,后续再展开。
四、开发者也同样需要这些支持
在现在 vibe coding 和 AI 开发的时代,系统和前端的开发进度往往比较快。开发者自己也容易不太熟悉当前系统设计了哪些细节和功能,很容易出现开发者和 Agent 认识口径不一致的情况。所以也需要同一个 Agent,或者说同一个 Agent 的两个人格,来服务开发者。
还是拿我在做的律师系统举例:
1. 开发者视角:知识库补齐与参数遗漏
在开发过程中,开发者往往记不全所有字段。比如配置案件信息时,我要求 AI 列全参数,但人工核对时很容易漏掉“法院地址”这种重要字段。
至于具体的开发技术细节,应该交给开发 Agent 去读。系统开发者只是承担一个系统方向指导的作用。
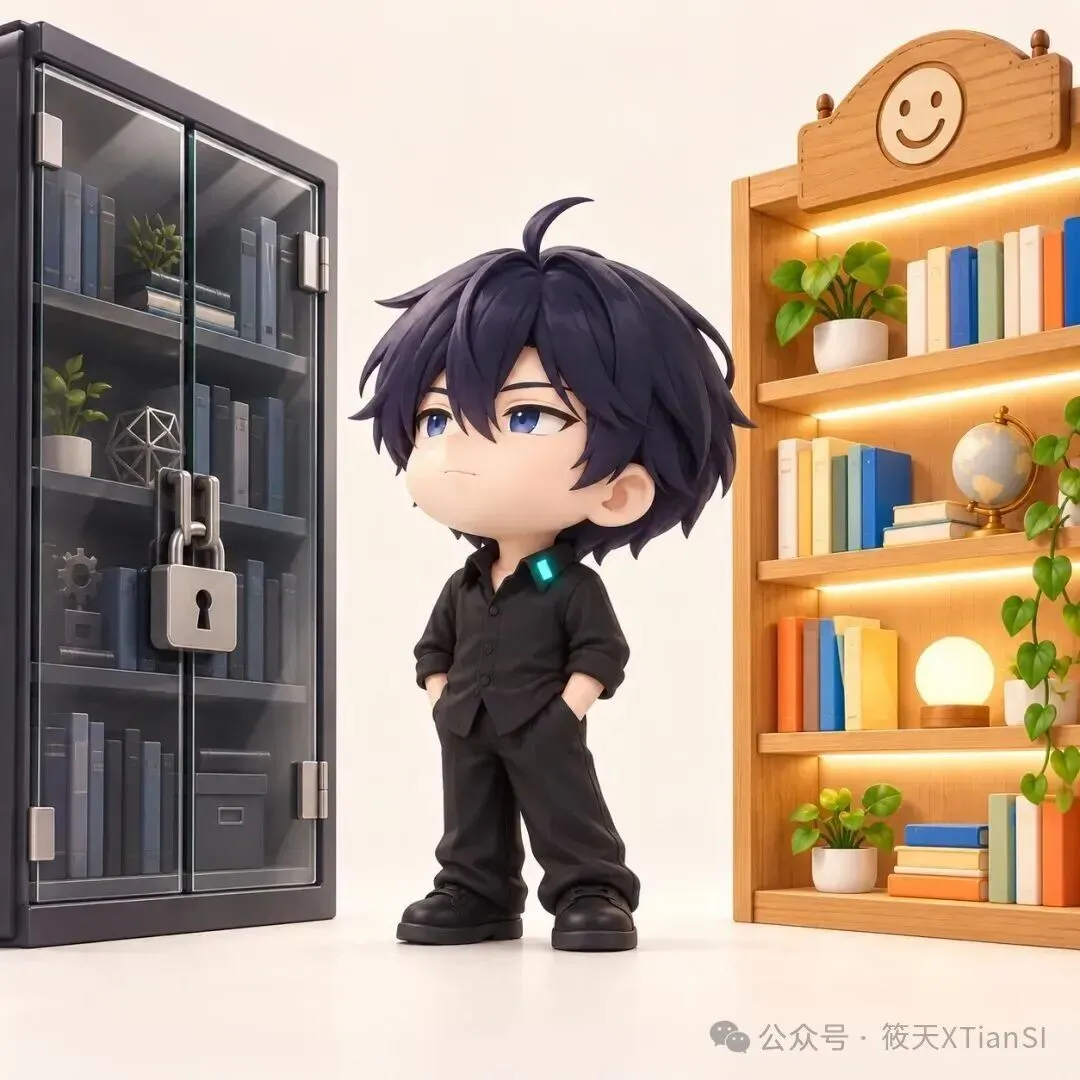
2. 对客与对内:两套知识库的权限隔离
由此引出两套知识库的边界划分:
3. 从用户反馈中反哺功能迭代
这里还有个有意思的思考,就是普通用户或律师在使用中如果反复遇到痛点,比如多次发现缺少法院地址,他自己可能缺乏系统的总结能力。
这时如果 Agent 能分析历史对话,主动识别出卡点,就可以提示他:
“检测到你多次需要此信息,系统目前暂未提供,是否需要帮你向开发团队提交反馈,申请加入‘法院地址’字段?”
用户同意后,和他深入沟通,确认清楚真实需求和痛点,自动整理成一份简洁高效的图文说明文档,转交给开发者,这样就能极大促进用户与开发者的沟通。
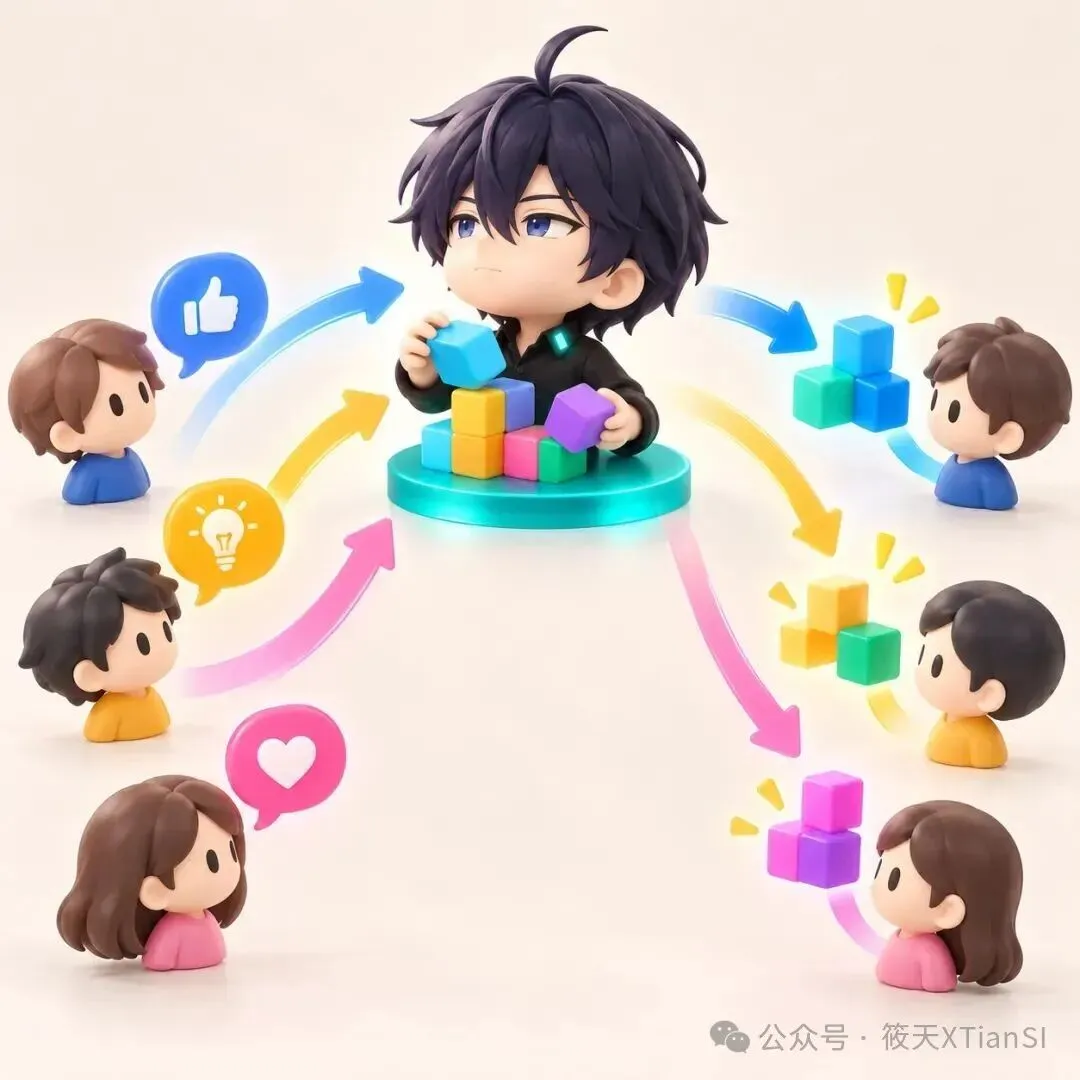
这里我想了两个版本。比如初版用邮箱,引导用户发反馈邮件;后续版本甚至可以做成系统内置的自动提交,但这个怎么实现还需要调研,而且要先征得用户同意,涉及到数据安全问题,毕竟用户的部分数据会被反馈给开发者。
但一旦实现,就能在用户和开发者之间形成一个良性的循环。
以上只是我浅显的举例,甚至可能不太恰当,经常使用 AI 的开发者肯定也遇到过很多类似情况,此处就不一一赘述。
写在最后
这样做既方便产品快速迭代,又对用户和开发者双方都友好,我觉得这是 AI 时代系统设计必备的要素。
以上主要是我现阶段的梳理和思考。试点测试正在做,不过还没有完全跑完,暂时拿不出真实的数据。后续如果有产出,我还会更新其他内容~
也欢迎有类似需求和想法的朋友在评论区多多交流~
这是「筱天的碎碎念和一些奇妙的思考」系列的第一篇,后续更新都会放在这个系列里,欢迎常来看看~