ARTICLE · 1247290
文档堆成山却没人翻?我用开源的 PandaWiki 搭了个能自己回答问题的知识库
先说个我自己的痛点。
我们团队的文档,认真讲不算少:产品说明、接口文档、FAQ,还有各种"踩坑记录",散在好几个地方。但真正会去翻的人不多。新人遇到问题,第一反应不是去搜文档,而是在群里 @ 老人;老人回文档里 Ctrl+F 半天,发现关键词对不上——文档里写的是"知识库配置",新人问的却是"怎么给文档分文件夹"。
写的时候很努力,用的时候没人看。这个矛盾挺普遍的。
后来刷 GitHub 时看到 PandaWiki(长亭科技开源的),吸引我的点就一个:它不是让你"存文档",而是让你"问文档"。你把手上的资料喂进去,用户用大白话提问,它从你的文档里找依据、给答案。
我不是这个项目的开发者,就是个普通使用者。下面是我自己用 Docker 跑了一遍之后的记录,外加翻了翻仓库和官方文档。凡是我不确定的,我都会明说,不硬撑。
一句话理解:传统 Wiki 像图书馆的卡片目录——你得先知道该找哪本书;PandaWiki 更像图书馆里多了一位读过所有书的馆员——你直接把问题丢给他就行。
一、它到底是干嘛的?30 秒版
PandaWiki 是一个"AI 大模型驱动的开源知识库搭建系统"。 拆开看就是两件事:先把文档管起来(这部分和传统 Wiki 差不多),再让 AI 把文档用起来。
它比普通 Wiki 多出来的,主要是三块 AI 能力:
- AI 问答
:用户提问,它从你的文档里找内容作答,还会标出参考了哪几篇; - AI 搜索
:不只是匹配关键词,而是尽量理解你"想找什么"; - AI 创作
:写文档时让 AI 帮你补内容、改措辞。
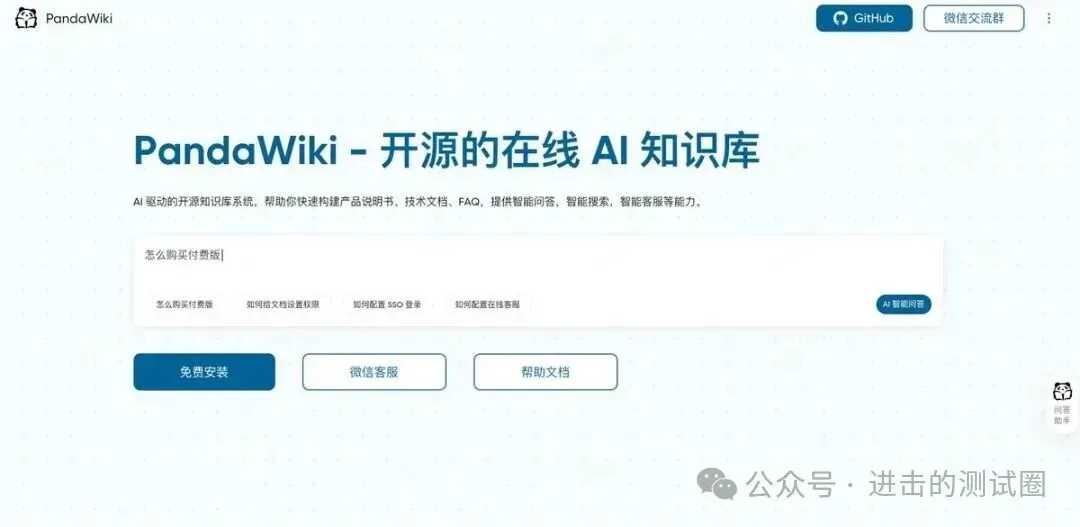
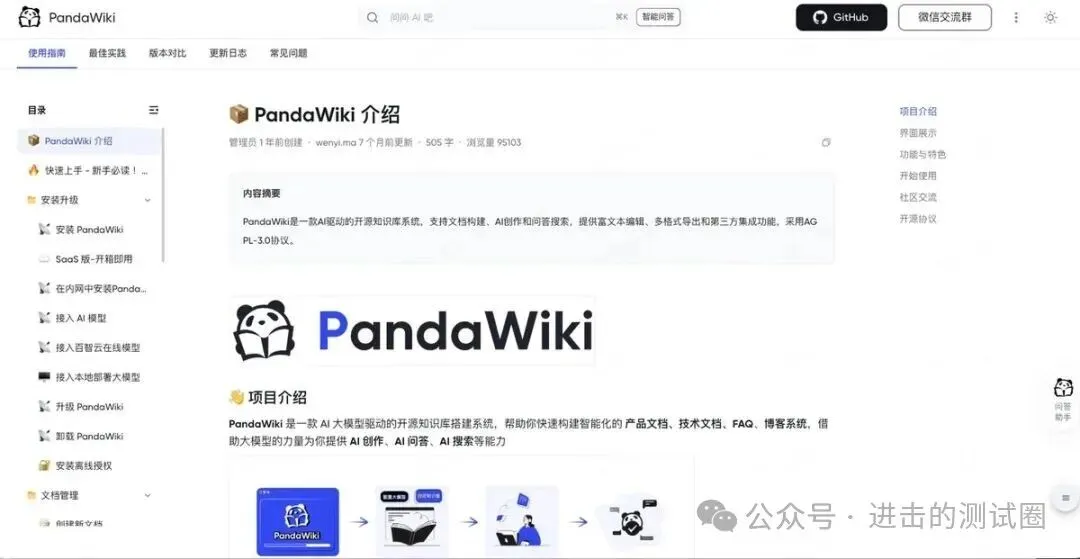
有个小细节挺有意思:PandaWiki 的官方文档站,本身就是用 PandaWiki 搭的,算是"自产自用"的样板。看首页就大概能感觉到它的重点在哪——中间那个搜索框,和右下角的问答助手:
几个词先垫一下,不然后面容易卡壳(文末还有一份完整速查表):
- 大模型
:就是 ChatGPT、DeepSeek 那一类"会说话"的 AI,这里负责把答案组织成人话; - 知识库
:说白了就是"一堆相关文档的集合",PandaWiki 会给每个知识库单独生成一个 Wiki 网站; - Wiki
:多人协作维护的文档站点,维基百科就是最出名的那个。
二、部署:一条命令的事
我原本以为要配一堆环境,结果安装就是官网给的一条脚本。用 root 跑:
# 用 root 权限执行官方安装脚本bash -c "$(curl -fsSLk https://release.baizhi.cloud/panda-wiki/manager.sh)"
跑完终端会直接把后台的访问地址和账号密码打出来:
SUCCESS 控制台信息:SUCCESS 访问地址(内网): http://*.*.*.*:2443SUCCESS 访问地址(外网): http://*.*.*.*:2443SUCCESS 用户名: adminSUCCESS 密码: **********************
拿浏览器打开那个 2443 端口的地址,就是登录页:
名词小抄 Docker:把软件连同它需要的运行环境一起打包成"集装箱",你机器上不用装一堆依赖,拉下来就能跑。这是 PandaWiki 部署这么省事的主要原因。
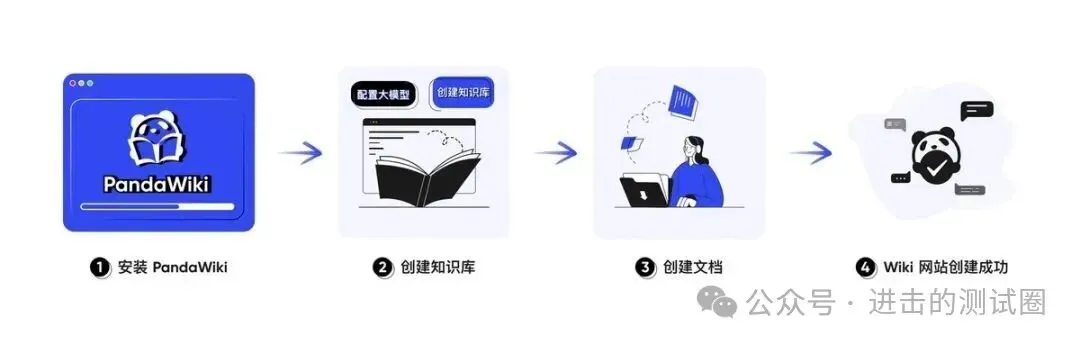
官方给的整体流程是四步,画得挺直观:
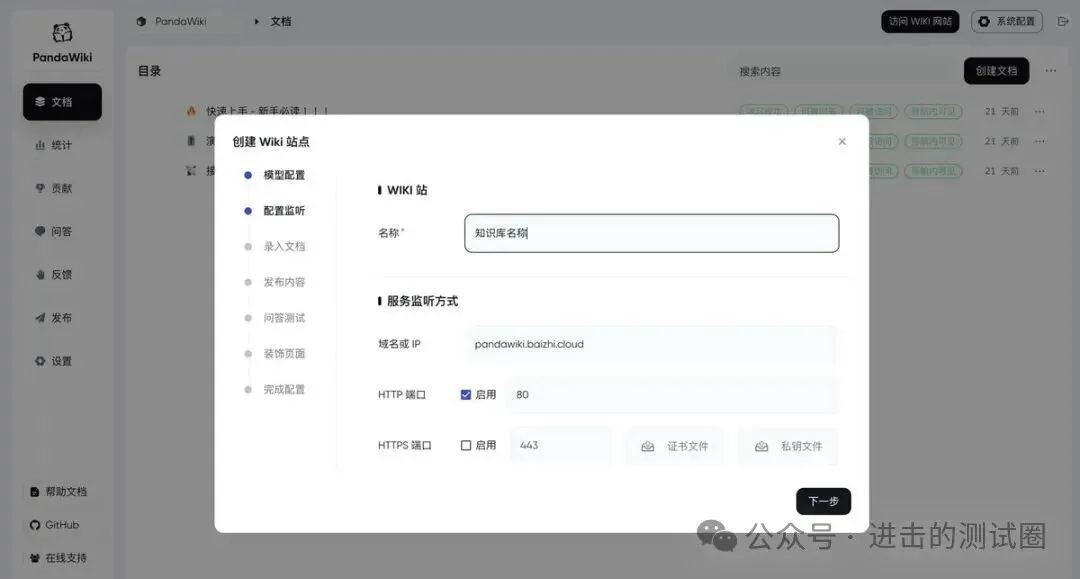
第一步创建知识库时,会让你填个名字,再配一个访问方式(域名或 IP、端口)。我图省事就直接用 IP 加端口:
从敲命令到能在浏览器里看到界面,我这边用了不到十分钟,其中大部分时间还是在拉镜像。
三、先配个 AI 模型,不然它不会"说话"
这是我觉得需要提前知道的一点:PandaWiki 本身不带大模型,它是个"壳",真正的智能来自你接进去的模型。首次登录会直接引导你配置。
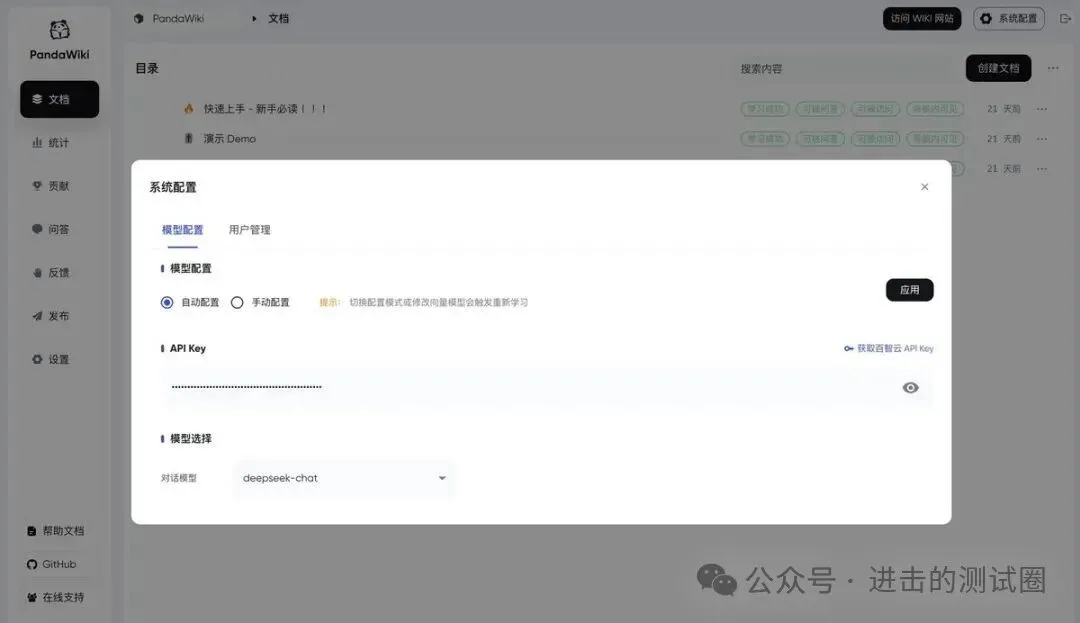
懒人路线是"自动配置"——去百智云模型广场拿个 API Key 填进去,对话模型选个现成的(我截图时选的是 deepseek-chat):
如果你想自己搭配,可以切到"手动配置"。这里能看到它其实需要五种不同角色的模型,各干各的活:
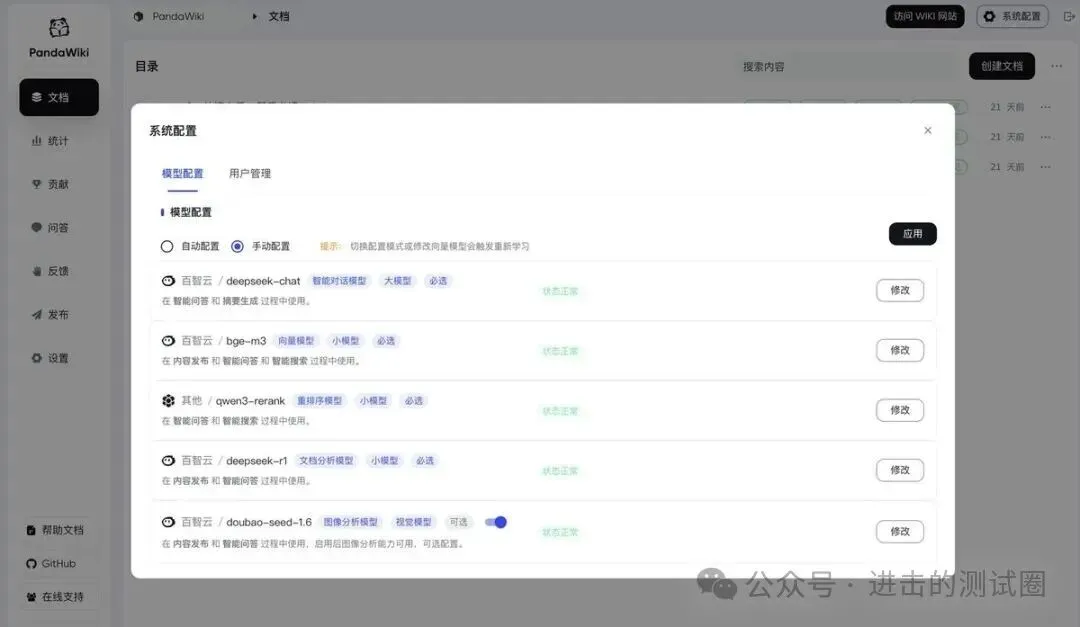
我把这五个角色翻译成人话,你就明白它们为什么缺一不可:
| 对话模型 | |
| 向量模型 | |
| 重排序模型 | |
| 文档分析模型 | |
| 图像分析模型 |
名词小抄 向量(Embedding):把一段文字变成一串数字坐标。意思越接近的句子,坐标在空间里挨得越近——就像地图上两家卖同类东西的店,位置往往靠在一起。
关于钱:接百智云首次注册有 5 元额度,想省的话也能接自己部署的模型(走 OpenAI 兼容接口那套)。这块是隐形成本,心里要有数。
四、界面和核心功能:边看边讲
配置完进去,后台长这样。左边是目录树,右边是文档列表:
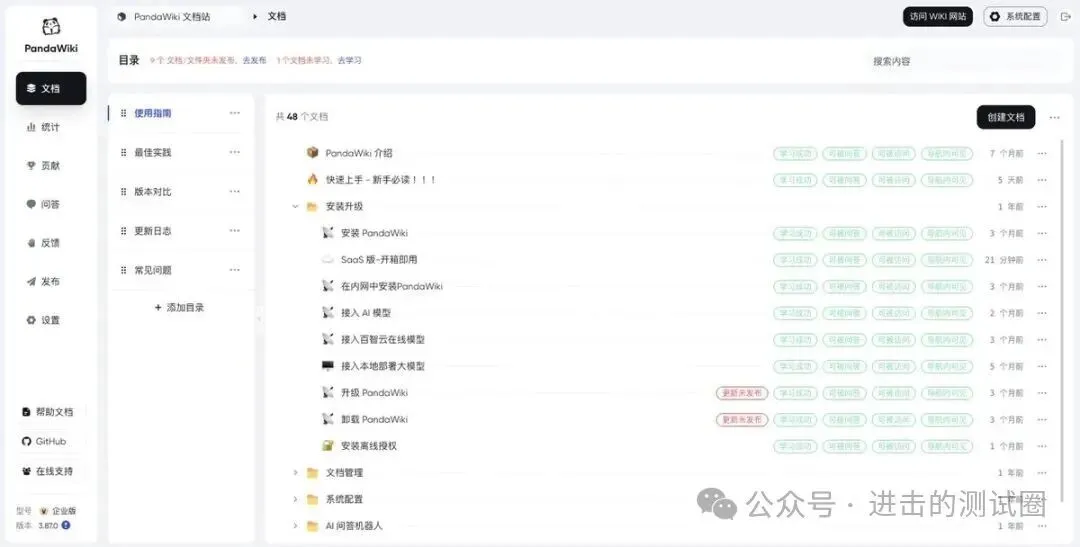
我挺喜欢的一个细节是每条文档后面的状态标签——「学习成功」「可被问答」「可被访问」「导航内可见」。等于明明白白告诉你:这篇到底是喂给 AI 了没有、能不能被问到。文档一多,这个状态比什么都实在。
前端用户看到的 Wiki 站点则是这个画风,右侧有目录和内容摘要:
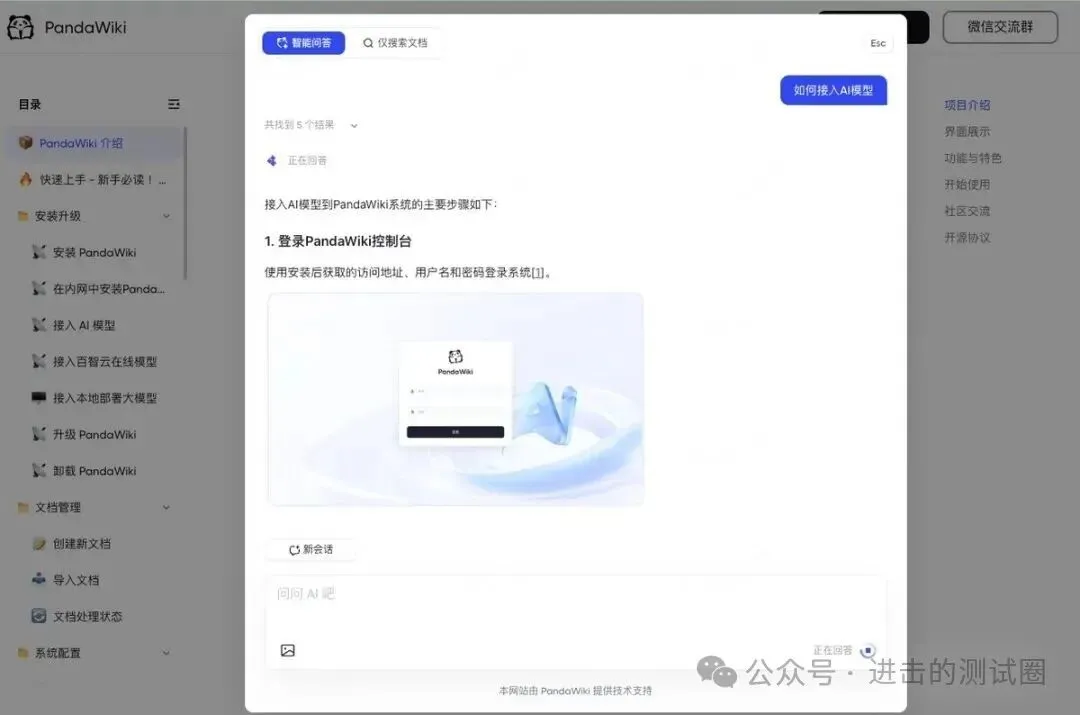
真正的主角是右下角那个 AI 问答窗口。用户点开直接问,它给的答案还会带上引用出处(截图里能看到 [1] 这种角标):
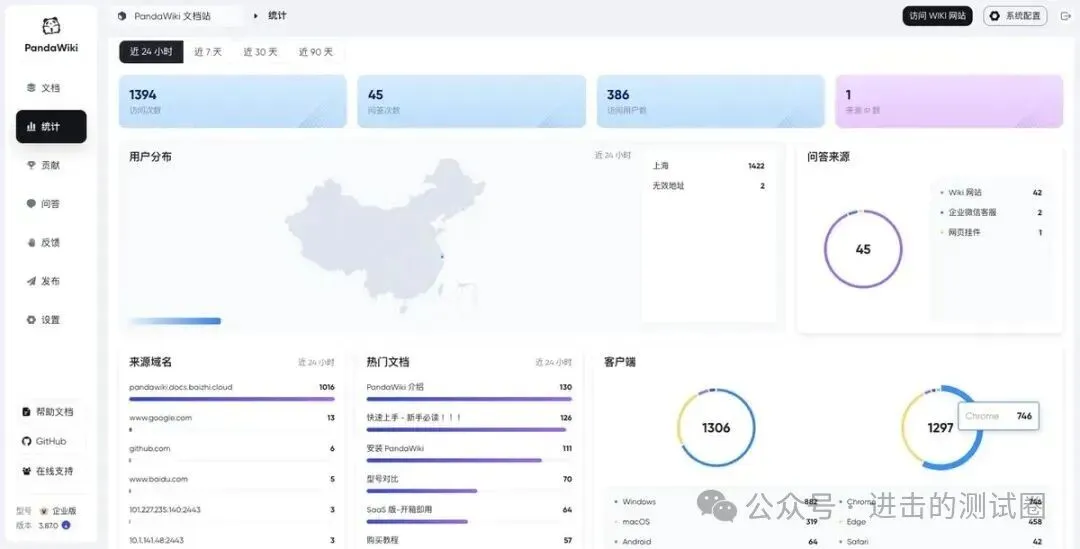
后台还有个统计页,能看到访问量、问答次数、热门文档、用户都在哪个省份、用什么浏览器……对想了解"哪篇文档最常被问到"的人来说挺有用:
功能这块我整理成一张表,省得一条条翻:
五、AI 问答是怎么跑起来的(RAG 原理)
很多人第一次用会好奇:它凭什么能"看着我的文档"回答?答案就四个字母——RAG。整个过程大致是这么一条流水线:
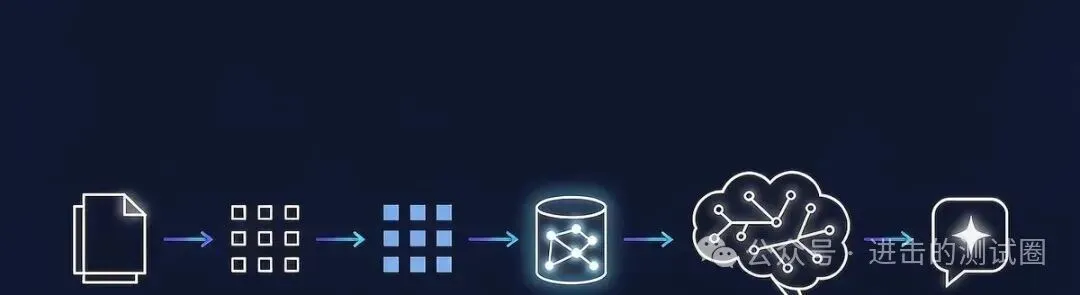
按图从左到右,五步走:
- 文档学习
:你上传文档后,系统先把它切成一小块一小块(专业叫"分块 / Chunking"); - 向量化
:每一小块被向量模型换算成一串坐标; - 进库
:这些坐标存进"向量数据库",等着被检索; - 检索
:用户提问时,问题也变成一串坐标,去库里捞坐标最接近的几块原文; - 生成
:把捞出来的原文 + 用户问题一起丢给对话模型,让它组织成答案。
名词小抄 RAG(检索增强生成):你可以理解成给 AI 安排了场"开卷考试"——先翻资料,再照资料答题,而不是凭记忆硬编。好处是答案有出处、能追溯。
名词小抄 向量数据库:专门存"文字坐标"、并且能飞快找出"离得最近的那几条"的仓库。
这也顺带解释了它的天花板在哪:RAG 只能从你给的资料里找答案。资料里没写的东西,它给不出,或者给得不准。所以问答质量跟文档质量是强绑定的——你文档写得越清楚,它答得越靠谱。
六、内容怎么进得来?四种导入方式
手上的老文档怎么搬进来,是我比较关心的。PandaWiki 支持四种,各有各的适用场景:
| URL 导入 | |
| Sitemap 导入 | |
| RSS 订阅 | |
| 离线文件导入 |
对我这种"文档早就写好了、只是散着"的情况,最后一种最省事。
【配图建议】此处可放一张"导入向导"界面截图(选择导入方式那一步),或一张"四种导入方式"的示意图。官方文档里有对应截图,我手边没截到,留个位置。
七、不止一个网页:挂件和聊天机器人
光有个 Wiki 网站还不够,人得在他本来就在的地方问到东西,用起来才顺。这方面它给了三个出口:
- 网页挂件
:一行 JS 嵌到你自己的网站上,右下角就多个问答小窗口,效果就是上一节那张 AI 问答截图; - 聊天机器人
:接进钉钉、飞书、企业微信,同事在群里就能问,不用专门开浏览器; - API
:想自己接入别的系统,直接调接口。
【配图建议】建议放一张"钉钉 / 飞书 / 企业微信里机器人回答"的对话截图。这是最有说服力的场景图,官方文档里应该能找到。
八、和传统 Wiki、其他 AI Wiki 摆一起比
我把几个关键维度列成一张表,方便横向看(✅ 表示支持,⚠️ 表示部分支持或看情况,❌ 表示不支持):
名词小抄 AGPL-3.0:一种开源许可协议。你可以免费用、随便改;但如果你把它改动后做成在线服务给别人用,就得把自己的改动也开源出来。自己内部用、不对外提供服务的场景,一般不受这条约束——真要商用,建议自己再核一遍协议原文。
九、我用了之后的真实感受
觉得不错的地方:
- 真·开箱即用
。一句脚本装完,剩下的都在网页上点,没让我碰配置文件。 - AI 能力比较"整"
。很多同类项目只有问答,它把创作、问答、搜索都做了,且能对外集成。 - 状态透明
。文档有没有被 AI 学进去,一看标签就知道,这对排查"为什么这个问题它答不上来"帮了大忙。 - 开源
。代码摆在那,后端 Go、前端 React,想改想接都能自己动手。
需要注意的地方(都是实话):
- 得自备模型
。它自己是壳,AI 要花钱或花机器,本地跑模型则吃显卡。 - 答得好不好,取决于你文档的质量
。这是 RAG 的通病,不是它的锅,但用之前要有预期。 - 界面和文档以中文为主
,我主要看中文栈,英文生态没细究。 - 企业级能力不一定全在开源版里
。我翻仓库时看到 backend/下有个pro/目录,推测 SSO 登录这类功能可能属于专业版,具体以官方说明为准。
十、谁适合用?
按我自己的判断,下面这几类人用它性价比最高:
- 产品 / 客服团队
:把产品说明、FAQ 丢进去,用户自己就能问,少接一堆重复咨询; - 研发团队
:接口文档、开发规范集中管,新人靠问答快速上手; - 要建企业知识库的公司
:文档统一收口,再挂到钉钉 / 飞书里; - 个人折腾派
:想给自己攒一个"能对话的笔记本",顺便玩玩 RAG。
项目信息(数据截至我查看时,仅供参考):
github.com/chaitin/PandaWiki | |
pandawiki.docs.baizhi.cloud | |
附:名词速查表
写在最后
本文是我作为普通使用者的体验记录,不是官方推广,文中数据以我查看时为准,项目迭代很快,具体请以官方仓库和文档为准。
如果这篇文章帮你省下了点摸索时间,点个赞就行。后面我打算再写一篇"把本地模型接进 PandaWiki"的折腾记录,有兴趣的可以关注一下。