ARTICLE · 1253712
2.8万亿参数像PDF一样挂上网!Kimi杀入全球前四,闭源护城河只剩3分
“2.8万亿参数,他们居然要像发PDF一样挂上网。我们彻底完了”
10月24日凌晨,开发者Chip Herndon的惊呼刷屏硅谷。几小时前,月之暗面发布Kimi K3.1 Pro与提速版Highspeed,并承诺11月4日前公开完整权重。
▲ 海外开发者惊叹2.8万亿参数模型即将像PDF一样公开
半小时后,独立评测机构Artificial Analysis放出成绩单:在全球215个模型的智能指数榜上,K3.1 Pro以55分杀入全球第四,仅次于Claude Opus 5.5(58分)、Sonnet 5.5与Muse Wonder Full(56分)。
此前,开源权重模型长期困在44至46分的天花板下。K3.1 Pro一举跨过10分“无人区”,一旦开源,开闭源顶尖代差将从12分骤缩至3分。出乎意料的是,它并没换更大底座一粒参数没加,凭什么原地起飞?拆开黑盒,核心就四个机制
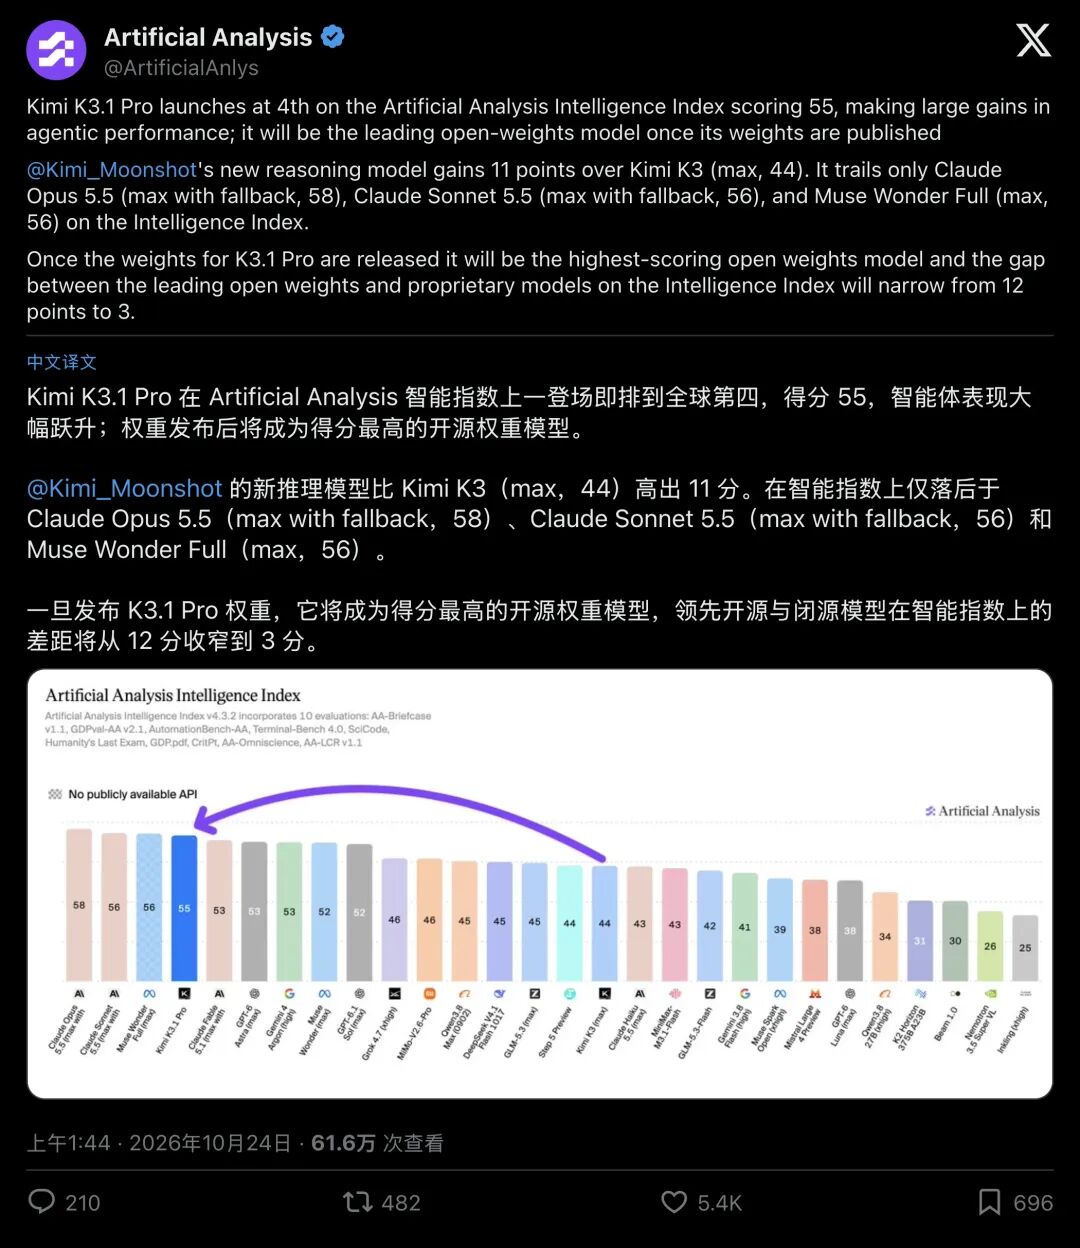
▲ Artificial Analysis榜单显示K3.1 Pro以55分位列全球第四
01拆解一:一粒参数没涨,凭什么暴涨11分?
先理清两个词闭源模型像只送外卖的私房菜;开源权重则是公开训练好的“大脑参数”,有算力的企业能直接搬回自家机房私有部署(商用细节仍看许可证)。K3.1 Pro沿用的仍是上代K3的2.8万亿总参数、单次激活1040亿参数混合专家(MoE)底座,好比拥有2800名医生的超级医院,每次看病只叫对口的104名专家会诊。
大脑容量没变,暴涨的11分从哪来?看2500题完整版HLE(人类最后一场考试)的戏剧性反差:
不给工具“赤手空拳”硬想,K3.1 Pro仅得51.1%,输给Opus 5.5(59.8%)和GPT-6 Astra(53.6%)。一旦允许调用工具,它的成绩瞬间狂飙近19个百分点至70.0%,一把反超Opus 5.5(67.7%)与Astra(57.2%)。
谜底揭开了它没靠死记硬背当“做题家”,而是砸下重度后训练算力,在数百个领域靠强化学习练成了“工具人”。在模拟终端编程的Terminal-Bench 4.0上,其第三方实测成绩从上代的13%暴涨至约67%。底座没变大,手脚练活了
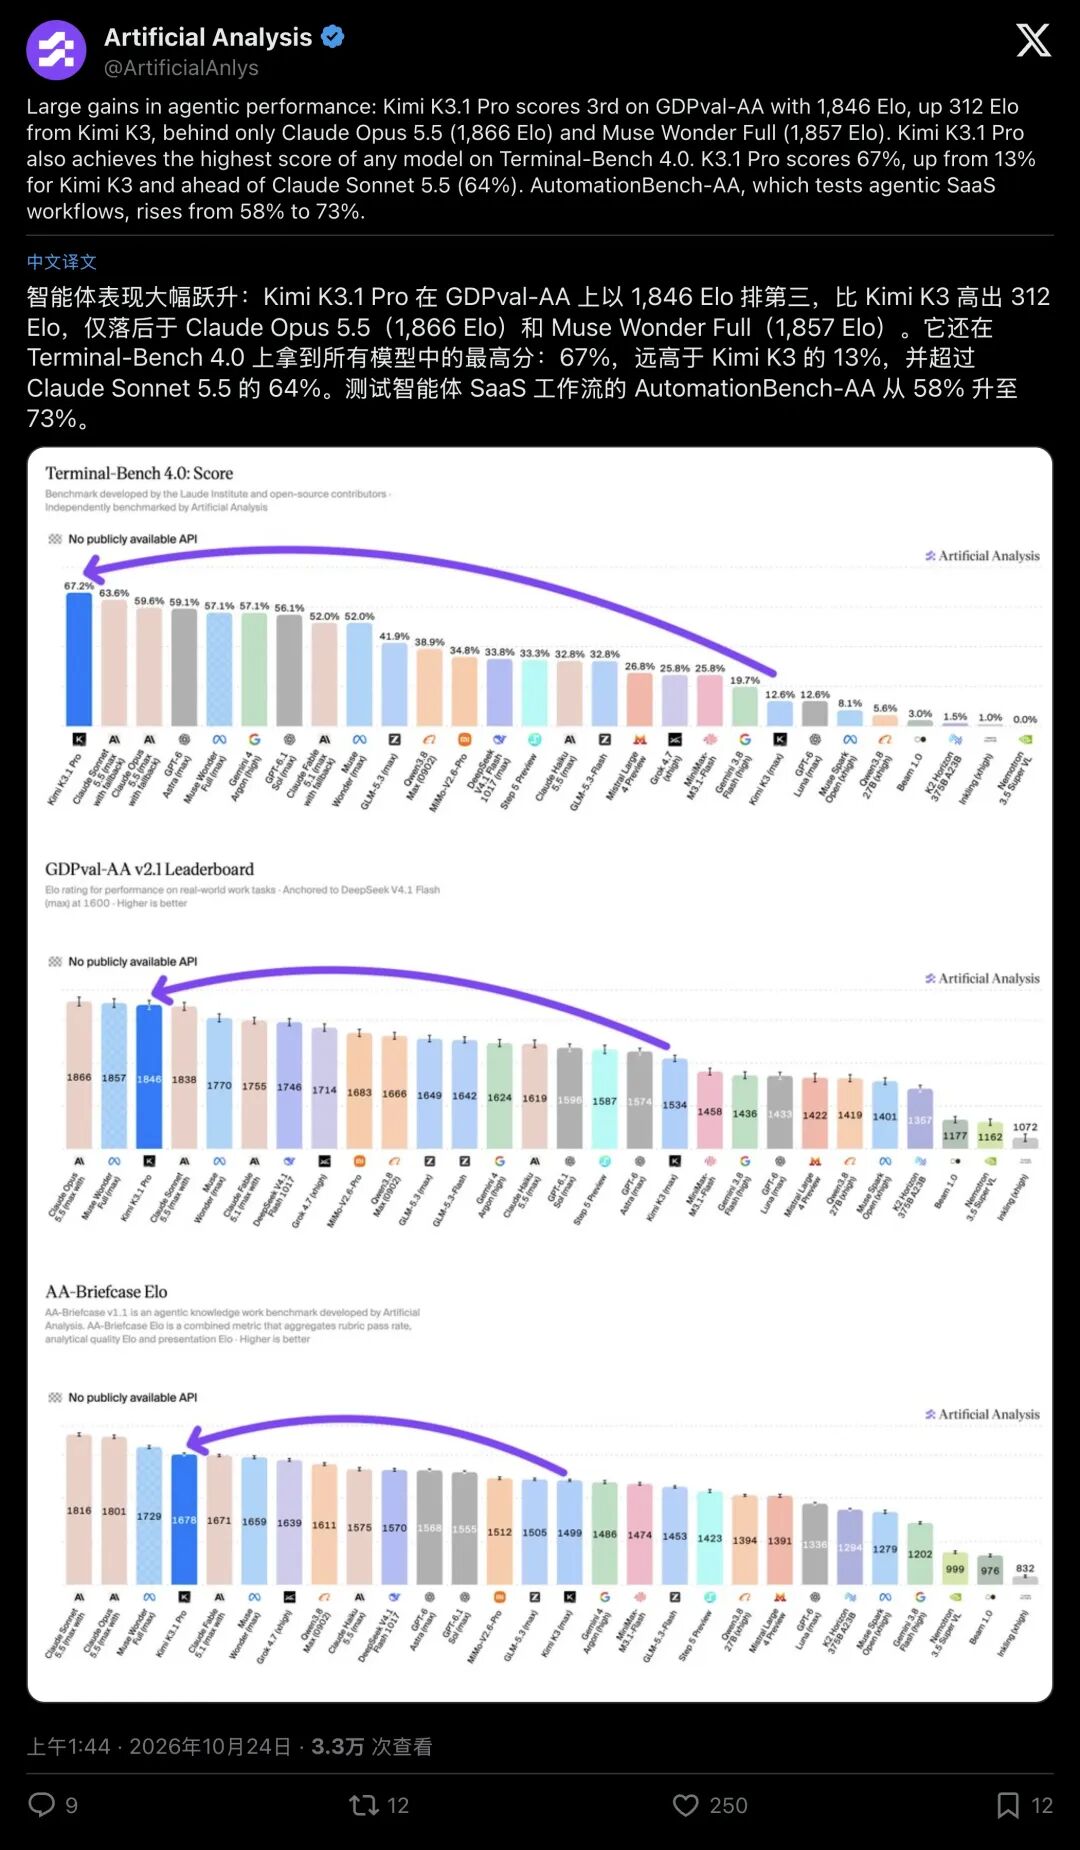
▲ Terminal-Bench 4.0测试中K3.1 Pro从约13%跃升至约67%
02拆解二:禁搜答案、防烂尾,长程干活怎么练?
AI聊天很机灵,连干半小时真活却常烂尾。为什么?
前沿基准MCP-Atlas混入36个真实生产服务器、220个隐去名字的工具,测完20款大模型后揪出病根:调通工具的调用语法并不难,63.3%的失败都栽在后续的“认知崩溃”上,模型要么在终点前过早放弃,要么看错返回结果。
为治好偷懒与烂尾,K3.1 Pro扛住了两场魔鬼测试。
一是伯克利牵头的Agents' Last Exam(v1.1),含122道真实职业难题。评测团队立下铁血“防捷径判零规则”:比如要求用抓包软件Wireshark解析流量,模型若敢耍小聪明、绕开软件直接联网搜现成答案,当场判0分。严防作弊下,搭载Kimi Code脚手架的K3.1 Pro拿下43.2%(命令行44.2%),双双压过Opus 5.5(42.6%)与Astra(32.8%)。
二是深度网页寻源BrowseComp。长途搜索最怕内存塞满“失忆”K3.1 Pro每攒够20万token就自动压缩上下文,像老刑警把厚草稿浓缩成精炼办案笔记,最多连走500步不迷路,最终以92.1%力压Astra(91.5%)与Opus 5.5(90.8%)。
03拆解三:按GDP算经济账,开源江湖已成“三国杀”
跑分之外,企业只认投入产出比10月24日更新的Vals Index v2.2,将金融、编程、法律、税务表现严格按美国GDP行业占比加权。前七名全是闭源巨头,K3.1 Pro以62.52%居总榜第八、开源第一,较上代大涨9.57个百分点(Vibe Code编程达84.9%,法律67.0%,金融智能体61.5%)。
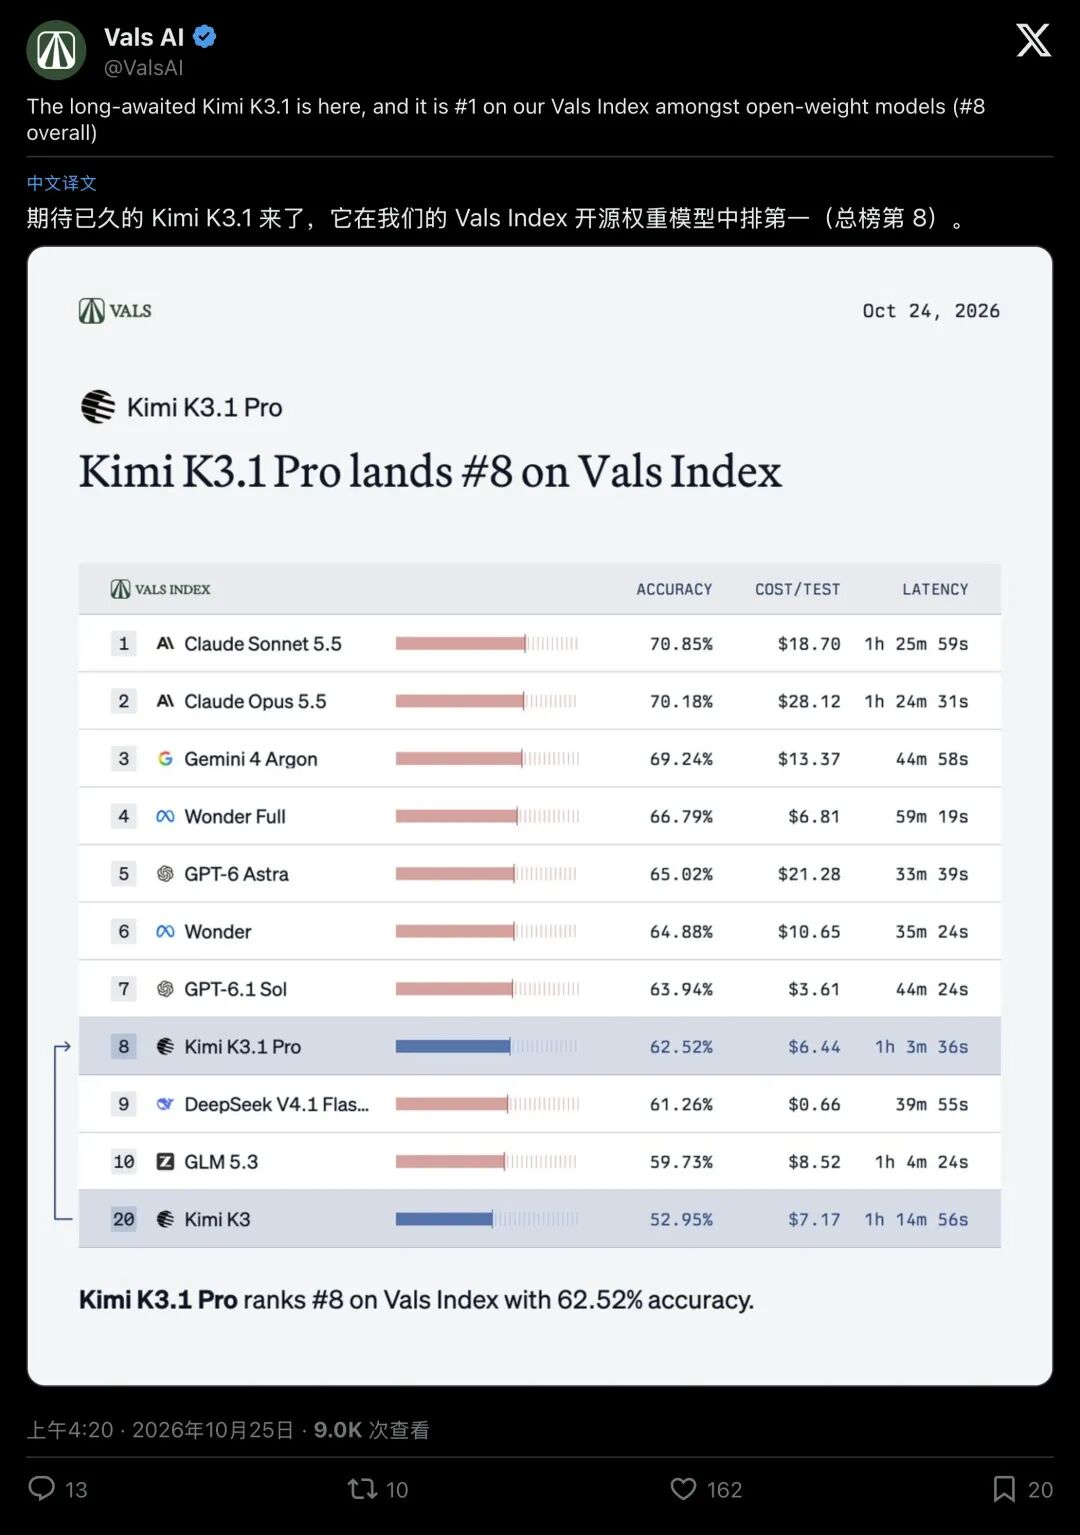
▲ Vals AI按GDP加权的榜单上,Kimi K3.1居开源第一、总榜第八
对比紧随其后的第9、第10名,开源阵营已分化出三种截然不同的生存路线:
“重装特种兵”Kimi K3.1 Pro:2.8万亿体量专啃多步硬仗,代价是慢且话痨,每秒仅73.5个token,单题狂吐5.5万token。哪怕标准API降价三分之一(每百万输入2美元/输出10美元),啰嗦属性仍把单题账单维持在约2美元。
“极速手术刀”DeepSeek V4.1 Flash(第9,61.26%):MIT协议配FP8权重,每秒飙出195个token,单题成本仅0.26美元。单仓修Bug(DeepSWE 77.0%)小胜Kimi,但遇上超长终端战(42.3%)仍显体量差距。
“谨慎老中医”GLM-5.3(第10,59.73%):强制常驻深度推理,靠70.4%的非幻觉率立身,不懂绝不瞎编。重装攻坚、极速省钱、高抗幻觉,开源生态第一次给企业凑齐了按需取用的全套兵器。
04拆解四:主动“自砍一刀”,为何反拿网安第一?
最戏剧性的反转出在网络安全赛道
Kimi团队透露,后训练中漏洞攻防能力涨势过猛。为防开源后沦为黑客武器,团队主动剔除了训练与强化学习中的攻防数据,硬把内部测试(xdev-bench-hard)通过率从90.5%压低到81.0%。
谁知几小时后,Artificial Analysis公布网络防御指数:K3.1 Pro竟以64%夺得公开可用模型第一,端到端防御子项从58%飙至95%。
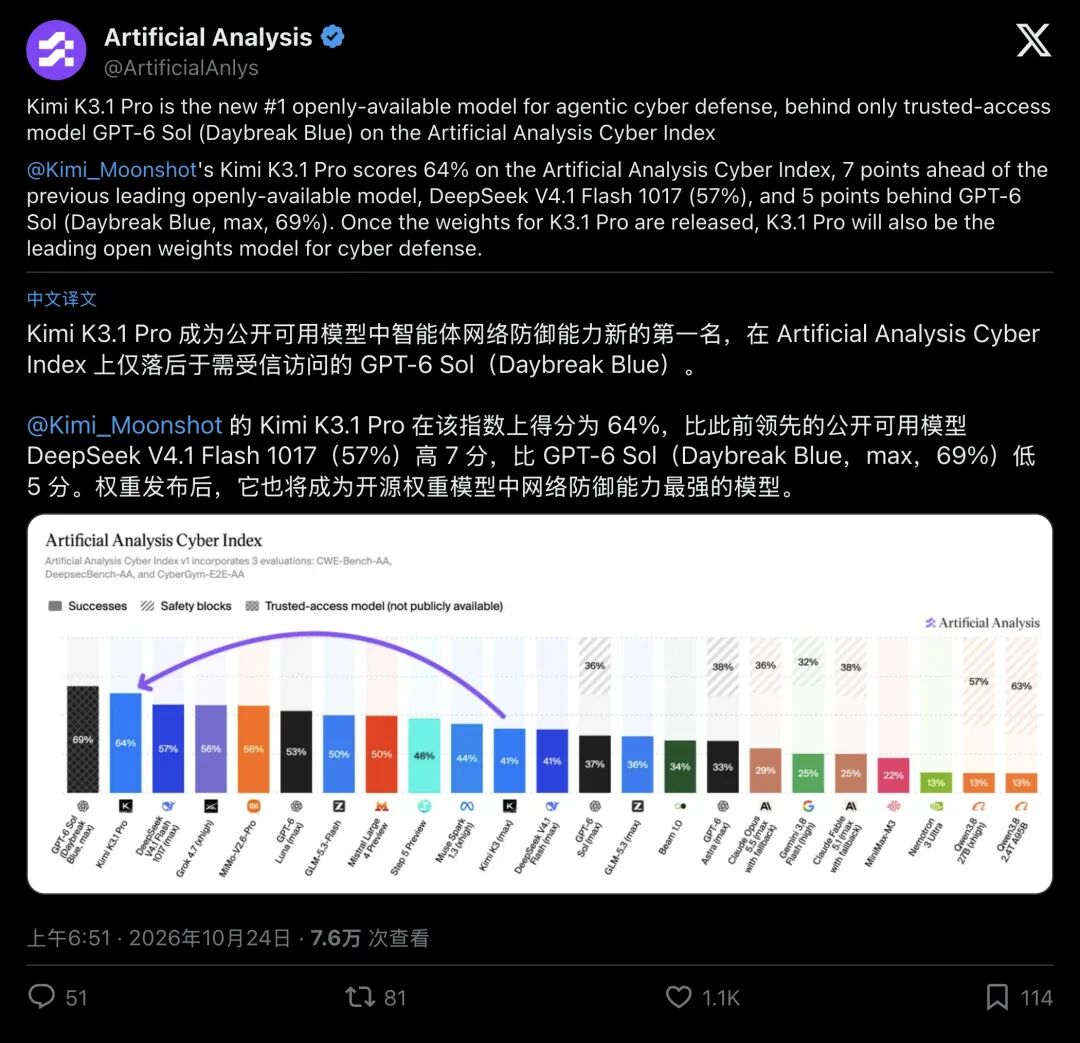
▲ K3.1 Pro在网络防御指数中位居公开可用模型第一
为何“自砍一刀”反而夺冠?因为Kimi砍掉的是危险的漏洞利用上限,而不少闭源模型护栏过度敏感,连正常防御指令也动辄拒答丢分。K3.1 Pro不瞎拒答,反而在合规防御里跑出了统治力。
当然,先别急着腾家用电脑硬盘目前权重尚未放出,11月4日才是验货时刻;2.8万亿参数的巨兽也注定属于云集群而非个人笔记本。但风向彻底变了:当准开源模型追到只差3分,闭源巨头靠“独家智商”躺收高价过路费的时代正在落幕。锁紧技术秘密的壁垒逐渐失效,下一程的胜负手,在于谁能以更快的速度、更低的成本,把思考转化为真金白银的生产力。