ARTICLE · 1257689
AI能预测220万种晶体,为什么新材料还是难落地?
材料AI最缺的不是算法,是数据。更准确地说,是高质量、多来源、能闭环的数据。
01 先从一个矛盾说起
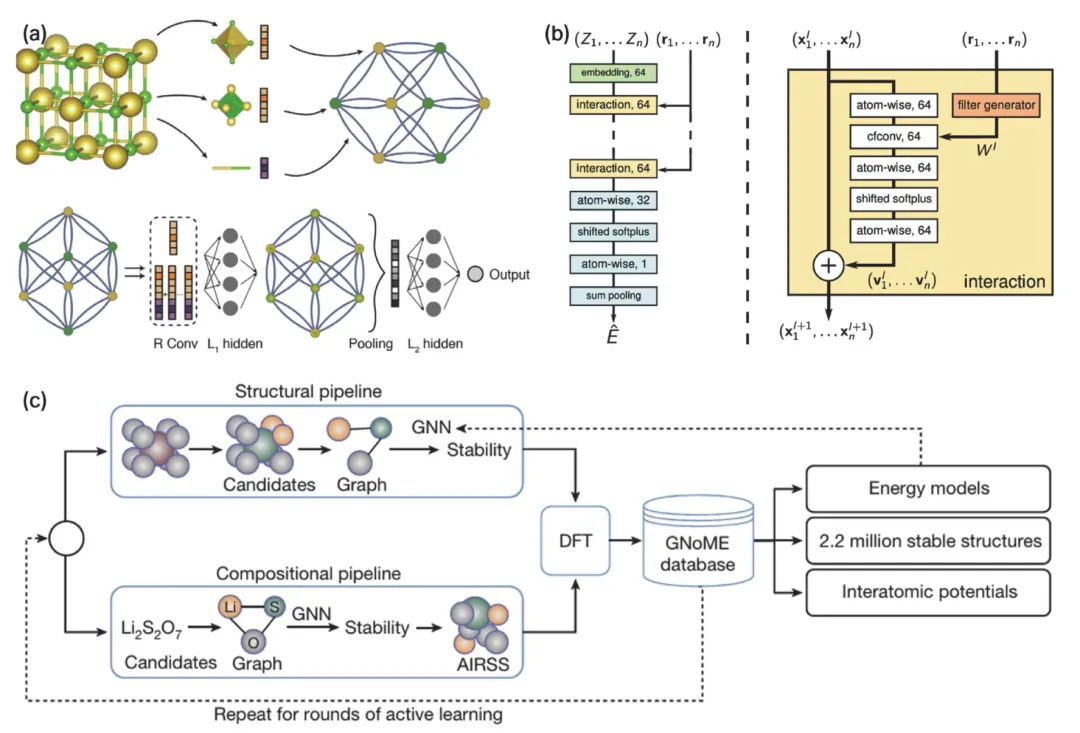
2023 年,GNoME 用图神经网络预测了 220 万种新型稳定晶体结构,把人类已知稳定材料的数量推高了一个数量级。几乎同时,A-Lab 在 17 天连续运行中,把计算筛选、文献配方和机器人实验串起来,成功合成了一批新化合物。
一边是计算筛选的“爆发”,一边是实验验证的“稀缺”。这篇综述要回答的核心问题很直接:
数据从哪里来?
因为数据是 AI 的燃料,而材料科学最缺的,恰恰是燃料。
02 材料AI的数据瓶颈:不是缺数据,是缺“好数据”
材料科学的数据稀缺,不是一句“数据少”就能概括。它至少有三层表现:
总量稀缺:ImageNet 有 1400 万标注图像,GPT-3 训练于 45TB 文本;而 Materials Project 只有约 17.8 万种材料的计算数据,实验确认的无机晶体结构也只有约 32 万种。
覆盖不均:研究资源集中在钙钛矿、二维材料等热门体系,局部数据过饱和;高性能结构材料、跨维耦合性质却数据稀疏,形成大量“数据孤岛”。
质量参差:实验数据受样品制备、测试环境、仪器精度影响,不同来源可比性差;计算数据也有系统性偏差;材料命名、化学计量比、晶体学参数缺乏统一标准。
更麻烦的是,数据获取本身很难。
材料宏观性能与微观机理之间,涉及电子结构、晶格缺陷、介观组织等多尺度耦合,还有热、电、磁等多物理场相互作用。很多合成和表征需要超高温、极低温、强磁场等极端条件,单次实验成本可达数千元甚至更高。
大量有价值的实验数据还分散在数十万篇文献里,以非结构化自然语言和图表存在。人工提取费时费力,自动提取又面临文本理解、数据识别、关系抽取等难题。阴性结果往往不被报道,数据存在系统性偏差。
计算数据也不是“想算就能算”。精确求解多体薛定谔方程存在“维数灾难”,高通量计算必须引入近似。高精度杂化泛函成本极高,常用 GGA-DFT 对带隙、相变温度等关键性质存在系统性误差,对含 d/f 电子的强关联体系描述能力也有限。
所以,数据瓶颈不是单点问题,而是获取、质量、标准化、共享的系统性问题。
03 路径一:高通量 DFT 计算数据库
密度泛函理论(DFT)自 1960 年代提出以来,已成为材料电子结构计算的主流方法。进入 21 世纪,计算能力指数增长,DFT 软件成熟,高通量计算成为可能。
高通量计算把自动化工作流和高性能计算结合,实现了材料性质的批量预测。 材料研究从点状探索走向系统扫描。
目前国际上已建成多个大规模 DFT 材料数据库:
Materials Project:约 100 万条目,劳伦斯伯克利国家实验室,含无机、分子及电池材料;
AFLOW:>350 万条目,杜克大学,规模巨大,侧重合金与对称性分析;
OQMD:>130 万条目,西北大学,热力学稳定性、相图计算;
NOMAD:>1900 万条目,欧洲联合体,最大的计算材料学资源库;
GNoME:约 220 万,Google DeepMind,大规模深度学习预测的新型稳定晶体结构数据集。
这些数据直接推动了材料 AI 模型的演进,大致经历三个阶段:
第一阶段:特征工程主导。Magpie 框架整合电负性、原子半径、第一电离能等原子属性;Pilania 等人在双钙钛矿带隙预测中系统评估超过 120 万个候选特征;Rupp 等人提出库仑矩阵方法,把分子薛定谔方程求解转化为非线性统计回归。局限:描述符多基于人工经验和化学直觉,难以表征长程有序和复杂非线性结构效应,换体系就要重新设计。
第二阶段:图神经网络革命。CGCNN 把晶体视为节点(原子)和边(化学键/距离)构成的图,通过消息传递端到端提取特征,将形成能预测平均绝对误差降至 0.039 eV/atom,较传统机器学习提升约 60%。SchNet 用连续滤波器卷积捕捉连续相互作用,MEGNet 引入温度、压力等状态变量。关键变化:从人工特征工程转向自动特征学习,通用架构无需针对不同性质反复调整。
第三阶段:基础模型与预训练。GNoME 通过大规模主动学习预测 220 万种新型稳定晶体,将已知稳定材料数量扩展 10 倍以上。CHGNet 等通用势函数兼顾 DFT 级精度和极高效率,模拟速率较传统第一性原理方法提升 7 个数量级。
但 DFT 数据也有固有局限:计算精度和效率存在权衡,性质覆盖有限,缺乏合成信息,计算与实验之间存在鸿沟。 这正是后两条路径要补的课。
04 路径二:用大语言模型挖掘文献
科学文献是材料知识的重要载体,也是长期被低估的数据宝库。仅材料科学领域的学术出版物就超过 600 万篇,且每年以数十万篇速度增长。
文献里有什么?合成配方、表征数据、性能测试结果,还有宝贵的经验知识——特定条件下实验的成败关键与优化路径。
问题是,这些信息绝大多数以非结构化自然语言存在,机器难以直接读取。
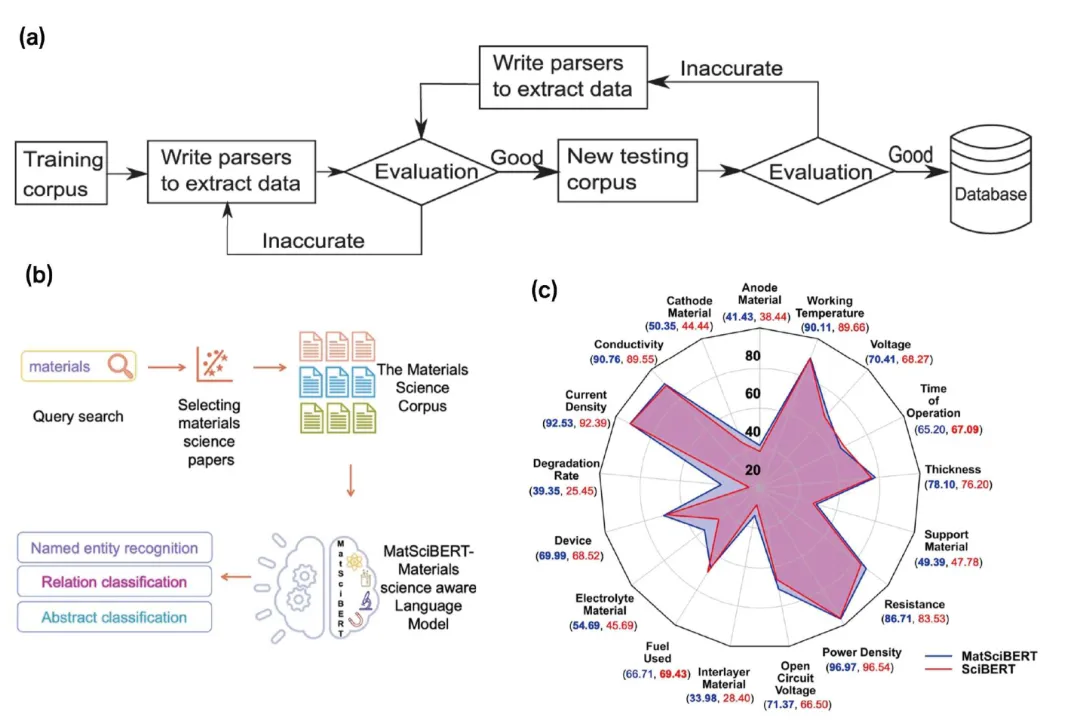
早期工具如 ChemDataExtractor 尝试自动生成电池材料数据库;MatSciBERT 作为首个材料科学领域预训练语言模型,在命名实体识别、关系分类等任务上显著优于通用科学模型 SciBERT。
2022 年以来,GPT、LLaMA 等大语言模型带来质的飞跃:
上下文理解更强:能判断 BPDSC 与 4,4'-联苯二磺酰氯指代同一化合物;
少样本/零样本学习:仅提供 2~3 个示例,GPT-4 的关系抽取性能即可超越专门训练的基线;
直接输出结构化格式:如 JSON,简化从非结构化文本到结构化知识的流程。
典型应用也很具体:
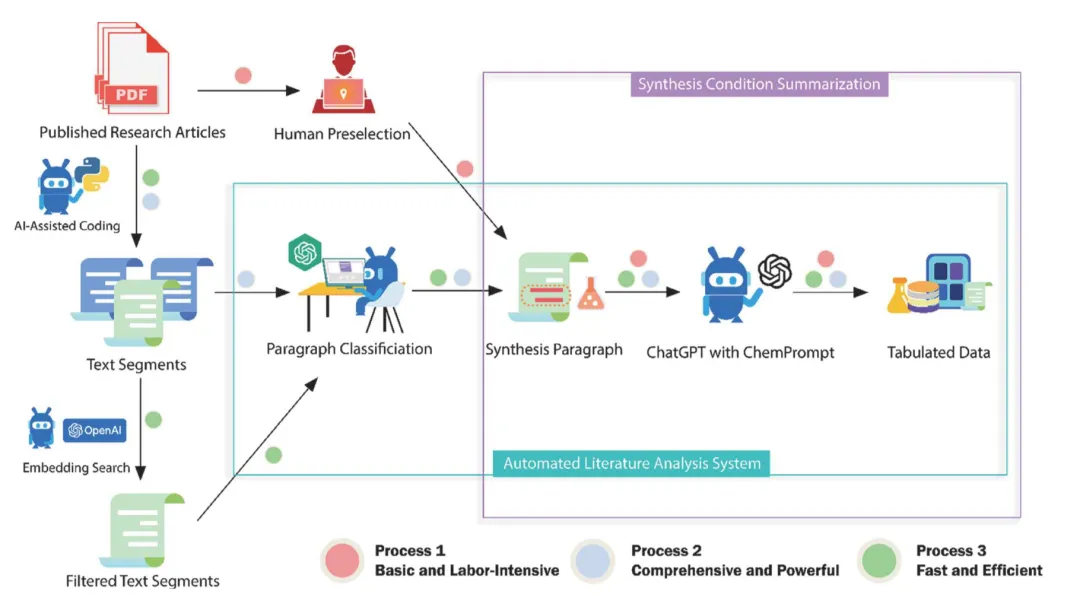
Zheng 等人开发基于 ChatGPT 的 MOF 合成条件提取框架,在 MOF 结晶条件分类任务中 F1 分数达到 0.90–0.99,信息提取准确率达 0.96;
Foppiano 等人评估 GPT-3.5/GPT-4 在超导材料文献中的表现,微调后的 GPT-3.5-Turbo 在关系抽取任务上超越所有基线;
Walker 等人用 LLM 从文献中提取金纳米棒合成流程,通过迭代微调持续提升准确率;
Kononova 等人从 24000 多篇论文中提取无机材料合成配方。
但 LLM 有个致命问题:幻觉。它可能生成毫无文献依据的“伪数据”。
所以实际应用中通常要引入 检索增强生成(RAG),强制模型基于检索到的真实文献片段进行定向提取;再辅以领域专家人工校验,形成“机器初筛—专家定稿”的闭环。
文献挖掘的价值:释放人类积累的实验知识,弥补计算数据与实验数据之间的鸿沟。局限:历史数据多、需要验证、存在发表偏差,提取质量依赖 RAG 和人工校验。
05 路径三:超快制备与高通量实验
实验数据是材料 AI 实现应用闭环的“最后一公里”。
相比计算和文献数据,实验数据可靠性更高,能直接反映材料真实性能,还能获取计算难以预测的加工性能、长期稳定性、批次重现性等信息。实验中常出现预期之外的发现,这往往是重大突破的来源。
但传统材料合成与表征太慢。陶瓷常规烧结要数小时乃至数十小时,一个完整的“设计—合成—表征—测试”循环通常以周为单位。DFT 计算可在数秒内完成一种材料的性质预测,实验验证却需要数天。计算筛选与实验验证之间的速度失配,是当前材料 AI 的核心矛盾之一。
超快制备技术正在改变局面。
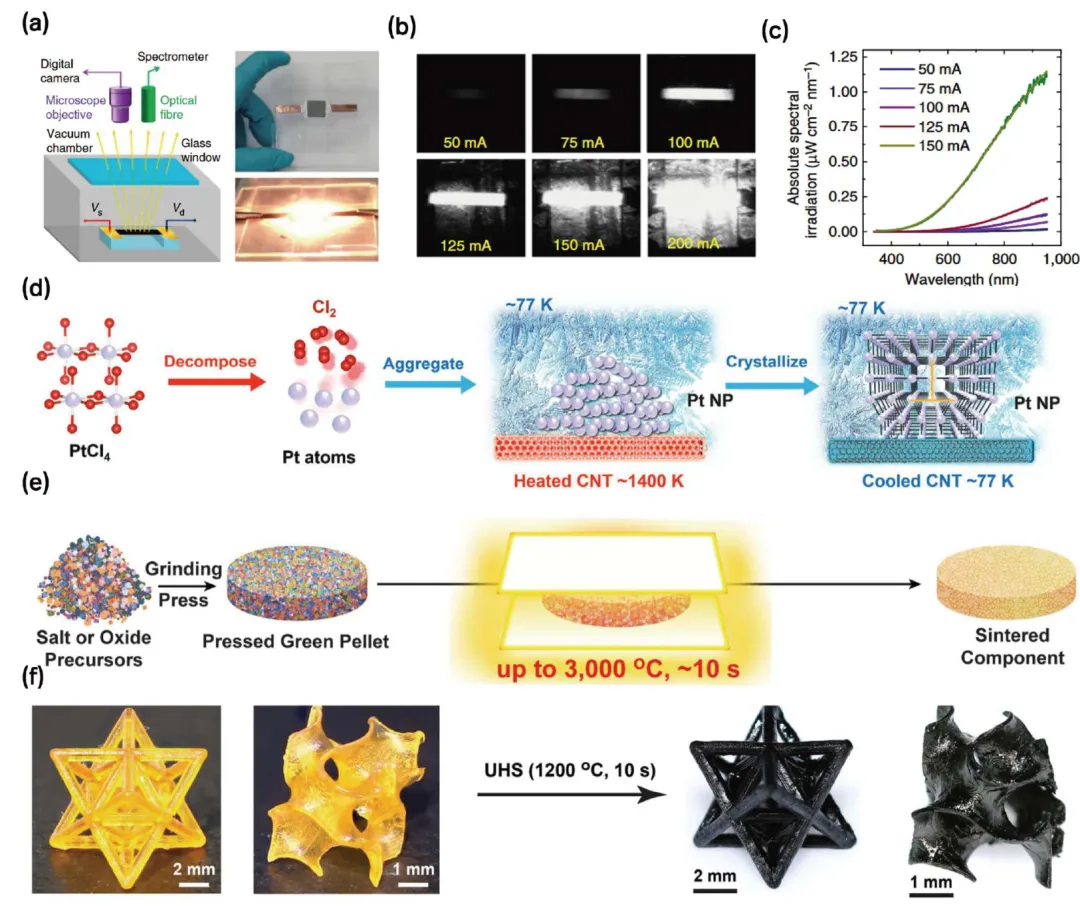
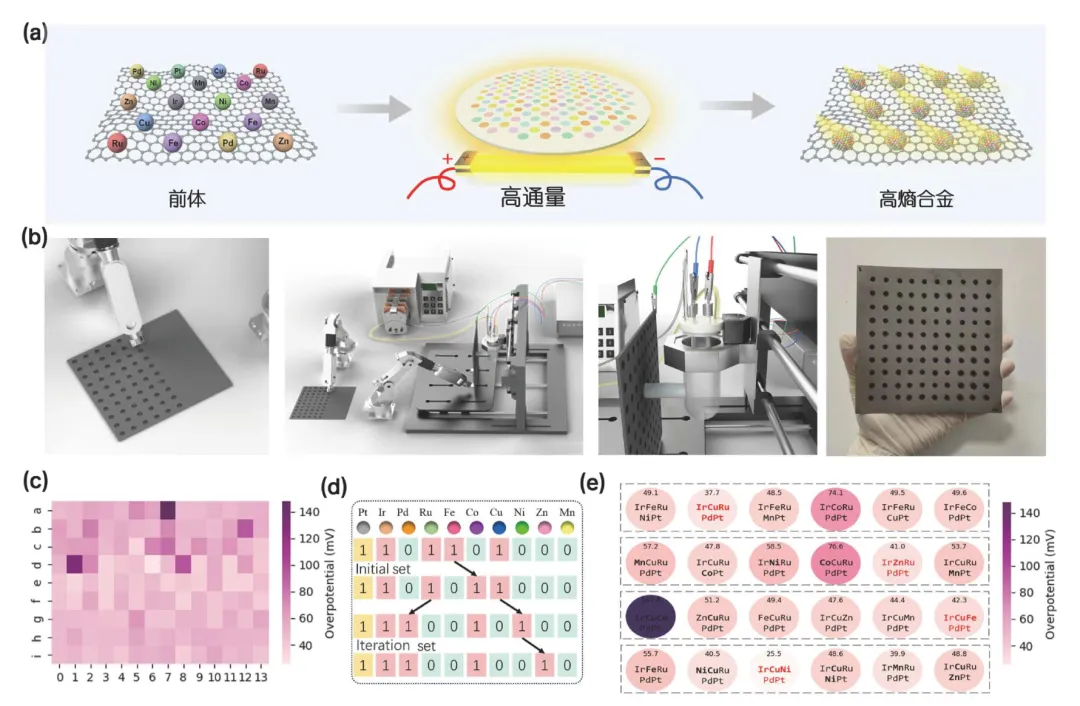
2016 年,陈亚楠和胡良兵团队提出超快高温热冲击方法(HTS):利用焦耳加热,在 10 ms 内实现高达 1700 K 的瞬时高温,在还原氧化石墨烯基底上成功制备并稳定直径约 10 nm 的活性纳米颗粒,解决了纳米颗粒高温易团聚、易氧化的难题。
后续发展更极端:
在 77 K 液氮环境中进行热冲击,在 Pt 纳米晶中诱导高密度位错,显著增强析氢反应活性;
超快高温烧结工艺在 数秒内完成高性能陶瓷的合成与致密化,抑制挥发性元素损失;
HTS 与增材制造结合,开发可 3D 打印的高温高速加热器,制造任意形状和定制热场分布的加热元件。
高通量技术则通过并行化、自动化和规模化实验设计,系统探索广阔材料组分空间。
一个代表性案例是高熵合金筛选:利用超快高温冲击高通量制备 HEA 催化剂,自动移液机械臂滴加催化剂墨水,定制电解池配合动态强制对流循环,再用混合遗传算法—实验迭代优化。经过四次迭代,识别出具有最优过电位的组合。
实验数据的优势:可靠性高、可定制、实时性强。传统局限:成本高、通量低。超快制备和高通量技术正在快速改变这一点。
06 自主实验室:三种数据源的闭环融合
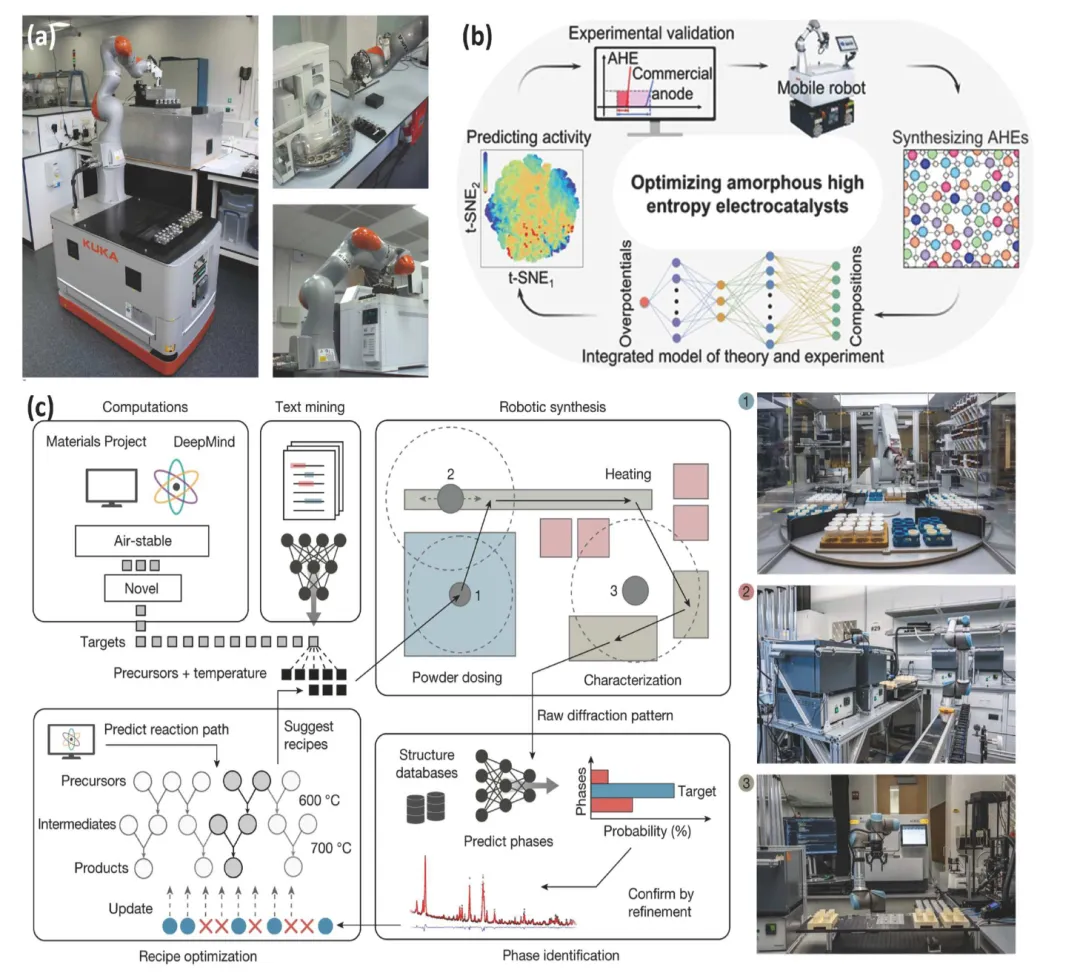
“干湿闭环”实验室,融合“干实验”(理论计算与 AI 模拟)和“湿实验”(自动化合成与表征),代表材料研究范式的根本性变革。
完整自主实验室包含三个核心环节:
数据输入:整合计算预测、文献挖掘、实验表征的多源信息;
智能决策:AI 识别知识空白、预测候选材料、规划实验序列;
数据反馈:新实验结果即时更新模型,优化预测能力。
几个标志性系统:
移动机器人化学家利物浦大学 Burger 等人提出模块化、移动性方案:不改造实验室,让机器人适应现有设备。配备六轴机械臂和灵巧抓手,能操作移液器、天平、pH 计、光谱仪等标准仪器。在光催化剂氢材料优化中,面对十维变量空间,传统网格搜索需要数万次实验;通过批量贝叶斯优化,机器人 8 天仅执行 688 次实验,就识别出活性比初始配方高 6 倍的光催化剂组合。从实验设计到高性能材料发现,效率提升约 3 个数量级。
高熵催化剂自动发现针对碱性析氧反应,从 16 种候选元素中选 6 种构成高熵羟基氧化物,对应 190 万种可能组分。自动化平台合成初始样品库,机器学习建立“组分—活性”关系,再在全空间虚拟筛选。模型达到近 100% 召回率,预测最优催化剂过电位仅 159 mV,稳定运行超 10000 小时。当结构信息缺失时,高通量实验数据驱动成为唯一出路。
A-LabA-Lab 代表自主实验室的更高形态:利用 Materials Project 和 GNoME 的 DFT 数据筛选热力学稳定目标化合物,基于自然语言模型从文献中提取合成路径生成初始配方,机器人执行实验后,失败案例输入主动学习算法优化合成条件。17 天连续运行,成功合成一批新化合物。更重要的是对失败案例的系统分析:约三分之一因 DFT 预测误差,三分之一因动力学阻碍,三分之一因工艺未优化。这些信息直接反馈改进计算筛选和合成策略,体现闭环系统的自我进化能力。
三类数据源各有优劣,可以这样对比:
DFT 计算:规模大(百万级),成本中,可靠性中,性质覆盖有限,无合成信息,实时性高;
文献挖掘:规模中(十万级),成本低,可靠性中,覆盖广,合成信息丰富,实时性低;
高通量实验:规模小→中(快速增长),成本高,可靠性高,可定制,合成信息完整,实时性高。
自主实验室的核心价值,是让计算提供候选、文献提供配方、实验验证结果、主动学习优化策略,形成正反馈循环。
07 几点感悟
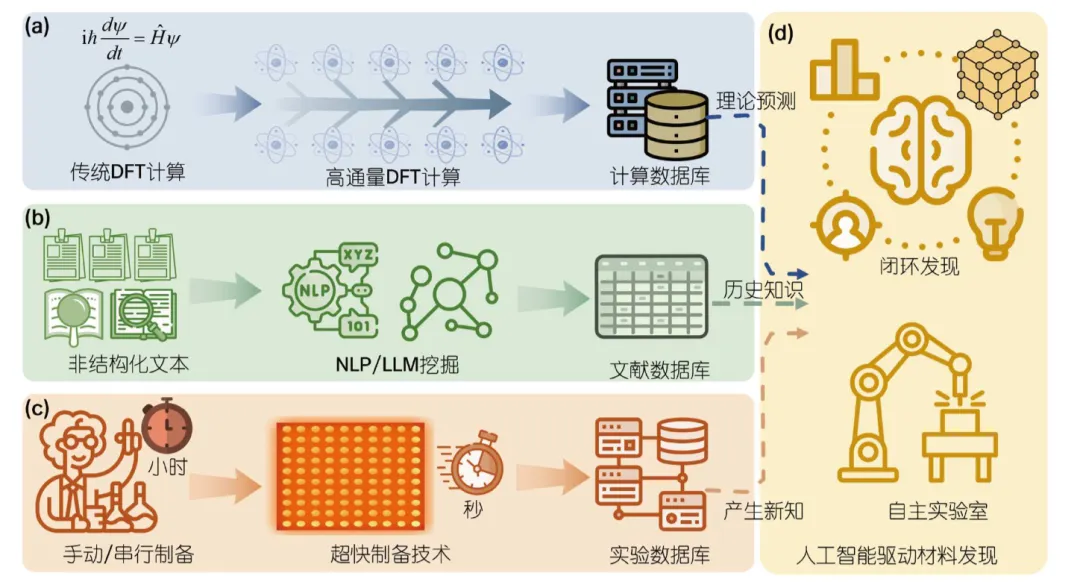
第一,数据是 AI 的燃料,但材料科学的燃料不是“更多数据”,而是“更高质量、更多来源、能闭环的数据”。单靠 DFT 不够,单靠文献不够,单靠实验也不够。三者融合,才可能把“数据稀缺”变成“数据丰富”。
第二,失败数据被严重低估。A-Lab 对失败案例的系统分析,直接改进了计算筛选和合成策略。阴性结果、失败实验、低产率条件,都是模型理解“什么不可行”的关键信息。只收集成功案例,模型学到的材料空间是偏的。
第三,实验速度是材料 AI 的隐形瓶颈。计算筛选可以在数秒内完成,实验验证却要数天。超快制备和高通量技术把合成周期压缩到秒级,才让“计算—实验”闭环真正跑起来。
第四,LLM 挖掘文献很强大,但不能迷信。幻觉会生成“伪数据”。RAG + 专家校验,是当前比较务实的方案。机器初筛、专家定稿,效率与可靠性才能兼顾。
第五,自主实验室不是“无人实验室”,而是“知识生成系统”。它最大的价值不是省人力,而是让每一个实验数据点的价值最大化,用最少实验获取最多知识。
08 对科研人员的启示
做材料 AI,先问数据从哪来。不要只盯着模型架构。数据规模、覆盖、质量、标准化,往往决定模型上限。
把失败实验和阴性结果当资产。它们能界定可行域,帮助模型避免重复踩坑。
多源数据融合是趋势。计算数据提供候选,文献数据提供合成先验,实验数据提供验证,主动学习负责迭代。
关注实验通量。如果实验验证速度跟不上计算筛选,闭环就很难真正高效。超快制备、高通量表征、自动化平台值得布局。
标准化和共享是基础设施。FAIR 原则不能只停留在口号。统一数据字典、本体库、结构化原始数据强制汇交,才能真正释放数据价值。
培养懂材料、会编程、擅数据的复合型人才。材料信息学不是材料加编程的简单叠加,而是需要理解物理约束、数据治理和 AI 方法的交叉能力。
09 一句话总结
AI 赋能材料科学,关键不只是更聪明的算法,而是更完整的数据生态:计算给候选,文献给配方,实验给验证,闭环给进化。
当计算、文献、实验三种数据源深度融合,当人类智慧与机器智能协同合作,材料科学才可能从“经验试错”走向“智能设计”,真正实现研发范式的变革。
原文信息黄鹏飞,陈亚楠. 人工智能驱动新材料发现:数据瓶颈突破与研发范式变革. 本文为该综述的科研解读,非原文翻译;细节请以原文为准。