ARTICLE · 1257842
OpenAI GPT-6.1 Terra正式发布
OpenAI GPT-6.1 Terra正式发布一张发票,是理解这次发布的起点。 OpenAI 在介绍 GPT-6.1 Terra 时,举的例子不是写诗,不是解奥数题,也不是生成一段惊艳的视频。 
它的原话是:让开发者有能力自动化"大量重复的工作,比如读取收到的发票,把上面的信息录入会计软件"。 这个例子朴素得近乎无聊。但恰恰是这个例子,暴露了 OpenAI 现在真正想打的那场仗。 过去两年,模型发布的核心是"更强"。参数更大、分数更高、能力边界更远。发布会上的每一张图表都在证明一件事:我们做到了别人做不到的事。 而这一次,OpenAI 的官方表述里反复出现的不是"最强",是"成本—智能前沿"(cost-intelligence frontier)。 一句话概括这次发布:不是把天花板顶得更高,而是把地板铺得更便宜。 先厘清位置。 OpenAI 目前的主力模型分四档,从便宜到强依次是 Luna、Terra、Sol、Astra。Terra 是中间偏下的那一档,承担的是"日常高频任务"的主力角色。 有个细节很关键:2026 年 9 月 OpenAI 发布 GPT-6 系列时,Sol 和 Luna 都升级了,唯独 Terra 还留在 GPT-5.6 这一代。它掉队了整整一个版本。 这次 GPT-6.1 Terra 的发布,本质上是一次"补课"——把中间档拉回到和家族其他成员同一代的技术框架上。 补课补出了什么结果?先看价格。 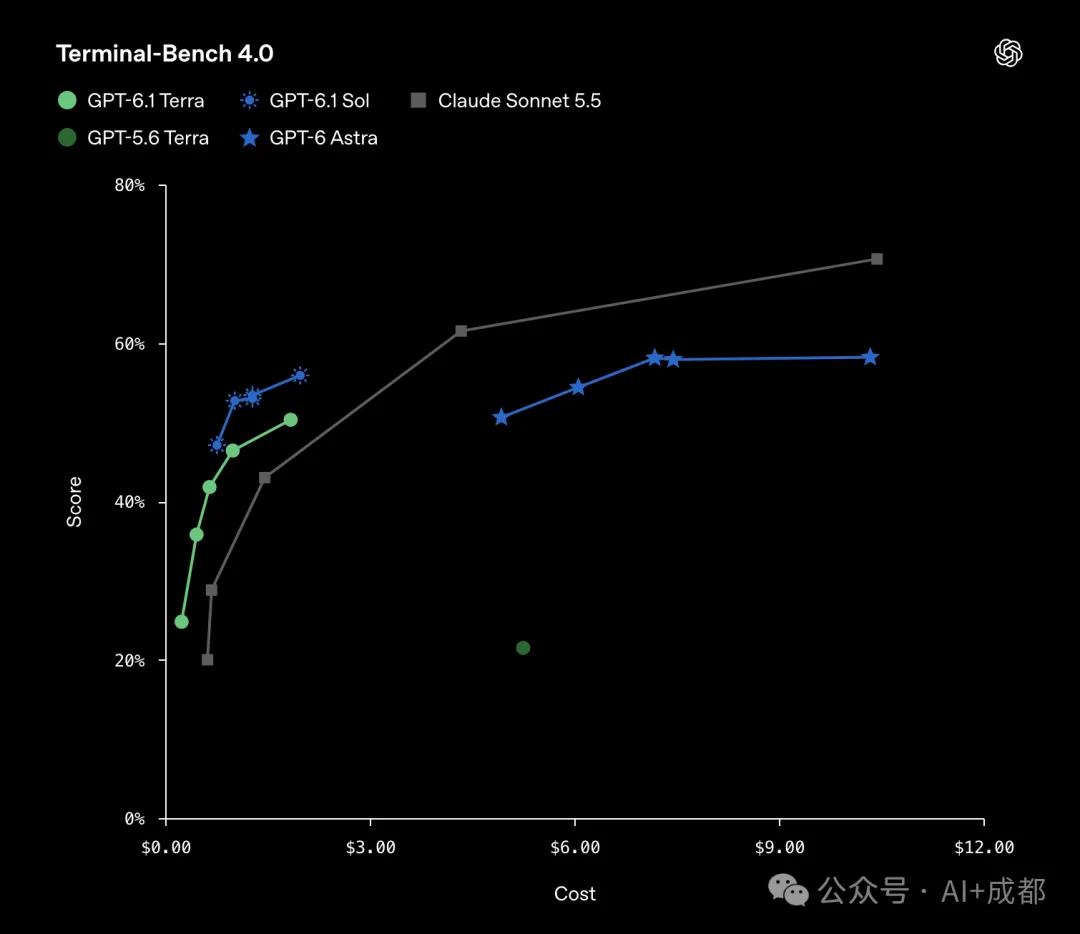
输入:每百万 Token 从 $2 降到 $1。 缓存输入:每百万 Token 从 $0.20 降到 $0.05。 输出:每百万 Token 从 $12 降到 $5。 输入价格降一半,输出价格降了近六成,缓存输入直接砍到原来的四分之一。 这个定价不是随便定的。它精准地压在了 Anthropic Claude Sonnet 5.5($2 / $10)的一半上。 把更便宜、更快的中间档,直接怼到对手同档位的一半价格——这是典型的定价进攻,不是定价跟随。 OpenAI 自己也算了一笔账:在 ChatGPT Work 和 Codex 里,同样的用量额度,用 GPT-6.1 Terra 能完成的任务比 GPT-5.6 Terra 更多,比 GPT-6.1 Sol 或 GPT-6 Astra 明显更多。 对订阅用户来说,这意味着一件事:你的套餐更耐用了。 GPT-6.1 Terra 的副标题是"从视觉理解到行动"(From visual understanding to action)。 这句话值得拆开看。 "视觉理解"是过去两年已经解决的问题:模型能看懂图纸、看懂截图、看懂视频。但"行动"是另一回事——模型要能操作鼠标、点击按钮、在多个应用之间跳转、把事情真的做完。 这个能力业界叫 computer use,概念不新。新鲜的是 OpenAI 这次用的修饰词:fast and capable computer use at scale。 三个词,三个约束。 fast 是时延和吞吐;capable 是复杂界面的多步操作;at scale 才是真正的门槛——它意味着任务要稳定、失败要可恢复、成本要可承受、能嵌进企业现有系统。 演示和规模化之间,隔着一条很宽的沟。 OpenAI 用 Agents' Last Exam 这个基准来证明它跨过去了。测试任务相当硬核:把建筑图纸转成 3D 模型;逐镜头审看一部动画电影,为修复团队生成带时间码的日志。 结果是: 中等推理强度下,Terra 比 GPT-5.6 Terra 高出 15 个百分点,成本约为后者的三分之一;在这个基准上追平了最强的 GPT-6 Astra,而每 Token 价格只有 Astra 的十分之一。 最高推理强度下,Terra 的 Token 效率是 Claude Opus 5.5 的三倍以上,每 Token 价格是其四分之一,单任务成本约为其九分之一。第三方报道给出的具体数字是:单任务成本 $1.01,对 Claude Opus 5.5 的 $8.82。 速度上,完成任务比 GPT-6 Astra 和 GPT-6.1 Sol 快三倍以上。 在 OSWorld 2.1(测试智能体操作桌面应用完成多步任务)上,中等推理强度就超过了 GPT-5.6 Terra 的最好成绩,而单任务成本只是后者的一小部分。 在 MMMU-Pro 视觉推理基准上,每一个推理档位都优于 GPT-5.6 Terra,并接近 GPT-6 Astra 和 GPT-6.1 Sol。 这里必须加一句提醒:以上全部数据来自 OpenAI 自己的测试,属于厂商自述,独立第三方复现结果尚未出现。这个行业里,自述成绩和落地成绩之间,通常存在折扣。 但即使打个折,方向也是明确的:计算机操作正在从"能演示"走向"能批量跑"。 这一组数据,我认为是整场发布里最有分量的一组。 流程自动化有一个残酷的现实:一个任务跑一万次,错 1% 就是一百次事故。而在财务、法务、医疗这类场景里,错一百次是不可接受的。 所以决定自动化能不能落地的,从来不是"快不快",而是"错不错"。 OpenAI 今年在降低幻觉上投入很大,这次给出了内部"诱导性错误提示词"基准的结果: 低推理强度下,错误率从 GPT-5.6 Terra 的 53.6% 降到 GPT-6.1 Terra 的 16.7%,下降近 37 个百分点。 最高推理强度下,错误率再降 18 个百分点,到 4.3%,最高档的前代数据是 22.3%。这个数字已经接近 GPT-6 Astra 和 GPT-6.1 Sol 的水平。 从 53.6% 到 4.3%,这不是优化,这是量级变化。 它把一个"必须人工复核"的模型,变成了一个"可以抽检复核"的模型。这两个状态之间的差别,决定了一个自动化流程值不值得上线。 编码能力同步大幅改善。 Terminal-Bench 4.0 测试编码智能体通过命令行解决问题的能力,比如修复一个加载时布局发生偏移的网页。最高推理强度下,GPT-6.1 Terra 解决了 50.3% 的任务,是 GPT-5.6 Terra 已发布成绩 21.5% 的两倍多。 有意思的是,OpenAI 在同一段里主动补了一句:对于最复杂的编码任务,GPT-6.1 Sol 和 GPT-6 Astra 仍然是更好的选择。 厂商在发布会上主动承认自己不是最强,这是很罕见的诚实。也说明 OpenAI 已经很清楚自己在卖什么——它卖的不是巅峰能力,是性价比。 在 Terminal-Bench-Science 0.1(用代码执行科研任务,比如在延时视频里追踪细胞分裂)上,Terra 以更低成本超过了 GPT-6.1 Sol,与 Claude Opus 5.5 的差距在 5 分以内,而成本不到其估计成本的五分之一。 第三方 Artificial Analysis 的编码智能体指数 v2.0 给出 Terra 48 分,GPT-6 Luna 31 分,GPT-6.1 Sol 54 分。同一机构认为,Terra 在低推理和超高推理两档配置下,都处在成本效率前沿上。 我们来算一笔最朴素的账。 一家公司每月要处理 20 万张发票。假设每张发票的输入处理约 4 万 Token、输出约 1000 Token。 用 GPT-5.6 Terra:输入 8 亿 Token × $2 = $1600,输出 2 亿 Token × $12 = $2400,合计约 $4000。 用 GPT-6.1 Terra:输入 8 亿 Token × $1 = $800,输出 2 亿 Token × $5 = $1000,合计约 $1800。 每月省下约 2200 美元,一年约 2.6 万美元。 这还只是把价格从"能做"降到"划算做"。真正的分水岭在下面: 当单任务成本降到 $1.01 这个量级,一大批过去算不过账的场景,突然就算得过账了。 审一份长合同、核对一批报关单、处理一柜子的理赔材料、给几千条客服工单分类归档——这些事过去不是 AI 做不到,是做的成本比人工贵,或者贵得不多,不值得为此改造流程。 价格每降一个量级,就会有一批新的场景从"不值得自动化"翻到"值得自动化"。 这就是为什么我说竞争重心在迁移。 模型能力的比拼,比的是谁能做到别人做不到的事;单位经济模型的比拼,比的是谁能让更多的事变得值得做。 后者的市场远大于前者。 还有一个容易被忽略的细节:缓存输入从 $0.20 降到 $0.05。 这个价格是给"重复上下文"准备的。当一个智能体每天在同一个系统里跑几千次任务,系统提示词、工具定义、知识库内容会被反复读取。缓存价格砍到四分之一,实际账单的降幅会明显大于标价降幅。 OpenAI 在给长期运行的智能体让利。这个信号,比标价本身更值得关注。 能力越强,风险敞口越大。这次发布里有一句话,很多人会略过,但我不建议略过: GPT-6.1 Terra 在 OpenAI 准备框架(Preparedness Framework)下,网络安全方面达到了 Critical(关键)阈值。 Critical 是这套框架里的高风险等级。达到这个阈值,意味着模型在网络安全相关能力上已经强到需要额外管控。 OpenAI 的应对是:沿用为 GPT-6 Astra 开发的防护措施。 对齐方面也有进展。相比 GPT-5.6 Terra,新模型更可能保持在任务范围内,更可能诚实地向用户披露限制和潜在阻碍。在提示注入测试中,对试图把它从用户任务上引开的恶意指令表现出强抵抗能力。 "更可能承认自己做不到",这一点对计算机操作类模型尤其重要。 一个会操作你电脑的智能体,最危险的状态不是能力不足,而是能力不足却自认为完成了任务。它可能在表单里填错一个数字,然后告诉你"已提交"。 所以"诚实披露限制"不是一个软性的道德指标,它是自动化流程能不能被信任的工程前提。 第一,模型的分层正在从"能力分层"变成"成本分层"。 当中间档能以十分之一的价格追平旗舰档的部分表现,"旗舰"这个词的含义就变了。它不再是"能不能做"的分界,而是"值不值得为最后那几个百分点付十倍价钱"的选择题。 第二,2026 年下半年真正的战场是 computer use 的规模化,而不是对话质量。 对话质量已经足够好了,好到边际收益递减。而让智能体稳定、便宜、可审计地操作真实系统,这件事才刚刚开始。谁先把单位成本和稳定性做下来,谁就拿到了企业工作流的入口。 第三,对使用者来说,现在最划算的动作是重新做一遍模型选型。 如果你还在用旧的中间档跑批量任务,把 GPT-6.1 Terra 换上去,账单大概率能降一半以上,而效果不会变差。 但别一刀切。OpenAI 自己都说了,最复杂的编码任务仍然该交给 Sol 或 Astra。 我的建议是分层用: 高频、量大、容错空间小的重复任务——表单、发票、数据录入、文档归档——用 Terra,把成本压下去。 复杂推理、重度编码、深度分析——继续用 Sol 或 Astra,别为省钱牺牲成功率。 另外,错误率降低不等于错误消失。4.3% 在最高推理强度下依然意味着,每一百次里大约有四次是错的。关键环节的人工复核,不要因为指标变好就撤掉。 发布会上的数字是厂商测的,你的账单是真实的,你的业务风险也是真实的。 真正该关心的只有一件事:在你的场景里,这个模型的单位成本和错误率,能不能让一条过去算不过账的流程,变得算得过账。 如果答案是能,这次发布对你就有意义。如果不能,它再便宜也和你无关。
一、Terra 在 OpenAI 的棋盘上,到底放在哪一格