ARTICLE · 1260268
MetricBot:我是如何生成文档并自动生成本体模型的
METRICBOT · 开源知识工作台
导读
我在 MetricBot 里写完一篇文档,通常会顺手点一下「AI 生成本体」。
几十秒后,文档里的概念、层级、关系和原文证据,会变成一张可以查询的图。
这篇拆开中间那段:文档怎么进来,长文怎么切,模型抽什么,证据怎么校验,合并怎么不冲掉旧内容。
01 / 08
文档是原料,不是附件
我习惯先写 Markdown。纯文本改起来不心疼,也方便版本管理。
Word、Excel、PDF、CSV、HTML 也能进同一个库。导入时保留原文件,同时转出一份可读文本;预览失败不会把原件弄丢。
这一步看起来只是格式转换,其实决定了后面能抽出什么。扫描件和复杂版式可以接 MinerU 做 OCR 和版面解析,结果按文件版本缓存;不接 MinerU,就用内置转换器拿到的文本。
02 / 08
AI 可以写,但每一笔都要授权
我常用的写法有两种:先让 AI 生成提纲,自己往里填;或者先写初稿,再让它从原文里找漏洞。
它可以在当前文档里替换一段、追加内容、重写全文,也可以新建一篇 Markdown。
写入前会弹权限卡,同意了才动文件。自动保存有 900 毫秒防抖,落盘用临时文件加原子替换;外部改过会提示版本冲突。
文档改了,本体不会自动跟着变。旧本体还是旧快照,要再点一次生成,才会产生新版本。
这个设计有点笨,但可预期。你不会因为改了一个错别字,后台就悄悄重写整张图。
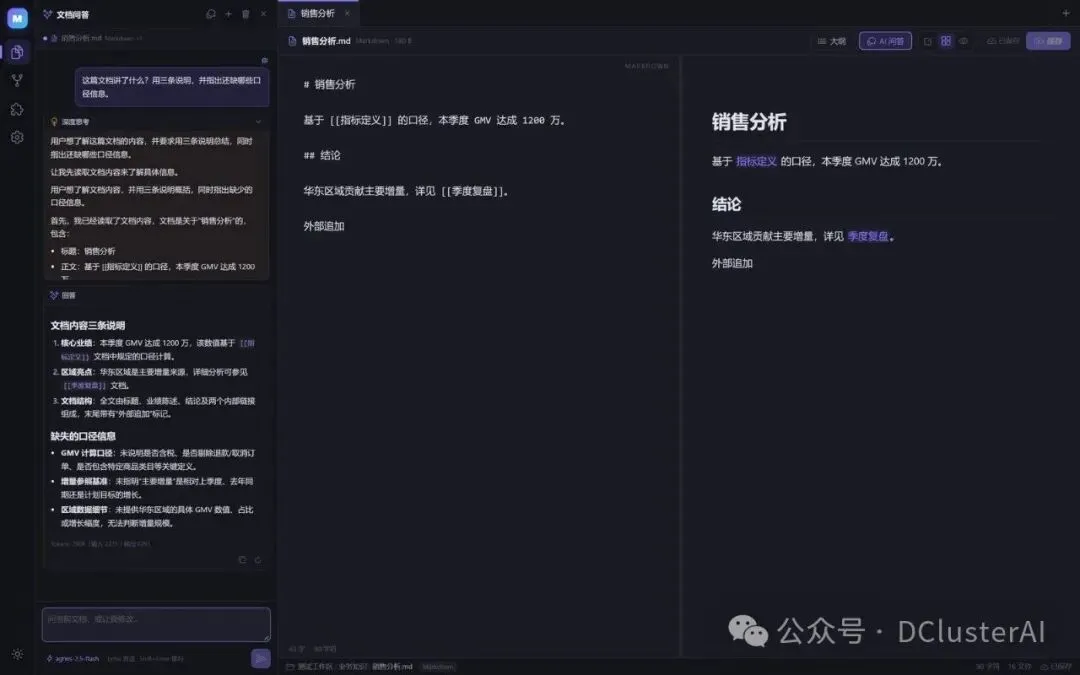
图 1:左边是 AI 问答,右边是 Markdown 编辑与实时预览
03 / 08
点一下,本体开始跑
入口有两个:文件树里右键「AI 生成本体」,或者在文档问答里说「把当前文档生成本体」。
弹窗里先选生成方式。新建本体,从零生成 v1;增量更新,把新文档合并到已有本体,生成下一个版本。截图里这篇销售分析已经有一个 v2 本体,所以默认选中增量更新,目标写着 8 类、5 关系,确认后生成 v3。
任务在后台异步跑,进度会经过读取、预处理、分块、抽取、合并、校验、写入几个阶段。
新建和更新的区别,不是有没有 AI,而是有没有旧结构作为参照。更新时,模型会先读已有本体的 key、别名和关系,再判断哪些概念该复用,哪些是新的。
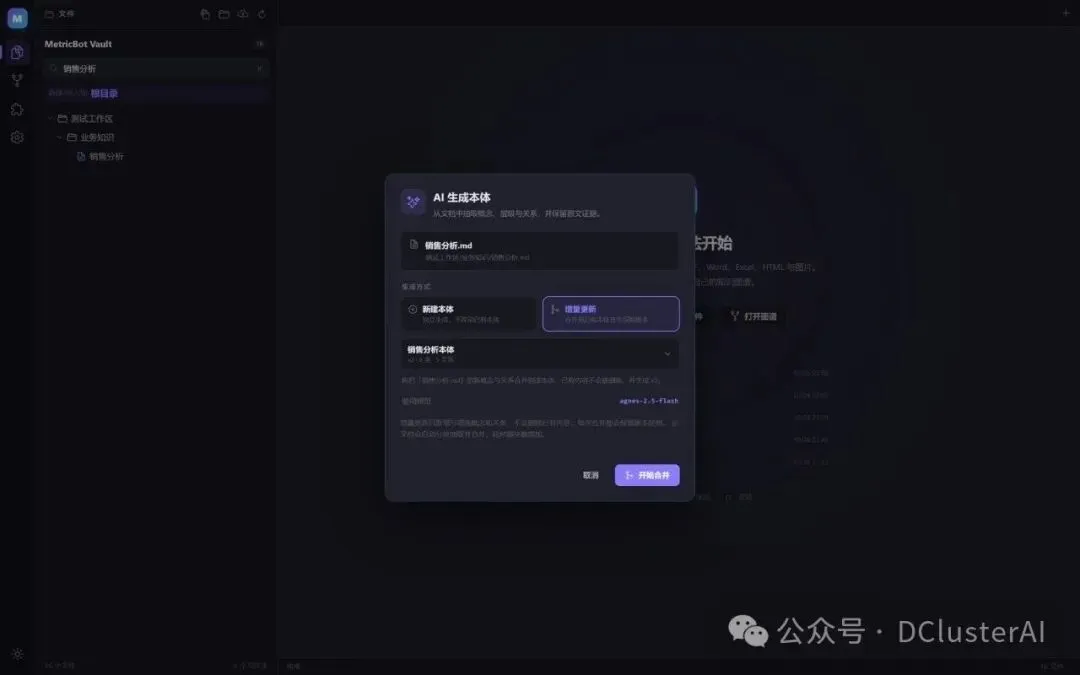
图 2:新建还是增量更新,弹窗里一次选清楚
04 / 08
长文按标题切,不按字数硬切
文本不超过 16000 字符,一次调用就能抽完。超过这个长度,就要分块。
分块先按 Markdown 标题分节,保留章节路径,再把相邻段落打包到 6000 字左右。单个章节超长时,按 6000 字切开并保留 600 字重叠,避免一个定义正好被切在两块中间。
每块会带上块序号和章节路径,模型只抽本块实际出现的内容,不替别的块补全。
如果某一块还是超出模型上下文,就对半再切,最多递归三次。切不动就明确报错,提示换更大上下文的模型。
分块有代价。跨章节的关系可能漏,块与块之间的上下位也要靠后面的合并去统一。长文档生成完,值得抽查章节边界附近的概念。
05 / 08
模型只抽文档里有的东西
系统提示词要求模型输出一个 JSON:本体标题、一句话描述、概念列表、关系列表。
概念带 key、名称、别名、类型、定义、父概念和原文证据。类型只有六种:实体、事件、规则、关联、属性、概念。提示词要求优先识别前五种,不要把所有节点都标成「概念」。
关系只连接已经出现的概念,type 用 camelCase 英文动词,label 用中文。父概念只在确实存在上下位时填,不能为了图好看硬造层级。
单次提示先抽 4 到 12 个核心概念,硬上限是 24 个概念、60 条关系。概念多的时候,会按证据数量和连接度排一个核心层,其余留在详细层。
模型偶尔多输出解释、漏转义引号,或者最后被截断。解析器会剥掉代码围栏,修引号、尾逗号和缺失的括号;救不回来的分半重试。
这些不是为了让输出好看,而是为了让失败可定位。JSON 解析不了,至少知道是模型的问题,不是文档没内容。
06 / 08
证据找不到,就删掉
每条概念和关系都要带原文引用。提示词要求每条不超过 120 个汉字,最多 3 条,而且必须能在原文里逐字找到。
生成后还有一道校验:把原文和引文里的空格、换行都去掉,引文必须仍然是原文的子串。找不到的,直接丢掉,并在任务结果里写「已过滤 N 条无法在原文定位的证据」。
这条规则很硬,会误伤合理改写,但我宁愿少几条证据,也不想在图上看到一句听起来很像、原文里没有的话。
多块合并先按 key、别名和规范化名称归并,一个概念不会因为出现在三个块里就变成三个节点。父概念和类型按票数定,关系按起点、类型、终点去重。
块数多的时候,还会做一次全局整理:只允许合并重复概念、调整上下位,不允许新增原文里没有的节点。它解决的是分块带来的碎片,不是让模型再自由发挥一遍。
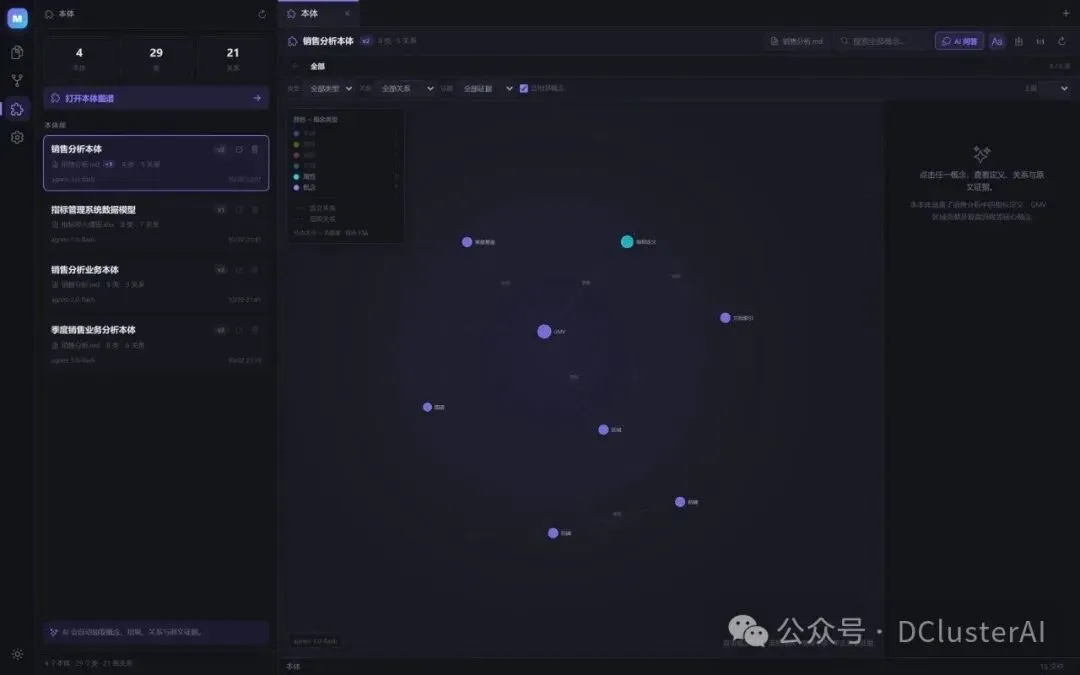
图 3:概念、关系、证据和类型,最后落在同一张图里
07 / 08
合并、版本和发布
新建本体从 v1 开始。增量更新会按 key、别名和兼容的名称匹配旧节点:能对上就补充描述、别名、证据和关系;对不上就新增;同名但语义明显不同的,按新节点保留,并在结果里标出来。
已有内容不会被删除。每次合并都会写一条版本快照,记录版本号、模型、方式和来源文件;发布状态、创建时间、更新时间也一起落库。需要对外交换时,可以导出 JSON-LD。
同一篇文档可以反复迭代,同一主题的多篇文档也能合并到同一个本体。代价是命名要稳定:叫「客户」还是「顾客」,还能靠别名对上;叫「用户」又没写别名,就可能多出一个节点。
08 / 08
它能做什么,不能做什么
最直接的用法是问。选中一个本体,问「GMV、区域和季度复盘是什么关系,哪条关系最缺证据」,它会先调用本体工具核对概念,再基于原文证据回答;找不到依据时,它会说不知道。
也可以把它当一份结构化目录:哪些概念没定义,哪些关系只有一句空话,哪些章节还没进本体。
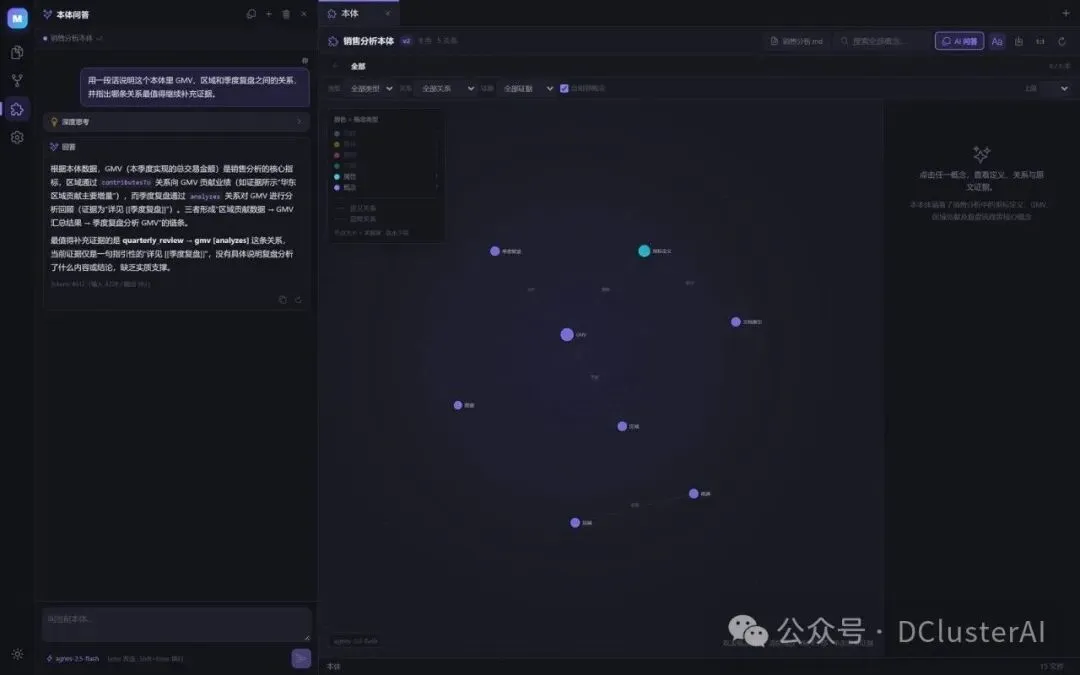
图 4:先核对本体,再回到原文找依据
它不会在文档保存时自动重算本体,也不会替你做跨文档推理。分块会漏掉跨章节关系,同名异义仍可能误并,扫描件能不能读好,取决于 OCR 和原图质量。
抽取质量最终取决于原文。原文里没有的定义,它编不出来;原文里前后矛盾,它也可能把矛盾一起抽进去。它负责起草,不负责拍板。
目前是单机、单用户,没有登录、协作和移动端。AI 要接 OpenAI 兼容接口,Key 只存本地;不配模型也能管理文件、浏览本体,只是不能生成和问答。
仓库里前后端齐全,Python 3.10+、Node.js 20+。先拿一篇熟悉的文档生成一次,再对照原文抽查几条证据。
开源地址在这里,AGPL-3.0,觉得有用可以点个 Star:
OPEN SOURCE / AGPL-3.0
MetricBot
本地优先的 AI 知识工作台,前后端可自部署。
https://gitee.com/zhenglv123456/metric-bot我先写好文档,再让文档长出结构。这样下次打开知识库,看到的就不只是一堆文件名。