ARTICLE · 1279830
推荐一个开源AiOps运维平台(含源码)
晚上,告警突然响起。
登录服务器,nginx 进程没了;检查端口,连接失败;翻遍日志,却没有明显的报错。
如果是你,会从哪里开始查?
大多数人从这里开始猜。进程没了可能是崩溃、可能是被 OOM 杀了、可能是配置错误起不来、可能有人动过机器——五个方向,每个都要翻不同的地方:systemctl status、journal、error.log、dmesg、crontab、/var/log/secure……熟手也要半小时起步,不熟的就是一晚上。
这次我把这个排查过程完整交给了 AI 运维 Agent,从告警响到拿到带证据链的根因报告,6 分 37 秒。全过程记录如下——它查出了什么、怎么排除的、哪些地方诚实承认查不到,一字未删。
01 环境:一台正常在用的服务器
一台日常跑着真实流量的云服务器,上面有 nginx 对外提供 80 端口服务,同机还跑着 MySQL 和 Redis。Agent 常驻这台机器,每 15 秒上报一次指标,并对声明的服务做三类探活:进程探活(nginx 进程在不在)、TCP 探活(80 端口通不通)、HTTP 探活(健康检查能不能返回)。
监控平台上,这台机器的七条探活全部是绿的:nginx 进程、80 端口、HTTP、MySQL 端口、MySQL 进程、Redis 端口、Redis 进程。
02 23:52:30,nginx 停了
晚上 23 点 52 分 30 秒,这台服务器上的 nginx 被停止了。是谁停的、为什么停,先按下不表——平台不知道,你也不知道,我们只看 AI 能查到哪一步。
03 46 秒后:三条探活告警同时触发
nginx 停止后 46 秒,告警刷新:同一台主机上三条探活同时翻红——nginx 进程、业务端口(127.0.0.1:80)、业务 HTTP。告警按指纹去重收敛成一个事件(同一故障合并报一次,不会每 15 秒刷一条重复的),S1 级别。
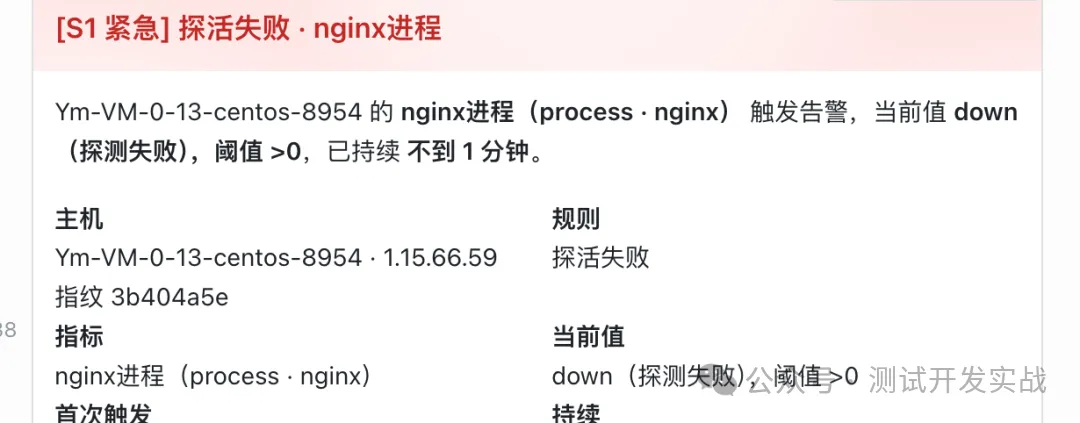
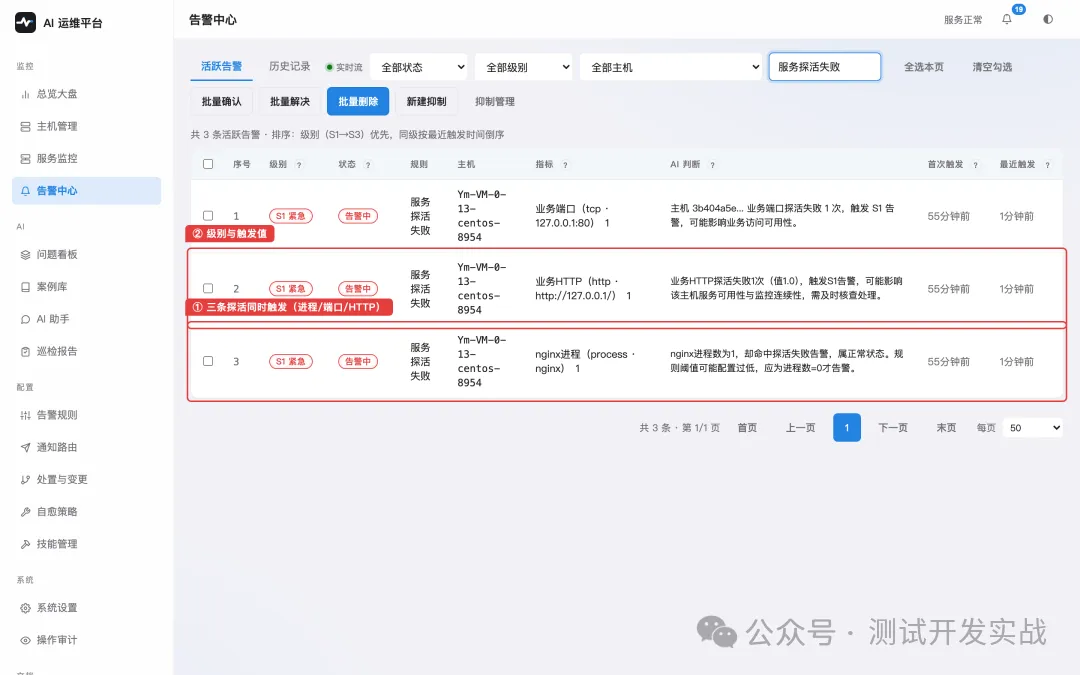
触发告警
告警列表里还有一列 AI 判断:每条告警触发时由快速模型先给一句方向判断("业务HTTP当前值为1且探活失败,可能导致业务请求异常或服务不可用")。这不是最终结论——最终结论要靠下面这场完整诊断。
如果你只看其中一条告警,判断一定是片面的:只看端口会去查网络,只看 HTTP 会去查应用。三条放在一起,问题域立刻收窄到 nginx 自身。
04 一键诊断:24 步、8 种工具、17 条只读命令
在事件详情点「一键诊断(AI)」,诊断 Agent 启动。它不跑固定剧本——每一步查什么,由上一步的结果决定。这次它跑了 24 步,调用了 8 种工具:
load_skill 加载排查技能(探活判别表、恢复动作库)service_health 服务健康总览discovered_services 服务发现:当前进程表 + 监听端口清单fetch_remote_log 拉取远程日志recent_changes 24h 变更记录journal_errors systemd journal 错误扫描run_readonly 授权只读命令(这次执行了 17 条)check_probe 探活状态复查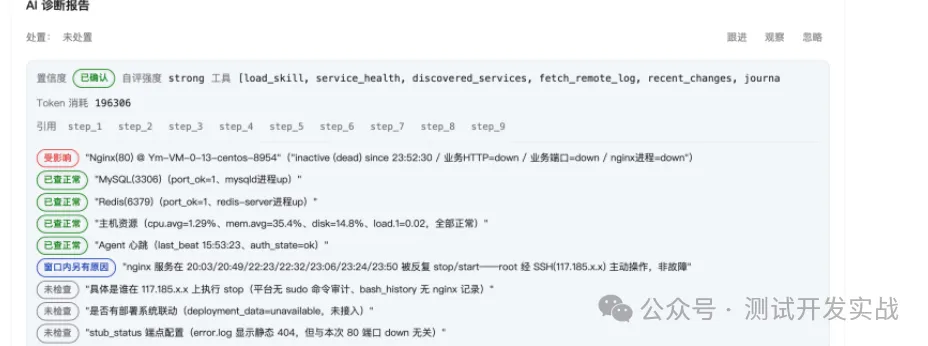
这 17 条命令全在 run_readonly 一个工具里:systemctl status nginx、journalctl -u nginx、cat /var/log/secure、crontab -l、cat /etc/crontab……全是只读,全部留痕,每一条的入参、返回、耗时都写进了执行瀑布,事后可逐帧回放。
把这场诊断画成一张图,Agent 的结构是这样的:
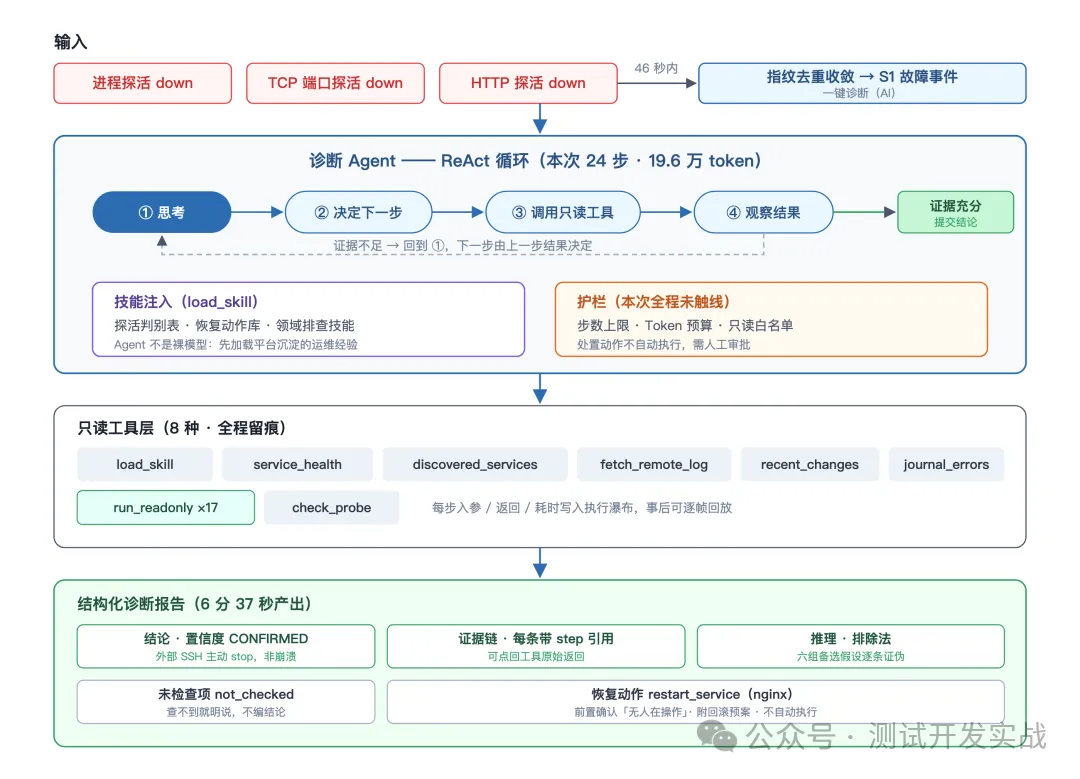
四层从上往下看:输入层三路探活去重收敛成事件;Agent 层是 ReAct 循环——思考、决定下一步、调工具、观察,每一步由上一步的结果决定,技能库给它注入探活判别表这类领域经验,护栏限定步数、预算和只读白名单;工具层 8 种全部只读、全程留痕;输出层强制以结构化报告收敛——结论必须带置信度、证据必须带 step 引用、查不到的必须写进 not_checked、恢复动作不自动执行。下一节就看它这次实际输出了什么。
05 6 分 37 秒后:报告出来了,结论是「有人停的,不是它自己挂的」
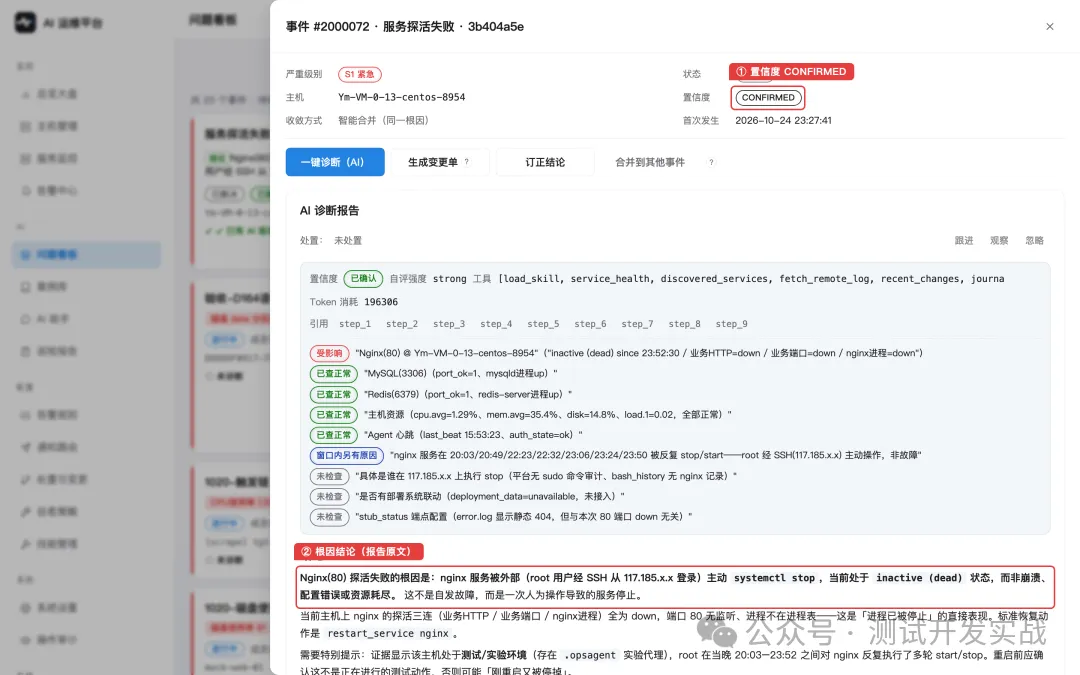
诊断完成,置信度 CONFIRMED(已确认)。结论段原文(未删减):
Nginx(80) 探活失败的根因是:nginx 服务被外部(root 用户经 SSH 从 117.185.x.x 登录)主动
systemctl stop,当前处于inactive (dead)状态,而非崩溃、配置错误或资源耗尽。 这不是自发故障,而是一次人为操作导致的服务停止。
注意它查到的深度——不是「nginx 不在了」,而是「谁、从哪、怎么停的」:
stop/start 与 SSH 登录秒级吻合:
/var/log/secure显示 root 从117.185.x.x的每次 SSH 登录都精确对应 nginx 的 start 或 stop——23:50:22 登录→start;23:52:30 登录→stop。
systemctl status 给出的停止时刻(23:52:30)与 /var/log/secure 里那条 SSH 登录记录同一秒。它把两个独立日志源交叉比对,闭合了因果链。
agent 故障诊断
06 排除法:六组假设全部证伪
报告另一半篇幅在证伪。每一组都有具体证据,不是一句话带过:
崩溃/OOM 被杀——退出码 0/SUCCESS、journal 无 crash/OOM 记录、内存仅 35% → 证伪。崩溃进程的退出码非 0 或有 fatal 日志,这里都没有;配置错误起不来——当日每次启动前 nginx -t都是 syntax is ok / test is successful,全程无 emerg→ 证伪;资源耗尽——CPU 1.3%、内存 35%、磁盘 14.8%、load 0.02 → 证伪; 发布/变更引入——24h 变更记录里只有 7 条只读审计任务,无任何变更单 → 证伪; 定时任务干的——crontab 全查,无任何 nginx 相关条目 → 证伪; error.log 里的 404 是元凶——那 3714 条 stub_status 404是探活采集配置问题,nginx 当时还在正常服务,「与 80 端口 down 无因果」→ 证伪,但顺手把它列为待修的独立小问题。
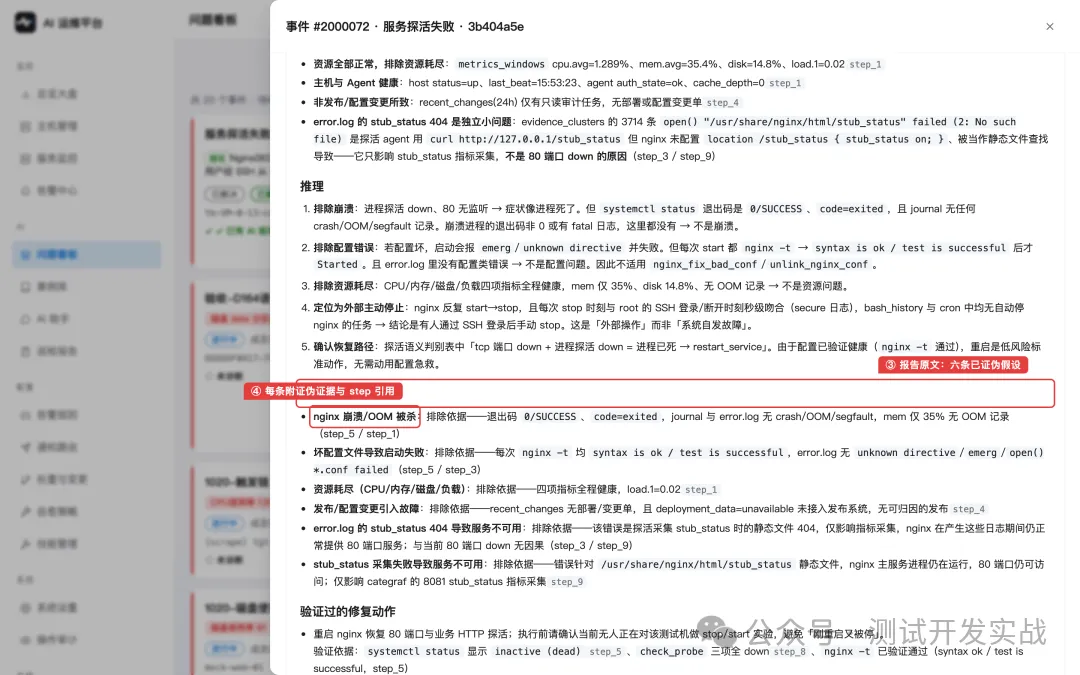
agent 分析失败根因
甚至还有一个细节:报告在恢复动作里专门写了一条前置提醒——「执行前请确认当前无人正在对该机器做 stop/start 实验,避免『刚重启又被停』」。因为它从 secure 日志里看到当晚这台机器被反复启停过多次,重启之前要先排除「正在进行的操作」。这个谨慎,很多人类工程师都不一定想得到。
07 诚实边界:三件事它明说查不到
报告专门列了 not_checked:
具体是谁在 117.185.x.x 上执行 stop(平台无 sudo 命令审计、bash_history 无 nginx 记录) 是否有部署系统联动(未接入发布系统) stub_status 端点配置(与本次故障无关,列为独立待修项)
它查到了 SSH 来源 IP,但没有权限知道 IP 背后是谁——没有审计日志,它就不猜。「是谁停的」这一步,需要云厂商的操作审计或堡垒机日志才能闭环,平台侧数据已穷尽,如实标注。
AI 运维工具最容易被骂的就是瞎编。这套平台的诊断 Agent 被设计成:结论必须引用证据(每条都带 step 编号,可点回原始返回),没有证据支撑的明确列为未检查项。查不出,也是合法结论。
08 收尾:恢复由 Agent 执行——你拍板,它动手
报告给出的恢复动作是 restart_service(nginx),但它不会自己执行。恢复走的是平台链路:在服务管理页对 Nginx(80) 发起「重启服务」,先跑一遍护栏预检(仅建议档,不下发)——判定「通过全部护栏」;然后切到人工确认档,点下确认的那一下,就是人拍板的那一下。
接下来的执行,全程由装在这台服务器上的 Agent 完成:
00:39:01 人工确认下发(mode=manual, confirmed)00:39:12 Agent 拉取任务(下发后 11 秒)00:39:13 执行完成(1.04 秒): 清残留进程 → systemctl reset-failed → systemctl start nginx后置校验 systemd_active=active ✓ 127.0.0.1:80 可连 ✓结果 三条探活转 up,服务状态恢复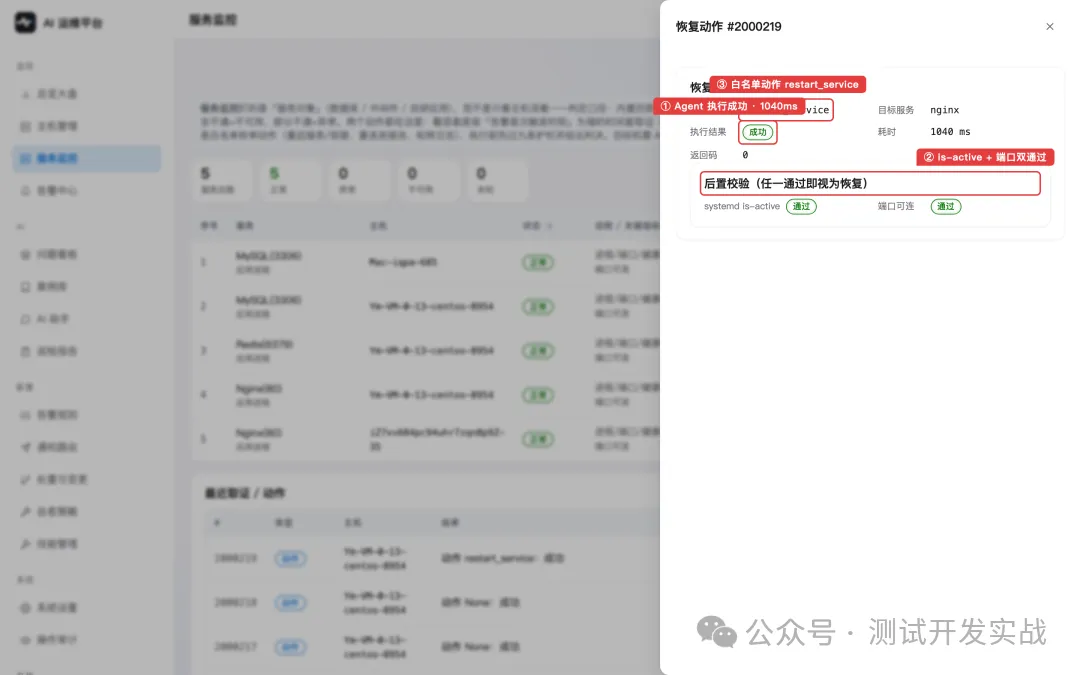
agent 自愈故障
上图的「最近取证 / 动作」列表和任务详情抽屉,就是平台上的原始记录:动作 restart_service、目标 nginx、执行结果成功、耗时 1040ms,后置校验 systemd is-active 与端口可连双双通过。
这条链路里有两个设计细节:一是后置校验是强制的——Agent 执行完立刻自查进程和端口,未通过会计入熔断,连续 2 次即停并转人工,不会反复重启打转;二是整条链路的动作只有四个白名单(重启服务/重启容器/重连连接池/轮转日志),白名单之外的动作压根下发不出去。
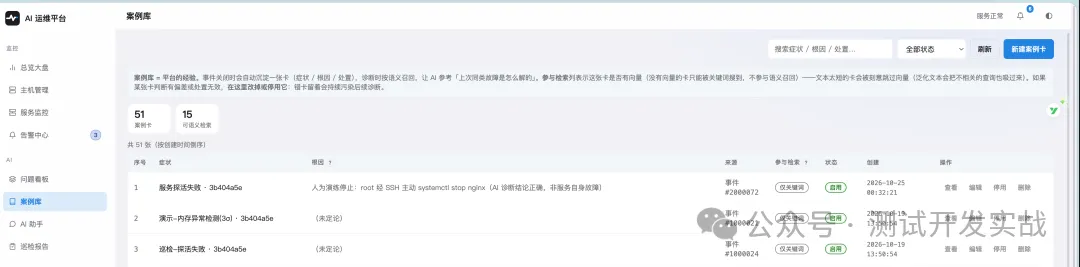
最后关闭事件:填入真实根因(AI 结论正确,无需订正:人为演练停止,非服务自身故障),点击关闭——平台自动把这次故障沉淀成一张案例卡:现象、根因、完整报告一起存进案例库。下次同类故障再发生,诊断 Agent 的 search_cases 工具就能检索到这次的经验。
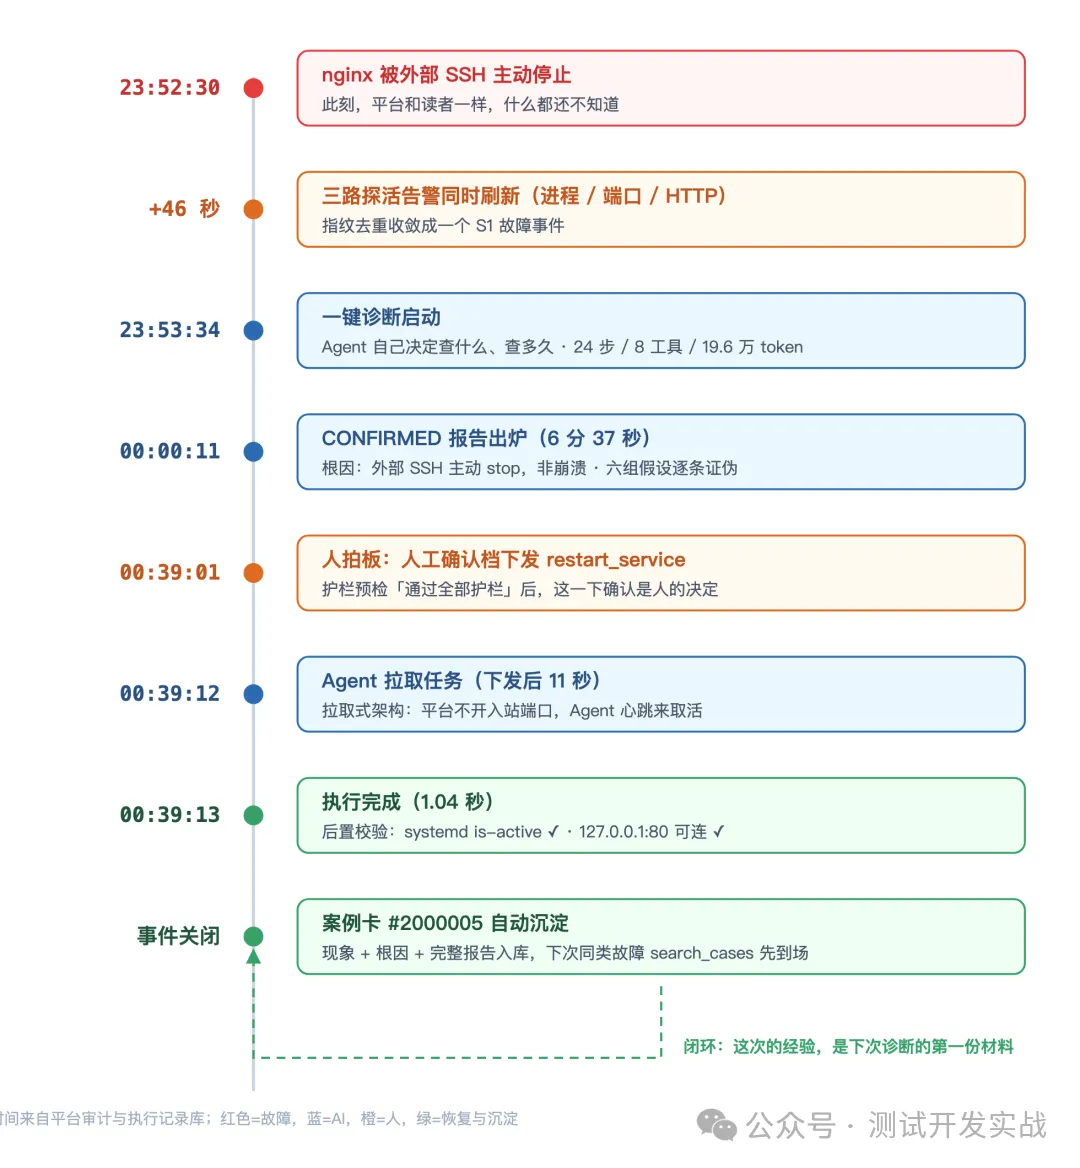
告警响 → AI 查完 → 人拍板 → Agent 执行恢复 → 经验沉淀,这才是一次完整的处置闭环。AI 负责把事实查清楚,恢复的决定权在人,动手的是受护栏约束的 Agent。
把这一次处置从头到尾画成一条时间线——每个时刻都来自平台的审计与执行记录:
经验沉淀:
09 复盘:这次处置的可带走经验
探活要三路覆盖(进程 + TCP + HTTP)——三路同时 down 才能把问题域锁死在「进程没了」,单看任何一路都会跑偏; 交叉比对比单点深挖值钱—— systemctl status的时刻与 /var/log/secure的登录时刻秒级吻合,这一步把「服务挂了」升级成了「人为停止」;排除法要留证据——六组假设逐条证伪,每组都有具体日志/指标,而不是「看起来没问题」; 恢复动作要带前置确认——AI 给的 restart 建议附带「确认无人在操作」的前置条件,自动处置前先排除与人工操作冲突; 对「查不到」要有预期——操作者身份无审计数据就明说查不到,比编一个根因有价值得多。
10 获取源码