ARTICLE · 1306942
EMNLP 2026|SAP:视觉文档索引该保留哪些标记?答案可能藏在中间层
论文标题:Structural Anchor Pruning: Training-Free Multi-Vector Compression for Visual Document Retrieval 作者:Zhuchenyang Liu、Ziyu Hu、Yao Zhang、Yu Xiao 作者单位:阿尔托大学 发表信息:EMNLP 2026 Main 论文链接:https://arxiv.org/abs/2601.20107 会议论文页面:https://aclanthology.org/2026.emnlp-main.216/ 代码链接:https://github.com/Ryenhails/structural-anchor-pruning
1. 最后几层的注意力,未必适合决定删什么
ColPali类检索器把页面表示为多个向量,通过晚交互匹配问题中的各个标记。索引保留的信息越多,存储和评分成本通常越高。压缩的难点在于:有些看似不显眼的区域恰好承载表头、实体或局部关系,删掉后可能改变检索结果。
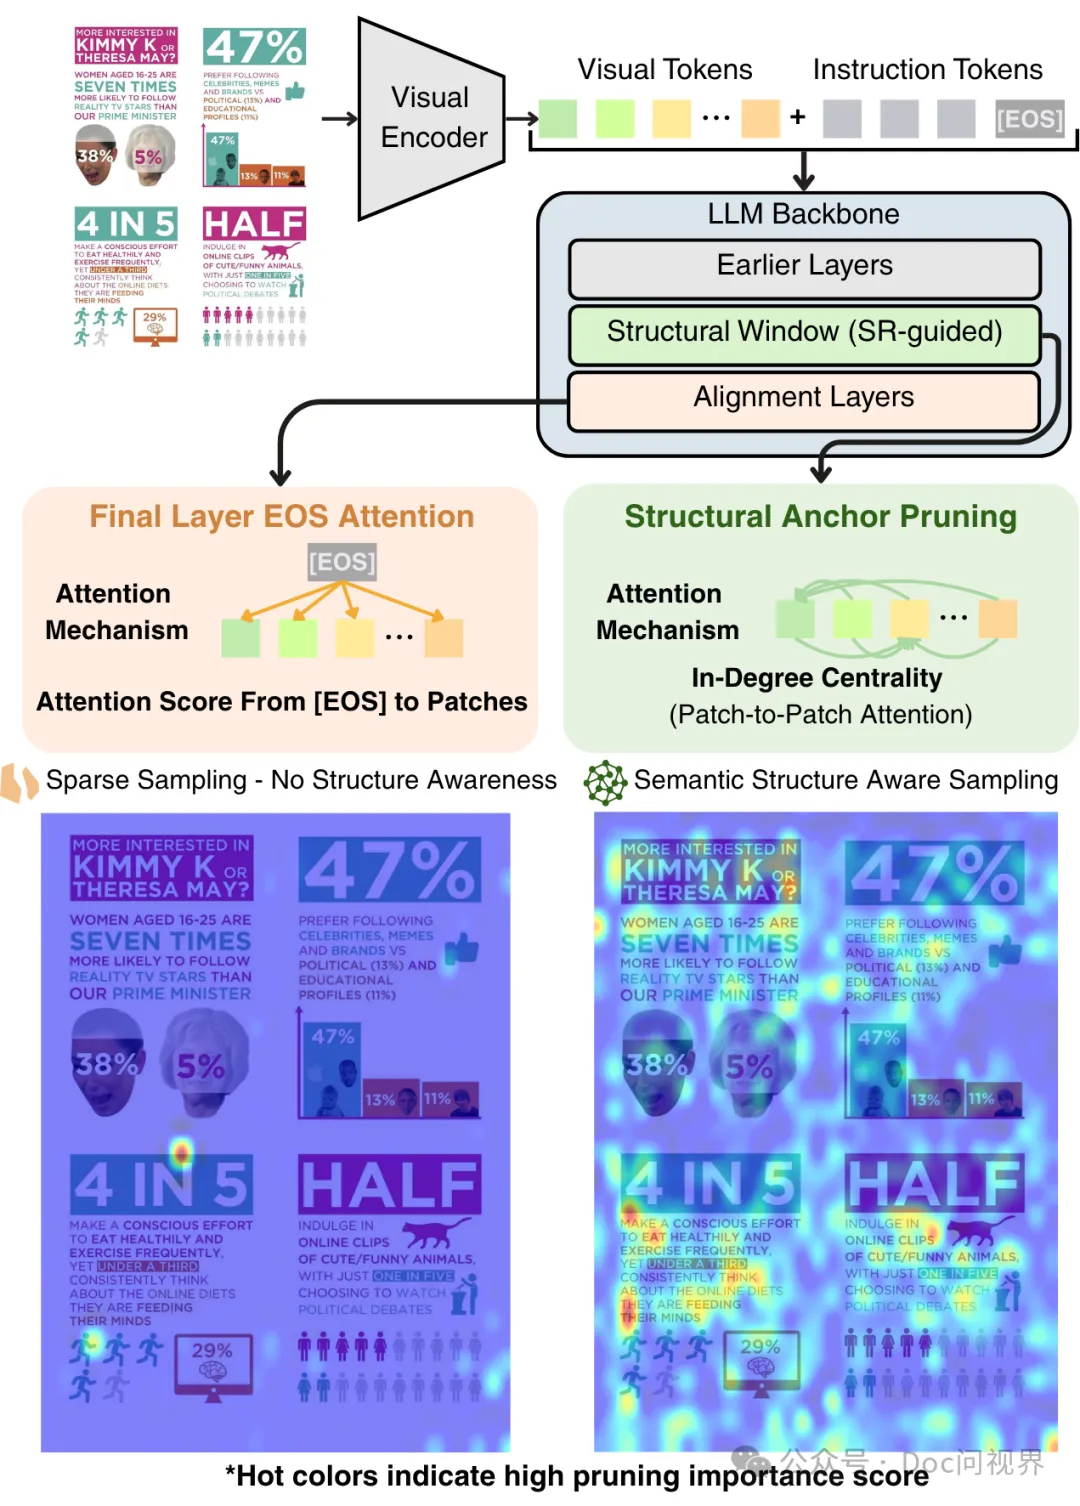
结构锚点剪枝(Structural Anchor Pruning,SAP)提出,适合检索评分的表示,不一定提供最好的剪枝信号。模型最后几层已经朝匹配目标调整,而中间某段层可能更集中地反映页面内部结构。SAP因此先定位这段结构窗口,再从中寻找值得保留的视觉标记。
2. 把注意力看成页面内部的信息流
SAP将自注意力看作有向图:每个视觉标记是节点,一个标记对另一个标记的注意力就是边权。对某个节点汇总来自其他视觉节点的注意力,可得到视觉入度中心性(Visual In-Degree Centrality)。如果许多区域都关注它,作者将其视为潜在的信息聚合位置。
计算只使用视觉标记之间的注意力,屏蔽系统提示等文本标记相关的边,再在多个注意力头和选定层窗口中取平均。跨头、跨层汇总降低对单个注意力图的依赖,形成每个页面标记的分数。系统按预算保留高分位置对应的最终检索向量,其余不进入索引。重要性来自中间层,保存的仍是用于检索的向量,两者承担不同角色。
这一评分过程不读取用户问题,因此同一份压缩页面索引可以服务后续不同查询。它也不需要更新模型参数。代价是必须能访问模型内部注意力;对于只提供封闭检索接口、无法获得中间状态的服务,不能直接套用这套方法。
3. 结构窗口如何自动找到?
作者设计分数保留率(Score Retention,SR),比较同一问题—页面对在剪枝前后的MaxSim得分。它关注匹配分数保留多少,而不依赖该页面在整库中的排名。SR用于诊断压缩,NDCG用于评估检索:前者高不保证排名正确,后者也会受到干扰页面分布的影响,两项指标不能互相替代。
离线校准时,对每一层分别用中心性选择相同预算的视觉标记,计算校准样本上的平均SR,得到随层深变化的曲线。系统找到末尾持续低于全局中位数的区段,再把固定相对宽度的结构窗口放在它前面。论文默认使用500个无标签问题—图像对,窗口宽度约为骨干深度的20%,无需按模型人工搜索最佳层。
这里需要分清“与查询无关”的范围:校准使用问题,建库评分不依赖部署查询。校准问题帮助衡量哪些层的剪枝更保真,一旦窗口确定,之后处理页面和服务用户时都不再按问题重选窗口。论文把中间平台与末层下降称为对齐—聚合分化(Alignment-Aggregation Divergence),并用不同骨干检验这一现象。
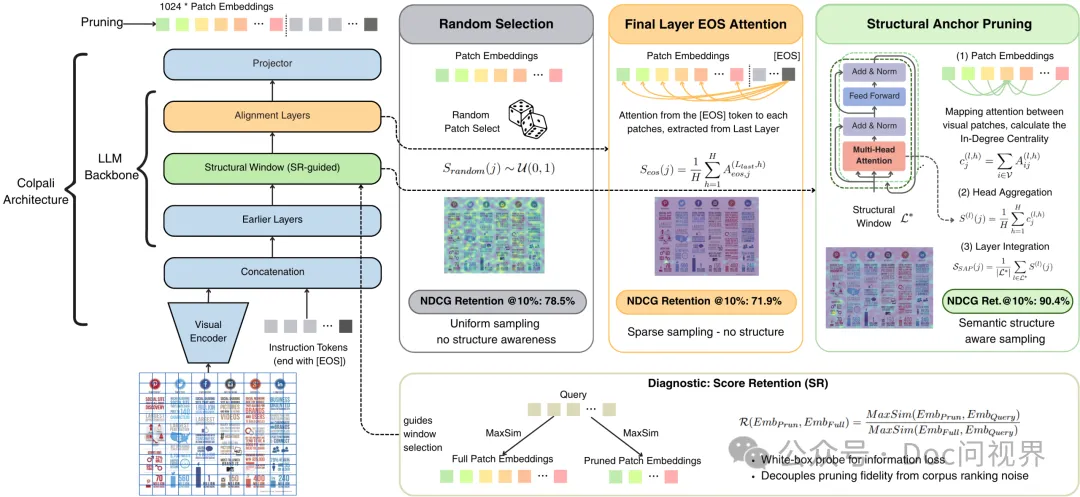
需要注意,中心性高表示在选定层里接收了较多视觉注意力,并不是人工标注的答案区域。SAP利用这种信号做通用索引压缩,最终仍必须用真实检索指标判断其价值,不能把保留下来的区域直接称为每个问题的正确证据。
4. 十倍压缩之后,还剩多少质量?
在ColPali、ColQwen2和Jina Embeddings v4上,保留10%的视觉标记时,SAP保留ViDoRe v1完整索引NDCG@5的93%—96%,在更难的v2上为88%—90%。进一步只留5%时,对应范围降至85%—90%和76%—79%。压缩越激进,质量损失越明显,不存在无损缩小索引的承诺。
在ViDoRe v2合并语料的具体ColPali实验中,索引从751 MB降至75 MB,MaxSim检索耗时从每查询6.1毫秒降至0.78毫秒,保留90.4%的NDCG@5。这是指定语料与评分实现下的结果,不包含后续回答生成,也不是视觉编码器本身加速了近八倍。
对照未做检索微调的基础模型后,作者发现末层下降并非微调凭空创造,但检索微调使边界差异扩大约三至八倍。该观察覆盖两个可获得基础检查点的骨干,尚不能据此认定某一种训练损失就是唯一原因。
5. 把剪枝信号与检索表示分开考虑
论文还测试了不同校准样本量,但这种稳定性证据仍限于文档图像领域,应与跨领域可迁移性区分。
SAP最有价值的设计是先诊断信息在哪一段层被聚合,再决定保留哪些位置。它提供了一种无需再训练的索引压缩路线,也提示我们:直接使用最后层的注意力作重要性判断,可能错过适合当前用途的结构信号。
目前证据集中在多向量视觉文档检索,尚未证明压缩后完整RAG答案质量保持不变。校准数据跨到自然图像等不同视觉领域时,结构窗口也可能变化。若用于生产系统,应在目标文档上同时测量检索质量、索引成本和下游问答,而不是把分数保留率视为信息完整性的证明。