ARTICLE · 1310961
腾讯 5B 模型统一解析图文音视频,文档解析拿下 96.96 分
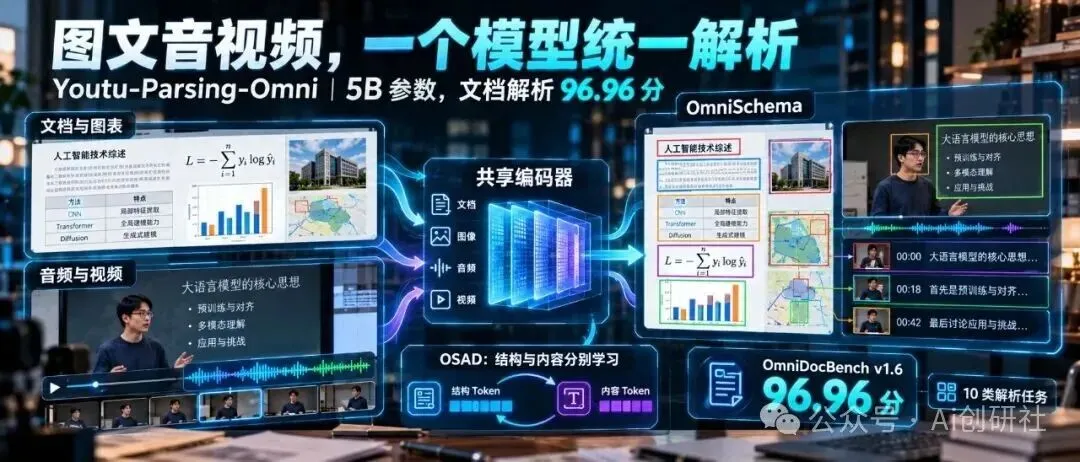
文档里的表格、音频里的说话人、视频里某一刻的画面,能不能交给同一个模型,输出同一种有出处的结构?Youtu-Parsing-Omni 用共享编码器与 OmniSchema 接住十类解析任务,文档基准 OmniDocBench v1.6 得分 96.96。笔者更想讨论的是:为什么统一输入还不够,它还专门区分了“结构 token”和“内容 token”来训练。
链接速览
📄 论文:Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
🔗 链接:https://arxiv.org/abs/2610.39301
代码:https://github.com/TencentCloudADP/youtu-parsing(技术报告列出的解析代码仓库)
模型:https://huggingface.co/tencent/Youtu-Parsing-Omni(技术报告列出的模型权重入口)
先看结论
- 统一到哪里
:一个 5B 检查点处理文档、自然图像、化学结构、乐谱、图表、音频和视频等十类任务,输出带空间或时间定位的文本结构。
- 两层设计
:感知侧共享大部分编码器权重,并在时间轴上融合画面和声音;输出侧用 OmniSchema 统一记录,再通过 OSAD 细化结构与内容监督。
- 主要结果
:OmniDocBench v1.6 为 96.96;OmniParsingBench 平均 75.08,在受测开放权重模型中领先,但仍低于 Gemini-3-Pro 的 77.44。
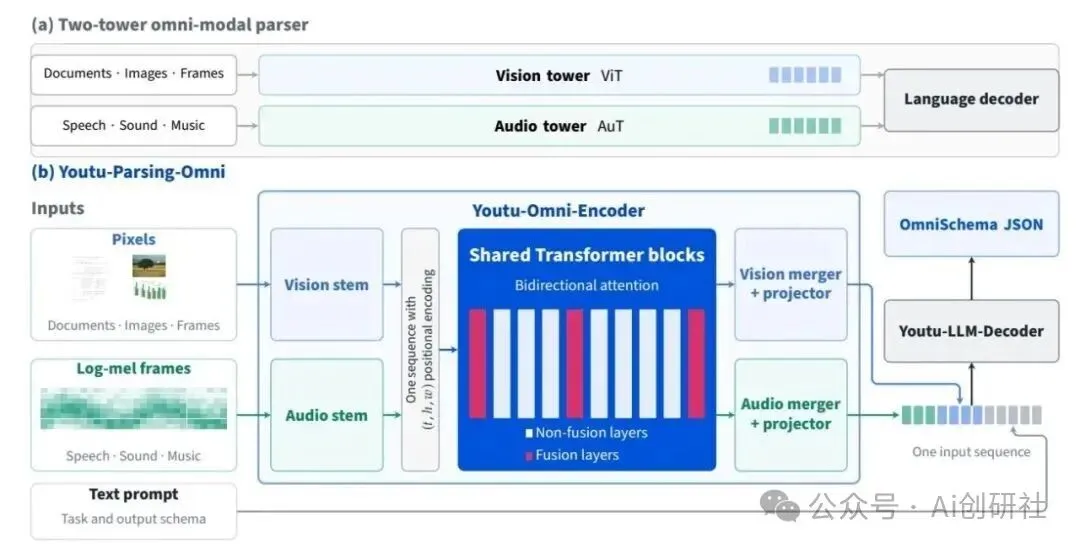
图 1|模态专用输入层把图像与声音转成 token,中间的大部分 Transformer 权重共享,再由语言解码器输出结构化解析。
背景与动机
传统解析管线往往按输入拆开:文档走 OCR 和版面分析,声音走 ASR,视频再接目标识别与事件描述。每条管线都有自己的输出格式,下游应用还要重新对齐它们。
问题不仅是工程复杂。假设一段讲课视频里,画面显示公式,老师同时解释某个变量。把画面和声音独立解析后,再让语言模型拼接,可能已经丢失“哪句话对应哪一屏”的细粒度关系。
Youtu-Parsing-Omni 希望把这层关系在感知阶段建立起来,并把输出组织成可追溯的单元。它回答的不是“这段内容大概讲什么”,而是哪里出现了什么、什么时候说了什么,以及这些信息怎样结构化保存。
核心方法
1. 共享编码器,但保留模态必要的输入处理
图像与视频帧按原生分辨率切成 patch,通过线性映射变成 token;音频先转为 log-mel 频谱,经少量步幅卷积压缩时间,再映射到相同宽度。
中间 Transformer 使用共享权重,注意力为双向。编码后,视觉 token 按空间邻域合并,音频 token 按时间相邻关系合并,再经过各自投影层进入语言解码器。
这不等于把声音当成图片直接输入。模态差异由输入 stem 和输出 merger/projector 处理,大部分上下文建模能力则共用。共享块还从语言模型 Qwen3-0.6B-Base 初始化,去掉词嵌入与语言模型头,而非从随机权重开始学习一切。
2. 同一时间轴,让声音与画面在编码器内交互
位置编码分配时间、高度、宽度三组旋转频率。视觉 token 使用帧时间和二维 patch 位置;音频 token 使用时间位置,空间坐标置零。
仅有共同坐标还不够,两个模态必须能够互相注意。模型提供独立和融合两条路径:独立路径按帧、音频块各自处理;融合路径把同一时间附近的画面与音频放进共享注意力窗口,其余层仍保持局部处理。
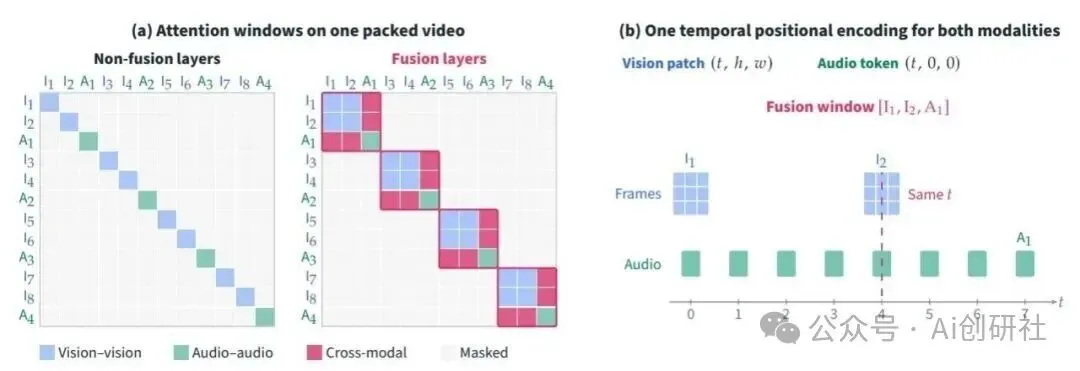
图 2|共同时间坐标与音视频融合窗口。前者让位置可比较,后者让信息真正交换,两者承担不同作用。
训练后期保留独立与融合两种路由,避免模型只能处理某一种组织方式。短窗口融合也避免所有音视频 token 在每层都做全局交互的昂贵开销。
3. OmniSchema:统一外壳,保留各任务自己的内容格式
输出的共同字段是 modality、定位单元列表和 global_description。图像单元带边界框,坐标归一化到 0—1000;音频与视频单元带起止时间,语音段还标注说话人。
单元内部按任务使用相应表示:公式写 LaTeX,表格写 OTSL,化学结构写 SMILES,乐谱写 ABC,图表恢复 Markdown 数据表,流程图输出 Mermaid。文档保留阅读顺序,富文本视频还提供结构化报告。
因此,“统一”不是把一切压成一段描述,而是统一定位、组织和追溯方式,同时保留专业内容的可操作形式。对于下游检索或智能体,这是比自然语言摘要更明确的接口。
4. OSAD:让模型在自己的输出前缀上,得到更细的纠错信号
SFT 可以教会正确格式,但训练时看到的是参考答案前缀,推理时却要接着自己已经生成的内容继续。RLVR 让模型在自身输出上优化,可一个序列级分数又难以指出具体哪个公式符号或表格数值错了。
OSAD 使用学生自己生成的轨迹。教师和学生读取同一个生成前缀,但教师额外看到参考解析;教师据此给出下一 token 分布,学生则不能看到参考答案。
输出被分成两种位置:JSON 键、括号和分隔符属于结构;字段值属于内容。前者有更严格语法约束,后者可能存在多个正确表达,因此采用不同的分布匹配目标。
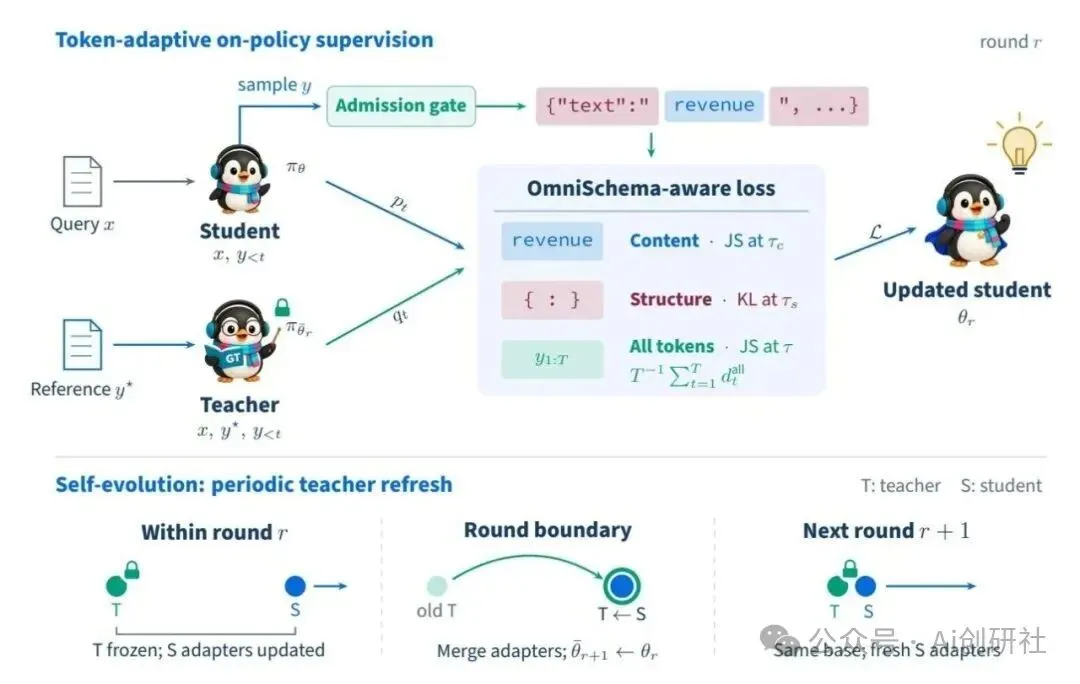
图 3|OSAD 在学生自身轨迹上蒸馏;教师额外获得参考解析,每轮结束后用学生的新权重刷新教师。
每轮内教师冻结,学生只训练 LoRA。轮次结束后合并适配器,更新下一轮教师和学生,再初始化新的适配器,共进行六轮。格式无效、框语法不合法或重复严重的轨迹不会进入这一步蒸馏。
核心公式
原文公式(4)区分内容与结构位置:
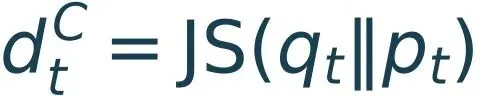
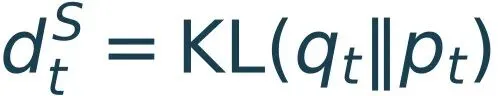
q 是教师分布,p 是学生分布。内容使用对称、有界的 JS 散度,结构使用正向 KL;实际计算还分别设置温度,结构温度高于内容温度。最终损失包含全 token 的 JS 项,以及按角色分别平均后的附加项。
直观上,模型不仅学习“整个答案更像参考”,还学习“这里是在填写内容,还是在维持结构”。对于长 JSON、公式和复杂表格,局部错误很容易让后续内容一起偏离,这种区别因此有实际价值。
关键实验结果
1. 文档解析:与专用模型保持同一水平
OmniDocBench v1.6 共 1,651 页,综合文字、公式和表格指标。Youtu-Parsing-Omni 得到 96.96,TeleOCR 为 96.91,差距只有 0.05 分。
更有意义的是,它在支持其他模态的同时,没有明显牺牲文档能力。与此前 Youtu-Parsing 相比,表格 TEDS 提高约 4.8 分,公式 CDM 提高约 3.2 分;表格与公式都要求把识别结果正确组织成结构。
这是一组基准成绩,并不意味着所有现实文件都能以 96.96% 的概率完美解析。它也不该被包装成对专用模型的压倒性领先。
2. 跨模态平均领先开放权重模型,优势集中在时序任务
| 75.08 | |
| 77.44 |
Youtu 的图表分数为 95.02,在受测系统中最高;相对 Logics,音频、自然视频、富文本视频分别领先约 2.5、6.8、10.3 分。
但自然图像与几何并没有同样的优势。图表数据提取较强,也不意味着所有图形关系理解都更强:论文指出几何关系和细粒度语义描述仍有不足。对于下游问答,正确抽出对象与充分表达对象关系是两件事。
3. 化学与乐谱:专门表示带来更明确的输出目标
ChemOCR 使用分子指纹相似度与 Tani@1.0 衡量识别;Youtu 在后者上领先受测模型。这是结构相关的严格指标,不能直接等同于 SMILES 字符串逐字完全一致。
在 800 张乐谱图的 PDMX-Synth 上,Youtu 字符错误率为 22.73,专用 LEGATO 为 23.30;但符号和行级错误率仍由 LEGATO 更低。不同粒度的错误评价,揭示了“字符相近”与“完整乐谱结构正确”的差别。
4. OSAD 的收益来自连续细化,而非一次换模型
在相同文档基准上,SFT 后续共增加 1.99 分,其中 RLVR 贡献 0.24,六轮 OSAD 贡献 1.75,占约 88%。OSAD 将分数从 95.21 推到 96.96,各轮均有增益,但幅度逐渐减小。
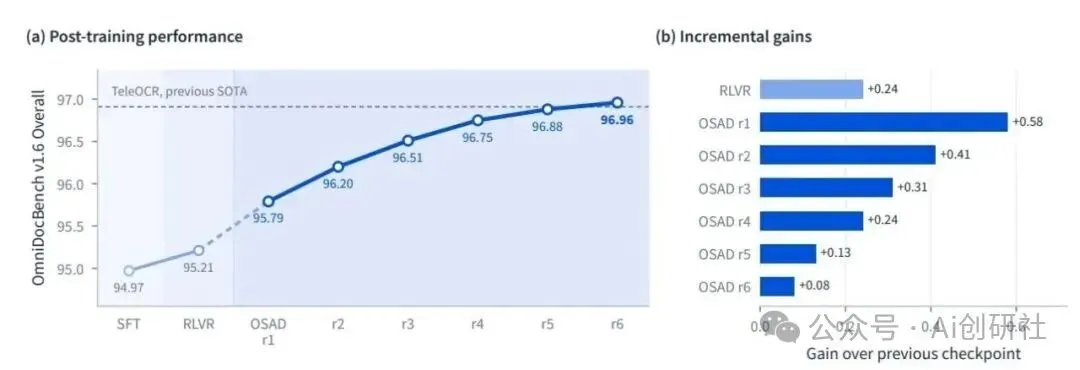
图 4|SFT、RLVR 与六轮 OSAD 的检查点变化。结构合法以后,内容中的局部识别错误仍然存在,细粒度监督继续带来改善。
这组顺序训练结果支持 OSAD 的整体价值,但不能独立量化教师刷新、不同散度和角色加权各自贡献了多少。
思考与启发
笔者认为,这篇最有价值的是把“感知输出应当是什么”定义清楚了。带坐标或时间戳的单元,可以回到原始证据;表格、公式、化学和乐谱各自有结构化载体,下游不必再从一段散文中猜测组织关系。
OSAD 的思路也不局限于解析。很多任务同时包含严格结构和开放内容,例如工具参数、代码配置、带证据的报告。把它们视为完全相同的 token 学习问题,可能浪费了已知的结构信息。
实际使用仍要看任务差异:视频时间戳采用秒级表示,模型输出以文本为主;复杂几何关系与自然图像细节也仍有短板。更合理的选型方式,是拿真实输入测试关键字段的准确性、定位与下游可用性,而不是只看一个跨任务平均分。
参考资料
Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities,arXiv:2610.39301。https://arxiv.org/abs/2610.39301